



更新日 2026年4月21日
Scrapy in Python(開発者向けのしくみ)
ここにScrapy、PythonにおけるWebスクレイピングフレームワークとIronPDFが登場し、オンラインデータの抽出と動的PDFの作成を最適化するための2つの強力なライブラリが協力しています。
詳しく読む

この記事では、強力な PDF 処理ライブラリである IronPDF を使用して、あらゆる PDF ファイル内の複雑なテーブルからデータを簡単に抽出する方法を説明します。
Python は、他の言語と比較してプログラマーに非常に高い柔軟性を提供し、開発者がグラフィカル ユーザー インターフェイスを簡単かつ効率的に設計できるようにします。 したがって、IronPDF ライブラリを Python に組み込むのは簡単なプロセスです。 完全に機能する GUI を迅速かつ安全に作成するために、PyQt、wxWidgets、Kivy、その他のさまざまなパッケージやライブラリを含む、プリインストールされたさまざまなツールを利用できます。
IronPDF は Python による Web デザインと開発を簡素化します。 これは主に、Django、Flask、Pyramid などの Python Web 開発フレームワークが豊富に利用できることに起因します。 これらのフレームワークを採用している有名な Web サイトやオンライン サービスとしては、Reddit、Mozilla、Spotify などがあります。
FromFileメソッドを使用します。ExtractAllTextメソッドでテーブルからテキストを抽出します。以下はIronPDFのいくつかの機能です:
コンピュータに Python がインストールされていることを確認してください。 ご使用のオペレーティング システム用の最新バージョンの Python をダウンロードしてセットアップするには、公式 Python Web サイトにアクセスしてください。 Python をインストールしたら、仮想環境を作成してプロジェクトの要件を分離します。 venvモジュールを利用して、仮想環境を作成し、変換プロジェクトにすっきりと整理された作業スペースを提供することができます。
このチュートリアルでは、Python 開発用の IDE である PyCharm をお勧めします。
PyCharm IDE を起動したら、下の図のようにメニューから"新規プロジェクト"を選択します。
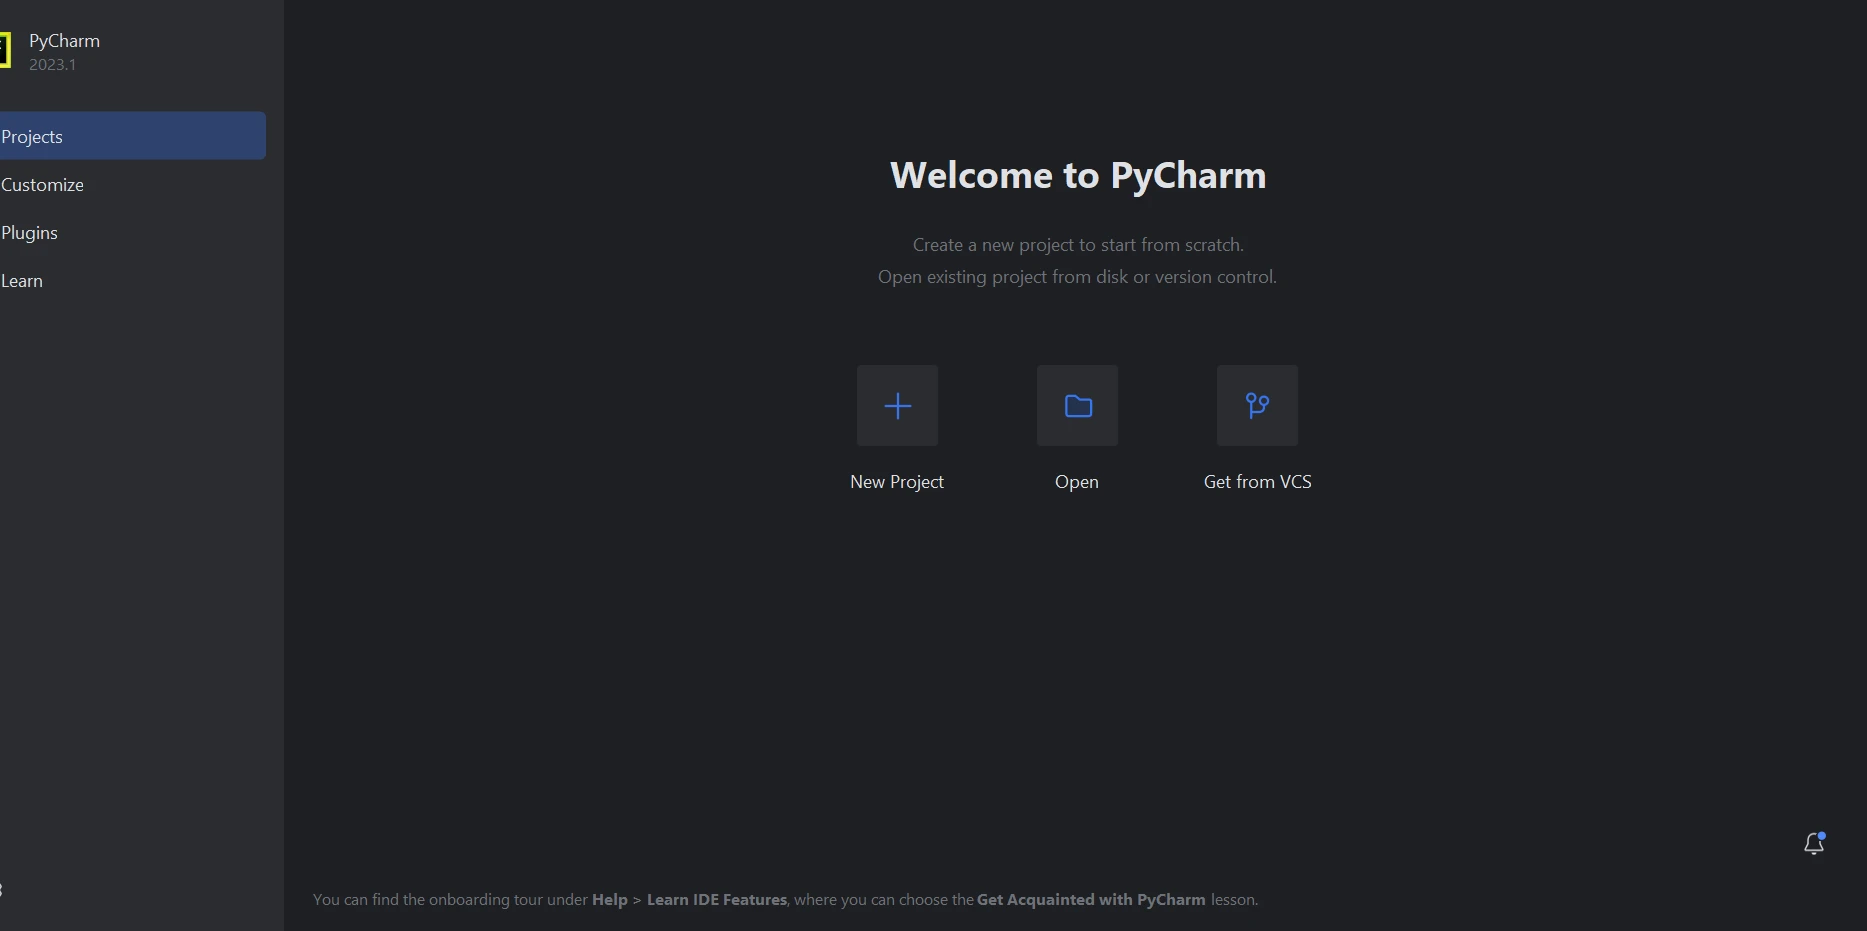 PyCharm IDE
下の図に示すように、"新しいプロジェクト"を選択すると新しいウィンドウが表示され、プロジェクトの場所と Python 環境を定義できるようになります。
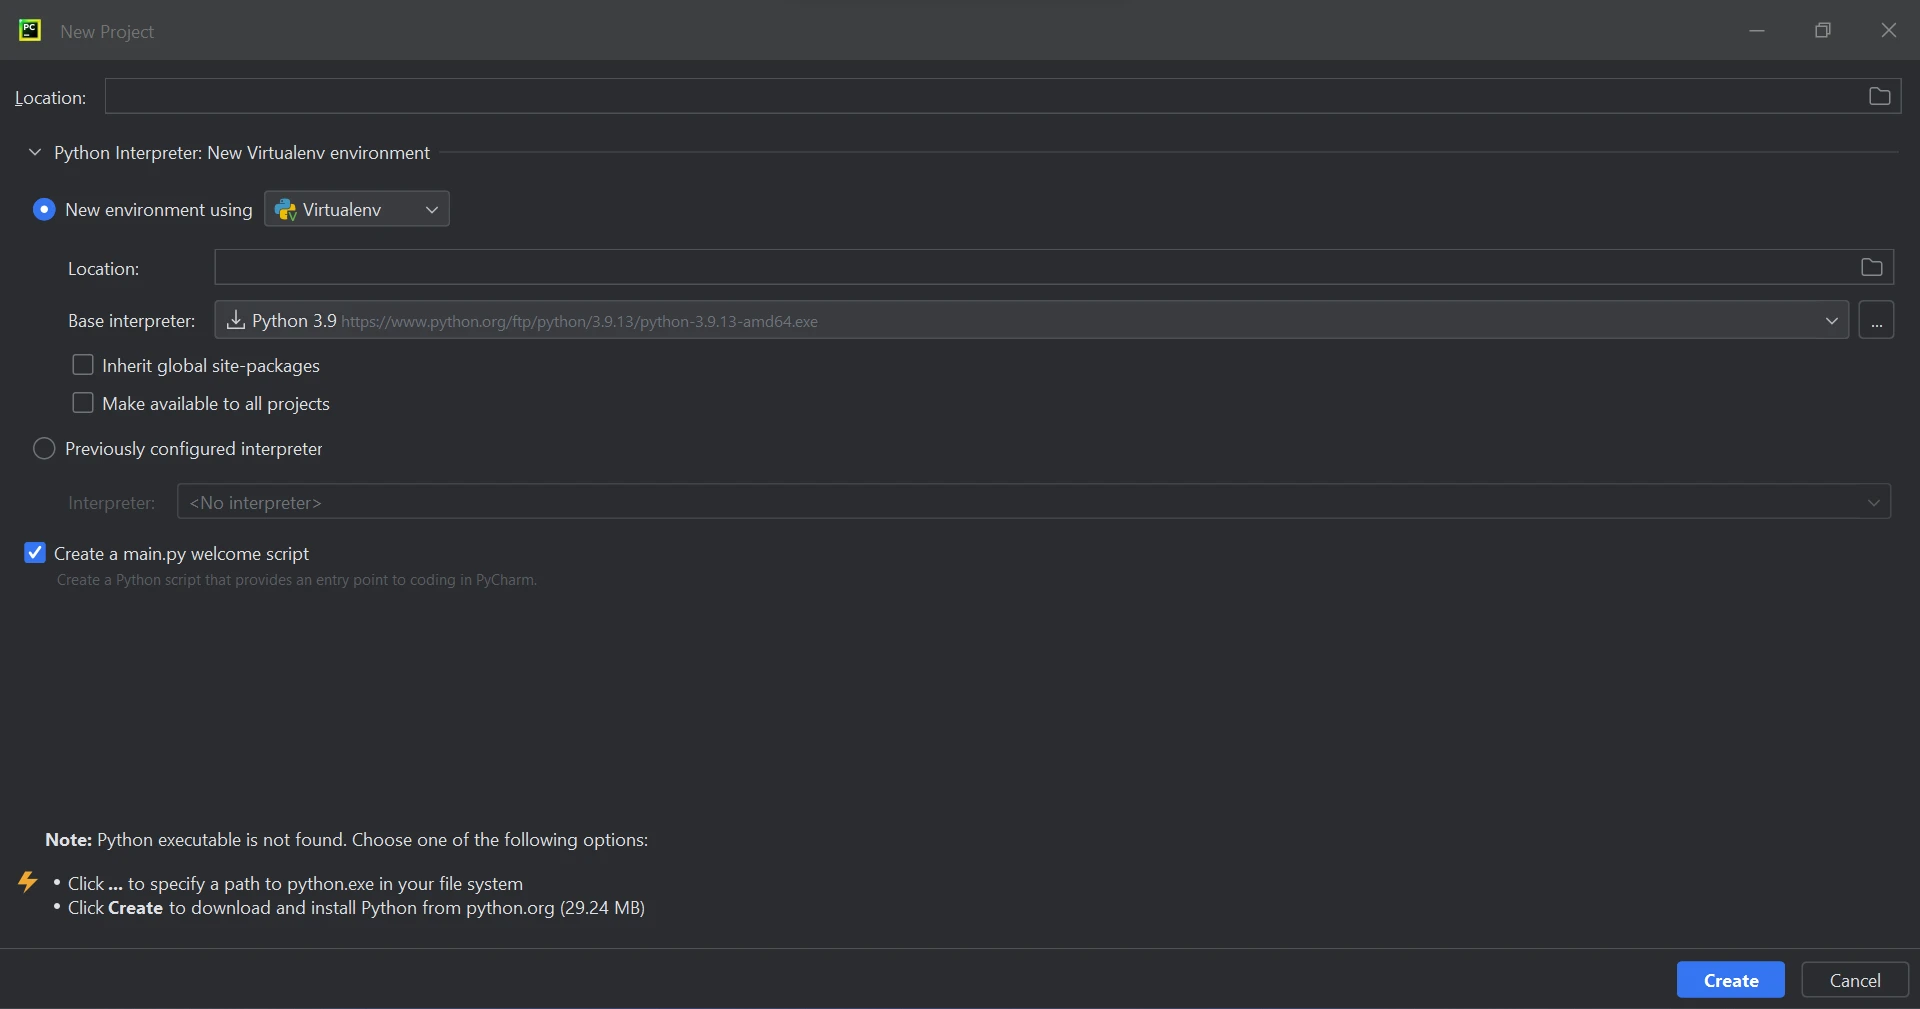 PyCharmで新しいプロジェクトを作成する
プロジェクトの場所と環境を選択したら、 **"作成"**ボタンをクリックしてプロジェクトを開始します。 新しく起動したウィンドウで Python ファイルを開き、コードを入力できます。 このガイドでは Python 3.9 を使用します。
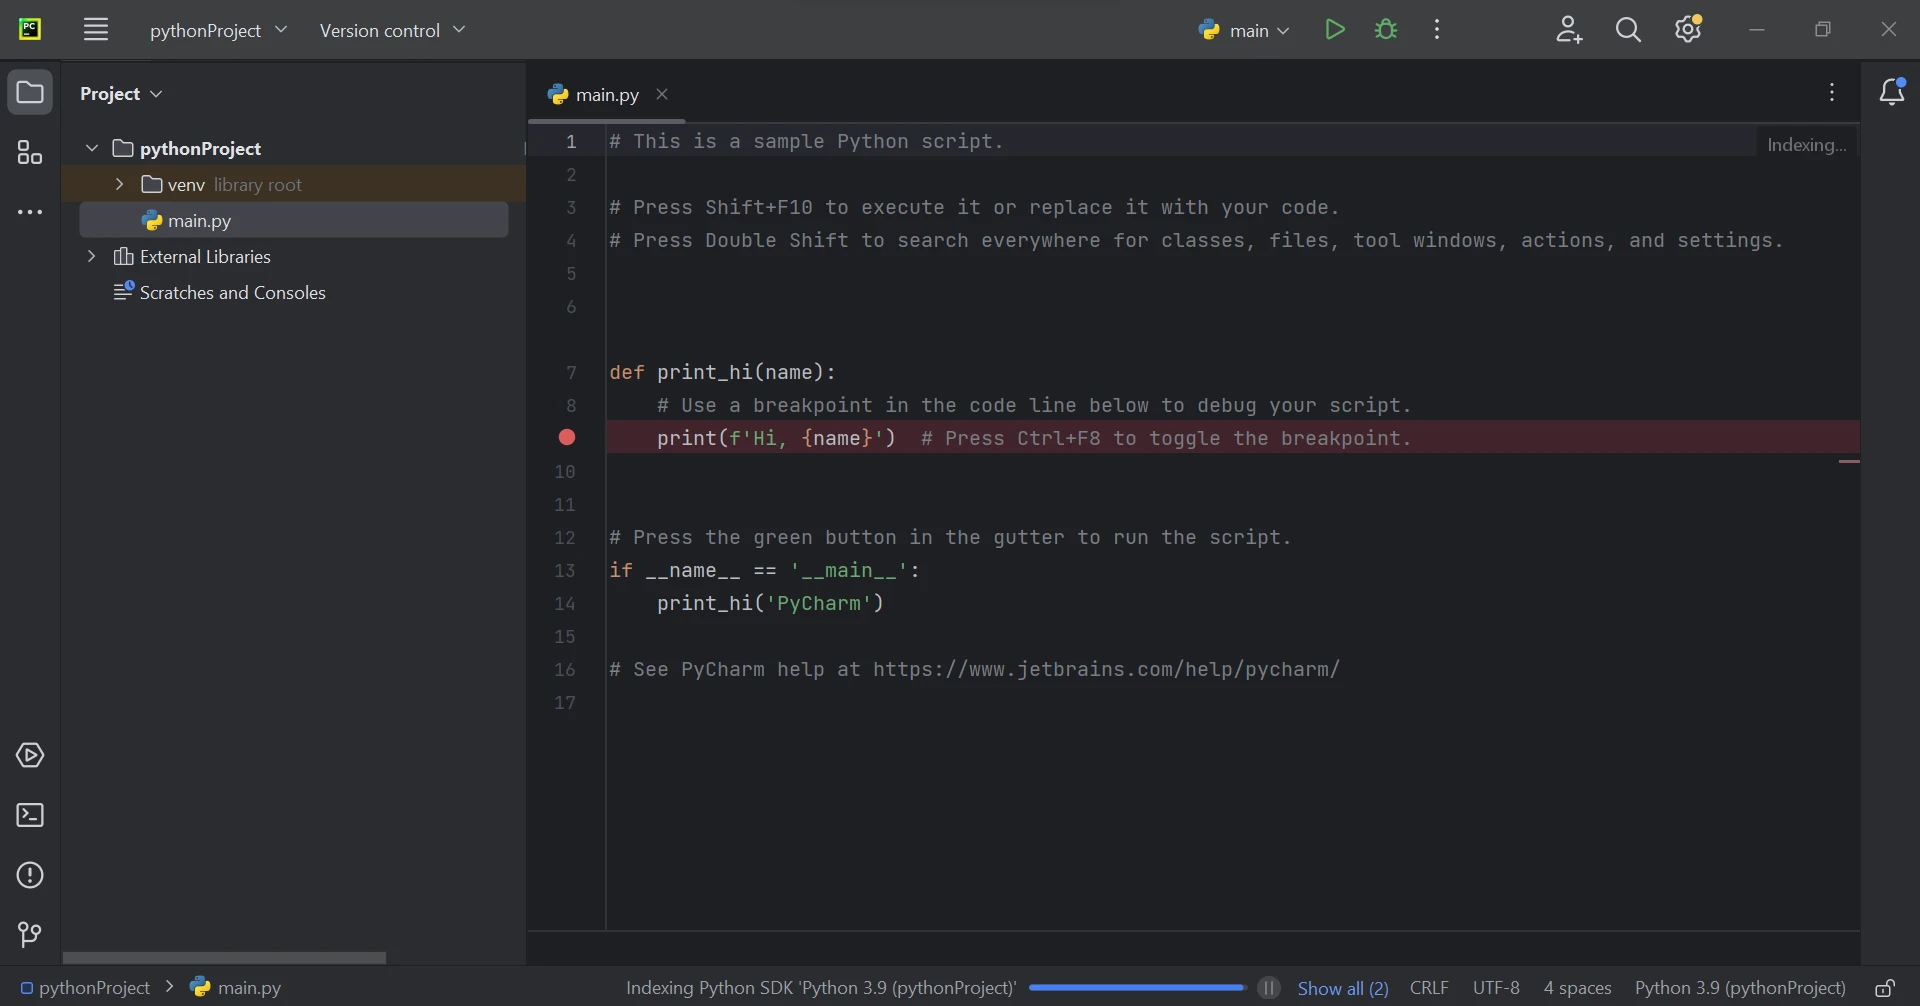 メイン for Pythonファイル
IronPDF for Python は、コア テクノロジーとして .NET 6.0 を採用しています。 したがって、IronPDF Python 向け を使用するには、コンピューターに .NET 6.0 ランタイムがインストールされている必要があります。 Linux および Mac ユーザーは、この Python モジュールを利用する前に .NET をインストールする必要がある場合があります。 必要なランタイム環境を Microsoft からダウンロードします。
".pdf"拡張子のファイルを作成、編集、開くためにironpdfパッケージをインストールする必要があります。 PyCharm にパッケージをインストールするには、ターミナル ウィンドウを開いて次のコマンドを入力します。
以下のスクリーンショットはironpdfパッケージのインストールプロセスを示しています。
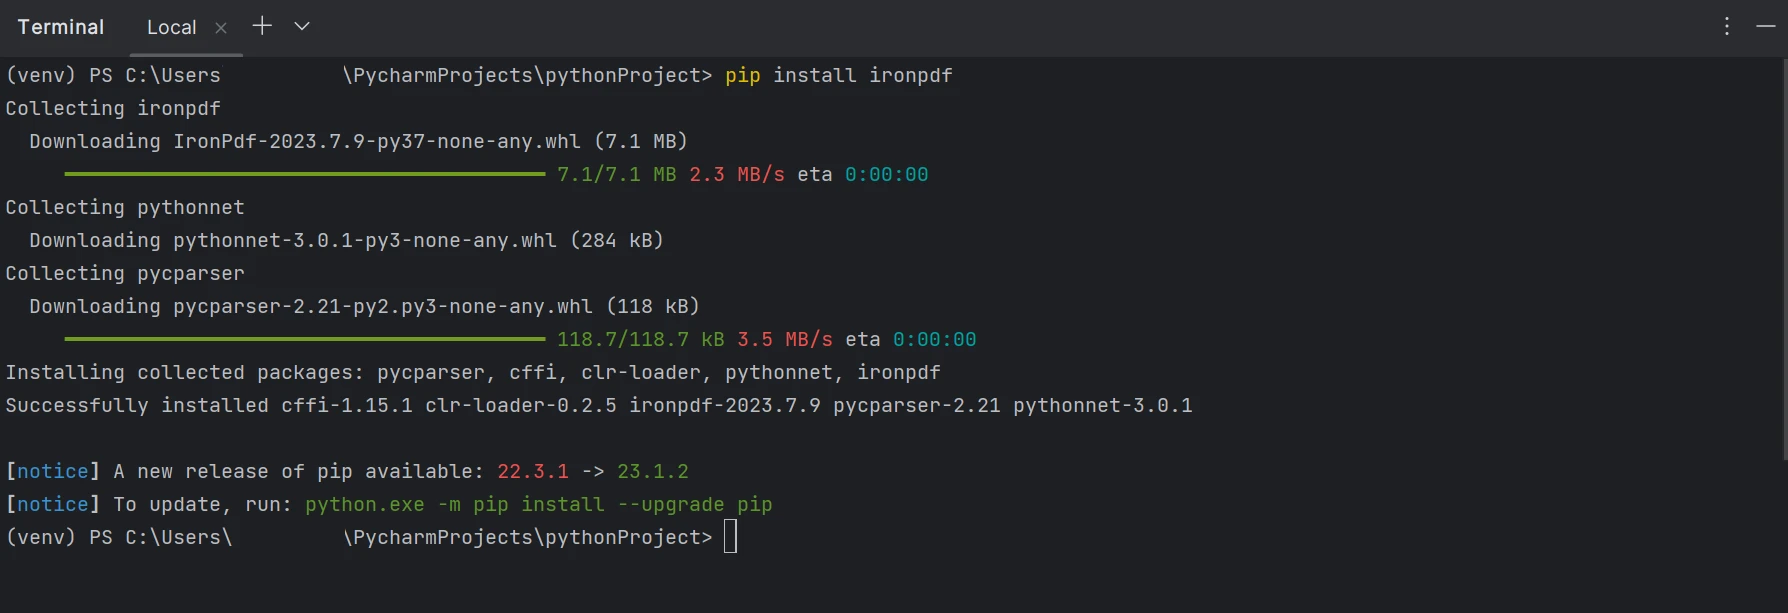 IronPDFパッケージをインストールする
IronPDF for Python ライブラリを使用すると、PDF ファイルから簡単にデータを抽出できます。 IronPDF は、テキスト データの分析と PDF ファイルからの表の抽出を容易にします。 以下は、提供された画像を参照として使用して、PDF テーブルからデータを抽出する方法を示すサンプル コードです。
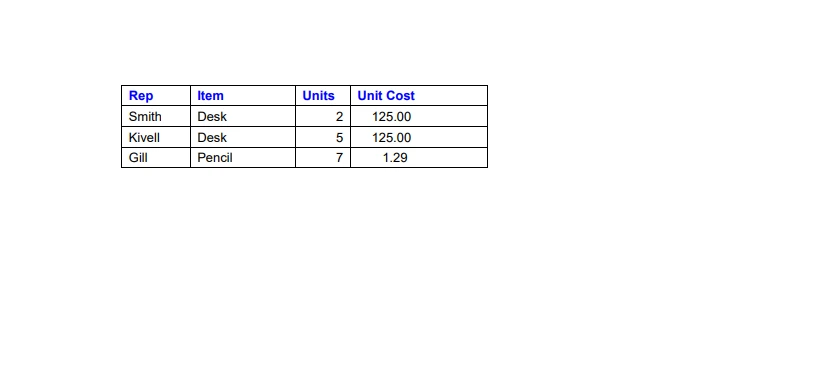 PDFファイルからのサンプルデータ
from ironpdf import PdfDocument

# Load the PDF document
pdf = PdfDocument.FromFile("sampleData.pdf")

# Extract all text from the PDF document
all_text = pdf.ExtractAllText()

# Split the extracted text into rows and print each row
for row in all_text.split("\n"):
print(row)提供されているコードは、わずか数行の Python コードを使用して IronPDF を使用して PDF ファイルから表を抽出する方法を示しています。 最初に、IronPDF ライブラリをインポートしてその機能にアクセスし、IronPDF のすべての機能にアクセスします。 次に、PdfDocumentクラスを利用して、既存のPDFファイルを処理し、さまざまな操作を行うことができます。
FromFile関数を使用すると、入力PDFファイルを読み込むための引数が利用可能です。 その後、ExtractAllText関数がPDFファイル内のすべてのページからすべてのテーブルデータを抽出します。 次に、split関数を使用して、抽出されたテーブルデータを複数の行に分割し、コンソール画面に表示します。
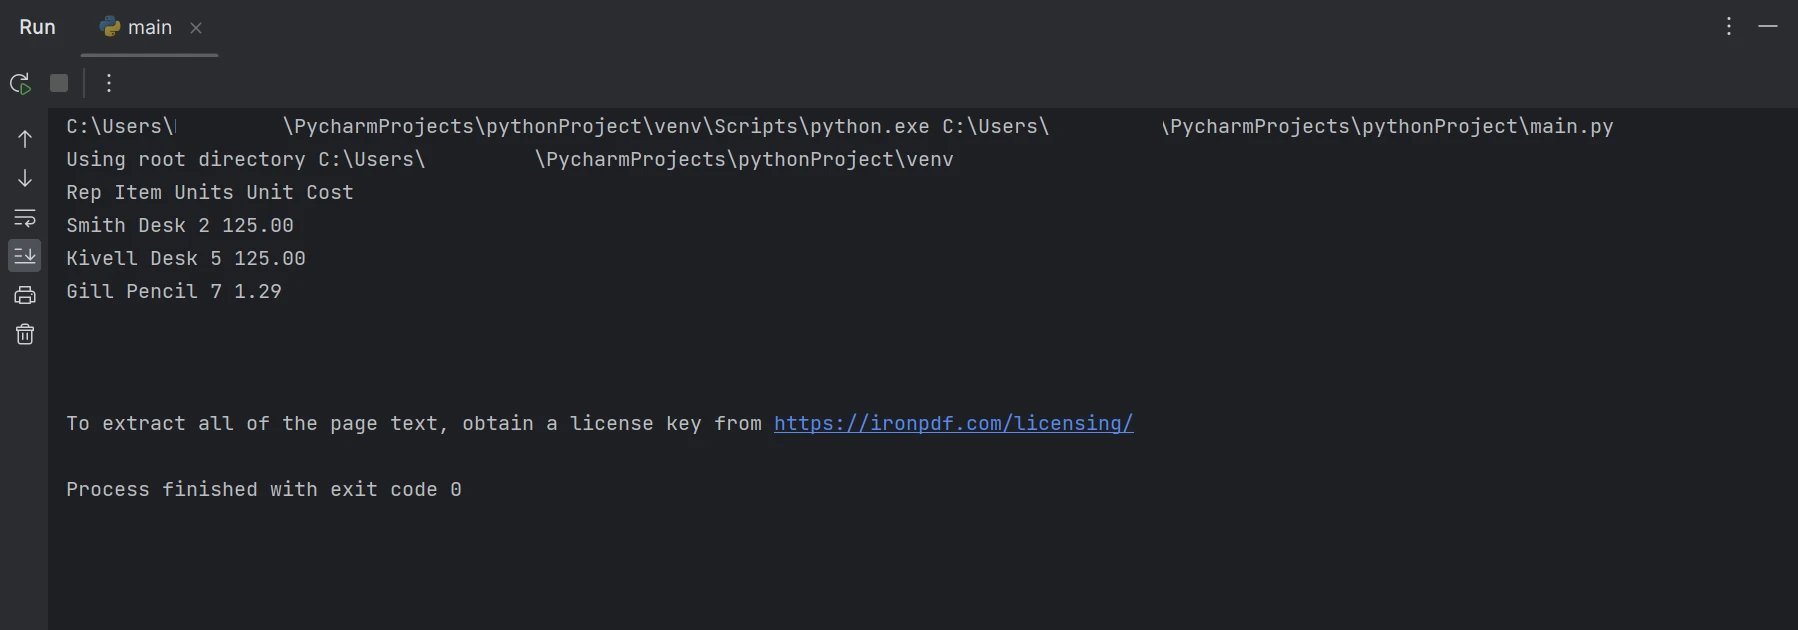 抽出されたデータ
上記の出力では、データが行ごとに表示され、テーブルデータを抽出する方法を示しています。 製品ドキュメントをよく読んで、IronPDF について詳しく学んでください。
IronPDF ライブラリは、潜在的なリスクを最小限に抑え、データのセキュリティを確保するための強力なセキュリティ対策を提供します。 すべての一般的なブラウザと互換性があり、特定のブラウザに限定されません。 IronPDF を使用すると、プログラマーはわずか数行のコードを使用して PDF ファイルを効率的に作成および読み取ることができます。 開発者の多様なニーズに応えるために、IronPDF ライブラリでは、無料の開発者ライセンスや購入可能な追加の開発ライセンスなど、さまざまなライセンス オプションを提供しています。
Liteバンドルは、$999の価格で、永続ライセンス、30日間の返金保証、1年間のソフトウェアメンテナンス、アップグレードの可能性を含んでいます。 初回購入後は追加料金は発生せず、これらのライセンスは運用環境、ステージング環境、開発環境で使用できます。 IronPDF は、時間と再配布の制限がある無料ライセンスも提供しています。 ユーザーは、透かしが入らない無料試用期間を利用して、実際の環境で製品をテストできます。 IronPDF の試用版の料金とライセンスに関する詳細については、次のライセンス ページをクリックしてください。

Curtis Chauは、カールトン大学でコンピュータサイエンスの学士号を取得し、Node.js、TypeScript、JavaScript、およびReactに精通したフロントエンド開発を専門としています。直感的で美しいユーザーインターフェースを作成することに情熱を持ち、Curtisは現代のフレームワークを用いた開発や、構造の良い視覚的に魅力的なマニュアルの作成を楽しんでいます。



IronPDF はIRONSUITEの一部です
オフィス文書向けの.NET API製品10個

PDFがHTMLのように見える必要があるとき、迅速に。



