



更新日 2026年4月21日
PythonでPDFをPNGに変換する方法
この記事では、Python用IronPDFを使用して、PDFをPNG画像ファイルに分割します。
詳しく読む

オンラインスクレイピングとドキュメント生成の分野では、有効性と効率性が非常に重要です。 ウェブサイトからデータを抽出し、その後プロフェッショナルなレベルのドキュメントに変換するには、強力なツールとフレームワークのスムーズな統合が必要です。
ここに登場するのがScrapy、PythonのウェブスクレイピングフレームワークとIronPDFです。これら2つの強力なライブラリが連携して、オンラインデータの抽出と動的なPDF作成を最適化します。
開発者はPythonのScrapyを利用することで、複雑なウェブを簡単に閲覧し、素早く精密に構造化されたデータを抽出することができます。これはトップクラスのウェブクロールおよびスクレイピングライブラリです。 堅牢なXPathとCSSセレクタ、非同期アーキテクチャにより、あらゆる複雑さのスクレイピングタスクに最適な選択肢となります。
一方、IronPDFはプログラムによるPDFドキュメントの作成、編集、操作をサポートする強力な.NETライブラリです。 IronPDFは強力なPDF作成ツールを備え、HTMLからPDFへの変換やPDF編集機能を通じて、開発者に動的で視覚的に魅力的なPDFドキュメントを生成するための包括的なソリューションを提供します。
この記事ではScrapy PythonとIronPDFのスムーズな統合を紹介し、この動的なペアがウェブスクレイピングとドキュメント作成の方法を如何に変革するかをご覧に入れます。 これら2つのライブラリがどのように連携して複雑な作業を容易にし、開発ワークフローを加速するかをお見せします。Scrapyでウェブからデータをスクレイプし、IronPDFで動的にPDFレポートを生成するところまでを紹介します。
IronPDFを使用してScrapyを最大限に活用し、ウェブスクレイピングとドキュメント生成の可能性を探りましょう。

Scrapyが使用する非同期アーキテクチャにより、複数のリクエストを同時に処理することが可能です。 これにより、特に複雑なウェブサイトや大量のデータを扱う場合に、効率が向上し、ウェブスクレイピング速度が向上します。
Scrapyには、URLの自動フィルタリング、リクエストスケジュールの設定、統合されたrobots.txt指示処理など、強力なScrapyクロールプロセス管理機能があります。 開発者は、自分のニーズに合わせてクロールの挙動を調整し、ウェブサイトのガイドラインへの遵守を保証できます。
Scrapyは、XPathおよびCSSセレクタを使用してHTMLページ内をナビゲートし、アイテムを選択することをユーザーに許可します。 この適応性により、ウェブページ上の特定の要素やパターンをターゲットにすることで、データ抽出がより精確で信頼性が高くなります。
開発者は、輸出や保存前にスクレープされたデータを処理するための再利用可能なコンポーネントを、Scrapyのアイテムパイプラインを使って指定できます。クリーンニング、検証、変換、および重複排除などの操作を実行することにより、抽出済みデータの精度と一貫性を保証できます。
Scrapyにプリインストールされた多数のミドルウェアコンポーネントは、自動クッキー処理、リクエストスロットリング、ユーザーエージェントの回転、プロキシ回転などの機能を提供します。 これらのミドルウェア要素は、スクレイピングの効率を改善し、一般的な問題に対処するために、簡単に構成およびカスタマイズが可能です。
カスタムミドルウェア、拡張機能、およびパイプラインを作成することで、開発者はScrapyのモジュラおよび拡張可能なアーキテクチャを利用して、Scrapyの機能をさらにカスタマイズし拡張できます。 その適応性により、開発者はScrapyを現在のプロセスに簡単に統合し、特定のスクレイピングニーズに合わせてそれを調整できます。
pipを使用して次のコマンドを実行し、Scrapyをインストールします。
pip install scrapyあなたのスパイダーを定義するために、example.py)を作成します。 ここにURLから抽出する基本的なスパイダーの例を示します。
import scrapy

class QuotesSpider(scrapy.Spider):
    # Name of the spider
    name = 'quotes'
    # Starting URL
    start_urls = ['http://quotes.toscrape.com']

    def parse(self, response):
        # Iterate through each quote block in the response
        for quote in response.css('div.quote'):
            # Extract and yield quote details
            yield {
                'text': quote.css('span.text::text').get(),
                'author': quote.css('span small.author::text').get(),
                'tags': quote.css('div.tags a.tag::text').getall(),
            }
        # Identify and follow the next page link
        next_page = response.css('li.next a::attr(href)').get()
        if next_page is not None:
yield response.follow(next_page, self.parse)ユーザーエージェント、ダウンロード遅延、パイプラインなどのScrapyプロジェクトパラメータを設定するには、settings.pyファイルを編集します。ここではユーザーエージェントを変更し、パイプラインを機能させる方法のイラストを示しています。
# Obey robots.txt rules
ROBOTSTXT_OBEY = True
# Set user-agent
USER_AGENT = 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.3'
# Configure pipelines
ITEM_PIPELINES = {
    'myproject.pipelines.MyPipeline': 300,
}ScrapyとIronPDFを開始するには、Scrapyの強力なウェブスクレイピング能力とIronPDFの動的なPDF生成機能を組み合わせる必要があります。 以下に示す手順でScrapyプロジェクトを設定し、ウェブサイトからデータを抽出し、IronPDFを使ってデータを含むPDFドキュメントを作成できるようにします。
IronPDFは、C#、VB.NETなど for .NET言語でプログラムによるPDFドキュメントの作成、編集、および変更を行うための強力な.NETライブラリです。 高品質なPDFを動的に作成するための多様な機能セットを開発者に提供するため、多くのプログラムにおいて人気の選択肢です。
PDF生成: IronPDFを使用し、プログラマーは新しいPDFドキュメントを作成したり、タグ、テキスト、画像、および他のファイル形式など、既存のHTML要素をPDFに変換できます。 この機能は、動的にレポート、請求書、領収書、その他のドキュメントを作成するために非常に役立ちます。
HTMLからPDFへの変換: IronPDFは開発者に、JavaScriptやCSSのスタイルを含むHTMLドキュメントをPDFファイルに変換することを容易にします。 これにより、ウェブページや動的に生成されたコンテンツ、HTMLテンプレートからのPDFの作成が可能になります。
PDFドキュメントの修正と編集: IronPDFは、既存のPDFドキュメントを修正および変更するための包括的な機能セットを提供します。 開発者は複数のPDFファイルを結合したり、別々のドキュメントに分割したり、ページを削除したり、ブックマーク、注釈、透かしを追加したりと、PDFを自身のニーズに合わせてカスタマイズできます。
Pythonがコンピューターにインストールされていることを確認した後、pipを使ってIronPDFをインストールします。
あなたのスパイダーを定義するために、Scrapyプロジェクト(example.py)を作成します。 URLから引用を抽出する基本的なスパイダーのコード例を示します。
import scrapy
from IronPdf import *

class QuotesSpider(scrapy.Spider):
    name = 'quotes'
    # Web page link
    start_urls = ['http://quotes.toscrape.com']

    def parse(self, response):
        quotes = []
        for quote in response.css('div.quote'):
            title = quote.css('span.text::text').get()
            content = quote.css('span small.author::text').get()
            quotes.append((title, content))  # Append quote to list

        # Generate PDF document using IronPDF
        renderer = ChromePdfRenderer()
        pdf = renderer.RenderHtmlAsPdf(self.get_pdf_content(quotes))
        pdf.SaveAs("quotes.pdf")

    def get_pdf_content(self, quotes):
        # Generate HTML content for PDF using extracted quotes
        html_content = "<html><head><title>Quotes</title></head><body>"
        for title, content in quotes:
            html_content += f"<h2>{title}</h2><p>Author: {content}</p>"
        html_content += "</body></html>"
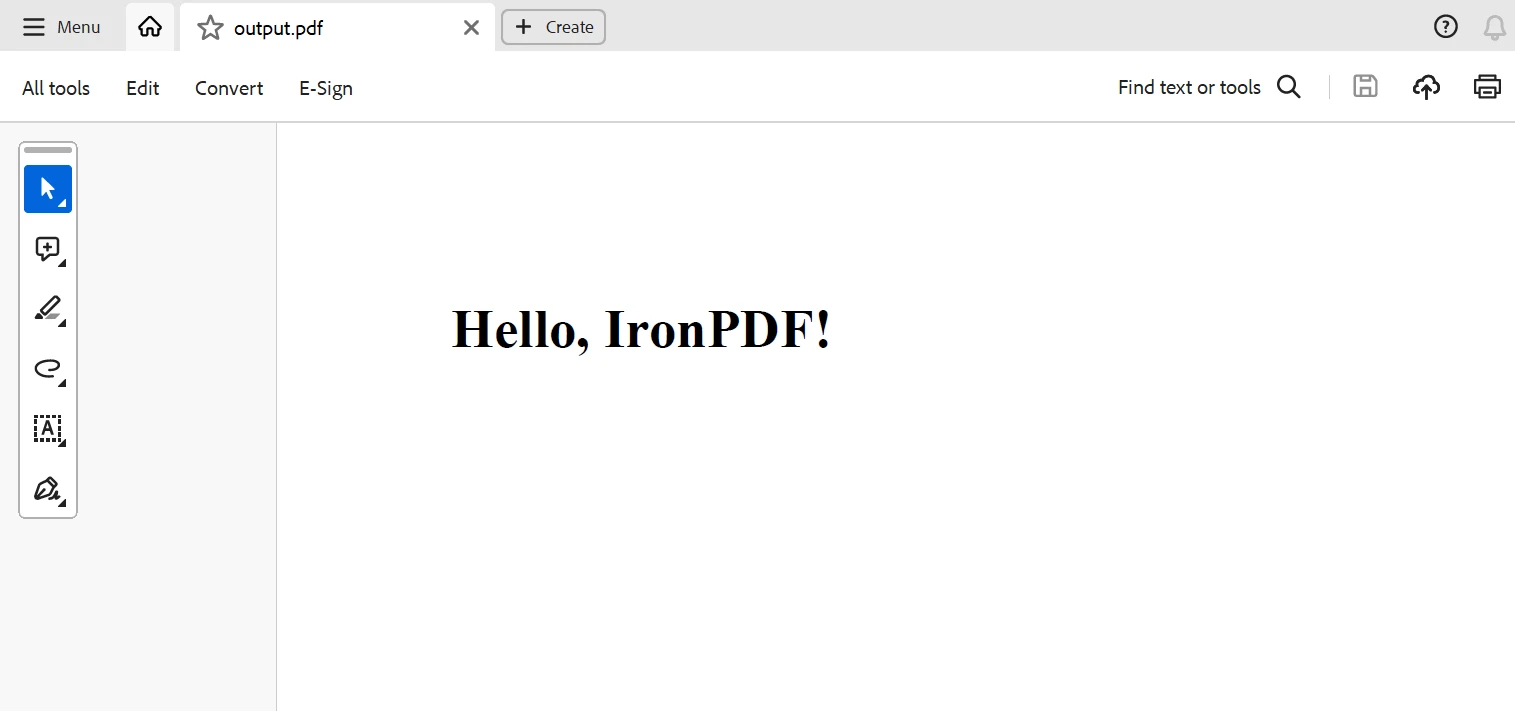
return html_content上記のIronPDFを使ったScrapyプロジェクトのコード例では、Scrapyで抽出されたデータを用いてPDFドキュメントを作成するためにIronPDFが使用されています。
ここで、スパイダーのquotes.pdfとして保存されます。
要約すると、ScrapyとIronPDFの組み合わせは、開発者にウェブスクレイピング活動を自動化し、PDF文書をその場で生成する強力なオプションを提供します。 IronPDFの柔軟なPDF生成機能とScrapyの強力なウェブクローリングおよびスクレイピング能力が組み合わさることで、どんなウェブページからも構造化されたデータを集め、抽出したデータをプロ級のPDFレポート、請求書、またはドキュメントに変換するためのスムーズなプロセスを提供します。
Scrapy Spider Pythonを利用することで、開発者はインターネットの複雑さを効果的にナビゲートし、多くのソースから情報を取得し、それを体系的に整理できます。 Scrapyの柔軟なフレームワーク、非同期アーキテクチャ、およびXPathやCSSセレクタのサポートにより、さまざまなウェブスクレイピング活動を管理するための柔軟性とスケーラビリティが提供されます。
IronPDF にはライフタイムライセンスが含まれており、バンドルで購入されるとかなり手頃な価格です。 このパッケージは$999(複数のシステム用の一度の購入)で非常に優れた価値を提供します。 ライセンスを持っている人は、24時間体制のオンライン技術サポートを利用できます。 追加の料金詳細については、ウェブサイトをご参照ください。 Iron Softwareの製品についてもっと知りたい場合は、このページを訪れてください。

Curtis Chauは、カールトン大学でコンピュータサイエンスの学士号を取得し、Node.js、TypeScript、JavaScript、およびReactに精通したフロントエンド開発を専門としています。直感的で美しいユーザーインターフェースを作成することに情熱を持ち、Curtisは現代のフレームワークを用いた開発や、構造の良い視覚的に魅力的なマニュアルの作成を楽しんでいます。


IronPDF はIRONSUITEの一部です
オフィス文書向けの.NET API製品10個

PDFがHTMLのように見える必要があるとき、迅速に。



