



更新日 2026年4月21日
Scrapy in Python(開発者向けのしくみ)
ここにScrapy、PythonにおけるWebスクレイピングフレームワークとIronPDFが登場し、オンラインデータの抽出と動的PDFの作成を最適化するための2つの強力なライブラリが協力しています。
詳しく読む

この記事では、IronPDFライブラリを使用してPythonでPDFファイルを表示する方法を探ります。
IronPDF は、開発者がプログラム的にPDFファイルを操作できる強力なPythonライブラリです。 IronPDFを使用すると、PDFドキュメントからデータを生成、操作、抽出することが容易になり、さまざまなPDF関連のタスクにおいて多用途なツールになります。 スクラッチからPDFを作成する必要がある場合でも、既存のPDFを変更する場合でも、PDFからコンテンツを抽出する場合でも、IronPDFはワークフローを簡素化するための包括的な機能セットを提供します。
IronPDF for Python ライブラリの機能には次のようなものがあります。
注: IronPDFは、透かし入りのPDFデータファイルを生成します。透かしを削除するには、IronPDFをライセンスする必要があります。 IronPDFのライセンスバージョンを使用したい場合は、IronPDDFのWebサイトを訪れてライセンスキーを取得してください。
PythonでIronPDFを使用する前に、いくつかの前提条件があります:
**Python のインストール:**システムに Python がインストールされていることを確認します。 IronPDFはPython 3.xバージョンと互換性があるため、互換性のあるPythonインストールを持っていることを確認してください。
IronPDFライブラリ: IronPDFライブラリをインストールして、その機能にアクセスします。 Pythonのパッケージマネージャー(pip)を使用して、以下のコマンドをコマンドラインインターフェースで実行してインストールできます:
Tkinter ライブラリ: Tkinter は Python の標準 GUI ツールキットです。 提供されたコードスニペットでPDFビューアのGUIを作成するために使用します。 Tkinterは通常、Pythonにプレインストールされていますが、問題が発生した場合は、パッケージマネージャーを使用してインストールできます:
pip install tkinterPillow ライブラリ: Pillow ライブラリは Python Imaging Library (PIL) のフォークであり、追加の画像処理機能を提供します。 コードスニペットでは、PDFから抽出された画像を読み込んで表示するために使用します。 パッケージマネージャーを使用してPillowをインストールします:
pip install pillow5.統合開発環境 (IDE): IDE を使用して Python プロジェクトを処理すると、開発エクスペリエンスが大幅に向上します。 コード補完、デバッグ、より合理化されたワークフローなどの機能を提供します。 Python 開発用の人気のある IDE の 1 つは PyCharm です。 JetBrainsのWebサイトからPyCharmをダウンロードしてインストールできます(https://www.jetbrains.com/pycharm/)。 6.**テキスト エディター:**軽量のテキスト エディターを使用する場合は、Visual Studio Code、Sublime Text、Atom など、任意のテキスト エディターを使用することもできます。 これらのエディターは、構文の強調表示や Python 開発に役立つその他の機能を提供します。 Pythonスクリプトを作成するためにPython自身のIDEアプリも使用できます。
PyCharm IDEをインストールした後、以下の手順に従ってPyCharm Pythonプロジェクトを作成します:
**PyCharm を起動します。**システムのアプリケーション ランチャーまたはデスクトップ ショートカットから PyCharm を開きます。 2.新しいプロジェクトを作成する: "新しいプロジェクトの作成"をクリックするか、既存の Python プロジェクトを開きます。
 PyCharm IDE
3.**プロジェクト設定を構成する:**プロジェクトの名前を指定し、プロジェクト ディレクトリを作成する場所を選択します。 プロジェクト用の Python インタープリターを選択します。 次に"作成"をクリックします。
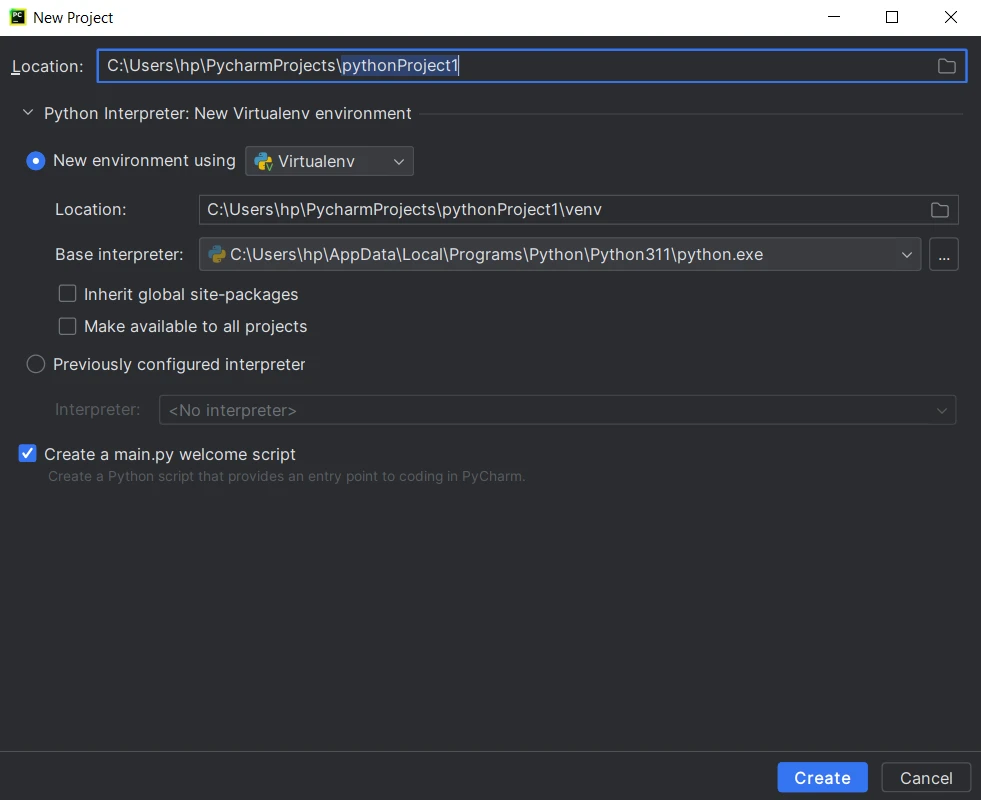 新しいPythonプロジェクトを作成
4.ソース ファイルの作成: PyCharm は、メインの Python ファイルと追加のソース ファイル用のディレクトリを含むプロジェクト構造を作成します。 コードの記述を開始し、実行ボタンをクリックするか、Shift + F10 を押してスクリプトを実行します。
まず、必要なライブラリをインポートします。 この場合、PILライブラリが必要です。 tkinterはグラフィカルユーザーインターフェース (GUI) の作成に使用され、PILは画像の操作に使用されます。
import os
import shutil
import ironpdf
from tkinter import *
from PIL import Image, ImageTk次に、convert_pdf_to_imagesという名前の関数を定義します。 この関数は、PDFファイルのパスを入力として受け取ります。 関数内では、IronPDFライブラリを使用してファイルからPDFドキュメントを読み込みます。次に、抽出された画像ファイルを保存するためのフォルダパスを指定します。 IronPDFのpdf.RasterizeToImageFilesメソッドは、各PDFページを画像ファイルに変換して指定されたフォルダに保存するために使われます。 画像パスを保存するためにリストが使用されます。 完全なコード例は次の通りです:
def convert_pdf_to_images(pdf_file):
    """Convert each page of a PDF file to an image."""
    pdf = ironpdf.PdfDocument.FromFile(pdf_file)
    # Extract all pages to a folder as image files
    folder_path = "images"
    pdf.RasterizeToImageFiles(os.path.join(folder_path, "*.png"))
    # List to store the image paths
    image_paths = []
    # Get the list of image files in the folder
    for filename in os.listdir(folder_path):
        if filename.lower().endswith((".png", ".jpg", ".jpeg", ".gif")):
            image_paths.append(os.path.join(folder_path, filename))
return image_pathsPDFドキュメントからテキストを抽出するには、このコード例のページをご覧ください。
アプリケーションウィンドウが閉じられるときに抽出された画像ファイルをクリーンアップするために、on_closing関数を定義します。 この関数内で、imagesフォルダ全体を削除します。 次に、この関数をウィンドウが閉じられたときに実行されるプロトコルとして設定します。 以下のコードは、タスクを達成するためのものです:
def on_closing():
    """Handle the window closing event by cleaning up the images."""
    # Delete the images in the 'images' folder
    shutil.rmtree("images")
    window.destroy()

window.protocol("WM_DELETE_WINDOW", on_closing)次に、Tk()コンストラクターを使用してメインのGUIウィンドウを作成し、ウィンドウのタイトルを"Image Viewer"に設定し、on_closing()関数をウィンドウのクローズを処理するプロトコルとして設定します。
window = Tk()
window.title("Image Viewer")
window.protocol("WM_DELETE_WINDOW", on_closing)画像を表示してスクロールを有効にするために、Canvasウィジェットを作成します。 pack(side=LEFT, fill=BOTH, expand=True)を使用して利用可能なスペースを埋め、両方の方向に拡張するように設定されています。 さらに、Scrollbarウィジェットを作成して、すべてのページとキャンバスの垂直スクロールを制御するように設定します。
canvas = Canvas(window)
canvas.pack(side=LEFT, fill=BOTH, expand=True)

scrollbar = Scrollbar(window, command=canvas.yview)
scrollbar.pack(side=RIGHT, fill=Y)
canvas.configure(yscrollcommand=scrollbar.set)

# Update the scrollregion to encompass the entire canvas
canvas.bind("<Configure>", lambda e: canvas.configure(
    scrollregion=canvas.bbox("all")))

# Configure the vertical scrolling using mouse wheel
canvas.bind_all("<MouseWheel>", lambda e: canvas.yview_scroll(
int(-1*(e.delta/120)), "units"))次に、キャンバス内にcreate_window()を使用してキャンバス内にフレームを配置します。 anchor='nw'パラメーターが、キャンバスの左上隅からフレームが開始されることを保証します。
frame = Frame(canvas)
canvas.create_window((0, 0), window=frame, anchor="nw")次のステップは、入力PDFファイルのファイルパス名を使ってconvert_pdf_to_images()関数を呼び出すことです。この関数はPDFページを画像として抽出し、画像パスのリストを返します。 画像パスを反復処理し、PILライブラリのImageTk.PhotoImage()を使用して作成します。 次に、画像を表示するためにLabelウィジェットを作成します。
images = convert_pdf_to_images("input.pdf")
# Load and display the images in the Frame
for image_path in images:
    image = Image.open(image_path)
    photo = ImageTk.PhotoImage(image)
    label = Label(frame, image=photo)
    label.image = photo  # Store a reference to prevent garbage collection
label.pack(pady=10)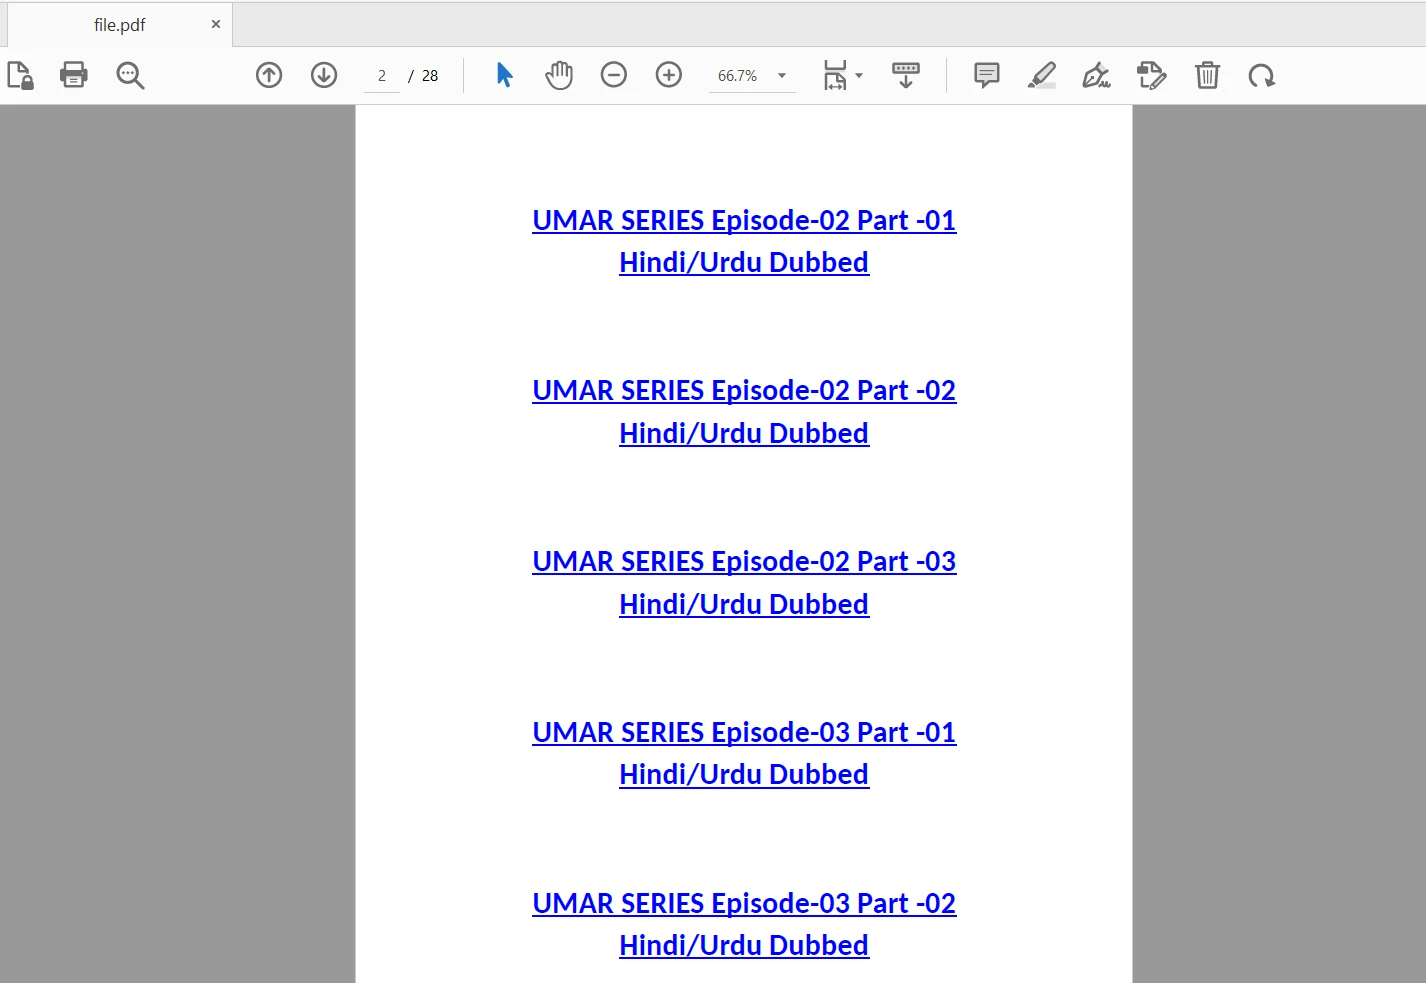 入力ファイル
最後に、window.mainloop()を使用してメインイベントループを実行しましょう。 これにより、GUIウィンドウが開かれていて、ユーザーが閉じるまで応答し続けます。
window.mainloop()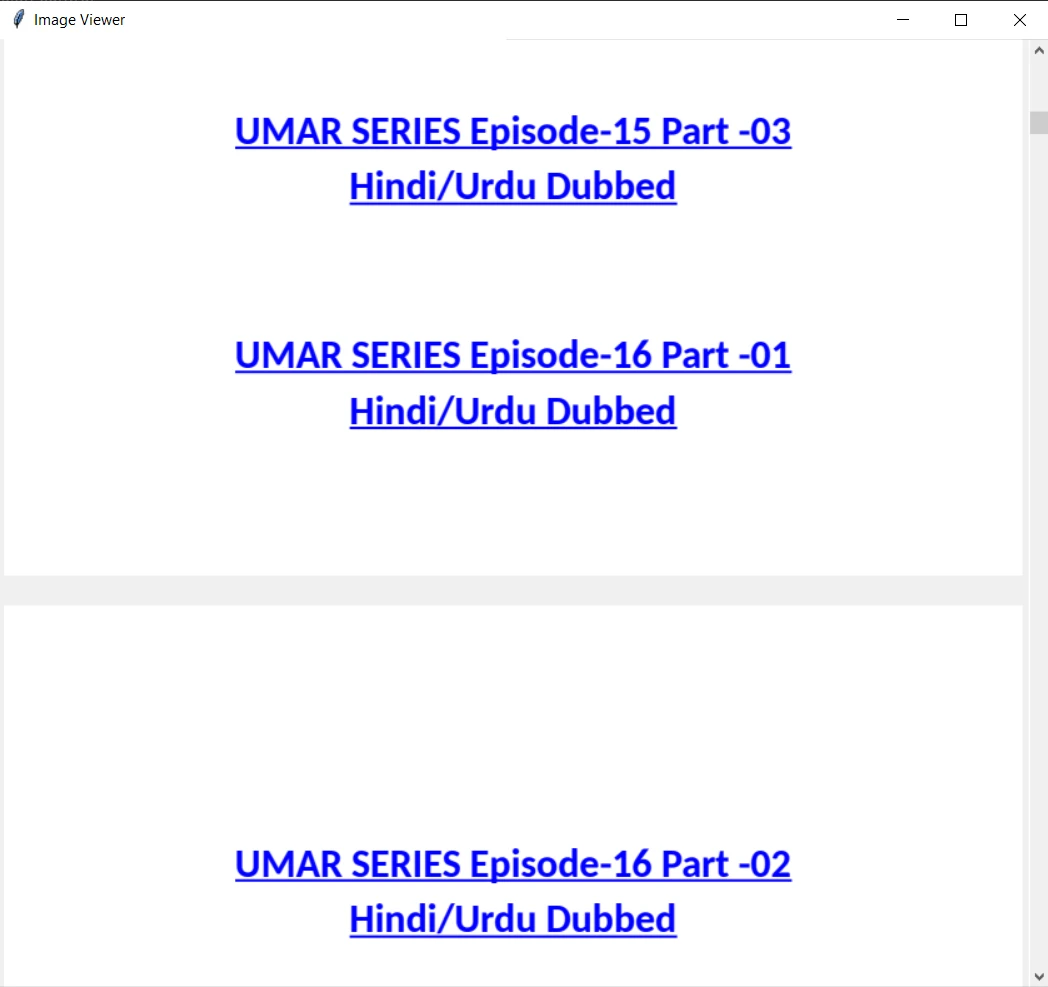 UIの出力
このチュートリアルでは、IronPDFライブラリを使用してPythonでPDFドキュメントを表示する方法を探りました。 PDFファイルを開いて一連の画像ファイルに変換し、それをスクロール可能なキャンバスに表示し、アプリケーションが閉じられたときに抽出された画像をクリーンアップする手順をカバーしました。
Python用IronPDFライブラリの詳細については、ドキュメントを参照してください。
Python用IronPDFライブラリをダウンロードしてインストールし、商業開発でその完全な機能をテストするための無料トライアルも取得してください。

Curtis Chauは、カールトン大学でコンピュータサイエンスの学士号を取得し、Node.js、TypeScript、JavaScript、およびReactに精通したフロントエンド開発を専門としています。直感的で美しいユーザーインターフェースを作成することに情熱を持ち、Curtisは現代のフレームワークを用いた開発や、構造の良い視覚的に魅力的なマニュアルの作成を楽しんでいます。



IronPDF はIRONSUITEの一部です
オフィス文書向けの.NET API製品10個

PDFがHTMLのように見える必要があるとき、迅速に。



