# Fusionar archivos PDF en un único PDF con Python
IronPDF for Python proporciona una solución directa para fusionar múltiples documentos PDF en un solo archivo utilizando el método `PdfDocument.Merge()`, que admite tanto la fusión de dos archivos como operaciones por lotes para combinar numerosos PDFs de manera eficiente.
PDF (Formato de Documento Portátil) es el estándar para compartir documentos que deben verse idénticos en todas las plataformas y aplicaciones. Ya sea que esté consolidando informes, combinando documentos escaneados o ensamblando formularios de varias partes, fusionar contenido PDF de varias fuentes es un requisito recurrente en los flujos de trabajo de negocios y de procesamiento de datos.
IronPDF maneja esta operación en Python con una sola llamada de método. Esta guía cubre la instalación, la fusión básica de dos archivos y las operaciones por lotes para combinar múltiples documentos a la vez.
*as-heading:2(Inicio rápido: fusionar archivos PDF en Python)*
```python
#:path=/static-assets/pdf/content-code-examples/how-to/python-merge-pdf/quickstart.py
from ironpdf import *

renderer = ChromePdfRenderer()
pdf_a = renderer.RenderHtmlAsPdf("<p>Document A</p>")
pdf_b = renderer.RenderHtmlAsPdf("<p>Document B</p>")

merged = PdfDocument.Merge([pdf_a, pdf_b])
merged.SaveAs("merged.pdf")
```
<div class="hsg-featured-snippet">
<h3>Flujo de trabajo mínimo (5 pasos)</h3>
<ol>
<li><a class="js-modal-open" data-modal-id="download-modal" href="#download-modal">Instalar la biblioteca Python para combinar archivos PDF</a></li>
<li>Use <code>RenderHtmlAsPdf</code> para generar archivos PDF individuales, o cargue los existentes con <code>PdfDocument.FromFile</code></li>
<li>Aplique el método <code>Merge</code> para combinar archivos PDF en un solo <code>PdfDocument</code></li>
<li>Guarde el documento fusionado con <code>SaveAs</code></li>
<li>Para múltiples PDFs, pase una lista de objetos <code>PdfDocument</code> a <code>Merge</code></li>
</ol>
</div>
## ¿Cómo instalo IronPDF for Python?
IronPDF está disponible como un paquete de Python a través de pip. Requiere Python 3.x y funciona en Windows y Linux sin depender de sistemas adicionales para operaciones de fusión estándar. El paquete viene con un motor de renderizado basado en Chrome que maneja la conversión de HTML a PDF internamente.
Instala la biblioteca `IronPdf` usando pip con el siguiente comando:
```shell
:ProductInstall
```
Para instrucciones detalladas de instalación y ayuda con problemas comunes como [errores "Módulo no definido"](https://ironpdf.com/python/troubleshooting/module-not-defined/) o [problemas de permisos](https://ironpdf.com/python/troubleshooting/could-not-install-package/), consulte la documentación oficial.
### ¿Qué declaraciones de importación se requieren?
En su script de Python, incluya las siguientes declaraciones de importación para acceder a las funciones de generación y fusión de PDFs de IronPDF:
```python
#:path=/static-assets/pdf/content-code-examples/how-to/python-merge-pdf/imports.py
from ironpdf import *

# Set your license key for production use
License.LicenseKey = "YOUR-LICENSE-KEY-HERE"
```
Para aplicaciones de producción, [configure su clave de licencia](https://ironpdf.com/python/get-started/license-keys/) para desbloquear el conjunto completo de características de IronPDF. Hay una prueba gratuita disponible - [comienza tu prueba gratuita](trial-license) para empezar sin compra.
## ¿Cómo combinar dos archivos PDF en Python?
[Fusionar archivos PDF en Python](/python/examples/merge-pdfs/) implica dos pasos: crear los documentos PDF de origen, luego combinarlos con `PdfDocument.Merge()`. El método acepta una lista de objetos `PdfDocument` y produce un nuevo documento combinado en el orden en que aparecen los elementos en la lista.
A continuación hay un ejemplo completo y funcional:
```python
#:path=/static-assets/pdf/content-code-examples/how-to/python-merge-pdf/merge-two-pdfs.py
from ironpdf import *
# HTML content for the first PDF
html_a = """<p> [PDF_A] </p>
<p> [PDF_A] 1st Page </p>
<div style='page-break-after: always;'></div>
<p> [PDF_A] 2nd Page</p>"""
# HTML content for the second PDF
html_b = """<p> [PDF_B] </p>
<p> [PDF_B] 1st Page </p>
<div style='page-break-after: always;'></div>
<p> [PDF_B] 2nd Page</p>"""
# Initialize renderer
renderer = ChromePdfRenderer()
# Convert each HTML string to a PDF document
pdfdoc_a = renderer.RenderHtmlAsPdf(html_a)
pdfdoc_b = renderer.RenderHtmlAsPdf(html_b)
# Merge the two documents into one
merged = PdfDocument.Merge([pdfdoc_a, pdfdoc_b])
# Save the merged result to disk
merged.SaveAs("Merged.pdf")
```
### ¿Por qué utilizar RenderHtmlAsPdf para la generación de PDF?
El ejemplo anterior utiliza dos cadenas HTML, cada una representando un documento de dos páginas. `RenderHtmlAsPdf` convierte cada cadena en un objeto `PdfDocument` utilizando el motor de renderizado basado en Chrome de IronPDF, que produce resultados precisos de contenido HTML, CSS y JavaScript. Este enfoque es adecuado para generar informes o documentos impulsados por datos desde plantillas web. Para escenarios de renderizado más complejos, vea el [tutorial de HTML a PDF](https://ironpdf.com/python/tutorials/html-to-pdf/).
[[t:(También puedes cargar archivos PDF existentes desde el disco usando `PdfDocument.FromFile("path/to/file.pdf")` y pasarlos directamente al método `Merge`. Esto es útil cuando se combinan informes preexistentes o documentos generados externamente.)]]
### ¿Cómo funciona el método Merge?
`PdfDocument.Merge` toma una lista de Python de objetos `PdfDocument` como su único argumento. Combina los documentos en orden de lista, colocando todas las páginas del primer documento antes que todas las páginas del segundo, y así sucesivamente. El resultado es un nuevo `PdfDocument` que se puede modificar o guardar. El recuento de páginas, los marcadores y el contenido incrustado de cada documento fuente se conservan en la salida.
El método acepta cualquier combinación de documentos renderizados y cargados desde archivos en la misma lista. Esto significa que puede combinar la salida HTML renderizada recientemente con PDFs existentes desde el disco en una sola llamada, lo cual es útil cuando una parte de un informe se genera dinámicamente y otra parte es una plantilla estática.
### ¿Cómo guardo el PDF combinado?
Pasa la ruta de salida deseada a `SaveAs` para escribir el documento fusionado en el disco:
```python
#:path=/static-assets/pdf/content-code-examples/how-to/python-merge-pdf/save-merged.py
# Save the merged document
merged.SaveAs("Merged.pdf")
# Optionally compress images before saving to reduce file size
merged.CompressImages(90)
merged.SaveAs("Merged_Compressed.pdf")
```
Después de guardar, puede aplicar procesamiento posterior adicional como [compresión de PDF](https://ironpdf.com/python/examples/pdf-compression/) para reducir el tamaño de archivo de documentos combinados grandes.
<div class="content-img-align-center">
<div class="center-image-wrapper">
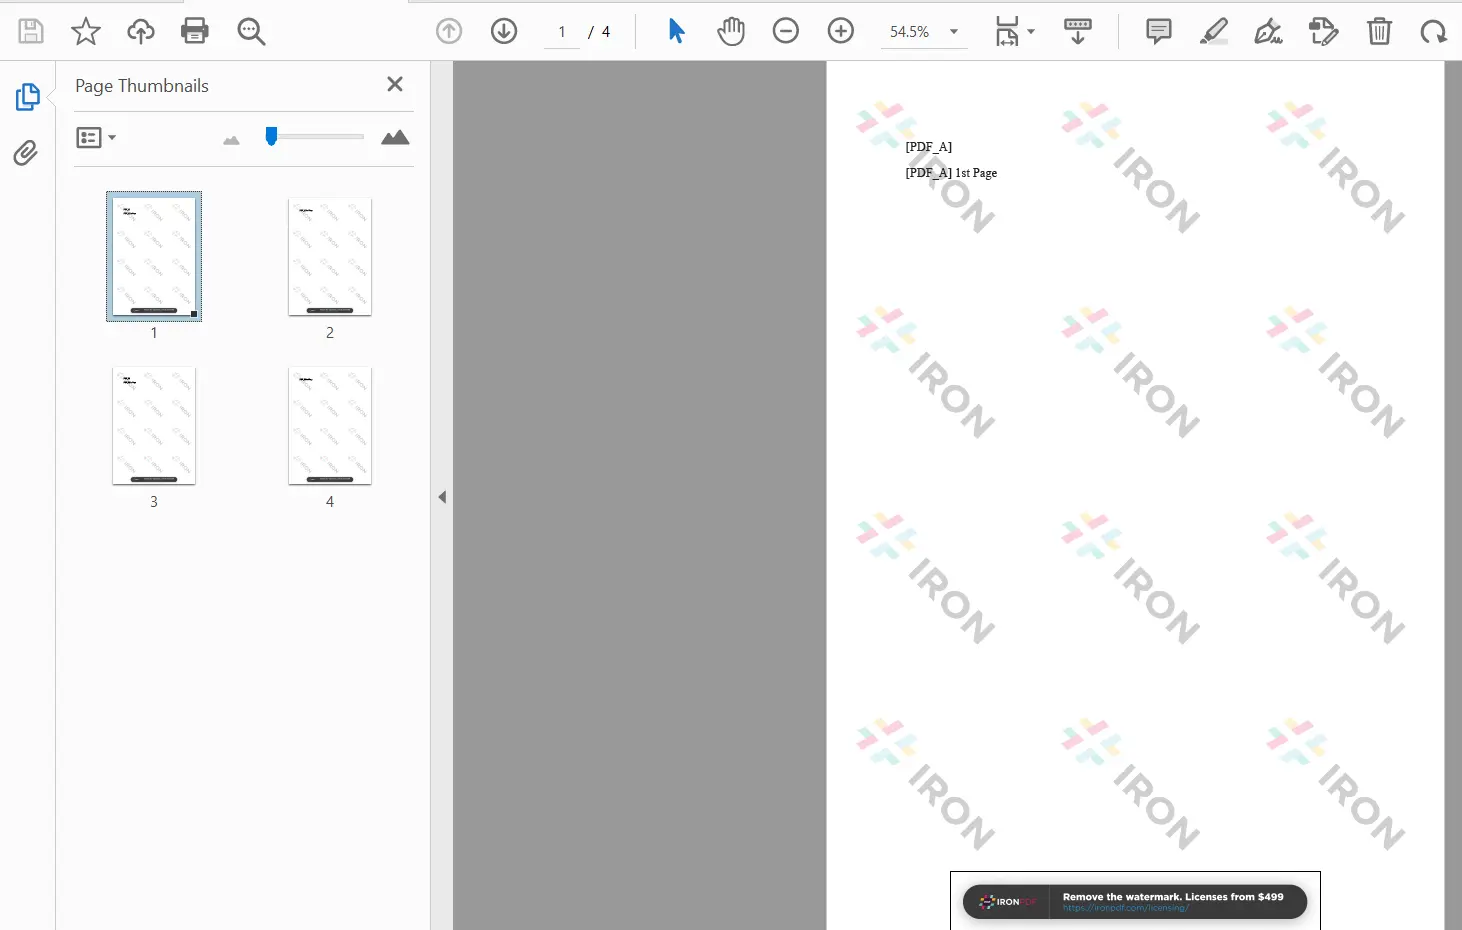
<a rel="nofollow" href="/static-assets/ironpdf-java/howto/java-merge-pdf/java-merge-pdf-2.webp" target="_blank"><img src="/static-assets/ironpdf-java/howto/java-merge-pdf/java-merge-pdf-2.webp" alt="Resultado de IronPDF que muestra un PDF combinado de 4 páginas con un panel de miniaturas que confirma la combinación correcta de dos documentos" class="img-responsive add-shadow" /></a>
<p class="content__image-caption">Salida de PDF combinado mostrando páginas de ambos documentos fuente</p>
</div>
</div>
## ¿Cómo fusiono más de dos archivos PDF en Python?
La fusión por lotes en IronPDF sigue el mismo patrón que la fusión de dos documentos. La única diferencia es que se añaden más objetos `PdfDocument` a la lista antes de la llamada a `PdfDocument.Merge`. El método se adapta para manejar docenas o cientos de documentos en una sola operación.
Esta es la misma API independientemente de si estás fusionando 2 o 200 documentos. Para escenarios de alto volumen como la agregación de informes nocturnos o las canalizaciones de ensamblaje de documentos, IronPDF también admite [la generación de PDF en paralelo](https://ironpdf.com/python/examples/parallel/) para acelerar la fase de renderizado antes de fusionar.
El proceso involucra dos pasos:
- Crea una lista de Python que contenga los objetos `PdfDocument` para fusionar
- Pasa la lista como argumento a `PdfDocument.Merge`
### ¿Cómo combino múltiples PDFs con una lista?
El código a continuación fusiona cuatro documentos renderizados en HTML en una sola llamada:
```python
#:path=/static-assets/pdf/content-code-examples/how-to/python-merge-pdf/merge-multiple-pdfs.py
from ironpdf import *
# HTML content for each document
html_a = """<p> [PDF_A] 1st Page </p>
<div style='page-break-after: always;'></div>
<p> [PDF_A] 2nd Page</p>"""
html_b = """<p> [PDF_B] 1st Page </p>
<div style='page-break-after: always;'></div>
<p> [PDF_B] 2nd Page</p>"""
html_c = """<p> [PDF_C] 1st Page </p>
<div style='page-break-after: always;'></div>
<p> [PDF_C] 2nd Page</p>"""
html_d = """<p> [PDF_D] Content Page </p>
<div style='page-break-after: always;'></div>
<p> [PDF_D] Summary Page</p>"""
renderer = ChromePdfRenderer()
# Render all four documents
pdfdoc_a = renderer.RenderHtmlAsPdf(html_a)
pdfdoc_b = renderer.RenderHtmlAsPdf(html_b)
pdfdoc_c = renderer.RenderHtmlAsPdf(html_c)
pdfdoc_d = renderer.RenderHtmlAsPdf(html_d)
# Collect into a list and merge
pdfs = [pdfdoc_a, pdfdoc_b, pdfdoc_c, pdfdoc_d]
pdf = PdfDocument.Merge(pdfs)
# Save the combined document
pdf.SaveAs("merged_multiple.pdf")
```
La lista pasada a `Merge` determina el orden de las páginas en el documento final. Reorganizar los elementos en la lista cambia el orden de salida sin código adicional. Si necesitas ordenar los documentos antes de fusionar, por ejemplo, por fecha o número de informe, ordena primero la lista de Python y luego pásala a `Merge`.
### ¿Cómo fusiono archivos PDF existentes desde el disco?
Al combinar archivos PDF preexistentes en lugar de recién renderizados, carga cada archivo con `PdfDocument.FromFile` antes de fusionar. Este es el patrón típico cuando trabajas con archivos producidos por otros sistemas: documentos escaneados, exportaciones de informes de terceros o PDFs generados por diferentes herramientas. IronPDF lee el archivo en memoria como un objeto `PdfDocument`, que luego puede fusionarse, modificarse o inspeccionarse antes de la guardada final.
```python
#:path=/static-assets/pdf/content-code-examples/how-to/python-merge-pdf/merge-existing-pdfs.py
from ironpdf import *
# Load existing PDF files from disk
existing_pdf1 = PdfDocument.FromFile("report1.pdf")
existing_pdf2 = PdfDocument.FromFile("report2.pdf")
existing_pdf3 = PdfDocument.FromFile("report3.pdf")
# Merge all loaded documents
merged_existing = PdfDocument.Merge([existing_pdf1, existing_pdf2, existing_pdf3])
# Save the combined result
merged_existing.SaveAs("merged_reports.pdf")
```
[[i:(IronPDF conserva fuentes, imágenes, anotaciones y diseños de página de los archivos fuente durante la fusión. Los documentos con campos de formulario incrustados o [firmas digitales](https://ironpdf.com/python/examples/digitally-sign-a-pdf/) también pueden ser fusionados, aunque los campos de formulario interactivos en el resultado pueden requerir un re-flattening dependiendo de tu caso de uso.)]]
<div class="content-img-align-center">
<div class="center-image-wrapper">
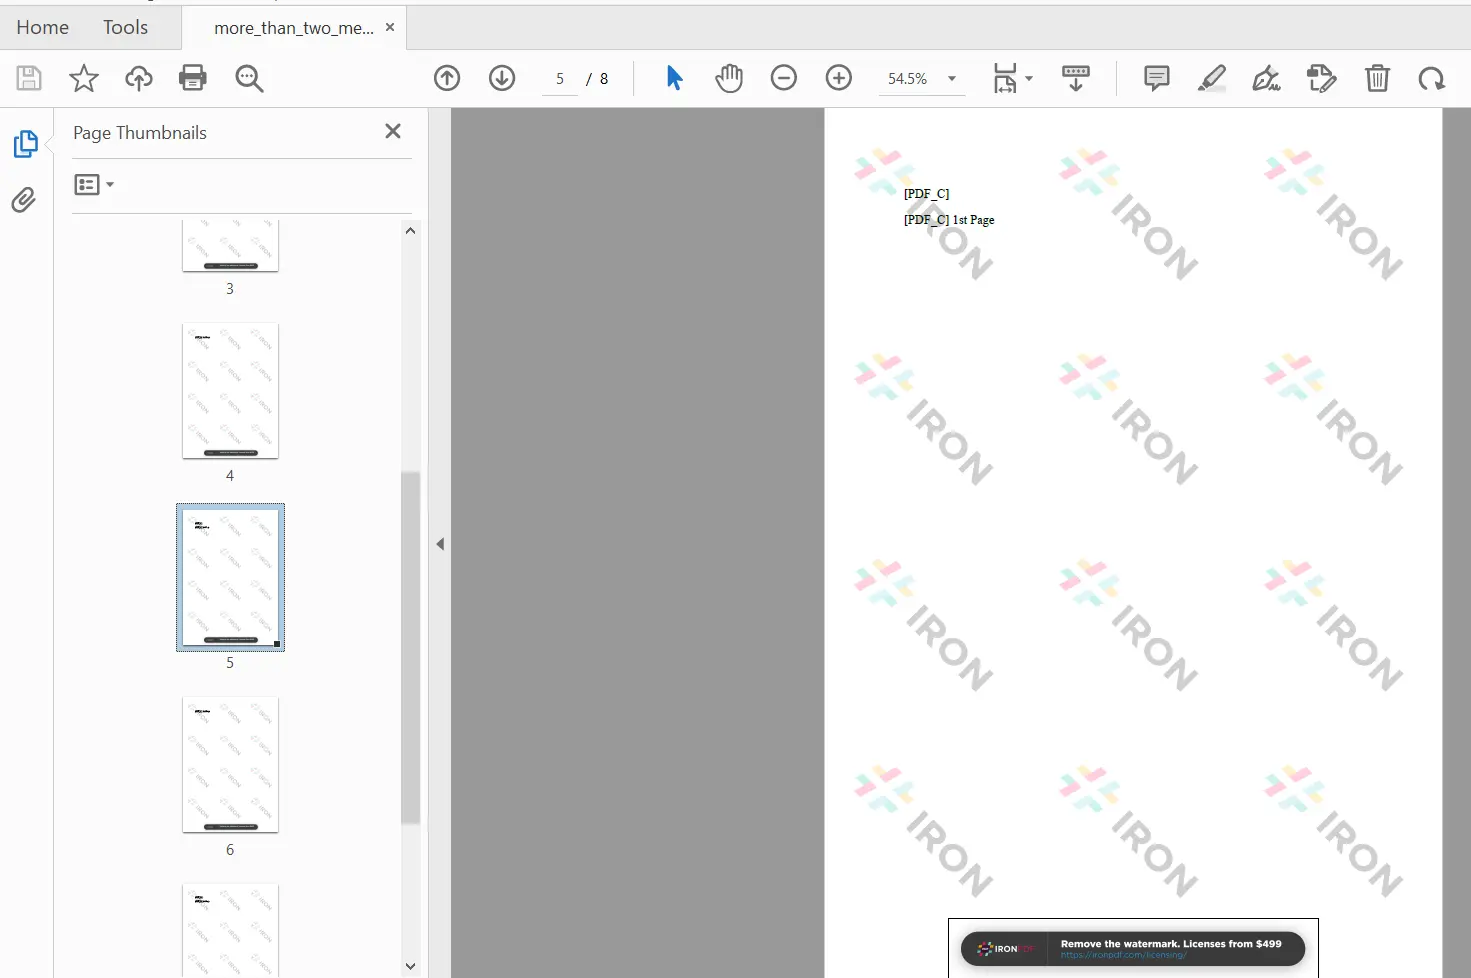
<a rel="nofollow" href="/static-assets/ironpdf-java/howto/java-merge-pdf/java-merge-pdf-3.webp" target="_blank"><img src="/static-assets/ironpdf-java/howto/java-merge-pdf/java-merge-pdf-3.webp" alt="Resultado de IronPDF que muestra un PDF combinado de varias páginas con un panel de navegación de miniaturas que muestra páginas de cuatro documentos de origen" class="img-responsive add-shadow" /></a>
<p class="content__image-caption">Resultado de la fusión de varios documentos mostrando páginas de los cuatro PDFs fuente</p>
</div>
</div>
## ¿Cuáles son los próximos pasos para fusionar PDFs en Python?
Esta guía cubrió los dos principales patrones para la fusión de PDFs con IronPDF: renderizar contenido HTML en documentos PDF y combinarlos con `PdfDocument.Merge`, y cargar archivos existentes desde el disco para una combinación por lotes. Ambos enfoques comparten la misma API y se escalan desde fusiones de dos archivos simples hasta grandes lotes de documentos.
IronPDF admite operaciones adicionales post-fusión como [agregar encabezados y pies de página](https://ironpdf.com/python/examples/headers-and-footers/), [aplicar marcas de agua](https://ironpdf.com/python/examples/pdf-watermarking/) para el branding, [extraer texto](https://ironpdf.com/python/examples/extract-pdf-text/) del documento combinado y [llenar formularios PDF](https://ironpdf.com/python/how-to/python-fill-pdf-form/) programáticamente.
La biblioteca admite Python 3.x en Windows y Linux. Para más operaciones con PDF en Python, explora [dividir PDFs](https://ironpdf.com/how-to/merge-or-split-pdfs/), [convertir PDFs a imágenes](https://ironpdf.com/python/how-to/python-pdf-to-image/) y [imprimir PDFs](https://ironpdf.com/python/how-to/python-print-pdf/). Para la lista completa de ejemplos de código en Python, visita [la página de ejemplos de IronPDF for Python](https://ironpdf.com/python/examples/using-html-to-create-a-pdf/).
[Comienza tu prueba gratuita](trial-license) para probar la fusión de PDF en tu entorno, o [ver las opciones de licencia](licensing) para implementaciones en producción.
¿Listo para ver qué más puedes hacer? Visita la página de tutoriales de IronPDF Python aquí: [Tutoriales de IronPDF for Python](https://ironpdf.com/python/tutorials/html-to-pdf/)
*[Descarga](https://ironpdf.com/downloads/python-merge-pdf.zip) el producto de software.*
IronPDF for Python proporciona una solución directa para fusionar múltiples documentos PDF en un solo archivo utilizando el método PdfDocument.Merge(), que admite tanto la fusión de dos archivos como operaciones por lotes para combinar numerosos PDFs de manera eficiente.
PDF (Formato de Documento Portátil) es el estándar para compartir documentos que deben verse idénticos en todas las plataformas y aplicaciones. Ya sea que esté consolidando informes, combinando documentos escaneados o ensamblando formularios de varias partes, fusionar contenido PDF de varias fuentes es un requisito recurrente en los flujos de trabajo de negocios y de procesamiento de datos.
IronPDF maneja esta operación en Python con una sola llamada de método. Esta guía cubre la instalación, la fusión básica de dos archivos y las operaciones por lotes para combinar múltiples documentos a la vez.
Use RenderHtmlAsPdf para generar archivos PDF individuales, o cargue los existentes con PdfDocument.FromFile
Aplique el método Merge para combinar archivos PDF en un solo PdfDocument
Guarde el documento fusionado con SaveAs
Para múltiples PDFs, pase una lista de objetos PdfDocument a Merge
¿Cómo instalo IronPDF for Python?
IronPDF está disponible como un paquete de Python a través de pip. Requiere Python 3.x y funciona en Windows y Linux sin depender de sistemas adicionales para operaciones de fusión estándar. El paquete viene con un motor de renderizado basado en Chrome que maneja la conversión de HTML a PDF internamente.
Instala la biblioteca IronPdf usando pip con el siguiente comando:
En su script de Python, incluya las siguientes declaraciones de importación para acceder a las funciones de generación y fusión de PDFs de IronPDF:
#:path=/static-assets/pdf/content-code-examples/how-to/python-merge-pdf/imports.pyfrom ironpdf import *# Set your license key for production useLicense.LicenseKey = "YOUR-LICENSE-KEY-HERE"
#:path=/static-assets/pdf/content-code-examples/how-to/python-merge-pdf/imports.py
from ironpdf import *

# Set your license key for production use
License.LicenseKey = "YOUR-LICENSE-KEY-HERE"
Fusionar archivos PDF en Python implica dos pasos: crear los documentos PDF de origen, luego combinarlos con PdfDocument.Merge(). El método acepta una lista de objetos PdfDocument y produce un nuevo documento combinado en el orden en que aparecen los elementos en la lista.
A continuación hay un ejemplo completo y funcional:
#:path=/static-assets/pdf/content-code-examples/how-to/python-merge-pdf/merge-two-pdfs.pyfrom ironpdf import *# HTML content for the first PDFhtml_a = """<p> [PDF_A] </p> <p> [PDF_A] 1st Page </p> <div style='page-break-after: always;'></div> <p> [PDF_A] 2nd Page</p>"""# HTML content for the second PDFhtml_b = """<p> [PDF_B] </p> <p> [PDF_B] 1st Page </p> <div style='page-break-after: always;'></div> <p> [PDF_B] 2nd Page</p>"""# Initialize rendererrenderer = ChromePdfRenderer()# Convert each HTML string to a PDF documentpdfdoc_a = renderer.RenderHtmlAsPdf(html_a)pdfdoc_b = renderer.RenderHtmlAsPdf(html_b)# Merge the two documents into onemerged = PdfDocument.Merge([pdfdoc_a, pdfdoc_b])# Save the merged result to diskmerged.SaveAs("Merged.pdf")
#:path=/static-assets/pdf/content-code-examples/how-to/python-merge-pdf/merge-two-pdfs.py
from ironpdf import *

# HTML content for the first PDF
html_a = """<p> [PDF_A] </p>
            <p> [PDF_A] 1st Page </p>
            <div style='page-break-after: always;'></div>
            <p> [PDF_A] 2nd Page</p>"""

# HTML content for the second PDF
html_b = """<p> [PDF_B] </p>
            <p> [PDF_B] 1st Page </p>
            <div style='page-break-after: always;'></div>
            <p> [PDF_B] 2nd Page</p>"""

# Initialize renderer
renderer = ChromePdfRenderer()

# Convert each HTML string to a PDF document
pdfdoc_a = renderer.RenderHtmlAsPdf(html_a)
pdfdoc_b = renderer.RenderHtmlAsPdf(html_b)

# Merge the two documents into one
merged = PdfDocument.Merge([pdfdoc_a, pdfdoc_b])

# Save the merged result to disk
merged.SaveAs("Merged.pdf")
Python
¿Por qué utilizar RenderHtmlAsPdf para la generación de PDF?
El ejemplo anterior utiliza dos cadenas HTML, cada una representando un documento de dos páginas. RenderHtmlAsPdf convierte cada cadena en un objeto PdfDocument utilizando el motor de renderizado basado en Chrome de IronPDF, que produce resultados precisos de contenido HTML, CSS y JavaScript. Este enfoque es adecuado para generar informes o documentos impulsados por datos desde plantillas web. Para escenarios de renderizado más complejos, vea el tutorial de HTML a PDF.
Consejos: También puedes cargar archivos PDF existentes desde el disco usando PdfDocument.FromFile("path/to/file.pdf") y pasarlos directamente al método Merge. Esto es útil cuando se combinan informes preexistentes o documentos generados externamente.
¿Cómo funciona el método Merge?
PdfDocument.Merge toma una lista de Python de objetos PdfDocument como su único argumento. Combina los documentos en orden de lista, colocando todas las páginas del primer documento antes que todas las páginas del segundo, y así sucesivamente. El resultado es un nuevo PdfDocument que se puede modificar o guardar. El recuento de páginas, los marcadores y el contenido incrustado de cada documento fuente se conservan en la salida.
El método acepta cualquier combinación de documentos renderizados y cargados desde archivos en la misma lista. Esto significa que puede combinar la salida HTML renderizada recientemente con PDFs existentes desde el disco en una sola llamada, lo cual es útil cuando una parte de un informe se genera dinámicamente y otra parte es una plantilla estática.
¿Cómo guardo el PDF combinado?
Pasa la ruta de salida deseada a SaveAs para escribir el documento fusionado en el disco:
#:path=/static-assets/pdf/content-code-examples/how-to/python-merge-pdf/save-merged.py# Save the merged documentmerged.SaveAs("Merged.pdf")# Optionally compress images before saving to reduce file sizemerged.CompressImages(90)merged.SaveAs("Merged_Compressed.pdf")
#:path=/static-assets/pdf/content-code-examples/how-to/python-merge-pdf/save-merged.py
# Save the merged document
merged.SaveAs("Merged.pdf")

# Optionally compress images before saving to reduce file size
merged.CompressImages(90)
merged.SaveAs("Merged_Compressed.pdf")
Python
Después de guardar, puede aplicar procesamiento posterior adicional como compresión de PDF para reducir el tamaño de archivo de documentos combinados grandes.
Salida de PDF combinado mostrando páginas de ambos documentos fuente
¿Cómo fusiono más de dos archivos PDF en Python?
La fusión por lotes en IronPDF sigue el mismo patrón que la fusión de dos documentos. La única diferencia es que se añaden más objetos PdfDocument a la lista antes de la llamada a PdfDocument.Merge. El método se adapta para manejar docenas o cientos de documentos en una sola operación.
Esta es la misma API independientemente de si estás fusionando 2 o 200 documentos. Para escenarios de alto volumen como la agregación de informes nocturnos o las canalizaciones de ensamblaje de documentos, IronPDF también admite la generación de PDF en paralelo para acelerar la fase de renderizado antes de fusionar.
El proceso involucra dos pasos:
Crea una lista de Python que contenga los objetos PdfDocument para fusionar
Pasa la lista como argumento a PdfDocument.Merge
¿Cómo combino múltiples PDFs con una lista?
El código a continuación fusiona cuatro documentos renderizados en HTML en una sola llamada:
#:path=/static-assets/pdf/content-code-examples/how-to/python-merge-pdf/merge-multiple-pdfs.pyfrom ironpdf import *# HTML content for each documenthtml_a = """<p> [PDF_A] 1st Page </p> <div style='page-break-after: always;'></div> <p> [PDF_A] 2nd Page</p>"""html_b = """<p> [PDF_B] 1st Page </p> <div style='page-break-after: always;'></div> <p> [PDF_B] 2nd Page</p>"""html_c = """<p> [PDF_C] 1st Page </p> <div style='page-break-after: always;'></div> <p> [PDF_C] 2nd Page</p>"""html_d = """<p> [PDF_D] Content Page </p> <div style='page-break-after: always;'></div> <p> [PDF_D] Summary Page</p>"""renderer = ChromePdfRenderer()# Render all four documentspdfdoc_a = renderer.RenderHtmlAsPdf(html_a)pdfdoc_b = renderer.RenderHtmlAsPdf(html_b)pdfdoc_c = renderer.RenderHtmlAsPdf(html_c)pdfdoc_d = renderer.RenderHtmlAsPdf(html_d)# Collect into a list and mergepdfs = [pdfdoc_a, pdfdoc_b, pdfdoc_c, pdfdoc_d]pdf = PdfDocument.Merge(pdfs)# Save the combined documentpdf.SaveAs("merged_multiple.pdf")
#:path=/static-assets/pdf/content-code-examples/how-to/python-merge-pdf/merge-multiple-pdfs.py
from ironpdf import *

# HTML content for each document
html_a = """<p> [PDF_A] 1st Page </p>
            <div style='page-break-after: always;'></div>
            <p> [PDF_A] 2nd Page</p>"""

html_b = """<p> [PDF_B] 1st Page </p>
            <div style='page-break-after: always;'></div>
            <p> [PDF_B] 2nd Page</p>"""

html_c = """<p> [PDF_C] 1st Page </p>
            <div style='page-break-after: always;'></div>
            <p> [PDF_C] 2nd Page</p>"""

html_d = """<p> [PDF_D] Content Page </p>
            <div style='page-break-after: always;'></div>
            <p> [PDF_D] Summary Page</p>"""

renderer = ChromePdfRenderer()

# Render all four documents
pdfdoc_a = renderer.RenderHtmlAsPdf(html_a)
pdfdoc_b = renderer.RenderHtmlAsPdf(html_b)
pdfdoc_c = renderer.RenderHtmlAsPdf(html_c)
pdfdoc_d = renderer.RenderHtmlAsPdf(html_d)

# Collect into a list and merge
pdfs = [pdfdoc_a, pdfdoc_b, pdfdoc_c, pdfdoc_d]
pdf = PdfDocument.Merge(pdfs)

# Save the combined document
pdf.SaveAs("merged_multiple.pdf")
Python
La lista pasada a Merge determina el orden de las páginas en el documento final. Reorganizar los elementos en la lista cambia el orden de salida sin código adicional. Si necesitas ordenar los documentos antes de fusionar, por ejemplo, por fecha o número de informe, ordena primero la lista de Python y luego pásala a Merge.
¿Cómo fusiono archivos PDF existentes desde el disco?
Al combinar archivos PDF preexistentes en lugar de recién renderizados, carga cada archivo con PdfDocument.FromFile antes de fusionar. Este es el patrón típico cuando trabajas con archivos producidos por otros sistemas: documentos escaneados, exportaciones de informes de terceros o PDFs generados por diferentes herramientas. IronPDF lee el archivo en memoria como un objeto PdfDocument, que luego puede fusionarse, modificarse o inspeccionarse antes de la guardada final.
#:path=/static-assets/pdf/content-code-examples/how-to/python-merge-pdf/merge-existing-pdfs.pyfrom ironpdf import *# Load existing PDF files from diskexisting_pdf1 = PdfDocument.FromFile("report1.pdf")existing_pdf2 = PdfDocument.FromFile("report2.pdf")existing_pdf3 = PdfDocument.FromFile("report3.pdf")# Merge all loaded documentsmerged_existing = PdfDocument.Merge([existing_pdf1, existing_pdf2, existing_pdf3])# Save the combined resultmerged_existing.SaveAs("merged_reports.pdf")
#:path=/static-assets/pdf/content-code-examples/how-to/python-merge-pdf/merge-existing-pdfs.py
from ironpdf import *

# Load existing PDF files from disk
existing_pdf1 = PdfDocument.FromFile("report1.pdf")
existing_pdf2 = PdfDocument.FromFile("report2.pdf")
existing_pdf3 = PdfDocument.FromFile("report3.pdf")

# Merge all loaded documents
merged_existing = PdfDocument.Merge([existing_pdf1, existing_pdf2, existing_pdf3])

# Save the combined result
merged_existing.SaveAs("merged_reports.pdf")
Python
Por favor nota: IronPDF conserva fuentes, imágenes, anotaciones y diseños de página de los archivos fuente durante la fusión. Los documentos con campos de formulario incrustados o firmas digitales también pueden ser fusionados, aunque los campos de formulario interactivos en el resultado pueden requerir un re-flattening dependiendo de tu caso de uso.
Resultado de la fusión de varios documentos mostrando páginas de los cuatro PDFs fuente
¿Cuáles son los próximos pasos para fusionar PDFs en Python?
Esta guía cubrió los dos principales patrones para la fusión de PDFs con IronPDF: renderizar contenido HTML en documentos PDF y combinarlos con PdfDocument.Merge, y cargar archivos existentes desde el disco para una combinación por lotes. Ambos enfoques comparten la misma API y se escalan desde fusiones de dos archivos simples hasta grandes lotes de documentos.
¿Cómo fusiono varios archivos PDF en uno solo utilizando Python?
Instala IronPDF con pip install ironpdf, luego llama a PdfDocument.Merge() con una lista de Python de objetos PdfDocument. El método devuelve un nuevo documento combinado que guardas con SaveAs.
¿Puedo fusionar archivos PDF existentes desde el disco en lugar de los renderizados?
Sí. Usa PdfDocument.FromFile('path/to/file.pdf') para cargar cada PDF existente, luego pasa los objetos cargados a PdfDocument.Merge(). Puedes mezclar documentos cargados desde archivos y recién renderizados en la misma lista.
¿El método PdfDocument.Merge conserva el formato y las fuentes del documento?
Sí. IronPDF conserva las fuentes, imágenes, anotaciones y disposiciones de página de todos los documentos de origen durante la fusión. La apariencia original de cada documento de origen se mantiene en el PDF fusionado final.
¿Cómo controlo el orden de las páginas en el PDF fusionado?
El orden de las páginas en la salida coincide con el orden de los objetos PdfDocument en la lista de Python pasada a Merge. Reorganiza los elementos de la lista antes de llamar a Merge para controlar la secuencia.
¿Puedo comprimir el PDF fusionado para reducir el tamaño del archivo?
Sí. Después de fusionar, llama a CompressImages(quality) en el PdfDocument fusionado antes de llamar a SaveAs. Un valor de calidad de 90 ofrece un buen equilibrio entre compresión y fidelidad visual.
¿IronPDF for Python es multiplataforma?
Sí. IronPDF for Python admite Python 3.x en Windows y Linux. La misma API PdfDocument.Merge() funciona en ambas plataformas sin cambios de configuración.
¿Puedo añadir metadatos al documento PDF fusionado?
Sí. Después de fusionar, establece propiedades de metadatos como pdf.MetaData.Author y pdf.MetaData.Title en el PdfDocument fusionado antes de guardar.
How does IronPDF handle HTML content for PDF generation?
IronPDF uses a Chrome-based rendering engine to convert HTML content into PdfDocument objects. This allows it to accurately render PDF documents from HTML, CSS, and JavaScript.
What are the next steps after merging PDFs with IronPDF?
After merging PDFs with IronPDF, you can perform additional operations such as adding headers and footers, applying watermarks, extracting text, or even filling out PDF forms programmatically.
Where can I find more examples of using IronPDF in Python?
For more examples of using IronPDF in Python, visit the IronPDF for Python examples page. It includes various tutorials and code snippets to help you perform different PDF operations.
Curtis Chau tiene una licenciatura en Ciencias de la Computación (Carleton University) y se especializa en el desarrollo front-end con experiencia en Node.js, TypeScript, JavaScript y React. Apasionado por crear interfaces de usuario intuitivas y estéticamente agradables, disfruta trabajando con frameworks modernos y creando manuales bien estructurados y visualmente atractivos.