



更新日 2026年4月21日
Scrapy in Python(開発者向けのしくみ)
ここにScrapy、PythonにおけるWebスクレイピングフレームワークとIronPDFが登場し、オンラインデータの抽出と動的PDFの作成を最適化するための2つの強力なライブラリが協力しています。
詳しく読む

デジタル変革の時代において、情報の共有と保存に PDF ドキュメントが不可欠であることは強調しすぎることはありません。
しかし、 スキャンされた PDFには検索可能なテキストではなく画像が含まれていることが多く、貴重なデータを抽出する際には大きな課題が生じます。
ここで Python が多用途で強力なソリューションとして登場し、スキャンした文書からの情報抽出が主な例である、さまざまなタスクを自動化するためのプログラミング言語としての地位を確立しました。
Python の柔軟性と強力な機能により、ユーザーはスキャンされたコンテンツの複雑な部分を効率的に操作できるようになり、画像ベースの PDF からのデータにアクセスして利用するための合理的なアプローチが提供されます。
Python は、高度な機能を備え、最も使用されているプログラミング言語の 1 つです。 [Python Wikipediaページ](https://en.wikipedia.org/wiki/Python_(programming_language)を訪問して、Pythonプログラミング言語とその構造化形式について学びましょう。
この記事では、Python PDF ライブラリのIronPDFを使用して、スキャンした PDF を Python プログラミング言語で読み取る方法について説明します。
PdfDocument.FromFile メソッドを使用してスキャンされたPDFファイルをロードします。ExtractAllText メソッドを使用してスキャンされたPDFからすべてのテキストを抽出します。print() メソッドを使用してPDFファイルからすべてのテキストを印刷します。IronPDF Python 向け は、Iron Software によって開発された堅牢なライブラリであり、PDF 生成および操作機能を Python アプリケーションにシームレスに統合できます。
この多用途ツールにより、開発者は PDF ドキュメントを簡単に作成、変更、操作することができ、動的なレポート生成、HTML から PDF への変換、既存の PDF ファイルからのコンテンツ抽出などのタスクがサポートされます。
ユーザーフレンドリーな API、包括的なドキュメント、さまざまな機能を備えた IronPDF は、高度な PDF 機能を Python プロジェクトに組み込むプロセスを簡素化し、プロフェッショナル レベルのドキュメント処理機能を使用してアプリケーションを強化したい開発者にとって貴重なリソースとなります。
IronPDF for Python には、PDF 生成やテキスト ファイル構造の操作のための強力なツールとなるさまざまな機能が搭載されています。
その主要な機能のいくつかは以下の通りです:
コードチュートリアルを始める前に、まずは Python 用 IronPDF をインストールする方法を見てみましょう。
まず、システムに Python がインストールされていること、そして PyCharm のような優れた Python IDE があることを確認します。 また、IronPDF Python 向け をインストールするには、PIP をインストールする必要があります。
まず、新しい Python プロジェクトを作成するか、既存のプロジェクトを開きます。
コンソールを開き、次のコマンドを実行して Enter キーを押します。
これで、IronPDF Python 向け が Python プロジェクトに統合されます。
このセクションでは、IronPDF を使用してスキャンされた PDF ファイルからテキストを抽出する方法を説明します。
from ironpdf import *  # Import everything from ironpdf

# Set the license key for IronPDF
License.LicenseKey = "Your License Key"

# Load the scanned PDF document
pdf = PdfDocument.FromFile("C:/Users/buttw/INV_2023_00008.pdf")

# Extract all text from the PDF document
all_text = pdf.ExtractAllText()

# Print the extracted text
print(all_text)上記のコード例では、スキャンされた PDF ファイルからテキストを抽出します。 上記コードの内訳は以下のとおりです。
IronPDFモジュールをインポートします。
from ironpdf import *この行は、IronPDF ライブラリから必要なモジュールとクラスをインポートします。 アスタリスク(*)は、モジュールからすべてのクラスと関数をインポートすることを示します。
2.ライセンスキーを設定します。
License.LicenseKey = "Your License Key"この行は、IronPDF のライセンス キーを設定します。 取得した実際のライセンスキーを"Your License Key"に置き換える必要があります。
ライセンス キーは IronPDF を使用するために必要であり、通常は製品を購入するときに提供されます。
3.スキャンしたPDF文書を読み込み
pdf = PdfDocument.FromFile("C:/Users/buttw/INV_2023_00008.pdf")この行は、指定されたファイルパス ("C:/Users/buttw/INV_2023_00008.pdf") にあるスキャンされたPDFドキュメントをロードします。 与えられたファイルからPdfDocument.FromFileメソッドが使用されます。
PDF文書からテキストを抽出する:
all_text = pdf.ExtractAllText()この行は、すべてのページのExtractAllText メソッドを使用して、読み込まれた PDF ドキュメントからすべてのテキスト コンテンツを抽出します。 抽出されたテキストはall_text変数に格納されます。
5.抽出したテキストを印刷する:
print(all_text)最後に、この行は抽出されたテキストをコンソールに出力します。 all_text変数には、スキャンされたPDFドキュメントのテキストコンテンツが含まれています。
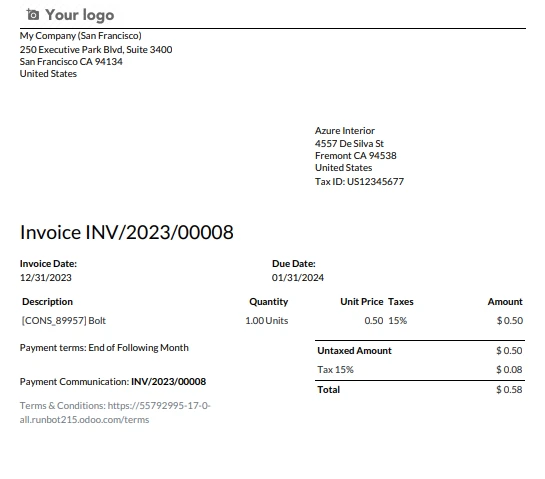
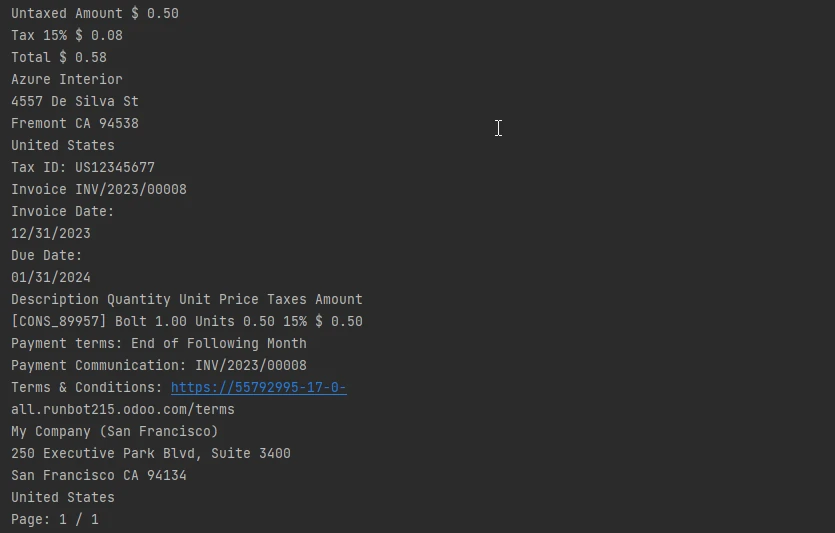
デジタル ドキュメント処理の分野では、検索可能なテキストではなく画像を含むスキャンされた PDF によってもたらされる課題を克服するための多目的ソリューションとして Python プログラミング言語が登場しています。
Python の柔軟性と IronPDF for Python の強力な機能の相乗効果により、開発者は PDF の生成、操作、抽出機能をプロジェクトにシームレスに統合できるようになります。
Iron Software が開発したIronPDFは、この点で非常に役立ち、さまざまなドキュメント タイプから PDF ファイルを変換したり、HTML から PDF ページへの変換、テキストと画像の操作、スキャンした PDF から OCR ベースのテキスト抽出などの機能を提供します。
紹介されているコード例では、スキャンされた PDF ページからテキストを読み取るための IronPDF の簡単な実装を示しており、効率的なデータ抽出の可能性と Python アプリケーションでのドキュメント処理機能の強化を示しています。
高度な PDF 処理の需要が高まり続ける中、IronPDF Python 向け は、開発者がスキャンされたコンテンツの複雑な部分を簡単に操作できるようにする貴重なツールとして位置づけられています。
IronPDF for Python は試用ライセンスを提供しており、開発者にとって IronPDF の機能を知る絶好の機会となります。
スキャンした PDF からテキストを抽出する完全なチュートリアルは、こちらでご覧いただけます。

Curtis Chauは、カールトン大学でコンピュータサイエンスの学士号を取得し、Node.js、TypeScript、JavaScript、およびReactに精通したフロントエンド開発を専門としています。直感的で美しいユーザーインターフェースを作成することに情熱を持ち、Curtisは現代のフレームワークを用いた開発や、構造の良い視覚的に魅力的なマニュアルの作成を楽しんでいます。



IronPDF はIRONSUITEの一部です
オフィス文書向けの.NET API製品10個

PDFがHTMLのように見える必要があるとき、迅速に。



