from ironpdf import *

# Instantiate Renderer
renderer = ChromePdfRenderer()

# Create a PDF from a HTML string using Python
pdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>")

# Export to a file or Stream
pdf.SaveAs("output.pdf")

# Advanced Example with HTML Assets
# Load external html assets: Images, CSS and JavaScript.
# An optional BasePath 'C:\site\assets\' is set as the file location to load assets from
myAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", r"C:\site\assets")
myAdvancedPdf.SaveAs("html-with-assets.pdf")
from ironpdf import *# Instantiate Rendererrenderer = ChromePdfRenderer()# Create a PDF from a HTML string using Pythonpdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>")# Export to a file or Streampdf.SaveAs("output.pdf")# Advanced Example with HTML Assets# Load external html assets: Images, CSS and JavaScript.# An optional BasePath 'C:\site\assets\' is set as the file location to load assets frommyAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", r"C:\site\assets")myAdvancedPdf.SaveAs("html-with-assets.pdf")
In der Ära der digitalen Transformation kann die Unverzichtbarkeit von PDF-Dokumenten zum Teilen und Bewahren von Informationen nicht genug betont werden.
Die Verbreitung von [gescannten PDFs](https://towardsdatascience.com/extracting-text-from-scanned-pdf-using-pytesseract-open-cv-cd670ee38052), die oft Bilder anstelle von durchsuchbarem Text enthalten, stellt jedoch eine erhebliche Herausforderung beim Extrahieren wertvoller Daten dar.
Hier erweist sich Python als vielseitige und leistungsstarke Lösung und etabliert sich als Anlaufstelle für die Automatisierung verschiedener Aufgaben, wobei die Informationsextraktion aus gescannten Dokumenten ein erstklassiges Beispiel ist.
Die Flexibilität und robusten Fähigkeiten von Python ermöglichen es Benutzern, effizient durch die Komplexitäten gescannter Inhalte zu navigieren, und bieten einen schlanken Ansatz, um auf Daten aus bildbasierten PDFs zuzugreifen und diese zu nutzen.
Python ist eine der am häufigsten verwendeten Programmiersprachen mit seiner fortschrittlichen Funktionalität. Besuchen Sie die [Wikipedia-Seite zu Python](https://en.wikipedia.org/wiki/Python_(programming_language)), um mehr über die Programmiersprache Python und ihr strukturiertes Format zu erfahren.
In diesem Artikel werden wir diskutieren, wie man gescannte PDFs in der Programmiersprache Python mit Hilfe von [IronPDF](/python/) für die Python PDF-Bibliothek lesen kann.
## Wie man gescannte PDFs in Python liest
1. Erstellen Sie ein neues Projekt in [PyCharm](https://www.jetbrains.com/pycharm/promo/?source=google&medium=cpc&campaign=APAC_en_AU_PyCharm_Branded&term=pycharm&content=536947779564&gclid=EAIaIQobChMImJnalpPPgwMVQqlmAh0lzQspEAAYASAAEgJ9FPD_BwE).
2. Installieren Sie zuerst die IronPDF PDF-Bibliothek, um die gescannte PDF-Datei zu lesen.
3. Importieren Sie die erforderlichen Abhängigkeiten.
4. Laden Sie die gescannte PDF-Datei mit der `PdfDocument.FromFile` Methode.
5. Extrahieren Sie den gesamten Text aus der gescannten PDF mit der `ExtractAllText` Methode.
6. Drucken Sie den gesamten Text der PDF-Datei mit der `print()` Methode.
## IronPDF for Python
[IronPDF](/python/) for Python ist eine robuste Bibliothek, die von Iron Software entwickelt wurde und eine nahtlose Integration von PDF-Erstellungs- und Manipulationsfunktionen in Python-Anwendungen ermöglicht.
Dieses vielseitige Werkzeug befähigt Entwickler, mühelos PDF-Dokumente zu erstellen, zu ändern und zu interagieren, wobei Aufgaben wie die Erzeugung dynamischer Berichte, die Konvertierung von HTML in PDF und das Extrahieren von Inhalten aus vorhandenen PDF-Dateien unterstützt werden.
Mit einer benutzerfreundlichen API, umfassender Dokumentation und einer Vielzahl von Funktionen vereinfacht IronPDF den Prozess des Einbaus von fortschrittlichen PDF-Funktionalitäten in Python-Projekte und macht es zu einer unschätzbaren Ressource für Entwickler, die ihre Anwendungen mit professionellen Dokumentenverarbeitungsmöglichkeiten erweitern möchten.
### IronPDF Funktionen
IronPDF for Python ist mit einer Reihe von Funktionen ausgestattet, die es zu einem leistungsstarken Werkzeug für die PDF-Erzeugung und -Textstrukturmanipulation machen.
Einige seiner wichtigsten Funktionen sind:
1. **HTML zu PDF-Konvertierung:** Konvertieren Sie HTML-Inhalte, einschließlich CSS und Bilder, in hochwertige PDF-Dokumente, damit Entwickler vorhandene webbasierte Inhalte in ihren PDF-Erzeugungsprozessen nutzen und durchsuchbare PDF-Dateien erstellen können.
2. **Text- und Bildbearbeitung:** Fügen Sie Text, Bilder und andere Elemente in PDF-Dokumente ein und bearbeiten Sie diese einfach, um eine feingliedrige Kontrolle über das Layout und die Erscheinung der erzeugten PDFs zu erhalten.
3. **Dokumenten Zusammenführen und Teilen:** Kombinieren Sie mehrere PDF-Dokumente zu einer einzigen Datei oder teilen Sie große PDFs in kleinere, handlichere Dateien auf, um Flexibilität in der Dokumentenorganisation zu bieten.
4. **PDF-Formulare:** Erstellen und füllen Sie interaktive PDF-Formulare programmatisch aus, um die Automatisierung formularbezogener Aufgaben in Geschäftsapplikationen zu erleichtern.
5. **Sicherheitsfeatures:** Implementieren Sie Verschlüsselung und Passwortschutz, um PDF-Dokumente zu sichern und sicherzustellen, dass vertrauliche Informationen vor unbefugtem Zugriff geschützt bleiben.
6. **Textextraktion:** Extrahieren Sie Textinhalte aus PDF-Dokumenten zu Analyse- oder Indexierungszwecken, sodass Entwickler mit den in PDF-Dateien enthaltenen Textdaten mit der Texterkennungsfähigkeit von IronPDF arbeiten können.
### Installation von IronPDF for Python
Bevor wir mit dem Code-Tutorial beginnen, sehen wir uns erst an, wie IronPDF for Python installiert werden kann.
Stellen Sie zuerst sicher, dass Python auf dem System installiert ist und Sie eine gute Python-IDE wie PyCharm haben. Außerdem sollte PIP installiert sein, um IronPDF for Python zu installieren.
1. Erstellen Sie zunächst ein neues Python-Projekt oder öffnen Sie ein bestehendes.
2. Öffnen Sie die Konsole und führen Sie den folgenden Befehl aus und drücken Sie Enter.
```shell
:ProductInstall
```
3. So wird IronPDF for Python nahtlos in Ihr Python-Projekt integriert.
## Lesen von gescannten PDF-Dateien mit IronPDF for Python
In diesem Abschnitt sehen wir, wie Sie [Text aus gescannten PDF-Dateien extrahieren](/python/examples/extract-pdf-text/) können, indem Sie IronPDF verwenden.
```python
from ironpdf import *  # Import everything from ironpdf

# Set the license key for IronPDF
License.LicenseKey = "Your License Key"

# Load the scanned PDF document
pdf = PdfDocument.FromFile("C:/Users/buttw/INV_2023_00008.pdf")

# Extract all text from the PDF document
all_text = pdf.ExtractAllText()

# Print the extracted text
print(all_text)
```
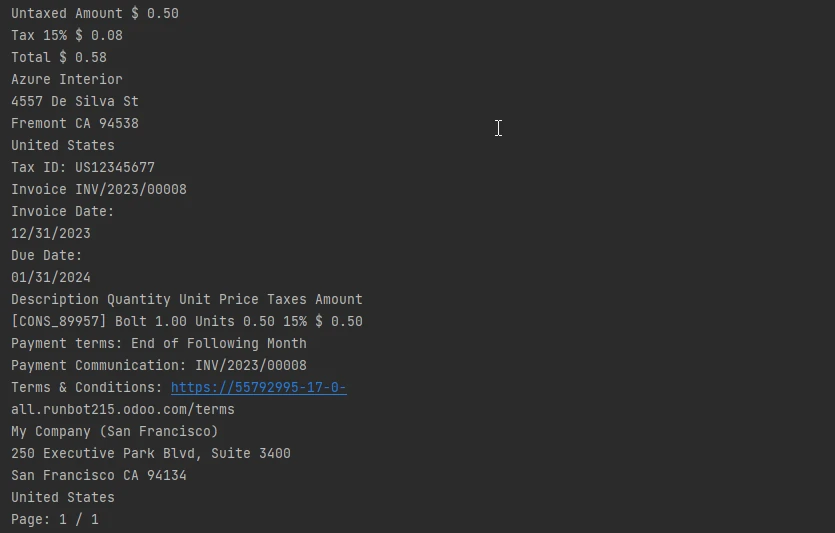
Das obige Codebeispiel extrahiert Text aus gescannten PDF-Dateien. Nachfolgend finden Sie die Aufschlüsselung des obigen Codes:
1. **Importieren des IronPDF-Moduls:**
```python
from ironpdf import *
```
Diese Zeile importiert die notwendigen Module und Klassen aus der IronPDF-Bibliothek. Das Sternchen (`*`) zeigt an, dass alle Klassen und Funktionen aus dem Modul importiert werden sollen.
2. **Setzen des Lizenzschlüssels:**
```python
License.LicenseKey = "Your License Key"
```
Diese Zeile setzt den Lizenzschlüssel für IronPDF. Sie müssen `"Your License Key"` durch den tatsächlichen Lizenzschlüssel ersetzen, den Sie von Iron Software erhalten haben.
Der Lizenzschlüssel ist notwendig für die Nutzung von IronPDF und wird in der Regel bereitgestellt, wenn Sie das Produkt kaufen.
3. **Laden eines gescannten PDF-Dokuments:**
```python
pdf = PdfDocument.FromFile("C:/Users/buttw/INV_2023_00008.pdf")
```
Diese Zeile lädt ein gescanntes PDF-Dokument, das sich am angegebenen Dateipfad (`"C:/Users/buttw/INV_2023_00008.pdf"`) befindet. Die `PdfDocument.FromFile` Methode wird verwendet, um ein `PdfDocument` Objekt aus der angegebenen Datei zu erstellen.
4. **Text aus PDF-Dokument extrahieren:**
```python
all_text = pdf.ExtractAllText()
```
Diese Zeile extrahiert den gesamten Textinhalt aus dem geladenen PDF-Dokument mit der [**ExtractAllText-Methode**](/python/examples/extract-pdf-text/) von allen Seiten. Der extrahierte Text wird dann in der `all_text` Variablen gespeichert.
5. **Extrahierten Text drucken:**
```python
print(all_text)
```
Schließlich druckt diese Zeile den extrahierten Text auf der Konsole aus. Die `all_text` Variable enthält den Textinhalt des gescannten PDF-Dokuments.
#### Eingabe-PDF
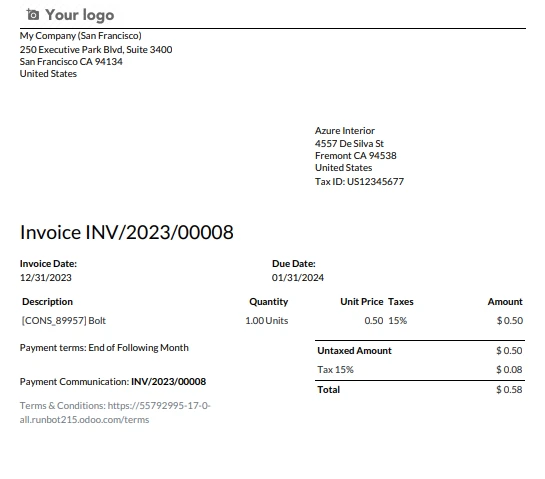
#### Ausgabetext
## Abschluss
Im Bereich der digitalen Dokumentenverarbeitung erweist sich die Programmiersprache Python als vielseitige Lösung zur Überwindung der Herausforderungen, die durch gescannte PDFs entstehen, die Bilder anstelle von durchsuchbarem Text enthalten.
Die Synergie zwischen der Flexibilität von Python und den robusten Fähigkeiten von IronPDF for Python bietet einen überzeugenden Weg für Entwickler, um PDF-Erzeugung, -Manipulation und -Extraktionsfunktionalitäten nahtlos in ihre Projekte zu integrieren.
[IronPDF](/python/), entwickelt von Iron Software, erweist sich in dieser Hinsicht als einflussreich, indem es Funktionen wie das Umwandeln von PDF-Dateien aus verschiedenen Dokumenttypen, HTML-zu-PDF-Seitenkonvertierung, Text- und Bildbearbeitung sowie OCR-basierte Textextraktion aus gescannten PDFs bietet.
Das präsentierte Codebeispiel zeigt die unkomplizierte Implementierung von IronPDF zur Textextraktion aus einer gescannten PDF-Seite, und demonstriert das Potenzial für eine effiziente Datenextraktion und die Verbesserung der Dokumentenverarbeitungsmöglichkeiten in Python-Anwendungen.
Da die Nachfrage nach anspruchsvoller PDF-Handhabung weiterhin steigt, steht IronPDF for Python als wertvolles Werkzeug bereit, das Entwicklern hilft, die Komplexitäten von gescannten Inhalten mit Leichtigkeit zu meistern.
IronPDF for Python bietet eine [Testlizenz](trial-license), die eine großartige Gelegenheit für Entwickler darstellt, um die Funktionen von IronPDF kennenzulernen.
Das vollständige Tutorial zur Textextraktion aus gescannten PDFs finden Sie [hier](/python/blog/using-ironpdf-for-python/extract-text-from-scanned-pdf-python/).
In der Ära der digitalen Transformation kann die Unverzichtbarkeit von PDF-Dokumenten zum Teilen und Bewahren von Informationen nicht genug betont werden.
Die Verbreitung von gescannten PDFs, die oft Bilder anstelle von durchsuchbarem Text enthalten, stellt jedoch eine erhebliche Herausforderung beim Extrahieren wertvoller Daten dar.
Hier erweist sich Python als vielseitige und leistungsstarke Lösung und etabliert sich als Anlaufstelle für die Automatisierung verschiedener Aufgaben, wobei die Informationsextraktion aus gescannten Dokumenten ein erstklassiges Beispiel ist.
Die Flexibilität und robusten Fähigkeiten von Python ermöglichen es Benutzern, effizient durch die Komplexitäten gescannter Inhalte zu navigieren, und bieten einen schlanken Ansatz, um auf Daten aus bildbasierten PDFs zuzugreifen und diese zu nutzen.
Python ist eine der am häufigsten verwendeten Programmiersprachen mit seiner fortschrittlichen Funktionalität. Besuchen Sie die Wikipedia-Seite zu Python, um mehr über die Programmiersprache Python und ihr strukturiertes Format zu erfahren.
In diesem Artikel werden wir diskutieren, wie man gescannte PDFs in der Programmiersprache Python mit Hilfe von IronPDF für die Python PDF-Bibliothek lesen kann.
Installieren Sie zuerst die IronPDF PDF-Bibliothek, um die gescannte PDF-Datei zu lesen.
Importieren Sie die erforderlichen Abhängigkeiten.
Laden Sie die gescannte PDF-Datei mit der PdfDocument.FromFile Methode.
Extrahieren Sie den gesamten Text aus der gescannten PDF mit der ExtractAllText Methode.
Drucken Sie den gesamten Text der PDF-Datei mit der print() Methode.
IronPDF for Python
IronPDF for Python ist eine robuste Bibliothek, die von Iron Software entwickelt wurde und eine nahtlose Integration von PDF-Erstellungs- und Manipulationsfunktionen in Python-Anwendungen ermöglicht.
Dieses vielseitige Werkzeug befähigt Entwickler, mühelos PDF-Dokumente zu erstellen, zu ändern und zu interagieren, wobei Aufgaben wie die Erzeugung dynamischer Berichte, die Konvertierung von HTML in PDF und das Extrahieren von Inhalten aus vorhandenen PDF-Dateien unterstützt werden.
Mit einer benutzerfreundlichen API, umfassender Dokumentation und einer Vielzahl von Funktionen vereinfacht IronPDF den Prozess des Einbaus von fortschrittlichen PDF-Funktionalitäten in Python-Projekte und macht es zu einer unschätzbaren Ressource für Entwickler, die ihre Anwendungen mit professionellen Dokumentenverarbeitungsmöglichkeiten erweitern möchten.
IronPDF Funktionen
IronPDF for Python ist mit einer Reihe von Funktionen ausgestattet, die es zu einem leistungsstarken Werkzeug für die PDF-Erzeugung und -Textstrukturmanipulation machen.
Einige seiner wichtigsten Funktionen sind:
HTML zu PDF-Konvertierung: Konvertieren Sie HTML-Inhalte, einschließlich CSS und Bilder, in hochwertige PDF-Dokumente, damit Entwickler vorhandene webbasierte Inhalte in ihren PDF-Erzeugungsprozessen nutzen und durchsuchbare PDF-Dateien erstellen können.
Text- und Bildbearbeitung: Fügen Sie Text, Bilder und andere Elemente in PDF-Dokumente ein und bearbeiten Sie diese einfach, um eine feingliedrige Kontrolle über das Layout und die Erscheinung der erzeugten PDFs zu erhalten.
Dokumenten Zusammenführen und Teilen: Kombinieren Sie mehrere PDF-Dokumente zu einer einzigen Datei oder teilen Sie große PDFs in kleinere, handlichere Dateien auf, um Flexibilität in der Dokumentenorganisation zu bieten.
PDF-Formulare: Erstellen und füllen Sie interaktive PDF-Formulare programmatisch aus, um die Automatisierung formularbezogener Aufgaben in Geschäftsapplikationen zu erleichtern.
Sicherheitsfeatures: Implementieren Sie Verschlüsselung und Passwortschutz, um PDF-Dokumente zu sichern und sicherzustellen, dass vertrauliche Informationen vor unbefugtem Zugriff geschützt bleiben.
Textextraktion: Extrahieren Sie Textinhalte aus PDF-Dokumenten zu Analyse- oder Indexierungszwecken, sodass Entwickler mit den in PDF-Dateien enthaltenen Textdaten mit der Texterkennungsfähigkeit von IronPDF arbeiten können.
Installation von IronPDF for Python
Bevor wir mit dem Code-Tutorial beginnen, sehen wir uns erst an, wie IronPDF for Python installiert werden kann.
Stellen Sie zuerst sicher, dass Python auf dem System installiert ist und Sie eine gute Python-IDE wie PyCharm haben. Außerdem sollte PIP installiert sein, um IronPDF for Python zu installieren.
Erstellen Sie zunächst ein neues Python-Projekt oder öffnen Sie ein bestehendes.
Öffnen Sie die Konsole und führen Sie den folgenden Befehl aus und drücken Sie Enter.
> pip install ironpdf
pip install ironpdf
So wird IronPDF for Python nahtlos in Ihr Python-Projekt integriert.
Lesen von gescannten PDF-Dateien mit IronPDF for Python
from ironpdf import * # Import everything from ironpdf# Set the license key for IronPDFLicense.LicenseKey = "Your License Key"# Load the scanned PDF documentpdf = PdfDocument.FromFile("C:/Users/buttw/INV_2023_00008.pdf")# Extract all text from the PDF documentall_text = pdf.ExtractAllText()# Print the extracted textprint(all_text)
from ironpdf import *  # Import everything from ironpdf

# Set the license key for IronPDF
License.LicenseKey = "Your License Key"

# Load the scanned PDF document
pdf = PdfDocument.FromFile("C:/Users/buttw/INV_2023_00008.pdf")

# Extract all text from the PDF document
all_text = pdf.ExtractAllText()

# Print the extracted text
print(all_text)
Python
Das obige Codebeispiel extrahiert Text aus gescannten PDF-Dateien. Nachfolgend finden Sie die Aufschlüsselung des obigen Codes:
Importieren des IronPDF-Moduls:
from ironpdf import *
from ironpdf import *
Python
Diese Zeile importiert die notwendigen Module und Klassen aus der IronPDF-Bibliothek. Das Sternchen (*) zeigt an, dass alle Klassen und Funktionen aus dem Modul importiert werden sollen.
Setzen des Lizenzschlüssels:
License.LicenseKey = "Your License Key"
License.LicenseKey = "Your License Key"
Python
Diese Zeile setzt den Lizenzschlüssel für IronPDF. Sie müssen "Your License Key" durch den tatsächlichen Lizenzschlüssel ersetzen, den Sie von Iron Software erhalten haben.
Der Lizenzschlüssel ist notwendig für die Nutzung von IronPDF und wird in der Regel bereitgestellt, wenn Sie das Produkt kaufen.
Laden eines gescannten PDF-Dokuments:
pdf = PdfDocument.FromFile("C:/Users/buttw/INV_2023_00008.pdf")
pdf = PdfDocument.FromFile("C:/Users/buttw/INV_2023_00008.pdf")
Python
Diese Zeile lädt ein gescanntes PDF-Dokument, das sich am angegebenen Dateipfad ("C:/Users/buttw/INV_2023_00008.pdf") befindet. Die PdfDocument.FromFile Methode wird verwendet, um ein PdfDocument Objekt aus der angegebenen Datei zu erstellen.
Text aus PDF-Dokument extrahieren:
all_text = pdf.ExtractAllText()
all_text = pdf.ExtractAllText()
Python
Diese Zeile extrahiert den gesamten Textinhalt aus dem geladenen PDF-Dokument mit der ExtractAllText-Methode von allen Seiten. Der extrahierte Text wird dann in der all_text Variablen gespeichert.
Extrahierten Text drucken:
print(all_text)
print(all_text)
Python
Schließlich druckt diese Zeile den extrahierten Text auf der Konsole aus. Die all_text Variable enthält den Textinhalt des gescannten PDF-Dokuments.
Eingabe-PDF
Ausgabetext
Abschluss
Im Bereich der digitalen Dokumentenverarbeitung erweist sich die Programmiersprache Python als vielseitige Lösung zur Überwindung der Herausforderungen, die durch gescannte PDFs entstehen, die Bilder anstelle von durchsuchbarem Text enthalten.
Die Synergie zwischen der Flexibilität von Python und den robusten Fähigkeiten von IronPDF for Python bietet einen überzeugenden Weg für Entwickler, um PDF-Erzeugung, -Manipulation und -Extraktionsfunktionalitäten nahtlos in ihre Projekte zu integrieren.
IronPDF, entwickelt von Iron Software, erweist sich in dieser Hinsicht als einflussreich, indem es Funktionen wie das Umwandeln von PDF-Dateien aus verschiedenen Dokumenttypen, HTML-zu-PDF-Seitenkonvertierung, Text- und Bildbearbeitung sowie OCR-basierte Textextraktion aus gescannten PDFs bietet.
Das präsentierte Codebeispiel zeigt die unkomplizierte Implementierung von IronPDF zur Textextraktion aus einer gescannten PDF-Seite, und demonstriert das Potenzial für eine effiziente Datenextraktion und die Verbesserung der Dokumentenverarbeitungsmöglichkeiten in Python-Anwendungen.
Da die Nachfrage nach anspruchsvoller PDF-Handhabung weiterhin steigt, steht IronPDF for Python als wertvolles Werkzeug bereit, das Entwicklern hilft, die Komplexitäten von gescannten Inhalten mit Leichtigkeit zu meistern.
IronPDF for Python bietet eine Testlizenz, die eine großartige Gelegenheit für Entwickler darstellt, um die Funktionen von IronPDF kennenzulernen.
Das vollständige Tutorial zur Textextraktion aus gescannten PDFs finden Sie hier.
Curtis Chau hat einen Bachelor-Abschluss in Informatik von der Carleton University und ist spezialisiert auf Frontend-Entwicklung mit Expertise in Node.js, TypeScript, JavaScript und React. Leidenschaftlich widmet er sich der Erstellung intuitiver und ästhetisch ansprechender Benutzerschnittstellen und arbeitet gerne mit modernen Frameworks sowie der Erstellung gut strukturierter, optisch ansprechender Handbücher.