



已更新 2026年4月21日
如何在 Python 中將 PDF 轉換為 PNG
在本文中,我們將使用 IronPDF for Python 將 PDF 拆分為 PNG 圖像文件。
閱讀更多

有效性和效率在線上抓取和文件生成領域至關重要。 順利整合強大的工具和框架是從網站中提取資料並隨後將其轉換成專業級別文件所必須的。
這裡來了Python中的Scrapy網頁抓取框架和IronPDF,這兩個強大的程式庫一起工作,以優化線上資料提取和動態PDF的建立。
借助Python中的Scrapy,一個頂尖的網抓和抓取圖書館,開發者現在可以輕鬆瀏覽複雜的網路,精確而快速地提取結構化資料。 憑藉其強大的XPath和CSS選擇器以及異步架構,它是任何複雜抓取任務的理想選擇。
反之,IronPDF是一個強大的.NET程式庫,支持PDF文件的程式化建立、編輯和操作。 憑藉其強大的PDF建立工具,包括HTML到PDF的轉換和PDF編輯能力,IronPDF為開發者提供了一套完整的動態生成和美觀PDF文件的解決方案。
本文將帶您參觀Scrapy Python與IronPDF的順利整合,並向您展示這對動態組合如何改變網頁抓取和文件建立的方式。 我們將展示這兩個程式庫如何協同工作以簡化複雜的任務並加速開發流程,從使用Scrapy從網頁抓取資料到使用IronPDF動態生成PDF報告。
來探索網頁抓取和文件生成的可能性,當我們使用IronPDF充分利用Scrapy。

Scrapy使用的異步架構使得能夠一次處理多個請求。 這導致效率提高和更快的網頁抓取速度,特別是在處理複雜網站或大量資料時。
Scrapy具有強大的Scrapy爬取過程管理功能,如自動URL過濾、可配置的請求調度和整合的robots.txt指令處理。 開發者可以調整爬取行為以符合自己的需求和保證遵循網站指導方針。
Scrapy允許使用者使用XPath和CSS選擇器在HTML頁面中定位和選擇項目。 這種適應性使得資料提取更準確和可靠,讓開發者可以準確定位網頁上的特定元素或模式。
使用Scrapy的項目管線,開發者可以指定可重用的組件來在導出或儲存資料之前處理抓取資料。通過執行清理、驗證、轉換和去重等操作,開發者可以保證提取資料的準確性和一致性。
Scrapy中預安裝的多個中介軟體組件提供自動cookie處理、請求限速、使用者代理旋轉和代理旋轉等功能。 這些中介軟體元素易於配置和自訂,以提高抓取效率和解決常見問題。
透過建立自訂中介軟體、擴展和管線,開發者可以進一步個性化和擴展Scrapy的功能,得益於其模組化和可擴展架構。 由於其適應性,開發者可以輕鬆地將Scrapy納入其現有流程中並調整它以滿足其獨特的抓取需求。
透過運行以下命令使用pip安裝Scrapy:
pip install scrapy要定義您的蜘蛛,請在example.py)。 這裡提供了一個從URL中提取的基本蜘蛛的範例:
import scrapy

class QuotesSpider(scrapy.Spider):
    # Name of the spider
    name = 'quotes'
    # Starting URL
    start_urls = ['http://quotes.toscrape.com']

    def parse(self, response):
        # Iterate through each quote block in the response
        for quote in response.css('div.quote'):
            # Extract and yield quote details
            yield {
                'text': quote.css('span.text::text').get(),
                'author': quote.css('span small.author::text').get(),
                'tags': quote.css('div.tags a.tag::text').getall(),
            }
        # Identify and follow the next page link
        next_page = response.css('li.next a::attr(href)').get()
        if next_page is not None:
yield response.follow(next_page, self.parse)要設置Scrapy專案參數,如使用者代理、下載延遲和管線,編輯settings.py文件。這裡是如何更改使用者代理並使管線功能化的範例:
# Obey robots.txt rules
ROBOTSTXT_OBEY = True
# Set user-agent
USER_AGENT = 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.3'
# Configure pipelines
ITEM_PIPELINES = {
    'myproject.pipelines.MyPipeline': 300,
}開始使用Scrapy和IronPDF需要結合Scrapy強大的網頁抓取能力和IronPDF的動態PDF生成功能。 下面我會帶您逐步設置Scrapy專案,以便您能夠從網站提取資料並使用IronPDF建立包含這些資料的PDF文件。
IronPDF是一個強大的.NET程式庫用於在C#、VB.NET和其他.NET語言中程式化地建立、編輯和改變PDF文件。 由於它為開發者提供了一套廣泛的功能集以動態建立高質量的PDF,因此它是許多應用程式的熱門選擇。
**PDF生成:**使用IronPDF,程式設計師可以建立新的PDF文件或將現有的HTML元素如標籤、文字、圖像和其他文件格式轉換為PDF。 此功能在動態建立報表、發票、收據和其他文件時非常有用。
**HTML到PDF轉換:**IronPDF使開發者可以輕鬆地將HTML文件(包括JavaScript和CSS中的樣式)轉換為PDF文件。 這使得從網頁、動態生成的內容和HTML模板中建立PDF。
**PDF文件的修改和編輯:**IronPDF提供全面的功能集用於修改和改變預先存在的PDF文件。 開發者可以合併多個PDF文件、將它們分成單獨的文件、刪除頁面、新增書籤、註釋和水印等功能,以根據他們的需求自定義PDF。
在確保Python已安裝在您的計算機上之後,請使用pip安裝IronPDF。
要定義您的蜘蛛,請在Scrapy專案的蜘蛛目錄(example.py)。 從URL中提取引用的基本蜘蛛的程式碼範例:
import scrapy
from IronPdf import *

class QuotesSpider(scrapy.Spider):
    name = 'quotes'
    # Web page link
    start_urls = ['http://quotes.toscrape.com']

    def parse(self, response):
        quotes = []
        for quote in response.css('div.quote'):
            title = quote.css('span.text::text').get()
            content = quote.css('span small.author::text').get()
            quotes.append((title, content))  # Append quote to list

        # Generate PDF document using IronPDF
        renderer = ChromePdfRenderer()
        pdf = renderer.RenderHtmlAsPdf(self.get_pdf_content(quotes))
        pdf.SaveAs("quotes.pdf")

    def get_pdf_content(self, quotes):
        # Generate HTML content for PDF using extracted quotes
        html_content = "<html><head><title>Quotes</title></head><body>"
        for title, content in quotes:
            html_content += f"<h2>{title}</h2><p>Author: {content}</p>"
        html_content += "</body></html>"
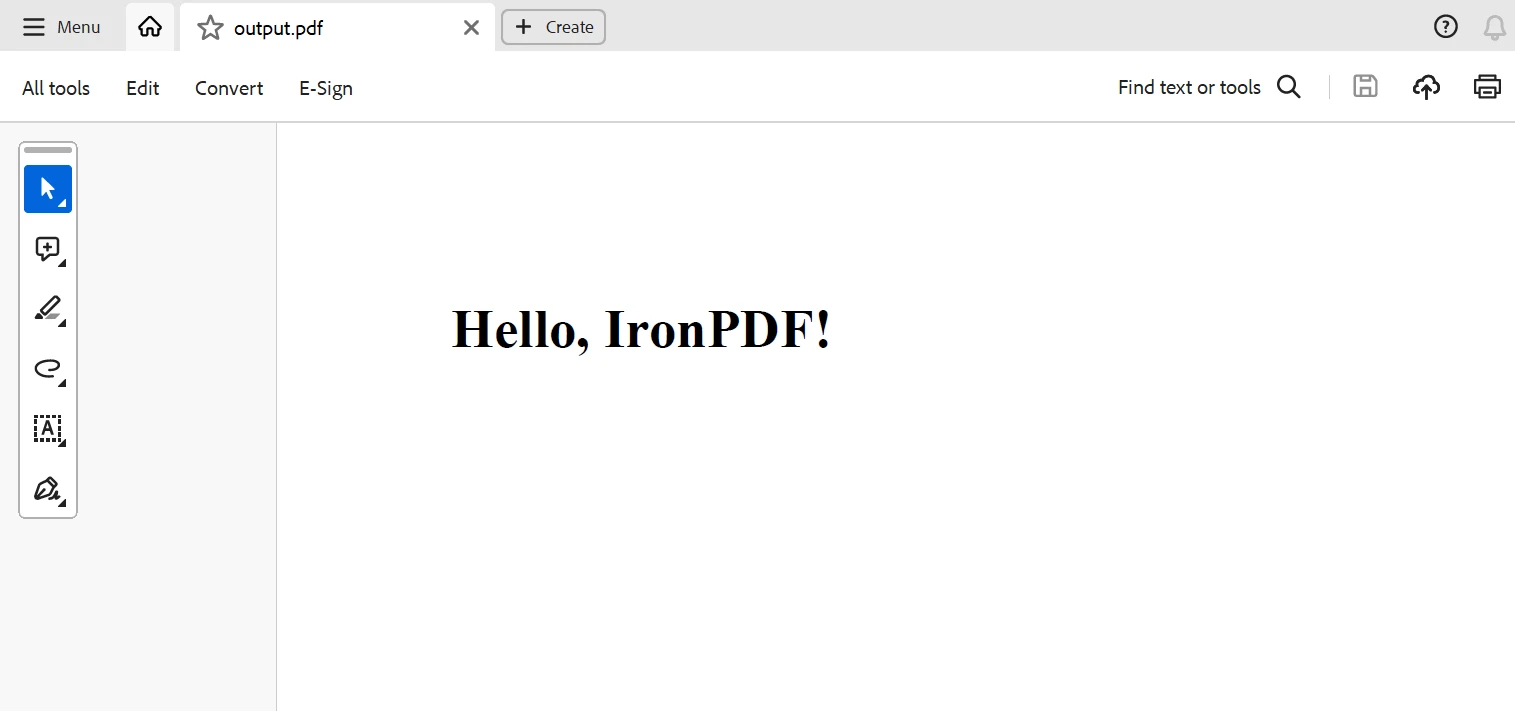
return html_content在上面的含有IronPDF的Scrapy專案的程式碼範例中,IronPDF被用於使用Scrapy提取的資料建立PDF文件。
在這裡,蜘蛛的quotes.pdf。
總結來說,Scrapy和IronPDF的結合為開發者提供了一個強大的選擇,可以自動執行網頁抓取活動並即時生成PDF文件。 IronPDF的可擴展PDF生成功能與Scrapy強大的網頁抓取和抓取能力一起為從任何網頁收集結構化資料並將提取的資料轉換為專業品質的PDF報告、發票或文件提供了一個順利的過程。
透過利用Scrapy Spider Python,開發者可以有效地導航互聯網的複雜性,從多個來源檢索資訊,並以系統的方式安排這些資訊。 Scrapy的靈活框架、異步架構和對XPath和CSS選擇器的支持使其擁有管理各種網頁抓取活動所需的靈活性和擴展性。
IronPDF附帶了終身授權,當以套裝形式購買時價格合理。 此套裝提供了絕佳的價值,只需$999(可一次性購買適用於多個系統)。 持有授權的人士可24/7存取線上技術支援。 如需有關費用的進一步資訊,敬請存取網站。 造訪此頁面以了解有關Iron Software的產品的更多資訊。

Curtis Chau擁有Carleton大學的電腦科學學士學位,專精於前端開發,擁有Node.js、TypeScript、JavaScript和React的專業知識。Curtis熱衷於建立直觀且美觀的使用者介面,喜愛使用現代框架並建立結構良好、視覺吸引力的手冊。

IronPDF 是 IRONSUITE 的一部分
10 款適用於辦公室文件的 .NET API 產品

當您需要您的PDF看起來像HTML一樣快速。



