import {PdfDocument} from "@ironsoftware/ironpdf";

(async () => {
    // Create a PDF from an HTML string
    const pdf = await PdfDocument.fromHtml("<h1>Hello World</h1>");

    // Export the PDF to a file
    await pdf.saveAs("output.pdf");

    // Advanced Example with HTML Assets
    // Load external HTML assets: Images, CSS, and JavaScript.
    const htmlContentWithAssets = "<img src='icons/iron.png'>";
    const advancedPdf = await PdfDocument.fromHtml(htmlContentWithAssets);

    // Save the PDF with loaded assets
    await advancedPdf.saveAs("html-with-assets.pdf");
})();
import {PdfDocument} from "@ironsoftware/ironpdf";(async () => { // Create a PDF from an HTML string const pdf = awaitPdfDocument.fromHtml("<h1>Hello World</h1>"); // Export the PDF to a file await pdf.saveAs("output.pdf"); // Advanced Example with HTML Assets // Load external HTML assets: Images, CSS, and JavaScript. const htmlContentWithAssets = "<img src='icons/iron.png'>"; const advancedPdf = awaitPdfDocument.fromHtml(htmlContentWithAssets); // Save the PDF with loaded assets await advancedPdf.saveAs("html-with-assets.pdf");})();
NODE-HILFE
body parser node (Wie es für Entwickler funktioniert)
Mit seiner ereignisgesteuerten, nicht blockierenden E/A-Architektur hat Node.js, eine leistungsstarke JavaScript-Laufzeitumgebung, die auf der V8-JavaScript-Engine von Chrome basiert, die serverseitige Webentwicklung völlig verändert. Das Parsen eingehender Request Bodies ist ein gängiger Schritt bei der schnellen Bearbeitung von HTTP-Anfragen mit Node.js, der für die Webentwicklung und die Entwicklung zuverlässiger Webanwendungen unerlässlich ist. Die Body-Parser-Middleware ist in dieser Situation nützlich.
[**Body-parser**](https://github.com/expressjs/body-parser#readme) ist eine Middleware für das bekannte Node.js-Framework Express.js, die den Zugriff auf vom Client gesendete Daten und deren Änderung erleichtert, indem sie den Prozess des Parsens eingehender Anfragebodies vor den Handlern rationalisiert. Die Body-Parser-Middleware bietet eine effiziente Methode zur Verarbeitung verschiedener Inhaltstypen, wie JSON-Payloads, URL-codierte Formulare oder Rohtext, damit Ihre Anwendung Benutzereingaben effizient verarbeiten kann.
Auf der anderen Seite ist [**IronPDF**](/nodejs/) eine leistungsstarke PDF-Erzeugungsbibliothek für Node.js. Sie ermöglicht es Entwicklern, PDF-Dokumente auf einfache Weise programmatisch zu erstellen, zu bearbeiten und zu manipulieren. Die Kombination von body-parser mit IronPDF eröffnet eine Fülle von Möglichkeiten für Webanwendungen, die Benutzereingaben verarbeiten und auf Basis dieser Daten dynamische PDF-Dokumente erzeugen müssen.
In diesem Artikel wird untersucht, wie body-parser in Node.js integriert werden kann, um HTTP-Anfragen zu verarbeiten und anschließend IronPDF zu verwenden, um PDF-Dokumente aus dem bereits geparsten body-Objekt zu erzeugen. Diese Kombination ist besonders nützlich für Anwendungen, die eine automatische Berichtserstellung, Rechnungserstellung oder andere Szenarien erfordern, bei denen dynamische PDF-Inhalte erforderlich sind.
## Hauptmerkmale von Body Parser
**JSON-Parsing**
Analysiert Anfragekörper im JSON-Format, was die Verarbeitung von JSON-Daten in APIs mit diesen Körperparsern vereinfacht.
**URL-codierte Datenanalyse**
Analysiert mit einer URL kodierte Daten, die üblicherweise in HTML-Formularen vorkommen. Es werden sowohl einfache als auch anspruchsvolle Objektstrukturen unterstützt.
**Rohdaten-Parsing**
Analysiert die binären Rohdaten eingehender Anfragen, was die Verwaltung einzigartiger Datenformate und nicht standardisierter Inhaltstypen erleichtert.
**Textdaten-Parsing**
Analysiert eingehende Anfragen nach reinen Textdaten und vereinfacht so die Verarbeitung von textbasierten Inhalten.
**Konfigurierbare Größenbeschränkungen**
Ermöglicht die Festlegung von Größenbeschränkungen für den Anfragekörper, um zu verhindern, dass schwere Nutzdaten den Server überlasten. Dies hilft bei der Verbesserung der Sicherheit und der Kontrolle der Ressourcennutzung.
**Automatische Content-Type-Erkennung**
Verschiedene Arten von Inhalten werden effizienter gehandhabt, indem der Anfragebody auf der Grundlage des Content-Type-Headers automatisch identifiziert und verarbeitet wird, wodurch manuelle Eingriffe überflüssig werden.
**Fehlerbehandlung**
Starke Fehlerbehandlung, um sicherzustellen, dass Anwendungen höflich auf Anfragen reagieren können, die Probleme verursachen, z. B. ungültige Medienformate, fehlerhaftes JSON oder übermäßig große Datenkörper.
**Integration with Other Middleware**
Ermöglicht einen modularen und gut organisierten Middleware-Stack durch nahtlose Integration mit bestehender Express-Middleware. Dadurch wird die Wartbarkeit und Flexibilität der Anwendung verbessert.
**Erweiterte Konfigurationsoptionen**
Bietet Konfigurationsoptionen, um das Verhalten des Parsing-Prozesses zu ändern, wie z. B. die Änderung des Kodierungstyps für das Text-Parsing oder die Definition der Verarbeitungstiefe für URL-kodierte Daten.
**Leistungsoptimierung**
Sie verwaltet die Parsing-Vorgänge effektiv, reduziert den Leistungs-Overhead und garantiert, dass das Programm auch in Situationen mit hoher Last reaktionsfähig bleibt.
## Create and Config Body Parser in Node.js
So verwenden Sie Express.js zum Erstellen und Einrichten von Body Parser in einer Node.js-Anwendung
### Installieren Sie Express und Body-Parser
Installieren Sie die Pakete Express und Body-Parser mit diesen npm-Befehlen in der Kommandozeile:
```shell
npm install express
npm install body-parser
```
#### Erstellen und Konfigurieren der Anwendung
Erstellen Sie in Ihrem Projektverzeichnis eine neue JavaScript-Datei namens `app.js` und konfigurieren Sie das body-parser-Middleware für die Express-Anwendung:
```js
const express = require('express');
const bodyParser = require('body-parser');
const app = express();
// Use body-parser middleware to parse JSON and URL-encoded data
app.use(bodyParser.json());
app.use(bodyParser.urlencoded({ extended: true }));
// Example route that handles POST requests using the req.body property
app.post('/submit', (req, res) => {
const data = req.body;
res.send(`Received data: ${JSON.stringify(data)}`);
});
// Start the server
const PORT = process.env.PORT || 3000;
app.listen(PORT, () => {
console.log(`Server is running on port ${PORT}`);
});
```
### Behandlung verschiedener Inhaltstypen
Darüber hinaus können wir Body Parser so einrichten, dass er verschiedene Arten von Daten verarbeiten kann, einschließlich reiner Text- oder Rohdaten in Binärform aus:
**Rohdaten-Parsing**
```js
app.use(bodyParser.raw({ type: 'application/octet-stream' }));
```
**Textdaten-Parsing**
```js
app.use(bodyParser.text({ type: 'text/plain' }));
```
### Fehlerbehandlung
Eine Middleware für die Fehlerbehandlung kann verwendet werden, um potenzielle Probleme, die beim Parsen des Textkörpers auftreten, zu bewältigen.
```js
app.use((err, req, res, next) => {
if (err) {
res.status(400).send('Invalid request body');
} else {
next();
}
});
```
## Einstieg mit IronPDF
### Was ist IronPDF?
Mit [**IronPDF**](/nodejs/) können Entwickler PDF-Dokumente programmatisch erstellen, verändern und manipulieren. IronPDF ist eine robuste PDF-Generierungsbibliothek für Node.js mit Unterstützung für zahlreiche Funktionen wie Styling, Skripting und komplizierte Layouts, die die Konvertierung von HTML-Material in PDF vereinfacht.
Dynamische Berichte, Rechnungen und andere Dokumente können mit IronPDF direkt aus Webanwendungen erstellt werden. Es ist eine flexible Lösung für jede Anwendung, die PDF-Funktionen benötigt, da es problemlos mit Node.js und anderen Frameworks zusammenarbeitet. IronPDF ist die erste Wahl für Entwickler, die eine zuverlässige PDF-Erstellung und -Änderung wünschen, da es über umfangreiche Funktionen verfügt und einfach zu bedienen ist.
### IronPDF Hauptmerkmale
#### Konvertierung von HTML in PDF
Ermöglicht anspruchsvolle Layouts, CSS und JavaScript bei der Konvertierung von HTML-Inhalten in PDF-Dokumente. Ermöglicht die Erstellung von PDFs durch Entwickler unter Verwendung bereits vorhandener Webvorlagen.
#### Erweiterte Optionen für Rendering
Gibt Seitennummerierung, Fußzeilen und Kopfzeilen zur Auswahl. Wasserzeichen, Hintergrundbilder und andere anspruchsvolle Layout-Elemente werden unterstützt.
#### Bearbeiten und Manipulieren von PDFs
Ermöglicht die Änderung von Seiten, das Zusammenführen von Seiten und das Teilen von Seiten in bereits vorhandenen PDF-Dokumenten. Ermöglicht das Hinzufügen, Löschen oder Neuanordnen von Seiten innerhalb einer PDF-Datei.
### Installation von IronPDF
Um die IronPDF-Funktionalität zu aktivieren, installieren Sie das erforderliche Paket in Node.js mit dem Node Package Manager.
```shell
:ProductInstall
```
### Erstellen eines PDF-Berichts mit IronPDF
Durch die Zusammenarbeit von IronPDF und Body Parser in Node.js können Entwickler Anfragedaten verarbeiten und dynamische PDF-Dokumente effizient erstellen. Dies ist eine detaillierte Anleitung zur Konfiguration und Nutzung dieser Funktionen in einer Node.js-Anwendung.
Richten Sie die Express-Anwendung mit Body Parser und IronPDF ein und erstellen Sie dann eine Datei namens `app.js`.
```js
const express = require('express');
const bodyParser = require('body-parser');
const IronPdf = require("@ironsoftware/ironpdf");
const app = express();
// Middleware to parse JSON and URL-encoded data
app.use(bodyParser.json());
app.use(bodyParser.urlencoded({ extended: true }));
// Route to handle PDF generation
app.post('/generate-pdf', async (req, res) => {
const data = req.body;
// HTML content to be converted into PDF
const htmlContent = `
<html>
<head></head>
<body>
<h1>${JSON.stringify(data, null, 2)}</h1>
</body>
</html>
`;
try {
// Create an instance of IronPDF document
const document = await IronPdf.PdfDocument.fromHtml(htmlContent);
// Convert to PDF buffer
let pdfBuffer = await document.saveAsBuffer();
// Set response headers to serve the PDF
res.setHeader('Content-Type', 'application/pdf');
res.setHeader('Content-Disposition', 'attachment; filename=generated.pdf');
// Send the PDF as the response
res.send(pdfBuffer);
} catch (error) {
console.error('Error generating PDF:', error);
res.status(500).send('Error generating PDF');
}
});
// Start the server
const PORT = process.env.PORT || 3000;
app.listen(PORT, () => {
console.log(`Server is running on port ${PORT}`);
});
```
In dieser Konfiguration wird IronPDF zur Generierung von PDFs verwendet, während die Funktionalitäten des Node.js Body Parsers kombiniert werden. Zu Beginn importieren wir die erforderlichen Module, wie IronPDF für die PDF-Erzeugung, Body Parser für das Parsen eingehender Anfragen und Express für die Serverkonstruktion. Als Nächstes richten wir eine Express-Middleware ein, um JSON- und URL-kodierte Formulardaten mit Body Parser zu parsen.
Für die Bearbeitung von POST-Anfragen richten wir eine Route namens **generate-pdf** ein, über die wir den Inhalt der Anfrage erhalten. Diese JSON-formatierten Daten werden in eine HTML-Vorlage integriert, die als Inhalt der PDF-Datei verwendet wird. Wir instanziieren ein Dokument mit `IronPdf` und verwandeln den HTML-Inhalt in ein PDF-Dokument.
Nachdem die PDF-Datei erfolgreich generiert wurde, senden wir die Antwort mit entsprechenden Kopfzeilen, um den Dateinamen und den Inhaltstyp anzugeben. Die Fehlerbehandlung stellt sicher, dass alle Probleme, die bei der Erstellung von PDFs auftreten, identifiziert, aufgezeichnet und dem Kunden mit entsprechenden Statuscodes mitgeteilt werden.
#### Ausgabe
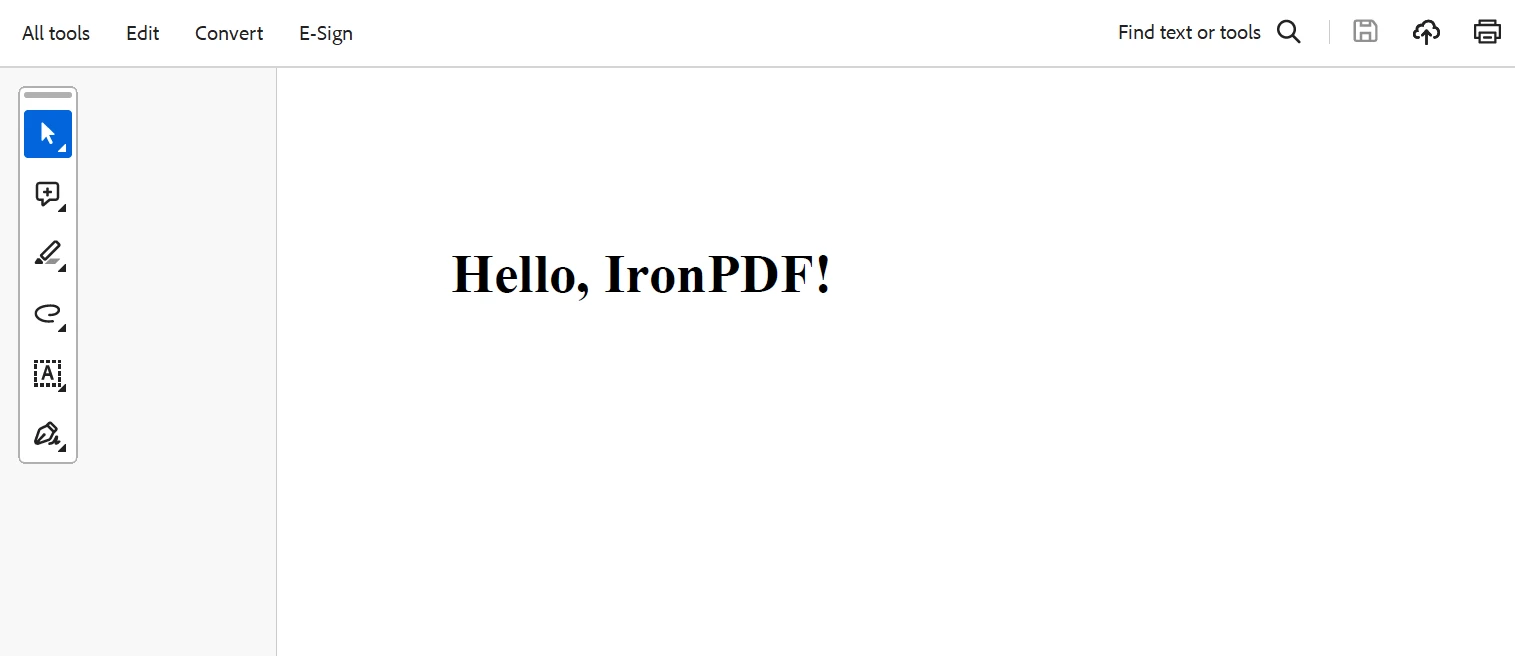
Schließlich wird der Server gestartet und wartet auf einem bestimmten Port auf eingehende Anfragen. Mit dieser Konfiguration können die Anfragebearbeitung mit Body Parser und die dynamische PDF-Erzeugung mit IronPDF leicht in eine Node.js-Anwendung integriert werden, was effektivere Arbeitsabläufe bei der Datenverarbeitung und Dokumentenerzeugung ermöglicht.
## Abschluss
Zusammenfassend lässt sich sagen, dass die Kombination von [**IronPDF**](/nodejs/) und Body Parser in Node.js einen stabilen Weg zur Verwaltung von HTTP-Request-Body-Daten und zur Erstellung dynamischer PDF-Dokumente zur Verwendung in Online-Anwendungen bietet. Entwickler können mit Body Parser leichter auf eingehende Daten zugreifen und diese ändern, indem sie den Prozess des Parsens verschiedener Arten von Anfragebodies rationalisieren.
IronPDF hingegen verfügt über robuste Funktionen zur Erstellung hochwertiger PDF-Dokumente mit erweiterten Funktionen, Formatierungen und Styling aus HTML-Text. Durch die Kombination dieser Technologien können Entwickler benutzerdefinierte PDF-Dokumente auf der Grundlage von Anwendungsdaten oder Benutzereingaben schneller erstellen. Mit Hilfe dieser Integration können Node.js-Apps jetzt nutzergenerierte Inhalte effektiver verarbeiten und PDFs ausgeben, die professionell aussehen.
Durch die Integration von IronPDF- und Iron Software-Produkten in Ihre Entwicklungsumgebung können wir funktionsreiche, hochwertige Softwarelösungen für Kunden und Endbenutzer garantieren. Darüber hinaus wird dies bei der Projekt- und Prozessoptimierung helfen. [**Iron Software**](licensing)-Preise beginnen bei `$liteLicense`, und sie sind verlässliche Partner für moderne Softwareentwicklungsprojekte aufgrund ihrer umfangreichen Dokumentation, lebendigen Community und häufigen Aktualisierungen.
Mit seiner ereignisgesteuerten, nicht blockierenden E/A-Architektur hat Node.js, eine leistungsstarke JavaScript-Laufzeitumgebung, die auf der V8-JavaScript-Engine von Chrome basiert, die serverseitige Webentwicklung völlig verändert. Das Parsen eingehender Request Bodies ist ein gängiger Schritt bei der schnellen Bearbeitung von HTTP-Anfragen mit Node.js, der für die Webentwicklung und die Entwicklung zuverlässiger Webanwendungen unerlässlich ist. Die Body-Parser-Middleware ist in dieser Situation nützlich.
Body-parser ist eine Middleware für das bekannte Node.js-Framework Express.js, die den Zugriff auf vom Client gesendete Daten und deren Änderung erleichtert, indem sie den Prozess des Parsens eingehender Anfragebodies vor den Handlern rationalisiert. Die Body-Parser-Middleware bietet eine effiziente Methode zur Verarbeitung verschiedener Inhaltstypen, wie JSON-Payloads, URL-codierte Formulare oder Rohtext, damit Ihre Anwendung Benutzereingaben effizient verarbeiten kann.
Auf der anderen Seite ist IronPDF eine leistungsstarke PDF-Erzeugungsbibliothek für Node.js. Sie ermöglicht es Entwicklern, PDF-Dokumente auf einfache Weise programmatisch zu erstellen, zu bearbeiten und zu manipulieren. Die Kombination von body-parser mit IronPDF eröffnet eine Fülle von Möglichkeiten für Webanwendungen, die Benutzereingaben verarbeiten und auf Basis dieser Daten dynamische PDF-Dokumente erzeugen müssen.
In diesem Artikel wird untersucht, wie body-parser in Node.js integriert werden kann, um HTTP-Anfragen zu verarbeiten und anschließend IronPDF zu verwenden, um PDF-Dokumente aus dem bereits geparsten body-Objekt zu erzeugen. Diese Kombination ist besonders nützlich für Anwendungen, die eine automatische Berichtserstellung, Rechnungserstellung oder andere Szenarien erfordern, bei denen dynamische PDF-Inhalte erforderlich sind.
Hauptmerkmale von Body Parser
JSON-Parsing
Analysiert Anfragekörper im JSON-Format, was die Verarbeitung von JSON-Daten in APIs mit diesen Körperparsern vereinfacht.
URL-codierte Datenanalyse
Analysiert mit einer URL kodierte Daten, die üblicherweise in HTML-Formularen vorkommen. Es werden sowohl einfache als auch anspruchsvolle Objektstrukturen unterstützt.
Rohdaten-Parsing
Analysiert die binären Rohdaten eingehender Anfragen, was die Verwaltung einzigartiger Datenformate und nicht standardisierter Inhaltstypen erleichtert.
Textdaten-Parsing
Analysiert eingehende Anfragen nach reinen Textdaten und vereinfacht so die Verarbeitung von textbasierten Inhalten.
Konfigurierbare Größenbeschränkungen
Ermöglicht die Festlegung von Größenbeschränkungen für den Anfragekörper, um zu verhindern, dass schwere Nutzdaten den Server überlasten. Dies hilft bei der Verbesserung der Sicherheit und der Kontrolle der Ressourcennutzung.
Automatische Content-Type-Erkennung
Verschiedene Arten von Inhalten werden effizienter gehandhabt, indem der Anfragebody auf der Grundlage des Content-Type-Headers automatisch identifiziert und verarbeitet wird, wodurch manuelle Eingriffe überflüssig werden.
Fehlerbehandlung
Starke Fehlerbehandlung, um sicherzustellen, dass Anwendungen höflich auf Anfragen reagieren können, die Probleme verursachen, z. B. ungültige Medienformate, fehlerhaftes JSON oder übermäßig große Datenkörper.
Integration with Other Middleware
Ermöglicht einen modularen und gut organisierten Middleware-Stack durch nahtlose Integration mit bestehender Express-Middleware. Dadurch wird die Wartbarkeit und Flexibilität der Anwendung verbessert.
Erweiterte Konfigurationsoptionen
Bietet Konfigurationsoptionen, um das Verhalten des Parsing-Prozesses zu ändern, wie z. B. die Änderung des Kodierungstyps für das Text-Parsing oder die Definition der Verarbeitungstiefe für URL-kodierte Daten.
Leistungsoptimierung
Sie verwaltet die Parsing-Vorgänge effektiv, reduziert den Leistungs-Overhead und garantiert, dass das Programm auch in Situationen mit hoher Last reaktionsfähig bleibt.
Create and Config Body Parser in Node.js
So verwenden Sie Express.js zum Erstellen und Einrichten von Body Parser in einer Node.js-Anwendung
Installieren Sie Express und Body-Parser
Installieren Sie die Pakete Express und Body-Parser mit diesen npm-Befehlen in der Kommandozeile:
npm install expressnpm install body-parser
npm install express
npm install body-parser
SHELL
Erstellen und Konfigurieren der Anwendung
Erstellen Sie in Ihrem Projektverzeichnis eine neue JavaScript-Datei namens app.js und konfigurieren Sie das body-parser-Middleware für die Express-Anwendung:
const express = require('express');const bodyParser = require('body-parser');const app = express();// Use body-parser middleware to parse JSON and URL-encoded dataapp.use(bodyParser.json());app.use(bodyParser.urlencoded({ extended: true }));// Example route that handles POST requests using the req.body propertyapp.post('/submit', (req, res) => { const data = req.body; res.send(`Received data: ${JSON.stringify(data)}`);});// Start the serverconstPORT = process.env.PORT || 3000;app.listen(PORT, () => { console.log(`Server is running on port ${PORT}`);});
const express = require('express');
const bodyParser = require('body-parser');
const app = express();

// Use body-parser middleware to parse JSON and URL-encoded data
app.use(bodyParser.json());
app.use(bodyParser.urlencoded({ extended: true }));

// Example route that handles POST requests using the req.body property
app.post('/submit', (req, res) => {
  const data = req.body;
  res.send(`Received data: ${JSON.stringify(data)}`);
});

// Start the server
const PORT = process.env.PORT || 3000;
app.listen(PORT, () => {
  console.log(`Server is running on port ${PORT}`);
});
JavaScript
Behandlung verschiedener Inhaltstypen
Darüber hinaus können wir Body Parser so einrichten, dass er verschiedene Arten von Daten verarbeiten kann, einschließlich reiner Text- oder Rohdaten in Binärform aus:
Mit IronPDF können Entwickler PDF-Dokumente programmatisch erstellen, verändern und manipulieren. IronPDF ist eine robuste PDF-Generierungsbibliothek für Node.js mit Unterstützung für zahlreiche Funktionen wie Styling, Skripting und komplizierte Layouts, die die Konvertierung von HTML-Material in PDF vereinfacht.
Dynamische Berichte, Rechnungen und andere Dokumente können mit IronPDF direkt aus Webanwendungen erstellt werden. Es ist eine flexible Lösung für jede Anwendung, die PDF-Funktionen benötigt, da es problemlos mit Node.js und anderen Frameworks zusammenarbeitet. IronPDF ist die erste Wahl für Entwickler, die eine zuverlässige PDF-Erstellung und -Änderung wünschen, da es über umfangreiche Funktionen verfügt und einfach zu bedienen ist.
IronPDF Hauptmerkmale
Konvertierung von HTML in PDF
Ermöglicht anspruchsvolle Layouts, CSS und JavaScript bei der Konvertierung von HTML-Inhalten in PDF-Dokumente. Ermöglicht die Erstellung von PDFs durch Entwickler unter Verwendung bereits vorhandener Webvorlagen.
Erweiterte Optionen für Rendering
Gibt Seitennummerierung, Fußzeilen und Kopfzeilen zur Auswahl. Wasserzeichen, Hintergrundbilder und andere anspruchsvolle Layout-Elemente werden unterstützt.
Bearbeiten und Manipulieren von PDFs
Ermöglicht die Änderung von Seiten, das Zusammenführen von Seiten und das Teilen von Seiten in bereits vorhandenen PDF-Dokumenten. Ermöglicht das Hinzufügen, Löschen oder Neuanordnen von Seiten innerhalb einer PDF-Datei.
Installation von IronPDF
Um die IronPDF-Funktionalität zu aktivieren, installieren Sie das erforderliche Paket in Node.js mit dem Node Package Manager.
> npm i @ironsoftware/ironpdf
npm i @ironsoftware/ironpdf
Erstellen eines PDF-Berichts mit IronPDF
Durch die Zusammenarbeit von IronPDF und Body Parser in Node.js können Entwickler Anfragedaten verarbeiten und dynamische PDF-Dokumente effizient erstellen. Dies ist eine detaillierte Anleitung zur Konfiguration und Nutzung dieser Funktionen in einer Node.js-Anwendung.
Richten Sie die Express-Anwendung mit Body Parser und IronPDF ein und erstellen Sie dann eine Datei namens app.js.
const express = require('express');const bodyParser = require('body-parser');constIronPdf = require("@ironsoftware/ironpdf");const app = express();// Middleware to parse JSON and URL-encoded dataapp.use(bodyParser.json());app.use(bodyParser.urlencoded({ extended: true }));// Route to handle PDF generationapp.post('/generate-pdf', async (req, res) => { const data = req.body; // HTML content to be converted into PDF const htmlContent = ` <html> <head></head> <body> <h1>${JSON.stringify(data, null, 2)}</h1> </body> </html> `; try { // Create an instance of IronPDF document const document = awaitIronPdf.PdfDocument.fromHtml(htmlContent); // Convert to PDF buffer let pdfBuffer = await document.saveAsBuffer(); // Set response headers to serve the PDF res.setHeader('Content-Type', 'application/pdf'); res.setHeader('Content-Disposition', 'attachment; filename=generated.pdf'); // Send the PDF as the response res.send(pdfBuffer); } catch (error) { console.error('Error generating PDF:', error); res.status(500).send('Error generating PDF'); }});// Start the serverconstPORT = process.env.PORT || 3000;app.listen(PORT, () => { console.log(`Server is running on port ${PORT}`);});
const express = require('express');
const bodyParser = require('body-parser');
const IronPdf = require("@ironsoftware/ironpdf");

const app = express();

// Middleware to parse JSON and URL-encoded data
app.use(bodyParser.json());
app.use(bodyParser.urlencoded({ extended: true }));

// Route to handle PDF generation
app.post('/generate-pdf', async (req, res) => {
  const data = req.body;

  // HTML content to be converted into PDF
  const htmlContent = `
    <html>
    <head></head>
    <body>
      <h1>${JSON.stringify(data, null, 2)}</h1>
    </body>
    </html>
  `;
  try {
    // Create an instance of IronPDF document
    const document = await IronPdf.PdfDocument.fromHtml(htmlContent);
    // Convert to PDF buffer
    let pdfBuffer = await document.saveAsBuffer();

    // Set response headers to serve the PDF
    res.setHeader('Content-Type', 'application/pdf');
    res.setHeader('Content-Disposition', 'attachment; filename=generated.pdf');

    // Send the PDF as the response
    res.send(pdfBuffer);

  } catch (error) {
    console.error('Error generating PDF:', error);
    res.status(500).send('Error generating PDF');
  }
});

// Start the server
const PORT = process.env.PORT || 3000;
app.listen(PORT, () => {
  console.log(`Server is running on port ${PORT}`);
});
JavaScript
In dieser Konfiguration wird IronPDF zur Generierung von PDFs verwendet, während die Funktionalitäten des Node.js Body Parsers kombiniert werden. Zu Beginn importieren wir die erforderlichen Module, wie IronPDF für die PDF-Erzeugung, Body Parser für das Parsen eingehender Anfragen und Express für die Serverkonstruktion. Als Nächstes richten wir eine Express-Middleware ein, um JSON- und URL-kodierte Formulardaten mit Body Parser zu parsen.
Für die Bearbeitung von POST-Anfragen richten wir eine Route namens generate-pdf ein, über die wir den Inhalt der Anfrage erhalten. Diese JSON-formatierten Daten werden in eine HTML-Vorlage integriert, die als Inhalt der PDF-Datei verwendet wird. Wir instanziieren ein Dokument mit IronPdf und verwandeln den HTML-Inhalt in ein PDF-Dokument.
Nachdem die PDF-Datei erfolgreich generiert wurde, senden wir die Antwort mit entsprechenden Kopfzeilen, um den Dateinamen und den Inhaltstyp anzugeben. Die Fehlerbehandlung stellt sicher, dass alle Probleme, die bei der Erstellung von PDFs auftreten, identifiziert, aufgezeichnet und dem Kunden mit entsprechenden Statuscodes mitgeteilt werden.
Ausgabe
Schließlich wird der Server gestartet und wartet auf einem bestimmten Port auf eingehende Anfragen. Mit dieser Konfiguration können die Anfragebearbeitung mit Body Parser und die dynamische PDF-Erzeugung mit IronPDF leicht in eine Node.js-Anwendung integriert werden, was effektivere Arbeitsabläufe bei der Datenverarbeitung und Dokumentenerzeugung ermöglicht.
Abschluss
Zusammenfassend lässt sich sagen, dass die Kombination von IronPDF und Body Parser in Node.js einen stabilen Weg zur Verwaltung von HTTP-Request-Body-Daten und zur Erstellung dynamischer PDF-Dokumente zur Verwendung in Online-Anwendungen bietet. Entwickler können mit Body Parser leichter auf eingehende Daten zugreifen und diese ändern, indem sie den Prozess des Parsens verschiedener Arten von Anfragebodies rationalisieren.
IronPDF hingegen verfügt über robuste Funktionen zur Erstellung hochwertiger PDF-Dokumente mit erweiterten Funktionen, Formatierungen und Styling aus HTML-Text. Durch die Kombination dieser Technologien können Entwickler benutzerdefinierte PDF-Dokumente auf der Grundlage von Anwendungsdaten oder Benutzereingaben schneller erstellen. Mit Hilfe dieser Integration können Node.js-Apps jetzt nutzergenerierte Inhalte effektiver verarbeiten und PDFs ausgeben, die professionell aussehen.
Durch die Integration von IronPDF- und Iron Software-Produkten in Ihre Entwicklungsumgebung können wir funktionsreiche, hochwertige Softwarelösungen für Kunden und Endbenutzer garantieren. Darüber hinaus wird dies bei der Projekt- und Prozessoptimierung helfen. Iron Software-Preise beginnen bei $999, und sie sind verlässliche Partner für moderne Softwareentwicklungsprojekte aufgrund ihrer umfangreichen Dokumentation, lebendigen Community und häufigen Aktualisierungen.
Curtis Chau hat einen Bachelor-Abschluss in Informatik von der Carleton University und ist spezialisiert auf Frontend-Entwicklung mit Expertise in Node.js, TypeScript, JavaScript und React. Leidenschaftlich widmet er sich der Erstellung intuitiver und ästhetisch ansprechender Benutzerschnittstellen und arbeitet gerne mit modernen Frameworks sowie der Erstellung gut strukturierter, optisch ansprechender Handbücher.