



Aktualisiert 21. April 2026
Wie man PDF zu PNG in Python konvertiert
In diesem Artikel werden wir IronPDF for Python verwenden, um PDF in PNG-Bilddateien zu teilen.
Weiterlesen

Effektivität und Effizienz sind in den Bereichen Online-Scraping und Dokumentenerstellung von entscheidender Bedeutung. Für die Extraktion von Daten von Webseiten und deren anschließende Umwandlung in professionelle Dokumente ist eine reibungslose Integration leistungsstarker Tools und Frameworks erforderlich.
Hier kommen Scrapy, ein Web-Scraping-Framework in Python, und IronPDF ins Spiel, zwei beeindruckende Bibliotheken, die zusammenarbeiten, um die Extraktion von Online-Daten und die Erstellung dynamischer PDFs zu optimieren.
Dank Scrapy in Python, einer führenden Bibliothek zum Web-Crawling und -Scraping, können Entwickler jetzt mühelos das komplexe Web durchsuchen und strukturierte Daten schnell, präzise und zügig extrahieren. Dank seiner robusten XPath- und CSS-Selektoren sowie seiner asynchronen Architektur ist es die ideale Option für Web-Scraping-Aufträge jeder Komplexität.
IronPDF hingegen ist eine leistungsstarke .NET-Bibliothek, die die programmatische Erstellung, Bearbeitung und Manipulation von PDF-Dokumenten unterstützt. IronPDF bietet Entwicklern eine Komplettlösung für die Erstellung dynamischer und ästhetisch ansprechender PDF-Dokumente mit seinen leistungsstarken PDF-Erstellungswerkzeugen, zu denen auch die Konvertierung von HTML in PDF und die Bearbeitung von PDFs gehören.
Dieser Beitrag führt Sie durch die nahtlose Integration von Scrapy Python mit IronPDF und zeigt Ihnen, wie dieses dynamische Paar die Art und Weise, wie Web-Scraping und Dokumentenerstellung durchgeführt werden, verändert. Wir zeigen, wie diese beiden Bibliotheken zusammenarbeiten, um komplexe Aufgaben zu vereinfachen und Entwicklungsabläufe zu beschleunigen – vom Scraping von Daten aus dem Web mit Scrapy bis hin zur dynamischen Generierung von PDF-Berichten mit IronPDF.
Entdecken Sie die Möglichkeiten des Web-Scraping und der Dokumentengenerierung, während wir IronPDF nutzen, um Scrapy voll auszuschöpfen.

Die von Scrapy verwendete asynchrone Architektur ermöglicht die gleichzeitige Verarbeitung mehrerer Anfragen. Dies führt zu einer höheren Effizienz und schnelleren Web-Scraping-Geschwindigkeiten, insbesondere bei der Arbeit mit komplexen Websites oder großen Datenmengen.
Scrapy verfügt über leistungsstarke Funktionen zur Verwaltung des Scrapy-Crawling-Prozesses, wie z. B. automatisierte URL-Filterung, konfigurierbare Anforderungsplanung und integrierte robots.txt-Direktivenbehandlung. Das Crawling-Verhalten kann von Entwicklern an ihre eigenen Bedürfnisse angepasst werden, um die Einhaltung der Website-Richtlinien zu gewährleisten.
Scrapy ermöglicht es Benutzern, mithilfe von Selektoren für XPath und CSS-Selektoren innerhalb von HTML-Seiten zu navigieren und Elemente auszuwählen. Durch diese Anpassungsfähigkeit wird die Datenextraktion präziser und zuverlässiger, da Entwickler so gezielt bestimmte Elemente oder Muster auf einer Webseite ansprechen können.
Entwickler können wiederverwendbare Komponenten zur Verarbeitung der gesammelten Daten vor dem Export oder der Speicherung mithilfe der Scrapy-Item-Pipeline definieren. Durch Operationen wie Bereinigung, Validierung, Transformation und Deduplizierung gewährleisten sie die Genauigkeit und Konsistenz der extrahierten Daten.
Eine Reihe von Middleware-Komponenten, die in Scrapy vorinstalliert sind, bieten Funktionen wie die automatische Cookie-Verwaltung, die Drosselung von Anfragen, die Rotation des User-Agents und die Rotation des Proxys. Diese Middleware-Elemente sind einfach konfigurierbar und anpassbar, um die Effizienz des Web-Scrapings zu verbessern und typische Probleme zu beheben.
Durch die Erstellung von benutzerdefinierter Middleware, Erweiterungen und Pipelines können Entwickler die Funktionen von Scrapy dank seiner modularen und erweiterbaren Architektur weiter personalisieren und ausbauen. Aufgrund seiner Anpassungsfähigkeit können Entwickler Scrapy problemlos in ihre bestehenden Prozesse integrieren und es an ihre individuellen Scraping-Anforderungen anpassen.
Installieren Sie Scrapy mit pip , indem Sie folgenden Befehl ausführen:
pip install scrapyUm Ihre Spider zu definieren, erstellen Sie eine neue Python-Datei (wie z. B. example.py) im spiders/-Verzeichnis. Hier wird eine Illustration eines einfachen Spiders bereitgestellt, der Daten von einer URL extrahiert:
import scrapy

class QuotesSpider(scrapy.Spider):
    # Name of the spider
    name = 'quotes'
    # Starting URL
    start_urls = ['http://quotes.toscrape.com']

    def parse(self, response):
        # Iterate through each quote block in the response
        for quote in response.css('div.quote'):
            # Extract and yield quote details
            yield {
                'text': quote.css('span.text::text').get(),
                'author': quote.css('span small.author::text').get(),
                'tags': quote.css('div.tags a.tag::text').getall(),
            }
        # Identify and follow the next page link
        next_page = response.css('li.next a::attr(href)').get()
        if next_page is not None:
yield response.follow(next_page, self.parse)Um die Scrapy-Projektparameter wie Benutzer-Agent, Download-Verzögerungen und Pipelines einzurichten, bearbeiten Sie die settings.py-Datei. Dies ist eine Darstellung, wie der Benutzer-Agent geändert und die Pipelines funktionsfähig gemacht werden können:
# Obey robots.txt rules
ROBOTSTXT_OBEY = True
# Set user-agent
USER_AGENT = 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.3'
# Configure pipelines
ITEM_PIPELINES = {
    'myproject.pipelines.MyPipeline': 300,
}Der Einstieg in Scrapy und IronPDF erfordert die Kombination der robusten Web-Scraping-Fähigkeiten von Scrapy mit den dynamischen PDF-Erstellungsfunktionen von IronPDF. Im Folgenden zeige ich Ihnen die einzelnen Schritte zum Einrichten eines Scrapy-Projekts, damit Sie Daten von Webseiten extrahieren und mit IronPDF ein PDF-Dokument erstellen können, das die Daten enthält.
IronPDF ist eine leistungsstarke .NET-Bibliothek zum programmgesteuerten Erstellen, Bearbeiten und Verändern von PDF-Dokumenten in C#, VB.NET und anderen .NET-Sprachen. Da es Entwicklern eine breite Funktionspalette zum dynamischen Erstellen von hochwertigen PDFs bietet, ist es eine beliebte Wahl für viele Programme.
PDF-Erstellung: Mit IronPDF können Programmierer neue PDF-Dokumente erstellen oder bestehende HTML-Elemente wie Tags, Text, Bilder und andere Dateiformate in PDFs konvertieren. Diese Funktion ist sehr nützlich für die dynamische Erstellung von Berichten, Rechnungen, Quittungen und anderen Dokumenten.
HTML-zu-PDF-Konvertierung: IronPDF macht es Entwicklern leicht, HTML-Dokumente, einschließlich Stile aus JavaScript und CSS, in PDF-Dateien umzuwandeln. Dies ermöglicht die Erstellung von PDFs aus Webseiten, dynamisch generierten Inhalten und HTML-Vorlagen.
Änderung und Bearbeitung von PDF-Dokumenten: IronPDF bietet einen umfassenden Funktionsumfang zum Ändern und Bearbeiten bereits vorhandener PDF-Dokumente. Entwickler können mehrere PDF-Dateien zusammenführen, sie in separate Dokumente aufteilen, Seiten entfernen und unter anderem Lesezeichen, Anmerkungen und Wasserzeichen hinzufügen, um PDFs an ihre Bedürfnisse anzupassen.
Nachdem Sie sichergestellt haben, dass Python auf Ihrem Computer installiert ist, verwenden Sie pip, um IronPDF zu installieren.
Um Ihre Spider zu definieren, erstellen Sie eine neue Python-Datei (wie z. B. example.py) im Spider-Verzeichnis Ihres Scrapy-Projekts (myproject/myproject/spiders). Ein Codebeispiel eines einfachen Spiders, der Anführungszeichen aus einer URL extrahiert:
import scrapy
from IronPdf import *

class QuotesSpider(scrapy.Spider):
    name = 'quotes'
    # Web page link
    start_urls = ['http://quotes.toscrape.com']

    def parse(self, response):
        quotes = []
        for quote in response.css('div.quote'):
            title = quote.css('span.text::text').get()
            content = quote.css('span small.author::text').get()
            quotes.append((title, content))  # Append quote to list

        # Generate PDF document using IronPDF
        renderer = ChromePdfRenderer()
        pdf = renderer.RenderHtmlAsPdf(self.get_pdf_content(quotes))
        pdf.SaveAs("quotes.pdf")

    def get_pdf_content(self, quotes):
        # Generate HTML content for PDF using extracted quotes
        html_content = "<html><head><title>Quotes</title></head><body>"
        for title, content in quotes:
            html_content += f"<h2>{title}</h2><p>Author: {content}</p>"
        html_content += "</body></html>"
return html_contentIm obigen Codebeispiel eines Scrapy-Projekts mit IronPDF wird IronPDF verwendet, um aus den mit Scrapy extrahierten Daten ein PDF-Dokument zu erstellen.
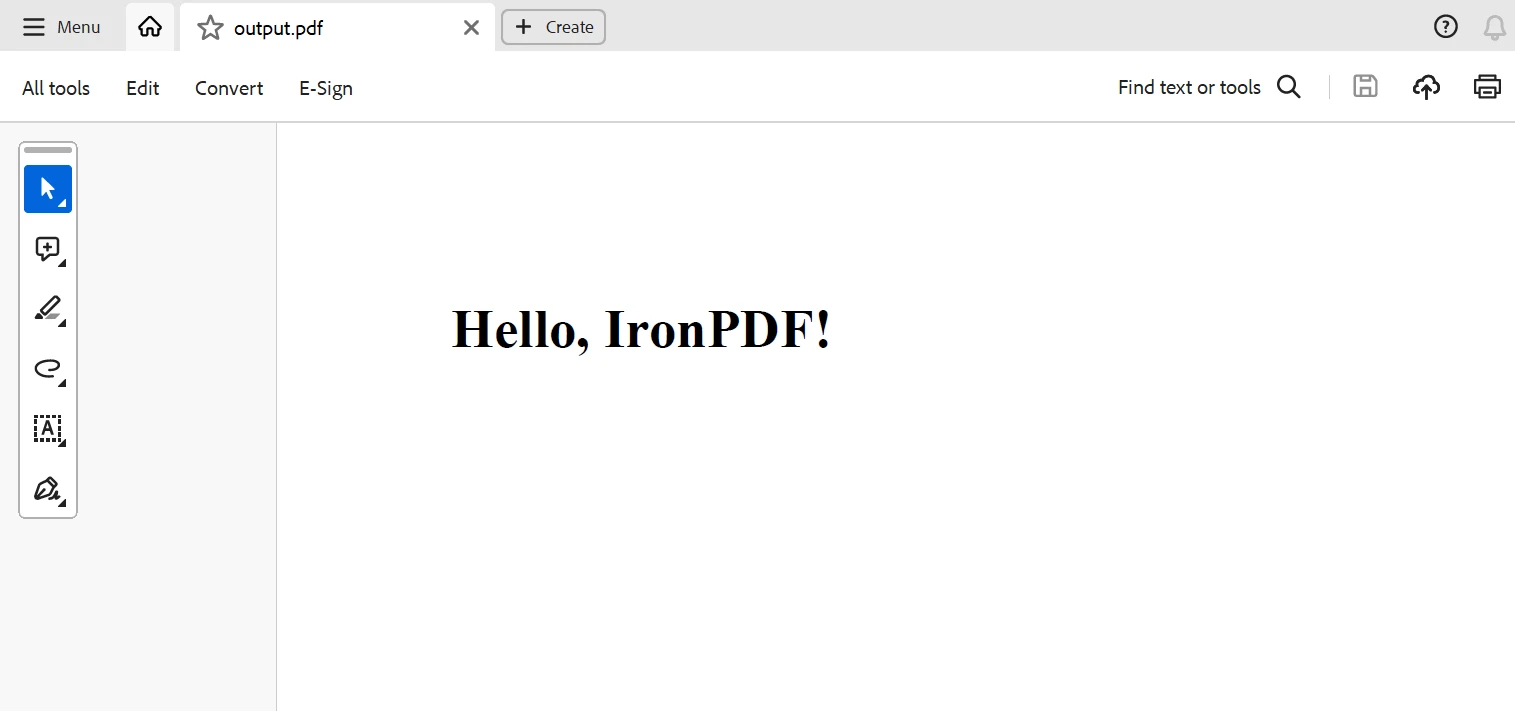
Hier sammelt die parse-Methode der Spider Zitate von der Webseite und verwendet die get_pdf_content-Funktion, um den HTML-Inhalt für die PDF-Datei zu erstellen. Dieses HTML-Material wird anschließend als PDF-Dokument mit IronPDF gerendert und als quotes.pdf gespeichert.
Zusammenfassend bietet die Kombination aus Scrapy und IronPDF Entwicklern eine leistungsstarke Möglichkeit, Web-Scraping-Aktivitäten zu automatisieren und PDF-Dokumente im Handumdrehen zu erstellen. Die flexiblen PDF-Produktionsfunktionen von IronPDF in Kombination mit den leistungsstarken Web-Crawling- und Scraping-Funktionen von Scrapy ermöglichen einen reibungslosen Prozess zum Sammeln strukturierter Daten von beliebigen Webseiten und zum Umwandeln der extrahierten Daten in professionelle PDF-Berichte, Rechnungen oder Dokumente.
Durch die Nutzung von Scrapy Spider Python können Entwickler die Komplexität des Internets effektiv bewältigen, Informationen aus vielen Quellen abrufen und diese systematisch ordnen. Scrapys flexibles Framework, die asynchrone Architektur und die Unterstützung für XPath- und CSS-Selektoren bieten die Flexibilität und Skalierbarkeit, die für die Bewältigung einer Vielzahl von Web-Scraping-Aktivitäten erforderlich sind.
IronPDF umfasst eine lebenslange Lizenz, die im Bundle recht günstig ist. Das Paket bietet einen ausgezeichneten Wert, da es nur $999 kostet (einmaliger Kauf für mehrere Systeme). Lizenzinhaber haben 24/7 Zugang zu technischem Online-Support. Weitere Einzelheiten zur Gebühr finden Sie auf der Website . Besuchen Sie diese Seite, um mehr über die Produkte von Iron Software zu erfahren.

Curtis Chau hat einen Bachelor-Abschluss in Informatik von der Carleton University und ist spezialisiert auf Frontend-Entwicklung mit Expertise in Node.js, TypeScript, JavaScript und React. Leidenschaftlich widmet er sich der Erstellung intuitiver und ästhetisch ansprechender Benutzerschnittstellen und arbeitet gerne mit modernen Frameworks sowie der Erstellung gut strukturierter, optisch ansprechender Handbücher.


IronPDF ist ein Teil der IRONSUITE
10 .NET-API-Produkte für Ihre Bürodokumente


Wenn Ihr PDF wie HTML aussehen soll, schnell.

