



更新日 2026年4月21日
Scrapy in Python(開発者向けのしくみ)
ここにScrapy、PythonにおけるWebスクレイピングフレームワークとIronPDFが登場し、オンラインデータの抽出と動的PDFの作成を最適化するための2つの強力なライブラリが協力しています。
詳しく読む

この記事では、最も強力な PDF ライブラリの 1 つである IronPDF for Python を使用して、PDF ドキュメント内の任意のテキストを抽出する方法を説明します。
ExtractAllTextメソッドを使用して、開いたファイルからテキストを読み取ります。IronPDF ライブラリは他の言語に比べてはるかに動的な言語であり、開発者がグラフィカル ユーザー インターフェイスを迅速かつ簡単に作成できるため、Python に統合するのは簡単です。 PyQT、wxWidgets、kivy、および多数の追加パッケージとライブラリを含む多数のプリインストールされたツールがあり、それらすべてを使用して、完全に完成した GUI を迅速かつ安全に作成できます。
IronPDF for Python は非常に効率的なライブラリであり、特に Web 開発に役立ちます。 Django、Flask、Pyramid など、多数の Python Web 開発パラダイムが利用可能であることが、この一因となっています。 これらのフレームワークは、Reddit、Mozilla、Spotify など、多数の Web サイトやオンライン サービスで使用されています。
IronPDF をインポートするには、IronPDF が使用されるソース ファイルの先頭に次のインポート ステートメントを含めます。
from ironpdf import *IronPDF for Python は無料で使用できますが、無料ユーザーの場合、PDF ファイルにタイル状の背景に透かしが入ります。 IronPDF を使用して透かしのない PDF を作成するには、ライブラリに正規のライセンス キーを付与する必要があります。 ライセンス キーを使用してライブラリを設定する方法は、次のコード スニペットに示されています。
# Set the license key for IronPDF
License.LicenseKey = "IRONPDF-LICENSE-KEY-ABCDEFGH"PDF ファイルを作成したり、そのコンテンツを変更したりする前に、ライセンス キーが設定されていることを確認してください。 他のコード行の前にLicenseKeyメソッドを呼び出す必要があります。 無料試用ライセンス キーを取得するには、ライセンス ページにアクセスしてください。
"Default"というテキスト ファイルには、Python スクリプトのディレクトリ内の Custom.log によって生成されたログ メッセージを保存できます。 以下のコードスニペットを使用して、LogFilePathプロパティを設定し、ログファイルの名前と場所をカスタマイズできます。
# Enable debugging and set the log file path and mode
Logger.EnableDebugging = True
Logger.LogFilePath = "Custom.log"
Logger.LoggingMode = Logger.LoggingModes.AllIronPDF for Python ライブラリは、PDF ページを PDF オブジェクトに変換し、スキャンされた PDF ファイルを含む PDF ファイルからテキストを抽出できるようにします。 以下は、IronPDF を使用して既存の PDF を読み取る方法を示す例です。
最初の方法では、PDF 内のすべてのテキストを抽出します。 コードのサンプルを以下に示します。
from ironpdf import *

# Load existing PDF document
pdf = PdfDocument.FromFile("content.pdf")

# Extract all the text from the entire PDF document
all_text = pdf.ExtractAllText()

# Display the extracted text
print(all_text)上記のコードで示されているように、FromFileメソッドは既存のPDFファイルを読み込み、それをPDF文書オブジェクトに変換するPDFリーダーオブジェクトです。 このオブジェクトは、PDF ページにあるテキストと画像を読み取るために使用できます。 オブジェクトはExtractAllTextというメソッドを提供しており、PDFファイル全体からすべてのテキストを取得し、文字列として保持して処理することができます。 その後、print関数を使用してテキストを表示します。
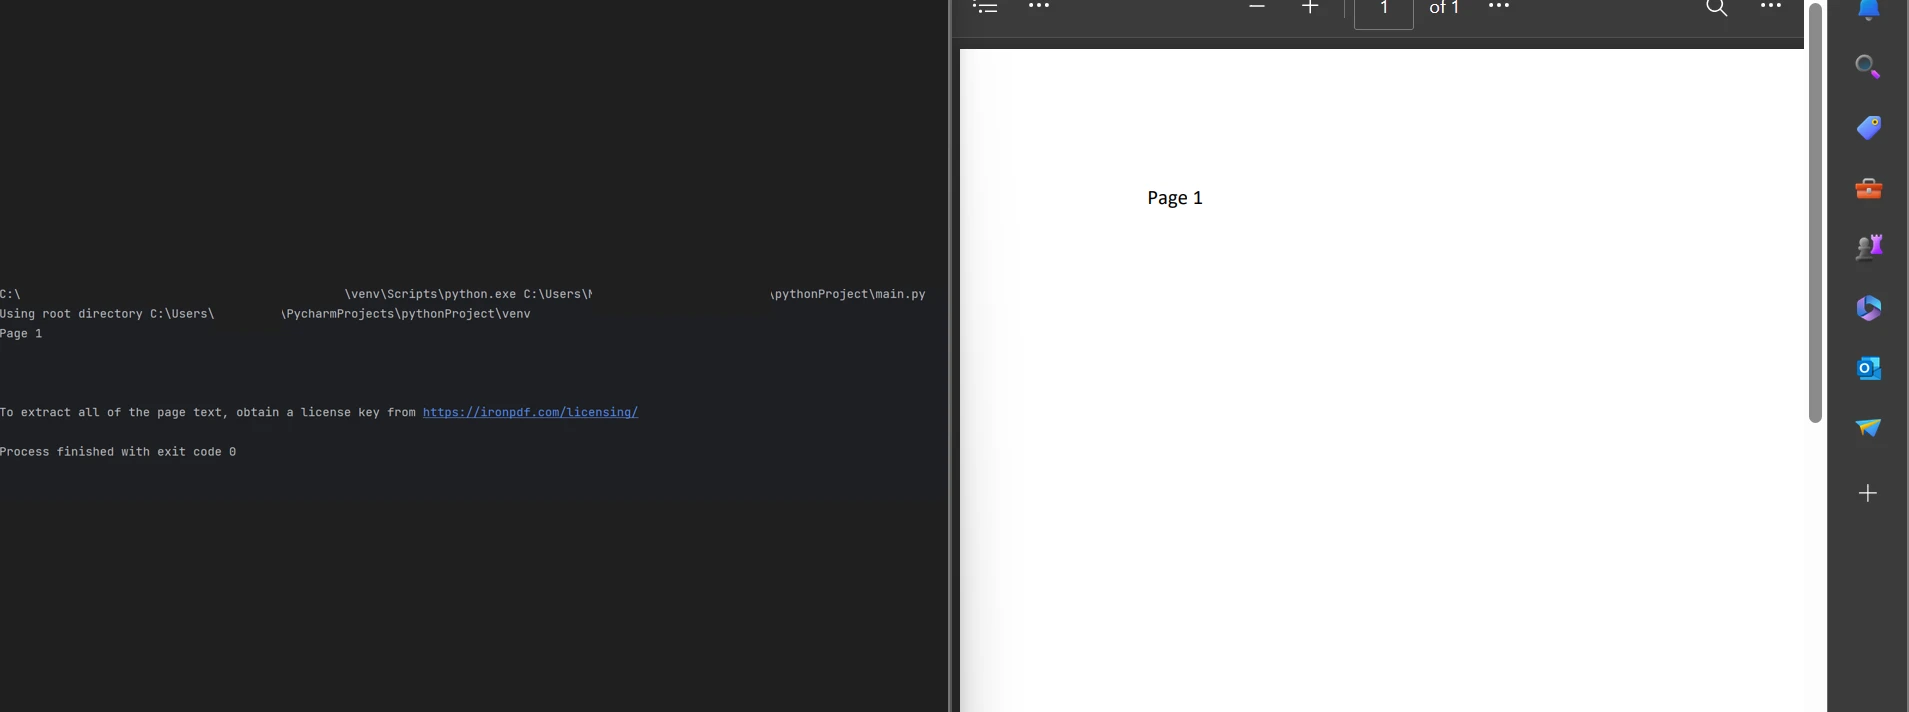 テキストを表示する
PDFファイルからページごとにテキストを抽出する2番目の方法のコード例を以下に示します。
from ironpdf import *

# Load existing PDF document
pdf = PdfDocument.FromFile("content.pdf")

# Extract text from a specific page in the document
page_text = pdf.ExtractTextFromPage(1)

# Display the extracted text from the specified page
print(page_text)FromFileメソッドは、既存のファイルからPDFファイルを読み込み、PDFファイルオブジェクトに変換するために使用されます。上記のコードで示されています。 PDFページオブジェクトのメソッドExtractTextFromPageは、PDFファイル内のページからすべてのテキストを取得します。特定のページからテキストを抽出するにはページ番号をパラメータとして提供する必要があります。 そして、テキストを抽出した後、処理できる情報を保持するためにpage_textを使用することができます。
PDF からテキストを抽出するためのその他の例を確認してください。
対照的に、IronPDFライブラリは潜在的なリスクを軽減するために強力なセキュリティ対策を提供します。 特定のブラウザ向けにカスタマイズされておらず、一般的に使用されているすべてのブラウザで動作します。 IronPDF を使用すると、プログラマーはわずか数行のコードで簡単に PDF ファイルを作成および読み取ることができます。 IronPDF ライブラリは、さまざまな開発者のニーズを満たすために、無料の開発者ライセンスや購入可能な追加の開発ライセンスなど、さまざまなライセンス オプションを提供します。
IronPDF には、永久ライセンス、30 日間の返金保証、1 年間のソフトウェア サポート、アップグレード オプションが含まれています。 初回購入後、追加費用は発生しません。 これらのライセンスは、開発、ステージング、プロダクション環境で使用することができます。 製品ライセンスの詳細については、こちらをご覧ください。
ソフトウェア製品をダウンロードします。

Curtis Chauは、カールトン大学でコンピュータサイエンスの学士号を取得し、Node.js、TypeScript、JavaScript、およびReactに精通したフロントエンド開発を専門としています。直感的で美しいユーザーインターフェースを作成することに情熱を持ち、Curtisは現代のフレームワークを用いた開発や、構造の良い視覚的に魅力的なマニュアルの作成を楽しんでいます。



IronPDF はIRONSUITEの一部です
オフィス文書向けの.NET API製品10個

PDFがHTMLのように見える必要があるとき、迅速に。



