



已更新 2026年4月21日
Python 中的 Scrapy (開發人員的工作原理)
在這裡出現 Scrapy,一個 Python 網路抓取框架,和 IronPDF,兩個強大的庫一起工作以優化線上資料提取和動態 PDF 的建立。
閱讀更多

在數位轉型的時代,PDF文件在分享和保存資訊方面的不可或缺性已不言而喻。
然而,掃描的PDF通常包含影像而不是可搜尋的文字,這在提取有價值的資料時帶來了重大挑戰。
這就是Python作為一個多功能且強大的解決方案脫穎而出的原因,並建立了自身作為自動化多樣化任務的首選程式語言,其中包含從掃描文件中提取資訊這個典型例子。
Python的靈活性和強大的功能讓使用者能夠有效地應對掃描內容的複雜性,提供一種流線型的方法來存取和利用基於影像的PDF中的資料。
Python是使用最廣泛的程式語言之一,擁有其先進的功能。 存取[Python維基百科頁面](https://en.wikipedia.org/wiki/Python_(programming_language),了解Python程式語言及其結構格式。
在本文中,我們將討論如何使用IronPDF的Python程式庫來閱讀掃描的PDF。
PdfDocument.FromFile方法載入掃描的PDF檔案。ExtractAllText方法從掃描的PDF中提取所有文字。print()方法列印PDF檔案中的所有文字。IronPDF for Python 是由Iron Software開發的一個強大的程式庫,能夠將PDF生成和操作的功能無縫整合到Python應用程式中。
這個多用途的工具使開發人員能夠輕鬆建立、修改和互動式地處理PDF文件,支援動態報告生成、HTML轉PDF及從現有PDF文件中提取內容等任務。
使用者友好的API,全面的文件和多種功能,IronPDF簡化了將高級PDF功能整合到Python專案中的過程,對於希望提升其應用程式的開發者來說,是一個非常寶貴的資源。
IronPDF for Python具有多種功能,使其成為強大的PDF生成和文字文件結構操作工具。
它的一些主要功能包括:
在開始程式教學之前,讓我們先看看如何安裝IronPDF for Python。
首先,確保系統中安裝了Python,並且您有一個好的Python IDE,例如PyCharm。 同樣,應該安裝PIP以安裝IronPDF for Python。
首先,建立一個新的Python專案或打開現有的專案。
打開控制台,運行以下命令並按下回車鍵。
就這樣,IronPDF for Python被整合到了您的Python專案中。
在本節中,我們將看到如何使用IronPDF從掃描的PDF文件中提取文字。
from ironpdf import *  # Import everything from ironpdf

# Set the license key for IronPDF
License.LicenseKey = "Your License Key"

# Load the scanned PDF document
pdf = PdfDocument.FromFile("C:/Users/buttw/INV_2023_00008.pdf")

# Extract all text from the PDF document
all_text = pdf.ExtractAllText()

# Print the extracted text
print(all_text)上述程式碼範例從掃描的PDF文件中提取文字。 以下是上述程式碼的分解說明:
匯入IronPDF模組:
from ironpdf import *此行匯入了IronPDF程式庫中所需的模組和類別。 星號(*)表示應匯入模組中的所有類別和功能。
設置授權金鑰:
License.LicenseKey = "Your License Key"此行設置了IronPDF的授權金鑰。 您需要將"Your License Key"替換成您從Iron Software獲得的實際授權金鑰。
授權金鑰是使用IronPDF所必需的,通常在您購買產品時提供。
載入掃描的PDF文件:
pdf = PdfDocument.FromFile("C:/Users/buttw/INV_2023_00008.pdf")此行載入位於指定文件路徑("C:/Users/buttw/INV_2023_00008.pdf")的掃描的PDF文件。 使用PdfDocument物件。
從PDF文件中提取文字:
all_text = pdf.ExtractAllText()此行使用ExtractAllText方法從已載入的PDF文件的所有頁面中提取所有文字內容。 提取的文字然後儲存在all_text變數中。
列印提取的文字:
print(all_text)最後,此行將提取的文字列印到控制台。 all_text變數包含了掃描的PDF文件的文字內容。
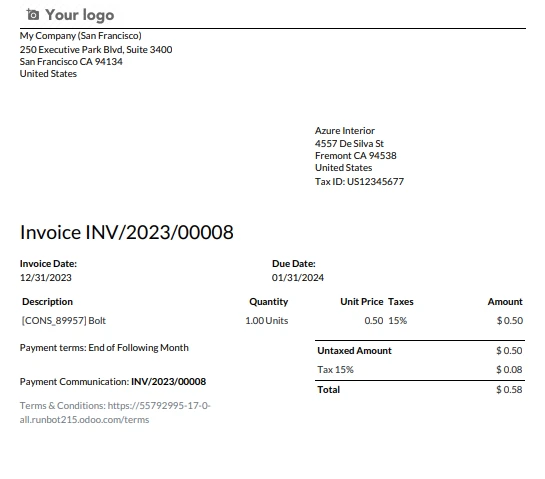
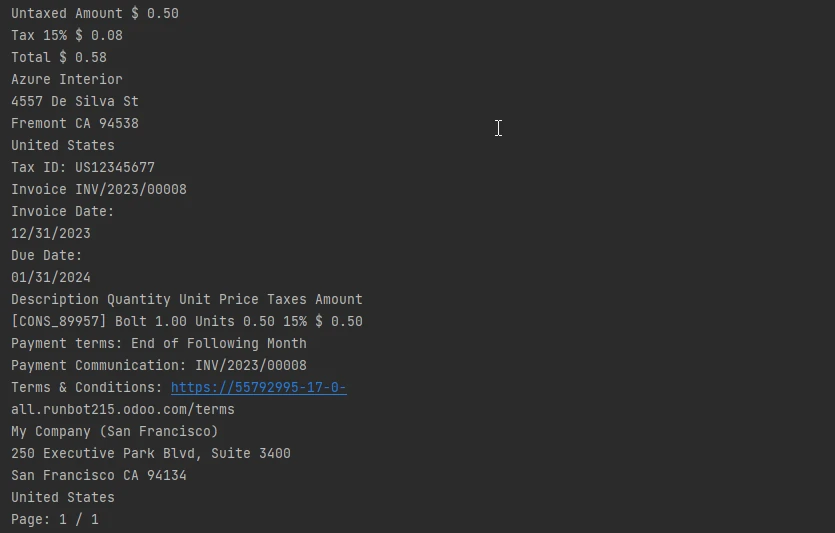
在數位文件處理領域,Python程式語言作為一個多功能解決方案,為克服由圖片而非可搜尋文字組成的掃描PDF所帶來的挑戰提供了幫助。
Python的靈活性與IronPDF for Python的強大功能的協同作用,為開發者提供了一個吸引人的途徑,能夠在其專案中無縫整合PDF生成、操作和提取功能。
IronPDF由Iron Software開發,在這方面表現出色,提供了如從各類文件型別轉換為PDF文件、HTML到PDF頁面轉換、文字和影像操作以及基於OCR的掃描PDF文字提取的功能。
展示的程式碼範例展示了如何簡單實現IronPDF從掃描的PDF頁面中讀取文字,展示了有效資料提取的潛力並提升Python應用程式中的文件處理能力。
隨著對複雜PDF處理的需求不斷增加,IronPDF for Python作為一個有價值的工具,使開發人員能夠輕鬆應對掃描內容的複雜性。
IronPDF for Python提供了試用授權,這是一個很好的機會讓開發者了解IronPDF的功能。
關於從掃描PDF中提取文字的完整教程可以在這裡找到。

Curtis Chau擁有Carleton大學的電腦科學學士學位,專精於前端開發,擁有Node.js、TypeScript、JavaScript和React的專業知識。Curtis熱衷於建立直觀且美觀的使用者介面,喜愛使用現代框架並建立結構良好、視覺吸引力的手冊。


IronPDF 是 IRONSUITE 的一部分
10 款適用於辦公室文件的 .NET API 產品

當您需要您的PDF看起來像HTML一樣快速。



