



已更新 2026年4月21日
如何在 Java 中将 TIFF 转换为 PDF
本完整指南将引导您在 Java 中使用 IronPDF 无缝地将 TIFF 图像转换为 PDF。
阅读更多

本文将探讨如何使用Java编程语言从现有的PDF文档中提取图像并将它们保存在一个文件夹中。 为此,使用IronPDF for Java库来提取图像。
extractAllImages 方法提取图像IronPDF是一个Java库,旨在帮助开发人员生成、修改和从Java应用程序中的PDF文件中提取数据。 借助IronPDF,您可以从HTML、图像等多种来源创建PDF文档。 此外,您还可以合并、拆分和操作现有的PDF。 IronPDF还包括安全功能,例如密码保护和数字签名。
由Iron Software开发和维护,IronPDF以其从PDF、HTML和URLs中提取文本的能力而闻名。 这使得它成为一个多用途且强大的工具,适用于多种应用,无论您是从头创建PDF还是处理现有的PDF。
在使用IronPDF从PDF文件中提取数据之前,需要满足一些先决条件:
安装IronPDF for Java是一个简单的过程,只要满足所有要求即可。 本指南将使用JetBrains IntelliJ IDEA来演示安装并运行一些示例代码。
**启动IntelliJ IDEA:**在您的系统上打开JetBrains IntelliJ IDEA。
**创建一个Maven项目:**在IntelliJ IDEA中,创建一个新的Maven项目。 这将为安装IronPDF for Java提供合适的环境。
 创建一个新的Maven项目
将出现一个新窗口。 输入项目名称并单击 "完成"。
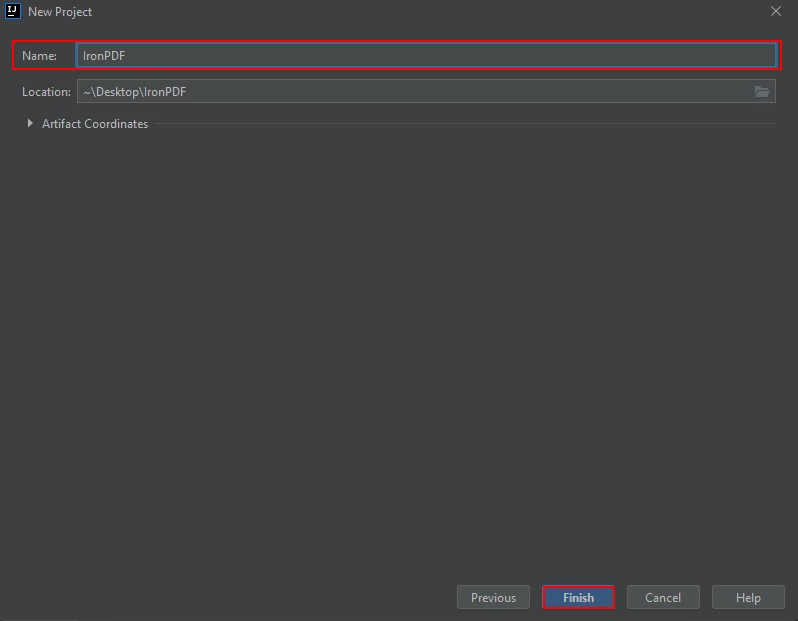 输入项目名称
点击完成后,会打开一个新项目,并转到pom.xml文件,以添加IronPDF for Java的Maven依赖项。
接下来,在pom.xml文件中添加以下依赖项,或者您可以从以下Maven库下载JAR文件。
<dependency>
    <groupId>com.ironsoftware</groupId>
    <artifactId>ironpdf</artifactId>
    <version>YOUR_VERSION_HERE</version>
</dependency>在pom.xml文件中放置依赖项之后,文件右上角会出现一个小图标。
 具有安装依赖项的小图标的pom.xml文件
点击此图标安装 IronPDF for Java 的 Maven 依赖项。 根据您的网络连接情况,这只需要几分钟时间。
您可以使用IronPDF通过一个名为extractAllImages的方法从PDF文档中提取图像。 此方法返回PDF文件中所有可用的图像。之后,您可以使用ImageIO.write方法通过提供输出图像的路径和格式将所有提取的图像保存到您选择的文件路径。
在下面的示例中,将从PDF文档中提取图像并保存到文件系统中作为PNG图像。
import com.ironsoftware.ironpdf.PdfDocument;
import javax.imageio.ImageIO;
import java.awt.image.BufferedImage;
import java.nio.file.Files;
import java.nio.file.Paths;
import java.util.List;

public class Main {
    public static void main(String[] args) throws Exception {
        // Load PDF document from file
        PdfDocument pdf = PdfDocument.fromFile(Paths.get("Final Project Report Craft Arena.pdf"));

        // Extract all images from the PDF document
        List<BufferedImage> images = pdf.extractAllImages();
        int i = 0;

        // Save each extracted image to the filesystem as a PNG
        for (BufferedImage image : images) {
            ImageIO.write(image, "PNG", Files.newOutputStream(Paths.get("image" + ++i + ".png")));
        }
    }
}以上程序打开"Final Project Report Craft Arena.pdf"文件,并使用BufferedImage对象列表中。 然后将每个新文件图像保存为具有唯一名称的单独PNG文件。
 PDF输出中的图像提取
本节将讨论如何直接从URL提取图像。 在下面的代码中,URL被转换为PDF页面,然后切换导航以从PDF中提取图像。
import com.ironsoftware.ironpdf.PdfDocument;
import javax.imageio.ImageIO;
import java.awt.image.BufferedImage;
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.Paths;
import java.util.List;

public class Main {
    public static void main(String[] args) throws IOException {
        // Render PDF from a URL
        PdfDocument pdf = PdfDocument.renderUrlAsPdf("https://www.amazon.com/?tag=hp2-brobookmark-us-20");

        // Extract all images from the rendered PDF document
        List<BufferedImage> images = pdf.extractAllImages();
        int i = 0;

        // Save each extracted image to the filesystem as a PNG
        for (BufferedImage image : images) {
            ImageIO.write(image, "PNG", Files.newOutputStream(Paths.get("image" + ++i + ".png")));
        }
    }
}在上述代码中,提供了亚马逊主页URL作为输入,并返回了74个图像。
 PDF输出中的图像提取
可以使用IronPDF库在Java中从PDF文档中提取图像。 要安装IronPDF,您需要在您的项目中安装并集成Java、Java IDE(Eclipse或IntelliJ)、Maven和IronPDF库。 使用IronPDF从PDF文档中提取图像的过程很简单,只需调用extractAllImages方法。 然后您可以使用ImageIO.write方法将图像保存到您选择的文件路径。
本文提供了一个分步指南,说明如何使用Java和IronPDF库从PDF文档中提取图像。 有关如何从PDF中提取文本的更多信息,请参见提取文本代码示例。

Curtis Chau 拥有卡尔顿大学的计算机科学学士学位,专注于前端开发,精通 Node.js、TypeScript、JavaScript 和 React。他热衷于打造直观且美观的用户界面,喜欢使用现代框架并创建结构良好、视觉吸引力强的手册。

当您需要PDF看起来像HTML时,速度快。





