



Aktualisiert 21. April 2026
Wie man TIFF in PDF in Java konvertiert
Dieser umfassende Leitfaden führt Sie durch die Schritte, wie Sie ein TIFF-Bild nahtlos in PDF in Java mit IronPDF konvertieren.
Weiterlesen

Dieser Artikel wird untersuchen, wie ein PDF-Reader erstellt wird, um eine PDF-Datei in Ihrer Softwareanwendung programmgesteuert zu öffnen. Um diese Aufgabe effektiv auszuführen, ist IronPDF for Java eine solche Systembibliothek, die hilft, PDF-Dateien mit dem Dateinamen in Java-Programmen zu öffnen und zu lesen.
fromFile, um vorhandene PDF-Dokumente zu ladenextractAllText zum Extrahieren von eingebettetem Text in PDFsextractTextFromPageDie IronPDF - Java-Bibliothek basiert auf dem bereits erfolgreichen .NET-Framework. Das macht IronPDF zu einem vielseitigen Werkzeug zur Arbeit mit PDF-Dokumenten im Vergleich zu anderen Klassenbibliotheken wie Apache PDFBox. Es bietet die Möglichkeit, Inhalte zu extrahieren und zu analysieren, Text zu laden und Bilder zu laden. Es bietet auch Optionen zur Anpassung der PDF-Seiten, wie z.B. Seitenlayout, Ränder, Kopf- und Fußzeile, Seitenausrichtung und vieles mehr.
Zusätzlich unterstützt IronPDF auch die Konvertierung von anderen Dateiformaten, das Schützen von PDFs mit einem Passwort, digitale Signaturen, das Zusammenführen und Aufteilen von PDF-Dokumenten.
Um IronPDF zu verwenden, um einen Java-PDF-Reader zu erstellen, ist es notwendig, sicherzustellen, dass die folgenden Komponenten auf dem Computer installiert sind:
pom.xml Datei ein, wie im folgenden Beispiel gezeigt:<!-- Add Maven dependencies for IronPDF -->
<dependencies>
<!-- IronPDF Dependency -->
<dependency>
<groupId>com.ironsoftware</groupId>
<artifactId>ironpdf</artifactId>
<version>your-version-here</version>
</dependency>
<!-- SLF4J Dependency necessary for logging -->
<dependency>
<groupId>org.slf4j</groupId>
<artifactId>slf4j-api</artifactId>
<version>1.7.32</version>
</dependency>
</dependencies>Zuerst fügen Sie den folgenden Code oben in die Java-Quelldatei ein, um alle benötigten Methoden von IronPDF zu referenzieren:
import com.ironsoftware.ironpdf.*;
// Necessary imports from IronPDF libraryKonfigurieren Sie IronPDF mit einem gültigen Lizenzschlüssel. Rufen Sie die setLicenseKey Methode in der Hauptmethode auf.
License.setLicenseKey("Your license key");
// Set your IronPDF license key - required for full versionHinweis: Sie können einen kostenlosen Testlizenzschlüssel erhalten, um PDFs zu erstellen, zu lesen und zu drucken.
Um PDF-Dateien zu lesen, müssen PDF-Dateien vorhanden sein, oder man kann eine erstellen. Dieser Artikel wird eine bereits erstellte PDF-Datei verwenden. Der Code ist einfach und ein zweistufiger Prozess, um Text aus dem Dokument zu extrahieren:
// Load the PDF document from file
PdfDocument pdf = PdfDocument.fromFile(Paths.get("assets/sample.pdf"));
// Extract all text from the PDF
String text = pdf.extractAllText();
// Print the extracted text
System.out.println(text);In the above code, fromFile opens a PDF document. Die Paths.get Methode erhält das Verzeichnis der Datei und ist bereit, den Inhalt aus der Datei zu extrahieren. Dann liest [extractAllText](/java/object-reference/api/com/ironsoftware/ironpdf/PdfDocument.html#extractAllText() den gesamten Text im Dokument.
Das Ergebnis ist unten:
 PDF-Textausgabe lesen
IronPDF kann auch Inhalte von einer bestimmten Seite in einem PDF lesen. Die extractTextFromPage Methode verwendet ein PageSelection Objekt, um einen Bereich von Seiten zu akzeptieren, aus dem der Text gelesen werden soll.
Im folgenden Beispiel wird der Text von der zweiten Seite des PDF-Dokuments extrahiert. PageSelection.singlePage nimmt den Index der Seite, die extrahiert werden muss (Index beginnt bei 0).
// Load the PDF document from file
PdfDocument pdf = PdfDocument.fromFile(Paths.get("assets/sample.pdf"));
// Extract text from the second page (page index based, starts at 0, so 1 means second page)
String text = pdf.extractTextFromPage(PageSelection.singlePage(1));
// Print the extracted text from the specified page
System.out.println(text);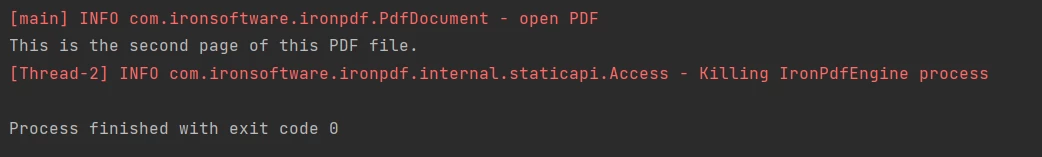 PDF-Textausgabe lesen
Andere in der PageSelection Klasse verfügbare Methoden, die zum Extrahieren von Text aus verschiedenen Seiten verwendet werden können, umfassen: firstPage, [lastPage](/java/object-reference/api/com/ironsoftware/ironpdf/edit/PageSelection.html#firstPage(), [pageRange](/java/object-reference/api/com/ironsoftware/ironpdf/edit/PageSelection.html#pageRange(int,int), und [allPages](/java/object-reference/api/com/ironsoftware/ironpdf/edit/PageSelection.html#allPages().
Suchtext kann auch aus einer neu generierten PDF-Datei aus einer HTML-Datei oder URL durchgeführt werden. Der folgende Beispielcode generiert PDFs aus URL und extrahiert den gesamten Text von der Website.
// Generate PDF from a URL
PdfDocument pdf = PdfDocument.renderUrlAsPdf("https://unsplash.com/");
// Extract all text from the generated PDF
String text = pdf.extractAllText();
// Print the extracted text from the URL
System.out.println("Text extracted from the website: " + text);
Lesen von einer neuen Datei
IronPDF kann auch verwendet werden, um Bilder aus PDF-Dateien zu extrahieren.
Der vollständige Code lautet wie folgt:
import com.ironsoftware.ironpdf.License;
import com.ironsoftware.ironpdf.PdfDocument;
import com.ironsoftware.ironpdf.edit.PageSelection;

import java.io.IOException;
import java.nio.file.Paths;

public class Main {
    public static void main(String[] args) throws IOException {
        // Set the IronPDF license key for commercial use
        License.setLicenseKey("YOUR LICENSE KEY HERE");

        // Read text from a specific page in an existing PDF
        PdfDocument pdf = PdfDocument.fromFile(Paths.get("assets/sample.pdf"));
        String text = pdf.extractTextFromPage(PageSelection.singlePage(1));
        System.out.println(text);

        // Read all text from a PDF generated from a URL
        pdf = PdfDocument.renderUrlAsPdf("https://unsplash.com/");
        text = pdf.extractAllText();
        System.out.println("Text extracted from the website: " + text);
    }
}Dieser Artikel erklärte, wie man PDFs in Java mit IronPDF öffnet und liest.
IronPDF hilft dabei, PDFs einfach aus HTML oder URL zu erstellen und aus verschiedenen Dateiformaten zu konvertieren. Es hilft auch dabei, PDF-Aufgaben schnell und einfach zu erledigen.
Probieren Sie IronPDF für 30 Tage mit einem kostenlosen Test aus und finden Sie heraus, wie gut es für Sie in der Produktion funktioniert. Erkunden Sie kommerzielle Lizenzierungsoptionen für IronPDF, die nur bei $999 anfangen.

Curtis Chau hat einen Bachelor-Abschluss in Informatik von der Carleton University und ist spezialisiert auf Frontend-Entwicklung mit Expertise in Node.js, TypeScript, JavaScript und React. Leidenschaftlich widmet er sich der Erstellung intuitiver und ästhetisch ansprechender Benutzerschnittstellen und arbeitet gerne mit modernen Frameworks sowie der Erstellung gut strukturierter, optisch ansprechender Handbücher.



IronPDF ist ein Teil der IRONSUITE
10 .NET-API-Produkte für Ihre Bürodokumente


Wenn Ihr PDF wie HTML aussehen soll, schnell.

