



已更新 2026年4月21日
如何在 Java 中将 TIFF 转换为 PDF
本完整指南将引导您在 Java 中使用 IronPDF 无缝地将 TIFF 图像转换为 PDF。
阅读更多

这篇文章将探讨如何创建一个PDF阅读器,以编程方式在您的软件应用程序中打开PDF文件。 要有效地执行此任务,IronPDF 适用于 Java 是一款有助于在Java程序中使用文件名打开和读取PDF文件的系统库。
fromFile 方法加载现有 PDF 文档extractAllText 方法提取 PDF 中的嵌入文本extractTextFromPage 方法从特定页面提取文本IronPDF - Java Library 构建在已成功的.NET Framework之上。 与Apache PDFBox等其他类库相比,这使得IronPDF成为处理PDF文档的多功能工具。 它提供了提取和解析内容、加载文本和加载图片的功能。 它还提供了自定义PDF页面的选项,比如页面布局、边距、页眉和页脚、页面方向,等等。
除此之外,IronPDF还支持从其他文件格式转换、使用密码保护PDF、数字签名、合并和拆分PDF文档。
要使用IronPDF制作Java PDF阅读器,必须确保计算机上安装了以下组件:
pom.xml文件中包括IronPDF工件以及slf4j依赖项,如下例所示:<!-- Add Maven dependencies for IronPDF -->
<dependencies>
<!-- IronPDF Dependency -->
<dependency>
<groupId>com.ironsoftware</groupId>
<artifactId>ironpdf</artifactId>
<version>your-version-here</version>
</dependency>
<!-- SLF4J Dependency necessary for logging -->
<dependency>
<groupId>org.slf4j</groupId>
<artifactId>slf4j-api</artifactId>
<version>1.7.32</version>
</dependency>
</dependencies>首先,在Java源文件顶部添加以下代码,以引用来自IronPDF的所有必需方法:
import com.ironsoftware.ironpdf.*;
// Necessary imports from IronPDF library接下来,配置IronPDF并使用有效的许可证密钥以使用其方法。 在主方法中调用setLicenseKey方法。
License.setLicenseKey("Your license key");
// Set your IronPDF license key - required for full version**注意:**您可以获得一个试用许可证密钥来创建、读取和打印PDF。
要读取PDF文件,必须有PDF文件,或者可以创建一个。 本文将使用已创建的PDF文件。代码简单,是从文档中提取文本的两步过程:
// Load the PDF document from file
PdfDocument pdf = PdfDocument.fromFile(Paths.get("assets/sample.pdf"));
// Extract all text from the PDF
String text = pdf.extractAllText();
// Print the extracted text
System.out.println(text);在上述代码中,fromFile打开PDF文档。 Paths.get方法获取文件目录并准备从文件中提取内容。然后,[extractAllText](/java/object-reference/api/com/ironsoftware/ironpdf/PdfDocument.html#extractAllText()读取文档中的所有文本。
输出如下:
 读取PDF文本输出
IronPDF还可以从PDF的特定页面读取内容。 PageSelection对象接受要读取文本的页面范围。
在下面的示例中,从PDF文档的第二页提取文本。 PageSelection.singlePage获取需要提取的页面的索引(索引从0开始)。
// Load the PDF document from file
PdfDocument pdf = PdfDocument.fromFile(Paths.get("assets/sample.pdf"));
// Extract text from the second page (page index based, starts at 0, so 1 means second page)
String text = pdf.extractTextFromPage(PageSelection.singlePage(1));
// Print the extracted text from the specified page
System.out.println(text);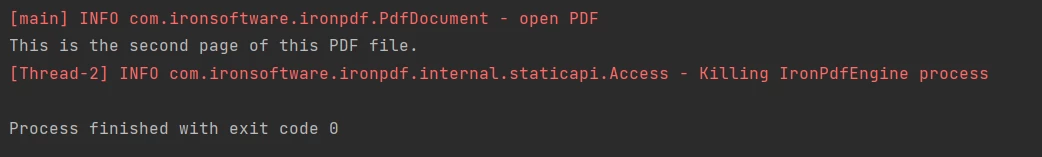 读取PDF文本输出
在PageSelection类中还有其他方法可用于从各种页面提取文本,包括:firstPage、[lastPage](/java/object-reference/api/com/ironsoftware/ironpdf/edit/PageSelection.html#firstPage()、[pageRange](/java/object-reference/api/com/ironsoftware/ironpdf/edit/PageSelection.html#pageRange(int,int)和[allPages](/java/object-reference/api/com/ironsoftware/ironpdf/edit/PageSelection.html#allPages()。
还可以从HTML文件或URL生成的新PDF文件中执行搜索文本。 下面的示例代码从URL生成PDF并从网站提取所有文本。
// Generate PDF from a URL
PdfDocument pdf = PdfDocument.renderUrlAsPdf("https://unsplash.com/");
// Extract all text from the generated PDF
String text = pdf.extractAllText();
// Print the extracted text from the URL
System.out.println("Text extracted from the website: " + text);
从新文件读取
IronPDF还可以用于从PDF文件中提取图像。
完整代码如下:
import com.ironsoftware.ironpdf.License;
import com.ironsoftware.ironpdf.PdfDocument;
import com.ironsoftware.ironpdf.edit.PageSelection;

import java.io.IOException;
import java.nio.file.Paths;

public class Main {
    public static void main(String[] args) throws IOException {
        // Set the IronPDF license key for commercial use
        License.setLicenseKey("YOUR LICENSE KEY HERE");

        // Read text from a specific page in an existing PDF
        PdfDocument pdf = PdfDocument.fromFile(Paths.get("assets/sample.pdf"));
        String text = pdf.extractTextFromPage(PageSelection.singlePage(1));
        System.out.println(text);

        // Read all text from a PDF generated from a URL
        pdf = PdfDocument.renderUrlAsPdf("https://unsplash.com/");
        text = pdf.extractAllText();
        System.out.println("Text extracted from the website: " + text);
    }
}本文解释了如何使用IronPDF在Java中打开和读取PDF。
IronPDF可以轻松地从HTML或URL创建PDF,并从不同的文件格式进行转换。 它还帮助快速且轻松地完成PDF任务。
试用IronPDF30天免费试用,了解它在生产环境中如何为您有效工作。 探索IronPDF的商业许可证选项,起价仅为$999。

Curtis Chau 拥有卡尔顿大学的计算机科学学士学位,专注于前端开发,精通 Node.js、TypeScript、JavaScript 和 React。他热衷于打造直观且美观的用户界面,喜欢使用现代框架并创建结构良好、视觉吸引力强的手册。

当您需要PDF看起来像HTML时,速度快。





