



Actualizado 21 de abril de 2026
Cómo Convertir TIFF A PDF en Java
Esta guía integral te llevará a través de los pasos sobre cómo convertir imágenes TIFF a PDF sin problemas en Java usando IronPDF.
Leer más

Este tutorial te mostrará cómo usar IronPDF for Java para extraer datos de un archivo PDF. La configuración del entorno, la importación de la biblioteca, la lectura del archivo de entrada y la extracción de los datos necesarios se explican con ejemplos de código.
IronPDF es una biblioteca de software que proporciona a los desarrolladores la capacidad de generar, editar y extraer datos de archivos PDF usando IronPDF for Java dentro de sus aplicaciones Java. Te permite crear PDFs a partir de documentos HTML, imágenes y más, así como fusionar múltiples PDFs, dividir archivos PDF, y manipular PDFs existentes. IronPDF también proporciona la capacidad de asegurar PDFs con características de protección con contraseña y añadir firmas digitales a PDFs, entre otras características.
IronPDF for Java es desarrollado y mantenido por Iron Software. Una de sus características mejor valoradas es extraer texto y datos de archivos PDF, así como de HTML y URLs.
Para usar IronPDF para extraer datos de archivos PDF, debes cumplir con los siguientes requisitos previos:
Instalar IronPDF for Java es fácil y sencillo, siempre y cuando se cumplan todos los requisitos. Esta guía usará IntelliJ IDEA de JetBrains para demostrar la instalación y ejecutar código de ejemplo.
Esto es lo que debes hacer:
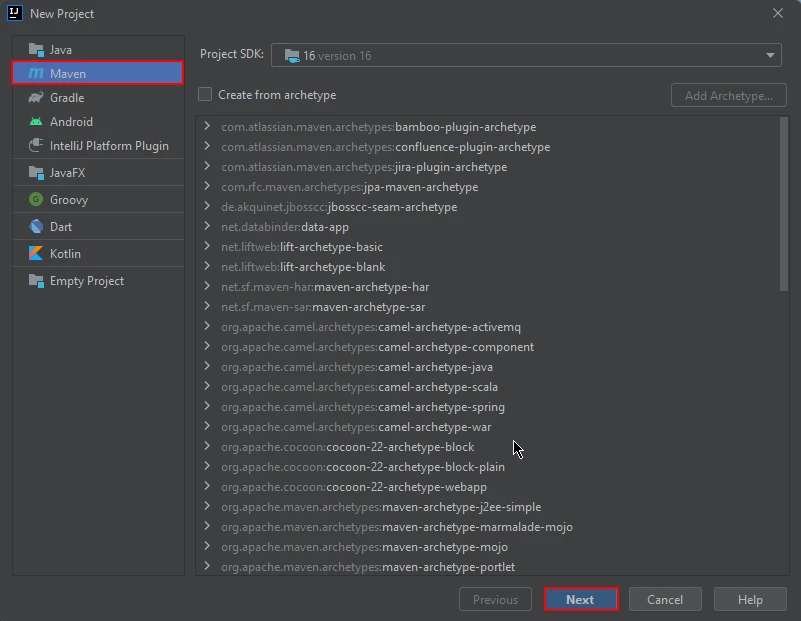 Nuevo Proyecto Maven en IntelliJ
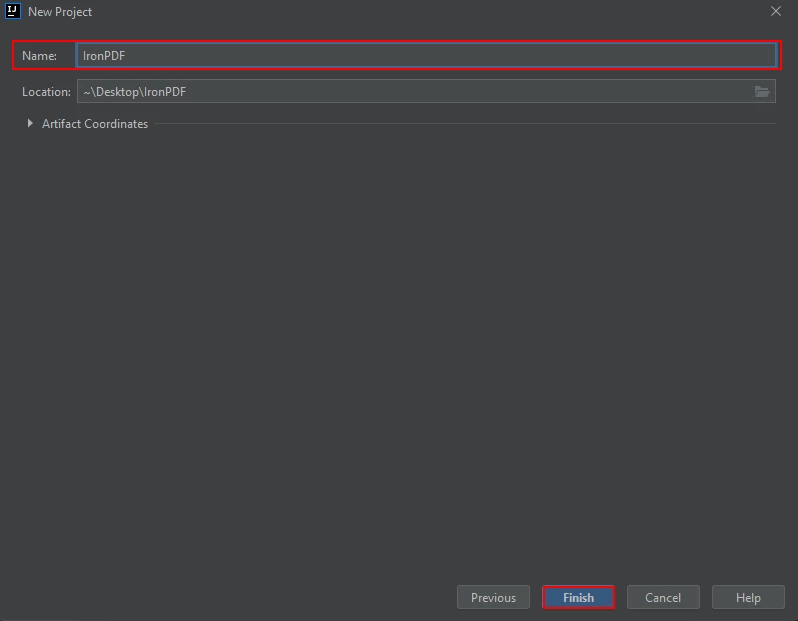 Nombra el Proyecto Maven y haz clic en Terminar
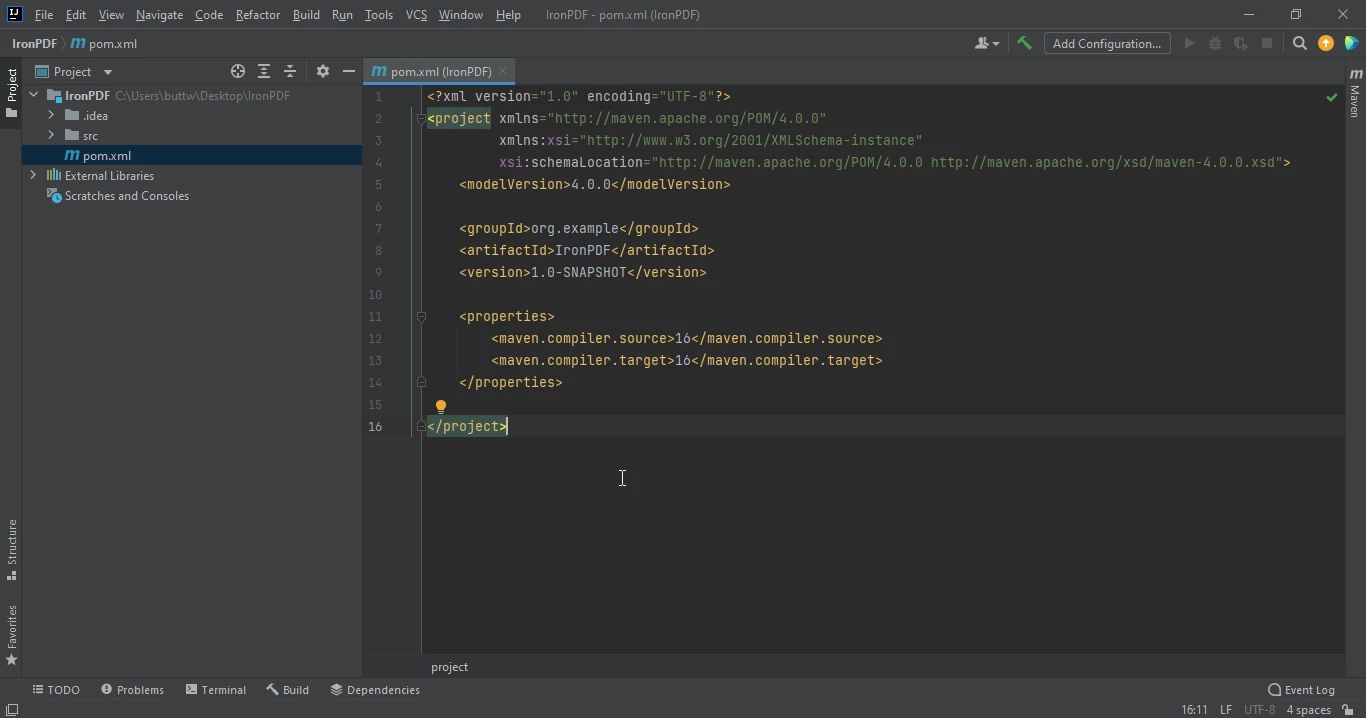 El archivo pom.xml
Añade las siguientes dependencias en el archivo pom.xml o descarga el archivo JAR desde la página de la biblioteca de IronPDF en Sonatype Central.
<dependency>
    <groupId>com.ironsoftware</groupId>
    <artifactId>ironpdf</artifactId>
    <version>1.0.0</version> <!-- replace with the latest version -->
</dependency>Una vez que hayas colocado las dependencias en el archivo pom.xml, aparecerá un pequeño icono en la esquina superior derecha del archivo.
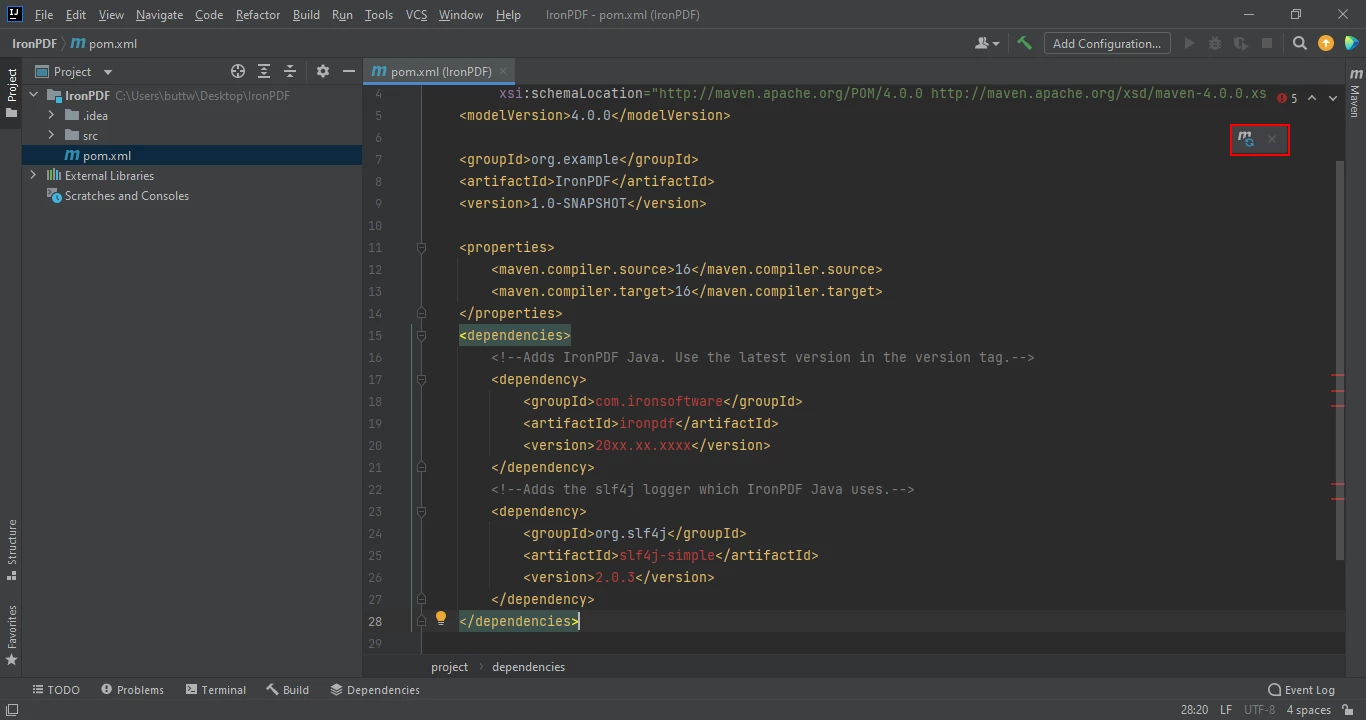 Haz clic en el icono flotante para instalar automáticamente las dependencias de Maven
Instala las dependencias Maven de IronPDF for Java haciendo clic en este botón. Dependiendo de la velocidad de tu conexión a internet, esto debería tomar solo unos minutos.
IronPDF es una biblioteca Java para crear, editar y extraer datos de documentos PDF. Proporciona una API simple para extraer texto de archivos PDF, URLs y tablas.
Usando IronPDF for Java, puedes fácilmente extraer datos de texto de documentos PDF. A continuación se muestra el código de ejemplo para extraer datos de un archivo PDF.
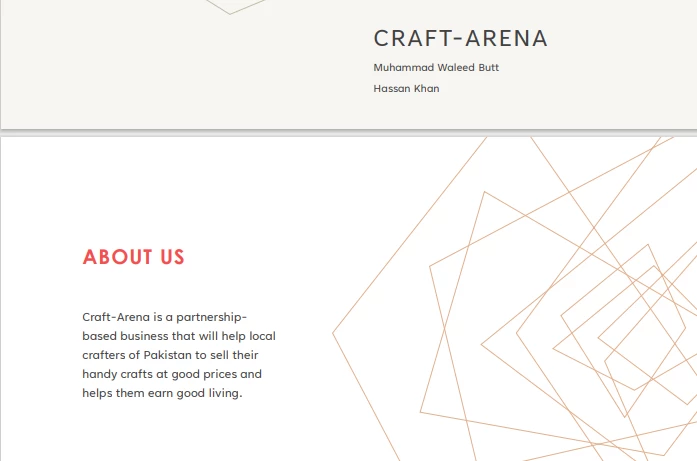 Entrada PDF
// Import the necessary IronPDF package for working with PDF documents
import com.ironsoftware.ironpdf.PdfDocument;

import java.io.IOException;
import java.nio.file.Paths;

public class Main {
    public static void main(String[] args) throws IOException {
        // Load the PDF document from the specified file
        PdfDocument pdf = PdfDocument.fromFile(Paths.get("business plan.pdf"));

        // Extract all text from the PDF document
        String text = pdf.extractAllText();

        // Print the extracted text to the console
        System.out.println("Text extracted from the PDF: " + text);
    }
}El código fuente produce la salida que se muestra a continuación:
> Text extracted from the PDF:
>
> CRAFT-ARENA
>
> Muhammad Waleed Butt
>
> Hassan Khan
>
> ABOUT US
>
> Craft-Arena is a partnership based business that will help local crafters of Pakistan to sell their handicrafts at good prices and helps them earn a good living.IronPDF for Java convierte la URL a PDF en tiempo de ejecución y extrae texto de ella. Este ejemplo mostrará el código fuente para extraer texto de URLs.
// Import the necessary IronPDF package for working with PDF documents
import com.ironsoftware.ironpdf.PdfDocument;

import java.io.IOException;

public class Main {
    public static void main(String[] args) throws IOException {
        // Convert a URL to a PDF and load it into a PdfDocument
        PdfDocument pdf = PdfDocument.renderUrlAsPdf("https://ironpdf.com/java/");

        // Extract all text from the PDF document
        String text = pdf.extractAllText();

        // Print the extracted text to the console
        System.out.println("Text extracted from the URLs: " + text);
    }
}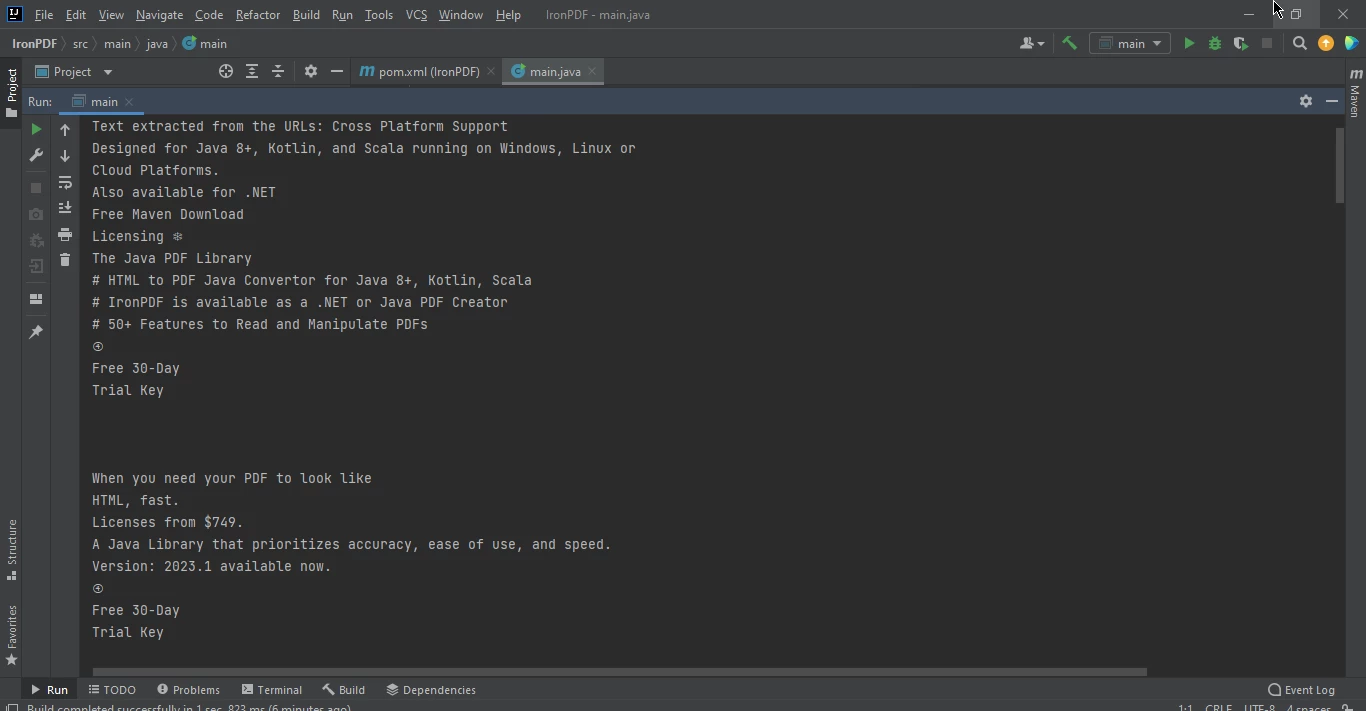 Datos de Página Web Extraídos
Para extraer datos de tabla de un PDF usando IronPDF for Java es muy simple; todo lo que necesitas es un PDF que contenga una tabla, y ejecutar el código abajo.
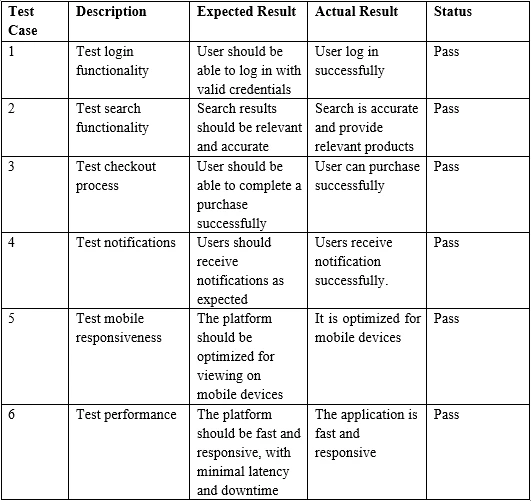 Ejemplo de Entrada de Tabla PDF
// Import the necessary IronPDF package for working with PDF documents
import com.ironsoftware.ironpdf.PdfDocument;

import java.io.IOException;
import java.nio.file.Paths;

public class Main {
    public static void main(String[] args) throws IOException {
        // Load the PDF document from the specified file
        PdfDocument pdf = PdfDocument.fromFile(Paths.get("table.pdf"));

        // Extract all text from the PDF document, including table data
        String text = pdf.extractAllText();

        // Print the extracted table data to the console
        System.out.print("Text extracted from the Marked tables: " + text);
    }
}> Test Case Description Expected Result Actual Result Status
>
> 1 Test login functionality User should be able to log in with valid credentials
>
> User log in successfully Pass
>
> 2 Test search functionality Search results should be relevant and accurate
>
> Search is accurate and provide relevant products Pass
>
> 3 Test checkout process User should be able to complete a purchase successfully
>
> User can purchase successfully PassEn conclusión, este tutorial ha demostrado cómo extraer datos, específicamente datos tabulares, de un archivo PDF usando IronPDF for Java.
Para más información, por favor consulta el ejemplo de extracción de texto de PDF en el sitio de IronPDF.
IronPDF es una biblioteca con una licencia comercial cuyos detalles comienzan en $999. Sin embargo, puedes evaluarlo en producción con una prueba gratuita usando la licencia de prueba de IronPDF.

Curtis Chau tiene una licenciatura en Ciencias de la Computación (Carleton University) y se especializa en el desarrollo front-end con experiencia en Node.js, TypeScript, JavaScript y React. Apasionado por crear interfaces de usuario intuitivas y estéticamente agradables, disfruta trabajando con frameworks modernos y creando manuales bien estructurados y visualmente atractivos.



IronPDF es parte de IRONSUITE
10 productos API .NET para tus documentos de oficina


Cuando necesitas que tu PDF se parezca al HTML, rápido.

