



更新日 2026年4月21日
JavaでTIFFをPDFに変換する方法
この包括的なガイドでは、JavaでIronPDFを使用してTIFF画像をシームレスにPDFに変換するステップを紹介します。
詳しく読む

この記事では、JavaでIronPDFを使用してPDFファイルを表示する方法を説明し、Mavenプロジェクトのセットアップ手順を紹介します。 さらに、IronPDFの他の機能を探り、Javaで強力なPDF処理アプリケーションを作成する際の有用性について議論します。
IronPDF Java 向け Libraryは、Java開発者向けに特別に設計された包括的で使いやすいPDFライブラリです。 このライブラリは、最小限の労力で強力なPDF処理機能を統合します。 IronPDFは、PDFファイルの作成、編集、表示、およびコンテンツの抽出を行うためのオールインワンソリューションです。 JavaアプリケーションでのPDFの取り扱いを簡素化し、開発者が主要なタスクに集中できるようにします。
まず、Mavenプロジェクトをセットアップし、IronPDFおよびSLF4Jロガーの必要な依存関係を追加します。 次のコードをプロジェクトのpom.xmlファイルに追加してください。
<!-- Add IronPDF and SLF4J dependencies to your Maven project -->
<dependencies>
    <dependency>
        <groupId>com.ironsoftware</groupId>
        <artifactId>ironpdf</artifactId>
        <version>YOUR_VERSION_HERE</version>
    </dependency>
    <dependency>
        <groupId>org.slf4j</groupId>
        <artifactId>slf4j-api</artifactId>
        <version>YOUR_VERSION_HERE</version>
    </dependency>
</dependencies>次に、PDFファイルからテキストを読み取ったり抽出したりするためにIronPDFを使用するJavaクラスを作成します。次のコードをテンプレートとして使用してください。
import java.awt.print.PrinterException;
import java.io.IOException;
import java.nio.file.Paths;

import com.ironsoftware.ironpdf.License;
import com.ironsoftware.ironpdf.PdfDocument;

public class App {

    public static void main(String[] args) throws IOException, PrinterException {
        // Set the IronPDF license key
        License.setLicenseKey("Your-License-Key");

        // Load the PDF file
        PdfDocument pdf = new PdfDocument(Paths.get("C:\\dotnet.pdf"));

        // Extract text from the PDF file
        String text = pdf.extractAllText();

        // Display the extracted text
        System.out.println("Text extracted from the PDF: " + text);
    }
}コードを分解してよりよく理解しましょう。
**インポート文:**IronPDFを使用するために必要なクラスとパッケージをインポートし、例外を処理します。 java.io.IOExceptionはPDF処理中に発生する可能性のある例外を処理します。
**IronPDFライセンスキーの設定:**IronPDFを使用する前に、ライセンスキーを設定します。 ライブラリの機能を有効にするために、"Your-License-Key"をIronPDFライセンスキーに置き換えてください。
License.setLicenseKey("Your-License-Key");PDFファイルの読み込み: PDFファイルパスを提供してPdfDocumentオブジェクトを作成します。 "C:\dotnet.pdf"ファイルを指すPaths.getを使用します。
PdfDocument pdf = new PdfDocument(Paths.get("C:\\dotnet.pdf"));PDFファイルからのテキスト抽出: 一度読み込んだ後、[extractAllText](/java/object-reference/api/com/ironsoftware/ironpdf/PdfDocument.html#extractAllText()メソッドを使ってPDFからすべてのテキストを抽出します。
String text = pdf.extractAllText();**抽出されたテキストの表示:**抽出されたテキストをコンソールにプリントして表示します。
System.out.println("Text extracted from the PDF: " + text);IronPDFは、抽出されたテキストセクションに示されているように、PDFファイルからテキストを抽出します。
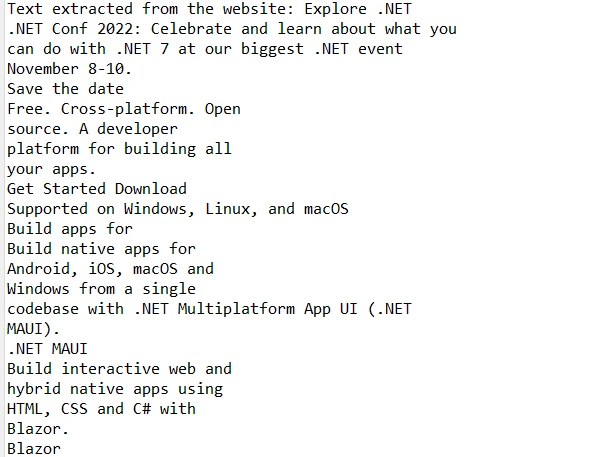 抽出されたテキスト
IronPDFによるPDF生成:IronPDFはHTML、画像、プレーンテキストなどさまざまなソースからPDFファイルを生成できます。 この機能は、JaVAアプリケーションから動的なレポート、請求書、および文書を直接PDFフォーマットで作成するのに役立ちます。
**PDF編集:**IronPDFは、既存のPDFを編集するためのツールを提供します。 開発者は、PDFドキュメントを結合、PDFを分割し、ファイル内のコンテンツを操作することができ、特定のニーズに合わせたカスタムPDFを作成できます。
IronPDFによるPDF表示とテキスト抽出:IronPDFは、表示とテキストの抽出を容易にします。PDF内のテキスト検索、インデックス作成、または解析が必要なアプリには重要です。
PDFを画像にラスタライズ:IronPDFによってPDFを画像としてレンダリングし、アプリやWebサイトでの表示を簡単にします。 Bitmap、PNG、またはJPEGなどのフォーマットをサポートしています。
PDFフォームの入力:IronPDFはプログラム的なフォーム入力を可能にし、フォームタスクの自動化、フォームの事前入力、およびワークフローの合理化を行います。
**セキュリティ機能:**IronPDFはPDF暗号化およびデジタル署名をサポートし、機密情報を保護し、文書の信頼性を保証します。
**プラットフォームの独立性:**IronPDFはプラットフォームに依存せず、Windows、macOS、LinuxなどのさまざまなOSと互換性があります。 IronPDFを使用しているJavaアプリは、別々の環境でもスムーズに展開できます。
結論として、IronPDFはJavaアプリケーションでPDFを表示および操作しようとする開発者にとって優れたソリューションです。 PDF生成、編集、レンダリング、フォーム入力などの機能により、IronPDFは強力で効率的かつユーザーフレンドリーなドキュメント管理ツールを作成します。 そのプラットフォームに依存しない性質は、さまざまな環境での互換性を保証し、現代 for Javaアプリケーションに最適です。
IronPDFはオープンソースライブラリではありませんが、開発者がその能力を探求できる無料トライアルを提供します。 ライセンスオプションは$999から始まり、PDF処理タスクを効率化するための費用対効果の高いソリューションを提供します。

Curtis Chauは、カールトン大学でコンピュータサイエンスの学士号を取得し、Node.js、TypeScript、JavaScript、およびReactに精通したフロントエンド開発を専門としています。直感的で美しいユーザーインターフェースを作成することに情熱を持ち、Curtisは現代のフレームワークを用いた開発や、構造の良い視覚的に魅力的なマニュアルの作成を楽しんでいます。

IronPDF はIRONSUITEの一部です
オフィス文書向けの.NET API製品10個

PDFがHTMLのように見える必要があるとき、迅速に。





