


已更新 2026年6月20日
如何在 Node.js 中从 PDF 中提取图像
在本文中,我们将探索如何使用 IronPDF,一个强大的 PDF 库,从PDF中提取并保存图像,以及如何通过其 NPM 包将其集成到 Node.js 环境中。
阅读更多

在 Node.js 中将 PDF 转换为文本是许多应用程序中的常见任务,尤其是在进行数据分析、内容管理系统,或甚至是简单的转换工具时。 在 Node.js 环境和IronPDF 库的帮助下,开发者可以轻松地将 PDF 文档转换为可用的文本数据。 本教程旨在指导初学者通过使用 IronPDF 设置一个 Node.js 项目来从 PDF 页面文件中提取文本,重点关注安装细节、PDF 解析实现、错误处理和实际应用等关键方面。
在踏上这段旅程之前,确保你拥有以下内容:
为你的项目创建一个新目录并初始化 Node.js 应用程序:
mkdir pdf-to-text-node
cd pdf-to-text-node
npm init -yusing npm 安装 IronPDF:
npm install ironpdfimport { PdfDocument } from "@ironpdf/ironpdf";
import { IronPdfGlobalConfig } from "@ironpdf/ironpdf";
import fs from "fs";在这第一步中,你需要导入必要的模块。 PdfDocument 和 IronPdfGlobalConfig 是从 @IronPDF/ironpdf 包中导入的,它们对于处理PDF文档和配置IronPDF分别是必不可少的。 核心 Node.js 模块fs也被导入,用于处理文件系统操作。
(async function createPDFs() {
// ...
})();在这里,定义并立即调用了一个名为createPDFs的异步匿名函数。 这种设置允许在函数中使用await,从而便于处理异步操作,这在处理文件 I/O 和像 IronPDF 这样的外部库时很常见。
const IronPdfConfig = {
licenseKey: "Your-License-Key",
};
IronPdfGlobalConfig.setConfig(IronPdfConfig);在这一步中,你需要为 IronPDF 创建一个配置对象,包括许可证密钥,并使用IronPDFGlobalConfig.setConfig应用此配置。 这对于启用 IronPDF 的所有功能至关重要,特别是如果你使用的是许可版本。
const pdf = await PdfDocument.fromFile("old-report.pdf");在这一步中,代码正确使用PdfDocument类的fromFile方法加载现有的 PDF 文档。 这是一个异步操作,因此需使用await。 通过指定 PDF 文件的路径(在此例中为"old-report.pdf"),pdf变量成为你的 PDF 文档的表示,完全加载并准备好进行文本提取。 这一步至关重要,因为这就是 PDF 文件被解析并准备好进行你希望执行的任何操作(例如提取文本)的地方。
const text = await pdf.extractText();在这里,在pdf对象上调用extractText方法。 这个异步操作从加载的 PDF 文档中提取所有文本,并将其存储在text变量中。
const wordCount = text.split(/\s+/).length;
console.log("Word Count:", wordCount);在这一步骤中,提取的文本被处理以计数单词的数量。 这是通过使用匹配一个或多个空白字符的正则表达式将文本字符串拆分为单词数组,然后计算结果数组的长度来实现的。
fs.writeFileSync("extracted_text.txt", text);这条已更正的行使用fs模块的writeFileSync方法同步地将提取的文本写入到文件中。
} catch (error) {
console.error("An error occurred:", error); // Log error
}最后,代码包括一个try-catch块用于错误处理。 如果try块中任何异步操作部分失败,catch块将捕获错误,并将消息记录到控制台。 这对于调试和确保你的应用程序能够优雅地处理意外问题是很重要的。
下面是完整的代码,涵盖了我们已经讨论的所有步骤,用于在 Node.js 环境中使用 IronPDF 从 PDF 文档中提取文本:
import { PdfDocument } from "@ironpdf/ironpdf";
import { IronPdfGlobalConfig } from "@ironpdf/ironpdf";
import fs from "fs";
(async function createPDFs() {
try {
// Input the license key
const IronPdfConfig = {
licenseKey: "Your-License-Key",
};
// Set the config with the license key
IronPdfGlobalConfig.setConfig(IronPdfConfig);
// Import existing PDF document
const pdf = await PdfDocument.fromFile("old-report.pdf");
// Get all text to put in a search index
const text = await pdf.extractText();
// Process the extracted text
// Example: Count words
const wordCount = text.split(/\s+/).length;
console.log("Word Count:", wordCount);
// Save the extracted text to a text file
fs.writeFileSync("extracted_text.txt", text);
console.log("Extracted text saved to extracted_text.txt");
} catch (error) {
// Handle errors here
console.error("An error occurred:", error);
}
})();这个脚本包含了从 PDF 文件中提取文本所需的所有组件:设置 IronPDF 的许可证密钥,加载 PDF 文档,提取文本,执行简单的文本分析(在这个例子中是词数统计),并将提取的文本保存到文件中。代码被包装在异步函数中以处理文件操作和 PDF 处理在 Node.js 中的异步特性。
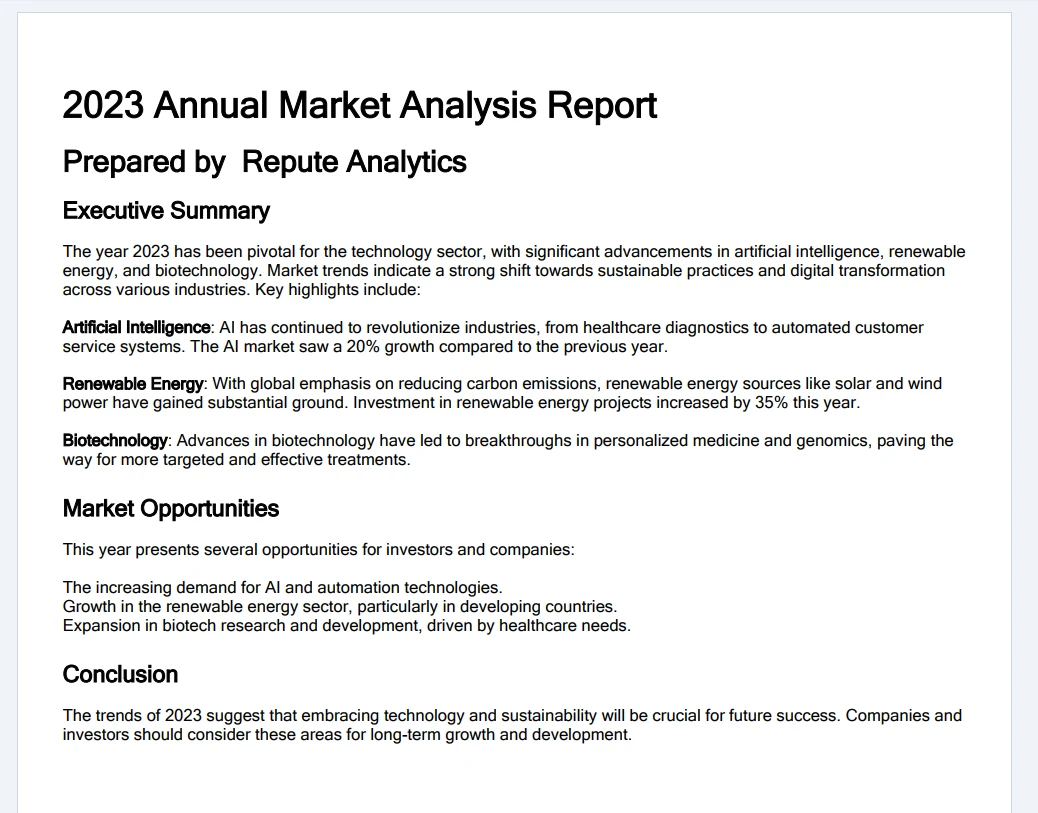
运行脚本后,你将得到两个关键组件来分析:原始 PDF 文件和包含提取文本的文本文件。 本节将指导你理解和评估脚本的输出。
你为这个过程选择的 PDF 文件,在本例中命名为"old-report.pdf",是起点。 PDF 文档在复杂性和内容上可能有很大的不同。 它们可能包含简单、直观的文本,或可能包含丰富的图像、表格和各种文本格式。 PDF 的结构和复杂性将直接影响提取过程。
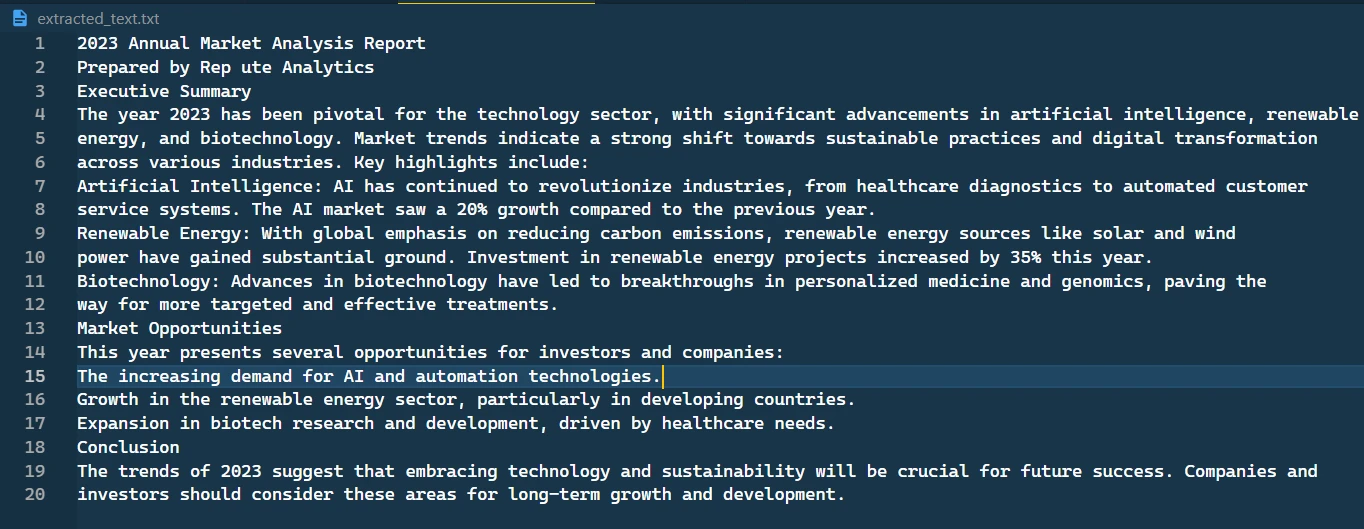
运行脚本后,将创建一个名为"extracted_text.txt"的新文本文件。 该文件包含所有从 PDF 文档中提取的文本。
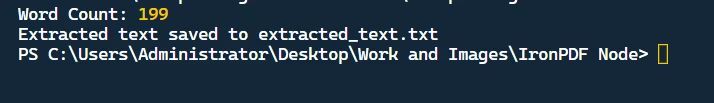
以下是在控制台上的输出:
从 PDF 中提取文本在数据挖掘和分析中特别有用。 无论是提取财务报告、研究论文或任何其他 PDF 文档,将 PDF 转换为文本的能力对于数据分析任务至关重要。
在内容管理系统中,通常需要处理各种文件格式。 IronPDF 可以成为管理、存档和检索以 PDF 格式存储的内容的系统中的关键组件。
这份详尽的指南已经带你走过了使用 IronPDF 从 PDF 文档中提取文本并在 Node.js 项目中设置的过程。 从处理基本的文本提取到深入研究更复杂的功能(如文本对象提取和性能优化),你现在已经具备了在你的 Node.js 应用程序中实现高效 PDF 文本提取的知识。
请记住,这段旅程并没有结束。 PDF 处理和文本提取的领域是一个广阔的领域,里面有许多功能和技术等待探索。 接受挑战,继续提高你在这个令人兴奋的软件开发领域的技能。
值得注意的是,IronPDF 提供了一个免费试用。 对于那些希望在专业环境中整合 IronPDF 的人,有可用的许可证选项。

Curtis Chau 拥有卡尔顿大学的计算机科学学士学位,专注于前端开发,精通 Node.js、TypeScript、JavaScript 和 React。他热衷于打造直观且美观的用户界面,喜欢使用现代框架并创建结构良好、视觉吸引力强的手册。

当您需要PDF看起来像HTML时,速度快。



