using IronPdf;

// Disable local disk access or cross-origin requests
Installation.EnableWebSecurity = true;

// Instantiate Renderer
var renderer = new ChromePdfRenderer();

// Create a PDF from a HTML string using C#
var pdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>");

// Export to a file or Stream
pdf.SaveAs("output.pdf");

// Advanced Example with HTML Assets
// Load external html assets: Images, CSS and JavaScript.
// An optional BasePath 'C:\site\assets\' is set as the file location to load assets from
var myAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", @"C:\site\assets\");
myAdvancedPdf.SaveAs("html-with-assets.pdf");
using IronPdf;// Disable local disk access or cross-origin requestsInstallation.EnableWebSecurity = true;// Instantiate Renderervar renderer = new ChromePdfRenderer();// Create a PDF from a HTML string using C#var pdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>");// Export to a file or Streampdf.SaveAs("output.pdf");// Advanced Example with HTML Assets// Load external html assets: Images, CSS and JavaScript.// An optional BasePath 'C:\site\assets\' is set as the file location to load assets fromvar myAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", @"C:\site\assets\");myAdvancedPdf.SaveAs("html-with-assets.pdf");
PM >Install-Package IronPdf
Install-Package IronPdf
ENTWICKLER-UPDATES
C# Parallel Foreach (Wie es für Entwickler funktioniert)
### What is Parallel.ForEach in C#?
[Parallel.ForEach](https://learn.microsoft.com/en-us/dotnet/api/system.threading.tasks.parallel.foreach?view=net-9.0) ist eine Methode in C#, die es ermöglicht, parallele Iterationen über eine Sammlung oder Datenquelle durchzuführen. Anstatt jedes Element in der Sammlung nacheinander zu verarbeiten, ermöglicht eine parallele Schleife die gleichzeitige Ausführung, was die Leistung erheblich verbessern kann, indem die gesamte Ausführungszeit reduziert wird. Die parallele Verarbeitung funktioniert, indem die Arbeit auf mehrere Kernprozessoren aufgeteilt wird, sodass die Aufgaben gleichzeitig ablaufen können. Dies ist besonders nützlich, wenn Aufgaben verarbeitet werden, die voneinander unabhängig sind.
Im Gegensatz zu einer normalen foreach-Schleife, die Elemente nacheinander verarbeitet, kann der parallele Ansatz große Datensätze viel schneller verarbeiten, indem er mehrere Threads parallel nutzt.
### Warum Parallelverarbeitung mit IronPDF?
[IronPDF](https://ironpdf.com) ist eine leistungsstarke Bibliothek zum Umgang mit PDFs in .NET, die in der Lage ist, [HTML in PDF zu konvertieren](/how-to/html-string-to-pdf/), [Text aus PDFs zu extrahieren](/how-to/extract-text-and-images/), Dokumente zu [zusammenzuführen und zu teilen](/how-to/merge-or-split-pdfs/) und mehr. Wenn Sie mit großen Mengen an PDF-Aufgaben zu tun haben, kann die Verwendung der Parallelverarbeitung mit Parallel.ForEach die Ausführungszeit erheblich verkürzen. Ob Sie Hunderte von PDFs erstellen oder Daten aus mehreren Dateien gleichzeitig extrahieren, die Nutzung von Datenparallelität mit IronPDF stellt sicher, dass Aufgaben schneller und effizienter abgeschlossen werden.
Dieser Leitfaden richtet sich an .NET-Entwickler, die ihre PDF-Verarbeitungsaufgaben mit IronPDF und Parallel.ForEach optimieren möchten. Grundkenntnisse in C# und Vertrautheit mit der IronPDF-Bibliothek werden empfohlen. Am Ende dieses Leitfadens werden Sie in der Lage sein, Parallelverarbeitung zu implementieren, um mehrere PDF-Aufgaben gleichzeitig zu bearbeiten und sowohl die Leistung als auch die Skalierbarkeit zu verbessern.
## Einstieg
### Installation von IronPDF
Um [IronPDF](https://www.nuget.org/packages/IronPdf/) in Ihrem Projekt zu verwenden, müssen Sie die Bibliothek über NuGet installieren.
#### NuGet-Paket-Installation
Um IronPDF zu installieren, führen Sie diese Schritte aus:
1. Öffnen Sie Ihr Projekt in Visual Studio.
2. Gehen Sie zu **Tools** → **NuGet-Paket-Manager** → **NuGet-Pakete für die Lösung verwalten**.
3. Suchen Sie im NuGet-Paket-Manager nach IronPDF.

4. Klicken Sie auf **Install**, um die IronPDF-Bibliothek zu Ihrem Projekt hinzuzufügen.

Alternativ können Sie es über die NuGet-Paket-Manager-Konsole installieren:
```shell
:ProductInstall
```
Sobald IronPDF installiert ist, sind Sie bereit, es für die PDF-Erzeugung und -Manipulation zu verwenden.
### Basic Concepts of Parallel.ForEach in C#
`Parallel.ForEach` ist Teil des `System.Threading.Tasks`-Namespace und bietet eine einfache und effektive Möglichkeit, Iterationen gleichzeitig auszuführen. Die Syntax für `Parallel.ForEach` lautet wie folgt:
```csharp
Parallel.ForEach(collection, item =>
{
    // Code to process each item
});
```
Jedes Element in der Sammlung wird parallel verarbeitet, und das System entscheidet, wie die Arbeitslast auf die verfügbaren Threads verteilt wird. Sie können auch Optionen angeben, um den Grad der Parallelität zu steuern, wie z. B. die maximale Anzahl verwendeter Threads.
Im Vergleich dazu verarbeitet eine traditionelle `foreach`-Schleife jedes Element nacheinander, während die parallele Schleife mehrere Elemente gleichzeitig verarbeiten kann, wodurch die Leistung bei der Verarbeitung großer Sammlungen verbessert wird.
## Schrittweise Implementierung
### Einrichten des Projekts
Stellen Sie zuerst sicher, dass IronPDF installiert ist, wie im Abschnitt Erste Schritte beschrieben. Danach können Sie beginnen, Ihre parallele PDF-Verarbeitung zu schreiben.
### Schreiben der Logik der Parallelverarbeitung
#### Code-Schnipsel: Parallel.ForEach für die Konvertierung von HTML in PDF verwenden
```csharp
string[] htmlFiles = { "page1.html", "page2.html", "page3.html" };
Parallel.ForEach(htmlFiles, htmlFile =>
{
// Load the HTML content into IronPDF and convert it to PDF
ChromePdfRenderer renderer = new ChromePdfRenderer();
PdfDocument pdf = renderer.RenderHtmlAsPdf(htmlFile);
// Save the generated PDF to the output folder
pdf.SaveAs($"output_{htmlFile}.pdf");
});
```
Dieses Codebeispiel zeigt, wie mehrere HTML-Seiten parallel in PDFs umgewandelt werden können.
### Behandlung von Fehlern bei der parallelen Verarbeitung
Beim Umgang mit parallelen Aufgaben ist die Fehlerbehandlung entscheidend. Verwenden Sie try-catch-Blöcke innerhalb der `Parallel.ForEach`-Schleife, um Ausnahmen zu verwalten.
#### Code Snippet: Fehlerbehandlung in parallelen PDF-Aufgaben
```csharp
Parallel.ForEach(pdfFiles, pdfFile =>
{
try
{
var pdf = IronPdf.PdfDocument.FromFile(pdfFile);
string text = pdf.ExtractAllText();
System.IO.File.WriteAllText($"extracted_{pdfFile}.txt", text);
}
catch (Exception ex)
{
Console.WriteLine($"Error processing {pdfFile}: {ex.Message}");
}
});
```
## Praktische Anwendungsfälle mit vollständigen Codebeispielen
### Text aus mehreren PDFs gleichzeitig extrahieren
Ein weiterer Anwendungsfall für die Parallelverarbeitung ist die Textextraktion aus mehreren PDFs. Beim Umgang mit mehreren PDF-Dateien kann die gleichzeitige Textextraktion viel Zeit sparen. Das folgende Beispiel zeigt, wie dies gemacht werden kann.
#### Beispiel: Parallele Textextraktion aus mehreren Dokumenten
```csharp
using IronPdf;
using System.Linq;
using System.Threading.Tasks;
class Program
{
static void Main(string[] args)
{
string[] pdfFiles = { "doc1.pdf", "doc2.pdf", "doc3.pdf" };
Parallel.ForEach(pdfFiles, pdfFile =>
{
var pdf = IronPdf.PdfDocument.FromFile(pdfFile);
string text = pdf.ExtractText();
System.IO.File.WriteAllText($"extracted_{pdfFile}.txt", text);
});
}
}
```
### Ausgangsdokumente

In diesem Code wird jede PDF-Datei parallel verarbeitet, um Text zu extrahieren, und der extrahierte Text wird in separaten Textdateien gespeichert.
### Beispiel: Parallele Stapelgenerierung von PDF-Dateien aus HTML-Dateien
In diesem Beispiel werden wir mehrere PDFs aus einer Liste von HTML-Dateien parallel erzeugen, was ein typisches Szenario sein könnte, wenn Sie mehrere dynamische HTML-Seiten in PDF-Dokumente konvertieren müssen.
### Code
```csharp
using IronPdf;
using System;
using System.Threading.Tasks;
class Program
{
static void Main(string[] args)
{
string[] htmlFiles = { "example.html", "example_1.html", "example_2.html" };
Parallel.ForEach(htmlFiles, htmlFile =>
{
try
{
// Load the HTML content into IronPDF and convert it to PDF
ChromePdfRenderer renderer = new ChromePdfRenderer();
PdfDocument pdf = renderer.RenderHtmlFileAsPdf(htmlFile);
// Save the generated PDF to the output folder
pdf.SaveAs($"output_{htmlFile}.pdf");
Console.WriteLine($"PDF created for {htmlFile}");
}
catch (Exception ex)
{
Console.WriteLine($"Error processing {htmlFile}: {ex.Message}");
}
});
}
}
```
### Konsolenausgabe

### PDF-Ausgabe

### Erklärung
1. **HTML-Dateien:** Das Array `htmlFiles` enthält Pfade zu mehreren HTML-Dateien, die Sie in PDFs konvertieren möchten.
2. **Parallelverarbeitung:**
- `Parallel.ForEach(htmlFiles, htmlFile => {...})` verarbeitet jede HTML-Datei gleichzeitig, was den Vorgang beschleunigt, wenn Sie mit mehreren Dateien arbeiten.
- Für jede Datei im `htmlFiles`-Array wird der Code mit `renderer.RenderHtmlFileAsPdf(htmlFile);` in ein PDF konvertiert.
3. **Speichern des PDFs:** Nach der Generierung des PDFs wird es mit der `pdf.SaveAs`-Methode gespeichert, wobei der Ausgabedateiname mit dem Originalnamen der HTML-Datei ergänzt wird.
4. **Fehlerbehandlung:** Wenn ein Fehler auftritt (z. B. wenn die HTML-Datei nicht existiert oder ein Problem bei der Konvertierung auftritt), wird er vom try-catch-Block abgefangen, und eine Fehlermeldung wird für die betreffende Datei ausgegeben.
## Leistungstipps und bewährte Praktiken
### Thread-Sicherheitsprobleme mit IronPDF vermeiden
IronPDF ist für die meisten Vorgänge threadsicher. Einige Operationen wie das gleichzeitige Schreiben in dieselbe Datei können jedoch Probleme verursachen. Stellen Sie immer sicher, dass jede parallele Aufgabe auf eine separate Ausgabedatei oder Ressource zugreift.
### Optimierung der parallelen Verarbeitung für große Datenmengen
Um die Leistung zu optimieren, sollten Sie den Grad der Parallelität steuern. Bei großen Datensätzen möchten Sie möglicherweise die Anzahl der gleichzeitigen Threads begrenzen, um eine Systemüberlastung zu verhindern.
```csharp
var options = new ExecutionDataflowBlockOptions
{
MaxDegreeOfParallelism = 4
};
```
### Speichermanagement bei parallelen PDF-Operationen
Bei der Verarbeitung einer großen Anzahl von PDFs sollten Sie auf die Speichernutzung achten. Versuchen Sie, Ressourcen wie `PdfDocument`-Objekte freizugeben, sobald sie nicht mehr benötigt werden.
### Verwendung von Erweiterungsmethoden
Eine Erweiterungsmethode ist eine besondere Art von statischer Methode, die es Ihnen ermöglicht, einem vorhandenen Typ neue Funktionalitäten hinzuzufügen, ohne dessen Quellcode zu ändern. Dies kann nützlich sein, wenn Sie mit Bibliotheken wie IronPDF arbeiten, bei denen Sie möglicherweise benutzerdefinierte Verarbeitungsmethoden hinzufügen oder deren Funktionalität erweitern möchten, um die Arbeit mit PDFs bequemer zu machen, insbesondere in parallelen Verarbeitungsszenarien.
#### Vorteile der Verwendung von Erweiterungsmethoden in der Parallelverarbeitung
Mit Erweiterungsmethoden können Sie prägnanten, wiederverwendbaren Code erstellen, der die Logik in parallelen Schleifen vereinfacht. Dieser Ansatz reduziert nicht nur die Duplizierung, sondern hilft Ihnen auch dabei, eine saubere Codebasis zu pflegen, insbesondere bei der Arbeit mit komplexen PDF-Arbeitsabläufen und Datenparallelitäten.
## Abschluss
Die Verwendung von parallelen Schleifen wie `Parallel.ForEach` mit [IronPDF](https://ironpdf.com) bietet erhebliche Leistungssteigerungen bei der Verarbeitung großer Mengen von PDFs. Ob Sie HTML in PDFs konvertieren, Text extrahieren oder Dokumente manipulieren, Datenparallelität ermöglicht eine schnellere Ausführung, indem Aufgaben gleichzeitig ausgeführt werden. Der parallele Ansatz stellt sicher, dass Operationen über mehrere Kernprozessoren ausgeführt werden können, was die gesamte Ausführungszeit verkürzt und die Leistung bei Batch-Processing-Aufgaben verbessert.
Während die Parallelverarbeitung Aufgaben beschleunigt, achten Sie auf Threadsicherheit und Ressourcenmanagement. IronPDF ist für die meisten Vorgänge threadsicher, aber es ist wichtig, potenzielle Konflikte beim Zugriff auf gemeinsame Ressourcen zu behandeln. Berücksichtigen Sie Fehlerbehandlung und Speicherverwaltung, um Stabilität sicherzustellen, insbesondere wenn Ihre Anwendung skaliert.
Wenn Sie bereit sind, tiefer in IronPDF einzusteigen und fortgeschrittene Funktionen zu erkunden, bietet die [offizielle Dokumentation](https://ironpdf.com) umfangreiche Informationen. Außerdem können Sie von deren Testlizenz profitieren, die es Ihnen ermöglicht, die Bibliothek in Ihren eigenen Projekten zu testen, bevor Sie einen Kauf tätigen.
Parallel.ForEach ist eine Methode in C#, die es ermöglicht, parallele Iterationen über eine Sammlung oder Datenquelle durchzuführen. Anstatt jedes Element in der Sammlung nacheinander zu verarbeiten, ermöglicht eine parallele Schleife die gleichzeitige Ausführung, was die Leistung erheblich verbessern kann, indem die gesamte Ausführungszeit reduziert wird. Die parallele Verarbeitung funktioniert, indem die Arbeit auf mehrere Kernprozessoren aufgeteilt wird, sodass die Aufgaben gleichzeitig ablaufen können. Dies ist besonders nützlich, wenn Aufgaben verarbeitet werden, die voneinander unabhängig sind.
Im Gegensatz zu einer normalen foreach-Schleife, die Elemente nacheinander verarbeitet, kann der parallele Ansatz große Datensätze viel schneller verarbeiten, indem er mehrere Threads parallel nutzt.
Warum Parallelverarbeitung mit IronPDF?
IronPDF ist eine leistungsstarke Bibliothek zum Umgang mit PDFs in .NET, die in der Lage ist, HTML in PDF zu konvertieren, Text aus PDFs zu extrahieren, Dokumente zu zusammenzuführen und zu teilen und mehr. Wenn Sie mit großen Mengen an PDF-Aufgaben zu tun haben, kann die Verwendung der Parallelverarbeitung mit Parallel.ForEach die Ausführungszeit erheblich verkürzen. Ob Sie Hunderte von PDFs erstellen oder Daten aus mehreren Dateien gleichzeitig extrahieren, die Nutzung von Datenparallelität mit IronPDF stellt sicher, dass Aufgaben schneller und effizienter abgeschlossen werden.
Dieser Leitfaden richtet sich an .NET-Entwickler, die ihre PDF-Verarbeitungsaufgaben mit IronPDF und Parallel.ForEach optimieren möchten. Grundkenntnisse in C# und Vertrautheit mit der IronPDF-Bibliothek werden empfohlen. Am Ende dieses Leitfadens werden Sie in der Lage sein, Parallelverarbeitung zu implementieren, um mehrere PDF-Aufgaben gleichzeitig zu bearbeiten und sowohl die Leistung als auch die Skalierbarkeit zu verbessern.
Einstieg
Installation von IronPDF
Um IronPDF in Ihrem Projekt zu verwenden, müssen Sie die Bibliothek über NuGet installieren.
NuGet-Paket-Installation
Um IronPDF zu installieren, führen Sie diese Schritte aus:
Öffnen Sie Ihr Projekt in Visual Studio.
Gehen Sie zu Tools → NuGet-Paket-Manager → NuGet-Pakete für die Lösung verwalten.
Suchen Sie im NuGet-Paket-Manager nach IronPDF.
Klicken Sie auf Install, um die IronPDF-Bibliothek zu Ihrem Projekt hinzuzufügen.
Alternativ können Sie es über die NuGet-Paket-Manager-Konsole installieren:
PM > Install-Package IronPdf
Install-Package IronPdf
Sobald IronPDF installiert ist, sind Sie bereit, es für die PDF-Erzeugung und -Manipulation zu verwenden.
Basic Concepts of Parallel.ForEach in C#
Parallel.ForEach ist Teil des System.Threading.Tasks-Namespace und bietet eine einfache und effektive Möglichkeit, Iterationen gleichzeitig auszuführen. Die Syntax für Parallel.ForEach lautet wie folgt:
Parallel.ForEach(collection, item =>{ // Code to process each item});
Parallel.ForEach(collection, item =>
{
    // Code to process each item
});
Parallel.ForEach(collection, Sub(item) ' Code to process each itemEnd Sub)
Parallel.ForEach(collection, Sub(item)
	' Code to process each item
End Sub)
Jedes Element in der Sammlung wird parallel verarbeitet, und das System entscheidet, wie die Arbeitslast auf die verfügbaren Threads verteilt wird. Sie können auch Optionen angeben, um den Grad der Parallelität zu steuern, wie z. B. die maximale Anzahl verwendeter Threads.
Im Vergleich dazu verarbeitet eine traditionelle foreach-Schleife jedes Element nacheinander, während die parallele Schleife mehrere Elemente gleichzeitig verarbeiten kann, wodurch die Leistung bei der Verarbeitung großer Sammlungen verbessert wird.
Schrittweise Implementierung
Einrichten des Projekts
Stellen Sie zuerst sicher, dass IronPDF installiert ist, wie im Abschnitt Erste Schritte beschrieben. Danach können Sie beginnen, Ihre parallele PDF-Verarbeitung zu schreiben.
Schreiben der Logik der Parallelverarbeitung
Code-Schnipsel: Parallel.ForEach für die Konvertierung von HTML in PDF verwenden
string[] htmlFiles = { "page1.html", "page2.html", "page3.html" };Parallel.ForEach(htmlFiles, htmlFile =>{ // Load the HTML content into IronPDF and convert it to PDF ChromePdfRenderer renderer = new ChromePdfRenderer(); PdfDocument pdf = renderer.RenderHtmlAsPdf(htmlFile); // Save the generated PDF to the output folder pdf.SaveAs($"output_{htmlFile}.pdf");});
string[] htmlFiles = { "page1.html", "page2.html", "page3.html" };
Parallel.ForEach(htmlFiles, htmlFile =>
{
    // Load the HTML content into IronPDF and convert it to PDF
    ChromePdfRenderer renderer = new ChromePdfRenderer();
    PdfDocument pdf = renderer.RenderHtmlAsPdf(htmlFile);
    // Save the generated PDF to the output folder
    pdf.SaveAs($"output_{htmlFile}.pdf");
});
Dim htmlFiles() AsString = { "page1.html", "page2.html", "page3.html" }Parallel.ForEach(htmlFiles, Sub(htmlFile) ' Load the HTML content into IronPDF and convert it to PDF Dim renderer As New ChromePdfRenderer() Dim pdf AsPdfDocument = renderer.RenderHtmlAsPdf(htmlFile) ' Save the generated PDF to the output folder pdf.SaveAs($"output_{htmlFile}.pdf")End Sub)
Dim htmlFiles() As String = { "page1.html", "page2.html", "page3.html" }
Parallel.ForEach(htmlFiles, Sub(htmlFile)
	' Load the HTML content into IronPDF and convert it to PDF
	Dim renderer As New ChromePdfRenderer()
	Dim pdf As PdfDocument = renderer.RenderHtmlAsPdf(htmlFile)
	' Save the generated PDF to the output folder
	pdf.SaveAs($"output_{htmlFile}.pdf")
End Sub)
Dieses Codebeispiel zeigt, wie mehrere HTML-Seiten parallel in PDFs umgewandelt werden können.
Behandlung von Fehlern bei der parallelen Verarbeitung
Beim Umgang mit parallelen Aufgaben ist die Fehlerbehandlung entscheidend. Verwenden Sie try-catch-Blöcke innerhalb der Parallel.ForEach-Schleife, um Ausnahmen zu verwalten.
Code Snippet: Fehlerbehandlung in parallelen PDF-Aufgaben
Parallel.ForEach(pdfFiles, pdfFile =>{ try { var pdf = IronPdf.PdfDocument.FromFile(pdfFile); string text = pdf.ExtractAllText();System.IO.File.WriteAllText($"extracted_{pdfFile}.txt", text); } catch (Exception ex) {Console.WriteLine($"Error processing {pdfFile}: {ex.Message}"); }});
Parallel.ForEach(pdfFiles, pdfFile =>
{
    try
    {
        var pdf = IronPdf.PdfDocument.FromFile(pdfFile);
        string text = pdf.ExtractAllText();
        System.IO.File.WriteAllText($"extracted_{pdfFile}.txt", text);
    }
    catch (Exception ex)
    {
        Console.WriteLine($"Error processing {pdfFile}: {ex.Message}");
    }
});
Parallel.ForEach(pdfFiles, Sub(pdfFile)Try Dim pdf = IronPdf.PdfDocument.FromFile(pdfFile) Dim text AsString = pdf.ExtractAllText()System.IO.File.WriteAllText($"extracted_{pdfFile}.txt", text)Catch ex AsExceptionConsole.WriteLine($"Error processing {pdfFile}: {ex.Message}")EndTryEnd Sub)
Parallel.ForEach(pdfFiles, Sub(pdfFile)
	Try
		Dim pdf = IronPdf.PdfDocument.FromFile(pdfFile)
		Dim text As String = pdf.ExtractAllText()
		System.IO.File.WriteAllText($"extracted_{pdfFile}.txt", text)
	Catch ex As Exception
		Console.WriteLine($"Error processing {pdfFile}: {ex.Message}")
	End Try
End Sub)
Praktische Anwendungsfälle mit vollständigen Codebeispielen
Text aus mehreren PDFs gleichzeitig extrahieren
Ein weiterer Anwendungsfall für die Parallelverarbeitung ist die Textextraktion aus mehreren PDFs. Beim Umgang mit mehreren PDF-Dateien kann die gleichzeitige Textextraktion viel Zeit sparen. Das folgende Beispiel zeigt, wie dies gemacht werden kann.
Beispiel: Parallele Textextraktion aus mehreren Dokumenten
using IronPdf;using System.Linq;using System.Threading.Tasks;class Program{ static voidMain(string[] args) { string[] pdfFiles = { "doc1.pdf", "doc2.pdf", "doc3.pdf" };Parallel.ForEach(pdfFiles, pdfFile => { var pdf = IronPdf.PdfDocument.FromFile(pdfFile); string text = pdf.ExtractText();System.IO.File.WriteAllText($"extracted_{pdfFile}.txt", text); }); }}
using IronPdf;
using System.Linq;
using System.Threading.Tasks;

class Program
{
    static void Main(string[] args)
    {
        string[] pdfFiles = { "doc1.pdf", "doc2.pdf", "doc3.pdf" };
        Parallel.ForEach(pdfFiles, pdfFile =>
        {
            var pdf = IronPdf.PdfDocument.FromFile(pdfFile);
            string text = pdf.ExtractText();
            System.IO.File.WriteAllText($"extracted_{pdfFile}.txt", text);
        });
    }
}
ImportsIronPdfImportsSystem.LinqImportsSystem.Threading.TasksFriend Class ProgramShared Sub Main(ByVal args() AsString) Dim pdfFiles() AsString = { "doc1.pdf", "doc2.pdf", "doc3.pdf" }Parallel.ForEach(pdfFiles, Sub(pdfFile) Dim pdf = IronPdf.PdfDocument.FromFile(pdfFile) Dim text AsString = pdf.ExtractText()System.IO.File.WriteAllText($"extracted_{pdfFile}.txt", text) End Sub) End SubEnd Class
Imports IronPdf
Imports System.Linq
Imports System.Threading.Tasks

Friend Class Program
	Shared Sub Main(ByVal args() As String)
		Dim pdfFiles() As String = { "doc1.pdf", "doc2.pdf", "doc3.pdf" }
		Parallel.ForEach(pdfFiles, Sub(pdfFile)
			Dim pdf = IronPdf.PdfDocument.FromFile(pdfFile)
			Dim text As String = pdf.ExtractText()
			System.IO.File.WriteAllText($"extracted_{pdfFile}.txt", text)
		End Sub)
	End Sub
End Class
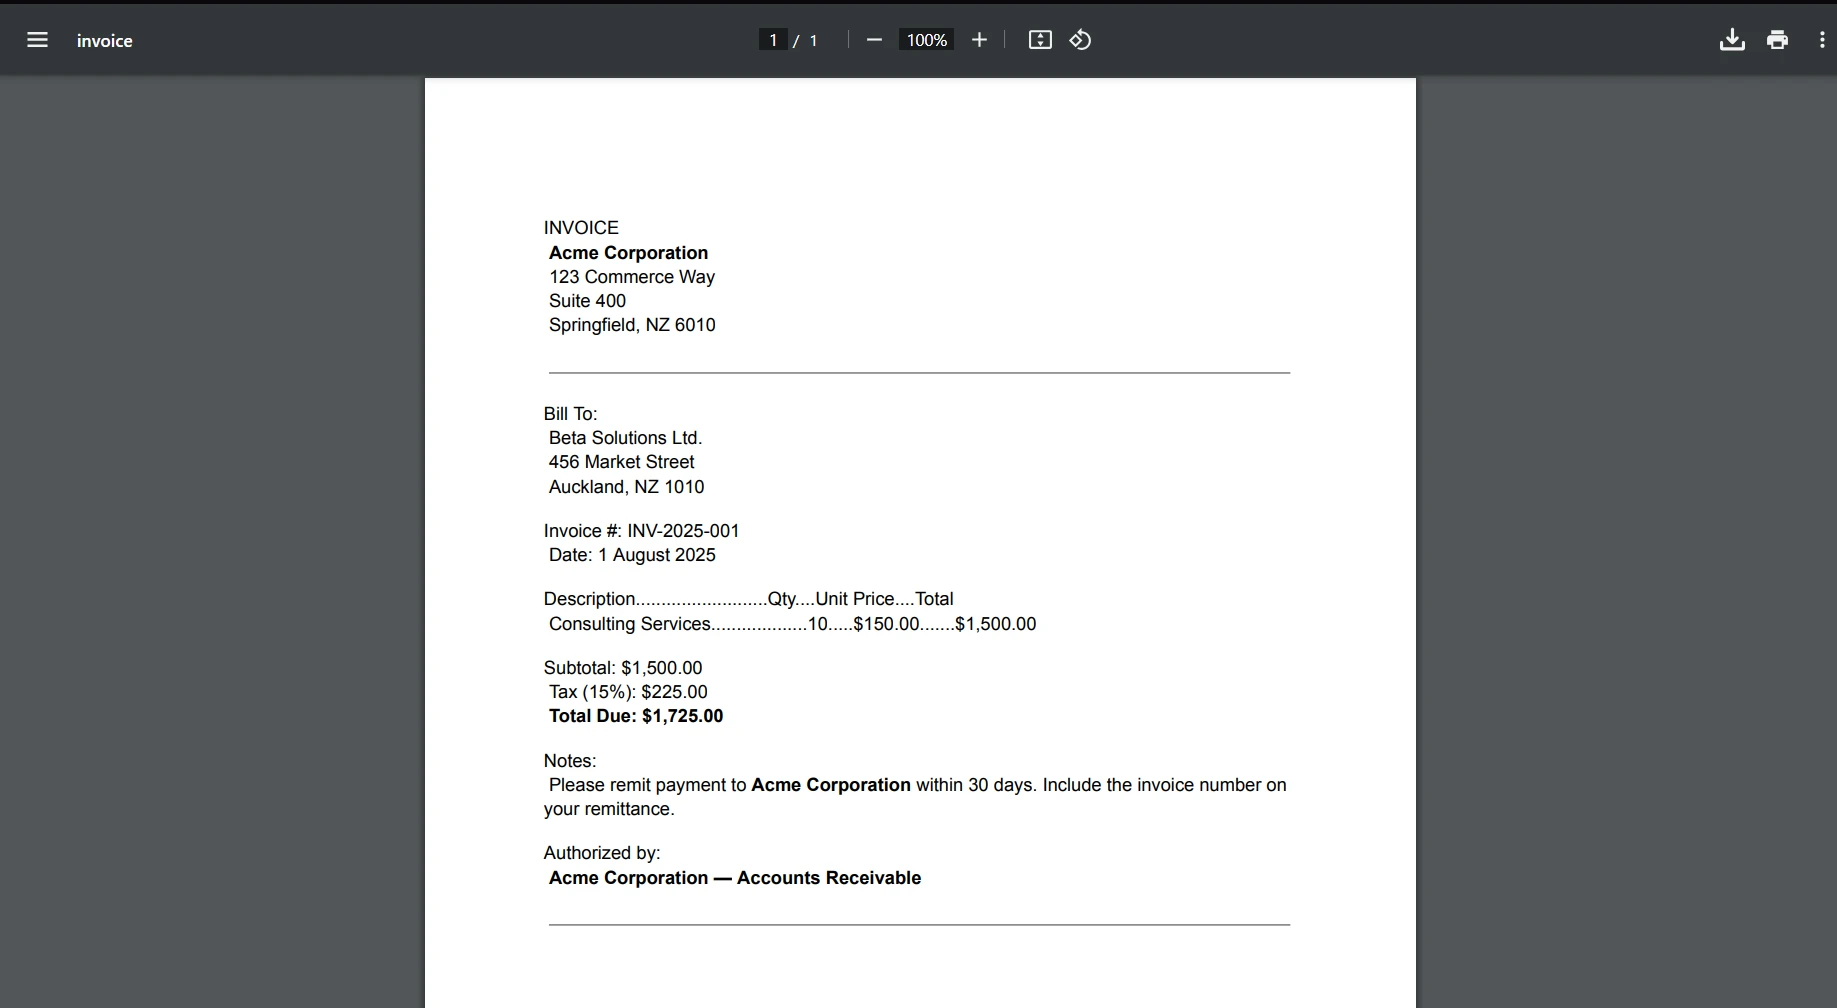
Ausgangsdokumente
In diesem Code wird jede PDF-Datei parallel verarbeitet, um Text zu extrahieren, und der extrahierte Text wird in separaten Textdateien gespeichert.
Beispiel: Parallele Stapelgenerierung von PDF-Dateien aus HTML-Dateien
In diesem Beispiel werden wir mehrere PDFs aus einer Liste von HTML-Dateien parallel erzeugen, was ein typisches Szenario sein könnte, wenn Sie mehrere dynamische HTML-Seiten in PDF-Dokumente konvertieren müssen.
Code
using IronPdf;using System;using System.Threading.Tasks;class Program{ static voidMain(string[] args) { string[] htmlFiles = { "example.html", "example_1.html", "example_2.html" };Parallel.ForEach(htmlFiles, htmlFile => { try { // Load the HTML content into IronPDF and convert it to PDF ChromePdfRenderer renderer = new ChromePdfRenderer(); PdfDocument pdf = renderer.RenderHtmlFileAsPdf(htmlFile); // Save the generated PDF to the output folder pdf.SaveAs($"output_{htmlFile}.pdf");Console.WriteLine($"PDF created for {htmlFile}"); } catch (Exception ex) {Console.WriteLine($"Error processing {htmlFile}: {ex.Message}"); } }); }}
using IronPdf;
using System;
using System.Threading.Tasks;

class Program
{
    static void Main(string[] args)
    {
        string[] htmlFiles = { "example.html", "example_1.html", "example_2.html" };
        Parallel.ForEach(htmlFiles, htmlFile =>
        {
            try
            {
                // Load the HTML content into IronPDF and convert it to PDF
                ChromePdfRenderer renderer = new ChromePdfRenderer();
                PdfDocument pdf = renderer.RenderHtmlFileAsPdf(htmlFile);
                // Save the generated PDF to the output folder
                pdf.SaveAs($"output_{htmlFile}.pdf");
                Console.WriteLine($"PDF created for {htmlFile}");
            }
            catch (Exception ex)
            {
                Console.WriteLine($"Error processing {htmlFile}: {ex.Message}");
            }
        });
    }
}
ImportsIronPdfImportsSystemImportsSystem.Threading.TasksFriend Class ProgramShared Sub Main(ByVal args() AsString) Dim htmlFiles() AsString = { "example.html", "example_1.html", "example_2.html" }Parallel.ForEach(htmlFiles, Sub(htmlFile)Try ' Load the HTML content into IronPDF and convert it to PDF Dim renderer As New ChromePdfRenderer() Dim pdf AsPdfDocument = renderer.RenderHtmlFileAsPdf(htmlFile) ' Save the generated PDF to the output folder pdf.SaveAs($"output_{htmlFile}.pdf")Console.WriteLine($"PDF created for {htmlFile}")Catch ex AsExceptionConsole.WriteLine($"Error processing {htmlFile}: {ex.Message}")EndTry End Sub) End SubEnd Class
Imports IronPdf
Imports System
Imports System.Threading.Tasks

Friend Class Program
	Shared Sub Main(ByVal args() As String)
		Dim htmlFiles() As String = { "example.html", "example_1.html", "example_2.html" }
		Parallel.ForEach(htmlFiles, Sub(htmlFile)
			Try
				' Load the HTML content into IronPDF and convert it to PDF
				Dim renderer As New ChromePdfRenderer()
				Dim pdf As PdfDocument = renderer.RenderHtmlFileAsPdf(htmlFile)
				' Save the generated PDF to the output folder
				pdf.SaveAs($"output_{htmlFile}.pdf")
				Console.WriteLine($"PDF created for {htmlFile}")
			Catch ex As Exception
				Console.WriteLine($"Error processing {htmlFile}: {ex.Message}")
			End Try
		End Sub)
	End Sub
End Class
Konsolenausgabe
PDF-Ausgabe
Erklärung
HTML-Dateien: Das Array htmlFiles enthält Pfade zu mehreren HTML-Dateien, die Sie in PDFs konvertieren möchten.
Parallelverarbeitung:
Parallel.ForEach(htmlFiles, htmlFile => {...}) verarbeitet jede HTML-Datei gleichzeitig, was den Vorgang beschleunigt, wenn Sie mit mehreren Dateien arbeiten.
Für jede Datei im htmlFiles-Array wird der Code mit renderer.RenderHtmlFileAsPdf(htmlFile); in ein PDF konvertiert.
Speichern des PDFs: Nach der Generierung des PDFs wird es mit der pdf.SaveAs-Methode gespeichert, wobei der Ausgabedateiname mit dem Originalnamen der HTML-Datei ergänzt wird.
Fehlerbehandlung: Wenn ein Fehler auftritt (z. B. wenn die HTML-Datei nicht existiert oder ein Problem bei der Konvertierung auftritt), wird er vom try-catch-Block abgefangen, und eine Fehlermeldung wird für die betreffende Datei ausgegeben.
Leistungstipps und bewährte Praktiken
Thread-Sicherheitsprobleme mit IronPDF vermeiden
IronPDF ist für die meisten Vorgänge threadsicher. Einige Operationen wie das gleichzeitige Schreiben in dieselbe Datei können jedoch Probleme verursachen. Stellen Sie immer sicher, dass jede parallele Aufgabe auf eine separate Ausgabedatei oder Ressource zugreift.
Optimierung der parallelen Verarbeitung für große Datenmengen
Um die Leistung zu optimieren, sollten Sie den Grad der Parallelität steuern. Bei großen Datensätzen möchten Sie möglicherweise die Anzahl der gleichzeitigen Threads begrenzen, um eine Systemüberlastung zu verhindern.
var options = new ExecutionDataflowBlockOptions{MaxDegreeOfParallelism = 4};
var options = new ExecutionDataflowBlockOptions
{
    MaxDegreeOfParallelism = 4
};
Dim options = New ExecutionDataflowBlockOptionsWith {.MaxDegreeOfParallelism = 4}
Dim options = New ExecutionDataflowBlockOptions With {.MaxDegreeOfParallelism = 4}
Speichermanagement bei parallelen PDF-Operationen
Bei der Verarbeitung einer großen Anzahl von PDFs sollten Sie auf die Speichernutzung achten. Versuchen Sie, Ressourcen wie PdfDocument-Objekte freizugeben, sobald sie nicht mehr benötigt werden.
Verwendung von Erweiterungsmethoden
Eine Erweiterungsmethode ist eine besondere Art von statischer Methode, die es Ihnen ermöglicht, einem vorhandenen Typ neue Funktionalitäten hinzuzufügen, ohne dessen Quellcode zu ändern. Dies kann nützlich sein, wenn Sie mit Bibliotheken wie IronPDF arbeiten, bei denen Sie möglicherweise benutzerdefinierte Verarbeitungsmethoden hinzufügen oder deren Funktionalität erweitern möchten, um die Arbeit mit PDFs bequemer zu machen, insbesondere in parallelen Verarbeitungsszenarien.
Vorteile der Verwendung von Erweiterungsmethoden in der Parallelverarbeitung
Mit Erweiterungsmethoden können Sie prägnanten, wiederverwendbaren Code erstellen, der die Logik in parallelen Schleifen vereinfacht. Dieser Ansatz reduziert nicht nur die Duplizierung, sondern hilft Ihnen auch dabei, eine saubere Codebasis zu pflegen, insbesondere bei der Arbeit mit komplexen PDF-Arbeitsabläufen und Datenparallelitäten.
Abschluss
Die Verwendung von parallelen Schleifen wie Parallel.ForEach mit IronPDF bietet erhebliche Leistungssteigerungen bei der Verarbeitung großer Mengen von PDFs. Ob Sie HTML in PDFs konvertieren, Text extrahieren oder Dokumente manipulieren, Datenparallelität ermöglicht eine schnellere Ausführung, indem Aufgaben gleichzeitig ausgeführt werden. Der parallele Ansatz stellt sicher, dass Operationen über mehrere Kernprozessoren ausgeführt werden können, was die gesamte Ausführungszeit verkürzt und die Leistung bei Batch-Processing-Aufgaben verbessert.
Während die Parallelverarbeitung Aufgaben beschleunigt, achten Sie auf Threadsicherheit und Ressourcenmanagement. IronPDF ist für die meisten Vorgänge threadsicher, aber es ist wichtig, potenzielle Konflikte beim Zugriff auf gemeinsame Ressourcen zu behandeln. Berücksichtigen Sie Fehlerbehandlung und Speicherverwaltung, um Stabilität sicherzustellen, insbesondere wenn Ihre Anwendung skaliert.
Wenn Sie bereit sind, tiefer in IronPDF einzusteigen und fortgeschrittene Funktionen zu erkunden, bietet die offizielle Dokumentation umfangreiche Informationen. Außerdem können Sie von deren Testlizenz profitieren, die es Ihnen ermöglicht, die Bibliothek in Ihren eigenen Projekten zu testen, bevor Sie einen Kauf tätigen.
Jacob Mellor ist Chief Technology Officer bei Iron Software und ein visionärer Ingenieur, der Pionierarbeit in der C# PDF-Technologie leistet. Als der ursprüngliche Entwickler hinter der Kern-Codebasis von Iron Software hat er die Produktarchitektur des Unternehmens seit seiner Gründung geprägt und es zusammen mit CEO Cameron Rimington in ein Unternehmen mit mehr als 50 Mitarbeitern verwandelt, das die NASA, Tesla und globale Regierungsbehörden beliefert.