
Eingebetteten Text und Bilder aus PDFs in C# extrahieren

Extrahieren Sie sowohl Textinhalte als auch Bilder aus PDF-Dokumenten in C# mit einfachen Methodenaufrufen. Abrufen von eingebetteten Inhalten zur Bearbeitung, Analyse oder Wiederverwendung in anderen Anwendungen.
Ihr Unternehmen gibt zu viel für jährliche Abonnements für PDF-Sicherheit und Konformität aus. Erwägen Sie IronSecureDoc, das Lösungen für die Verwaltung von SaaS-Diensten wie digitale Signatur, Schwärzung, Verschlüsselung und Schutz bietet - alles mit einer einmaligen Zahlung. Entdecken Sie die IronSecureDoc-Dokumentation
Bei der Text- und Bildextraktion werden Textinhalte und grafische Elemente aus PDF-Dokumenten extrahiert. Zugriff und Wiederverwendung von Inhalten zum Bearbeiten, Suchen, Konvertieren von Text in andere Formate oder Speichern von Bildern zur Wiederverwendung. Ob Sie PDFs in C# parsen für Datenanalyse, Inhalte in durchsuchbare Formate konvertieren oder visuelle Elemente für die Archivierung extrahieren müssen, IronPDF bietet umfassende Extraktionstools.
Extrahieren Sie Text und Bilder mit IronPDF. Speichern Sie die extrahierten Bilder auf der Festplatte oder konvertieren Sie sie in ein anderes Format, bevor Sie sie in neue Dokumente einbetten. Diese Flexibilität unterstützt Workflows, die eine Inhaltsumwandlung erfordern, wie zum Beispiel PDFs in HTML konvertieren oder extrahierte Bilder neu verwenden.
Schnellstart: Text und Bilder mit IronPDF extrahierenExtrahieren von Text und Bildern aus PDFs in nur wenigen Codezeilen. Dieser Quickstart demonstriert, wie eingebettete Inhalte aus PDF-Dokumenten für die Wiederverwendung und Analyse von Inhalten abgerufen werden können. Extrahieren Sie Text zur Bearbeitung oder speichern Sie Bilder zur weiteren Verwendung mit der effizienten Lösung von IronPDF.
-
1Installieren Sie IronPDF mit NuGet Package Manager
-
2Kopieren Sie diesen Codeausschnitt und führen Sie ihn aus.
var pdf = new IronPdf.PdfDocument("sample.pdf"); string text = pdf.ExtractAllText(); var images = pdf.ExtractAllImages();Dim pdf = New IronPdf.PdfDocument("sample.pdf") Dim text As String = pdf.ExtractAllText() Dim images = pdf.ExtractAllImages()Dim pdf = New IronPdf.PdfDocument("sample.pdf") Dim text As String = pdf.ExtractAllText() Dim images = pdf.ExtractAllImages() -
3Bereitstellen zum Testen in Ihrer Live-Umgebung
Beginnen Sie noch heute, IronPDF in Ihrem Projekt mit einer kostenlosen Testversion zu verwenden
Minimaler Arbeitsablauf (5 Schritte)
- Laden Sie die
IronPdfC#-Bibliothek herunter - Bereiten Sie das PDF-Dokument für die Text- und Bilderextraktion vor
- Verwenden Sie die Methode
ExtractAllText, um Text zu extrahieren - Verwenden Sie die Methode
ExtractAllImages, um Bilder zu extrahieren - Wählen Sie die bestimmten Seiten aus, von denen Sie Text und Bilder extrahieren möchten
Wie kann ich Text aus PDFs extrahieren?
Extrahieren von Text sowohl aus neu gerenderten als auch aus bestehenden PDF-Dokumenten. Verwenden Sie die Methode ExtractAllText, um eingebetteten Text aus dem Dokument zu extrahieren. Die Methode gibt eine Zeichenkette zurück, die den gesamten Text in der PDF-Datei enthält. Die Seiten werden durch vier aufeinanderfolgende Zeilenumbrüche getrennt. Dieses Beispiel verwendet ein Beispiel-PDF, das von der Wikipedia-Website gerendert wurde.
Beim Arbeiten mit PDFs, die internationale Sprachen und UTF-8-Zeichen enthalten, erhält IronPDF die korrekte Kodierung und Zeichendarstellung aufrecht. Dies gewährleistet die korrekte Darstellung von nicht-lateinischen Schriftzeichen und Sonderzeichen.
Eingabe
Eine Musterrechnung-PDF.
using IronPdf;
using System.IO;

PdfDocument pdf = PdfDocument.FromFile("sample.pdf");

// Extract text
string text = pdf.ExtractAllText();

// Export the extracted text to a text file
File.WriteAllText("extractedText.txt", text);
using IronPdf;
using System.IO;
PdfDocument pdf = PdfDocument.FromFile("sample.pdf");
// Extract text
string text = pdf.ExtractAllText();
// Export the extracted text to a text file
File.WriteAllText("extractedText.txt", text);Imports IronPdf
Imports System.IO
Private pdf As PdfDocument = PdfDocument.FromFile("sample.pdf")
' Extract text
Private text As String = pdf.ExtractAllText()
' Export the extracted text to a text file
File.WriteAllText("extractedText.txt", text)Imports IronPdf
Imports System.IO
Private pdf As PdfDocument = PdfDocument.FromFile("sample.pdf")
' Extract text
Private text As String = pdf.ExtractAllText()
' Export the extracted text to a text file
File.WriteAllText("extractedText.txt", text)Ausgabe
Das Ausführen von ExtractAllText gibt den Seitentext in Leserichtung zurück:
Invoice INV-2026-0042
Billed to: Northwind Traders
Date: 2026-02-14
Consulting $3,200.00
Support $800.00
Total: $4,000.00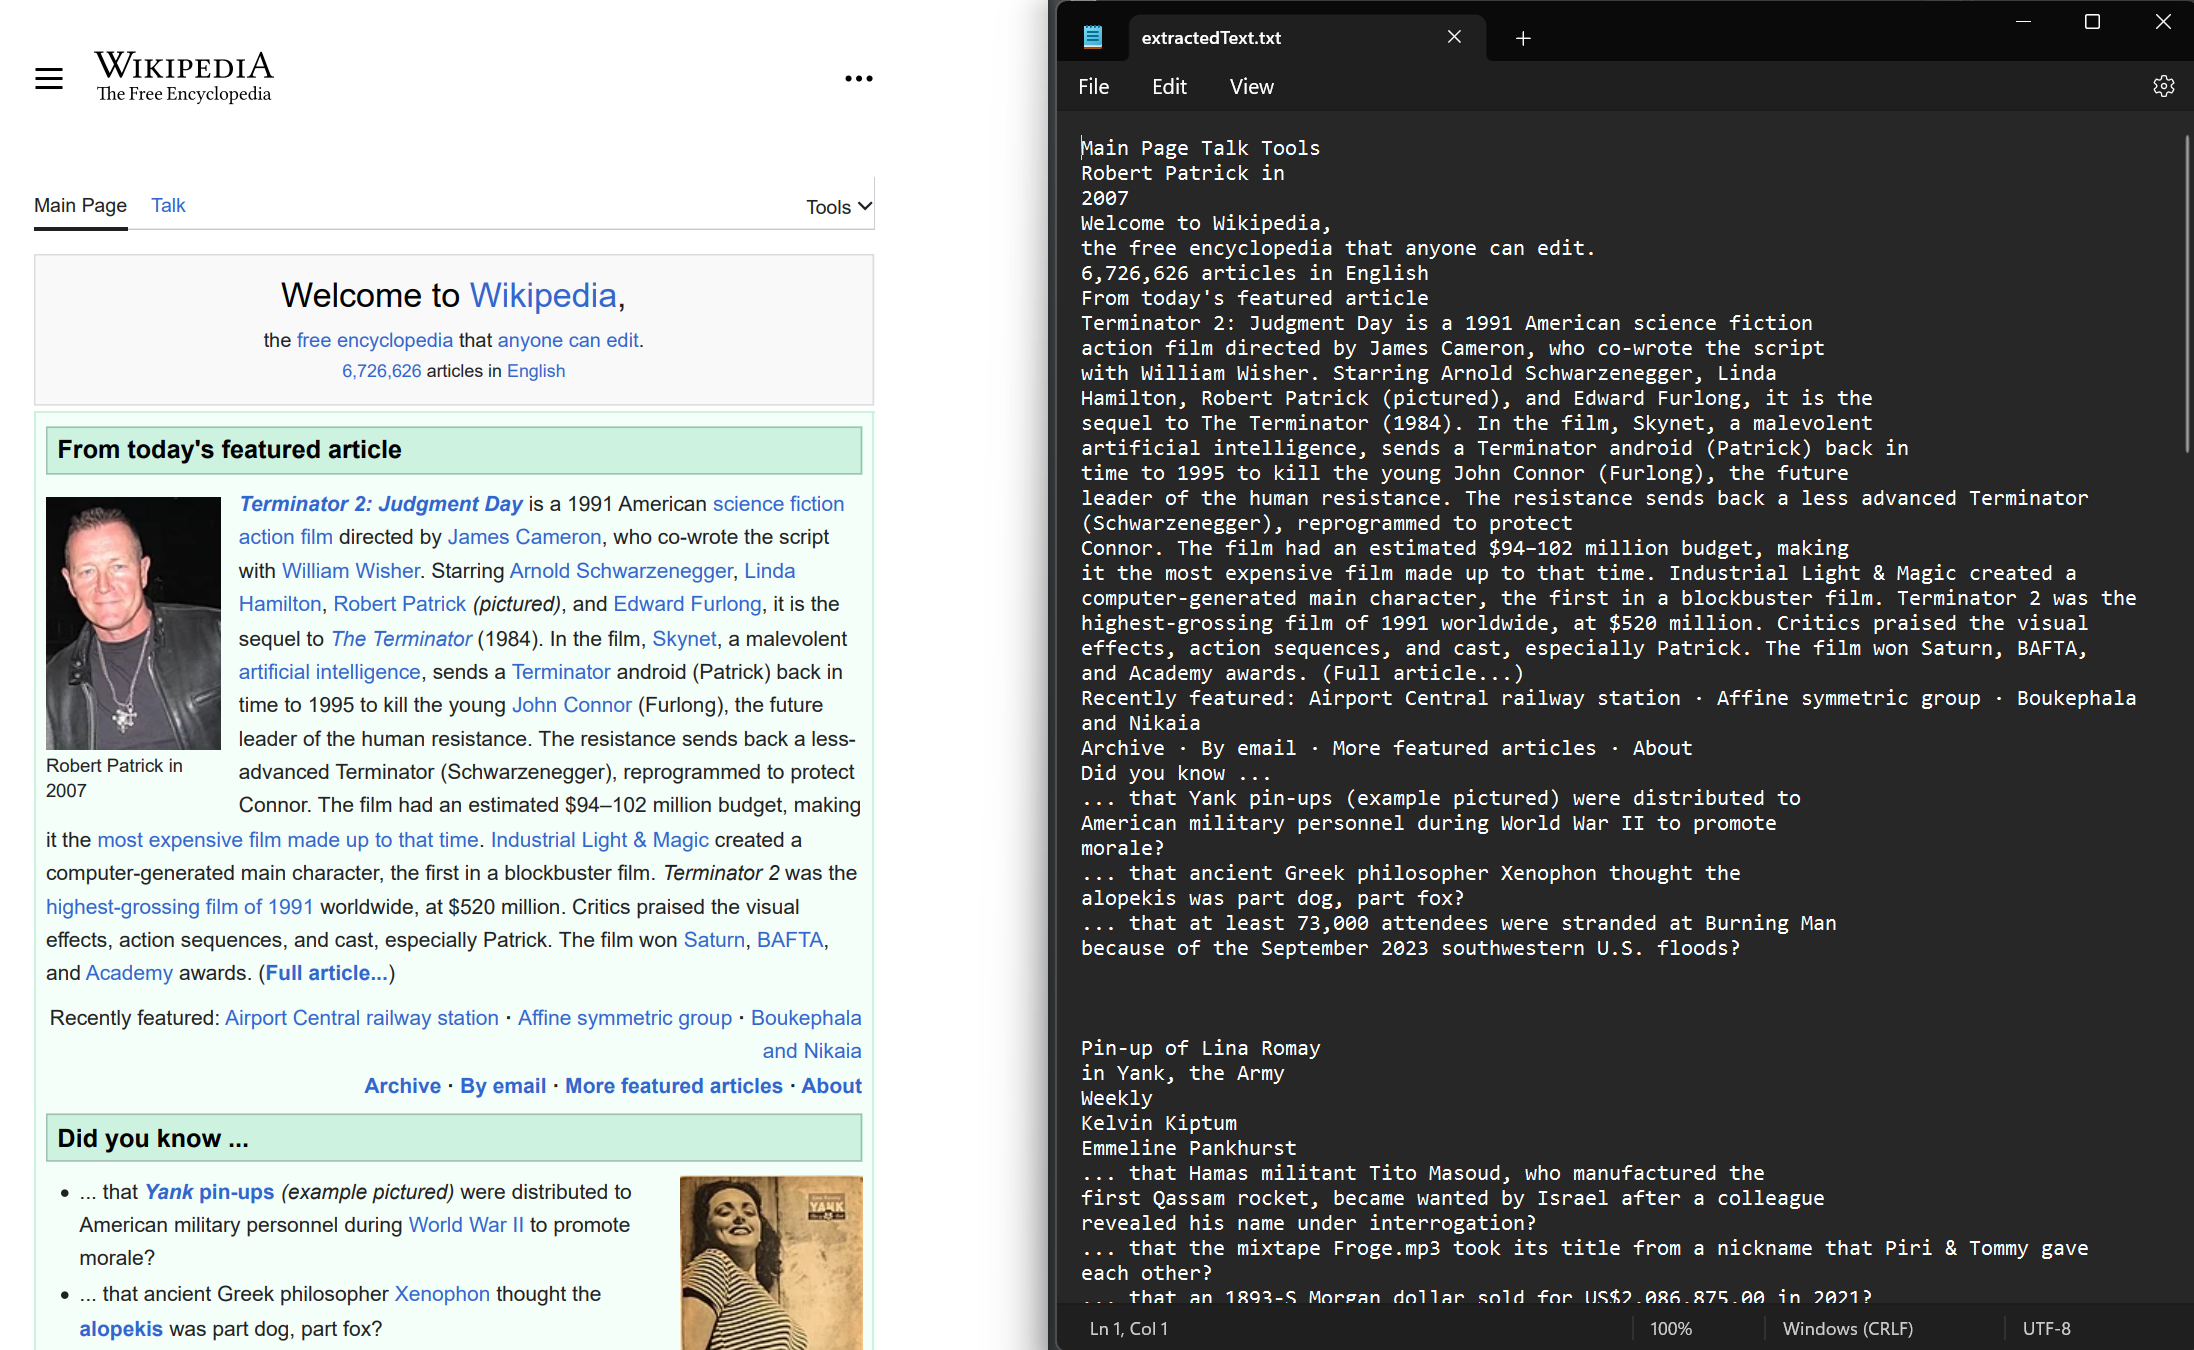
Wie kann ich Text mit präzisen Koordinaten extrahieren?
Abrufen der Koordinaten von Textzeilen und Zeichen innerhalb jeder PDF-Seite. Wählen Sie eine Seite aus dem PDF aus und greifen Sie auf die Eigenschaften Lines und Characters zu. Die Koordinaten umfassen die Werte Top, Right, Bottom und Left, die die Textposition darstellen. Diese Funktion bewahrt das räumliche Layout und ermöglicht die Analyse der Textposition.
Für Entwickler, die PDF-Dateien in C# lesen müssen, ist die Koordinatenextraktion hilfreich, um die Dokumentstruktur aufrechtzuerhalten und eine erweiterte Textanalyse zu implementieren.
using IronPdf;
using System.IO;
using System.Linq;

// Open PDF from file
PdfDocument pdf = PdfDocument.FromFile("sample.pdf");

// Extract text by lines
var lines = pdf.Pages[0].Lines;

// Extract text by characters
var characters = pdf.Pages[0].Characters;

File.WriteAllLines("lines.txt", lines.Select(l => $"at Y={l.BoundingBox.Bottom:F2}: {l.Contents}"));
using IronPdf;
using System.IO;
using System.Linq;
// Open PDF from file
PdfDocument pdf = PdfDocument.FromFile("sample.pdf");
// Extract text by lines
var lines = pdf.Pages[0].Lines;
// Extract text by characters
var characters = pdf.Pages[0].Characters;
File.WriteAllLines("lines.txt", lines.Select(l => $"at Y={l.BoundingBox.Bottom:F2}: {l.Contents}"));Imports IronPdf
Imports System.IO
Imports System.Linq
' Open PDF from file
Private pdf As PdfDocument = PdfDocument.FromFile("sample.pdf")
' Extract text by lines
Private lines = pdf.Pages(0).Lines
' Extract text by characters
Private characters = pdf.Pages(0).Characters
File.WriteAllLines("lines.txt", lines.Select(Function(l) $"at Y={l.BoundingBox.Bottom:F2}: {l.Contents}"))Imports IronPdf
Imports System.IO
Imports System.Linq
' Open PDF from file
Private pdf As PdfDocument = PdfDocument.FromFile("sample.pdf")
' Extract text by lines
Private lines = pdf.Pages(0).Lines
' Extract text by characters
Private characters = pdf.Pages(0).Characters
File.WriteAllLines("lines.txt", lines.Select(Function(l) $"at Y={l.BoundingBox.Bottom:F2}: {l.Contents}"))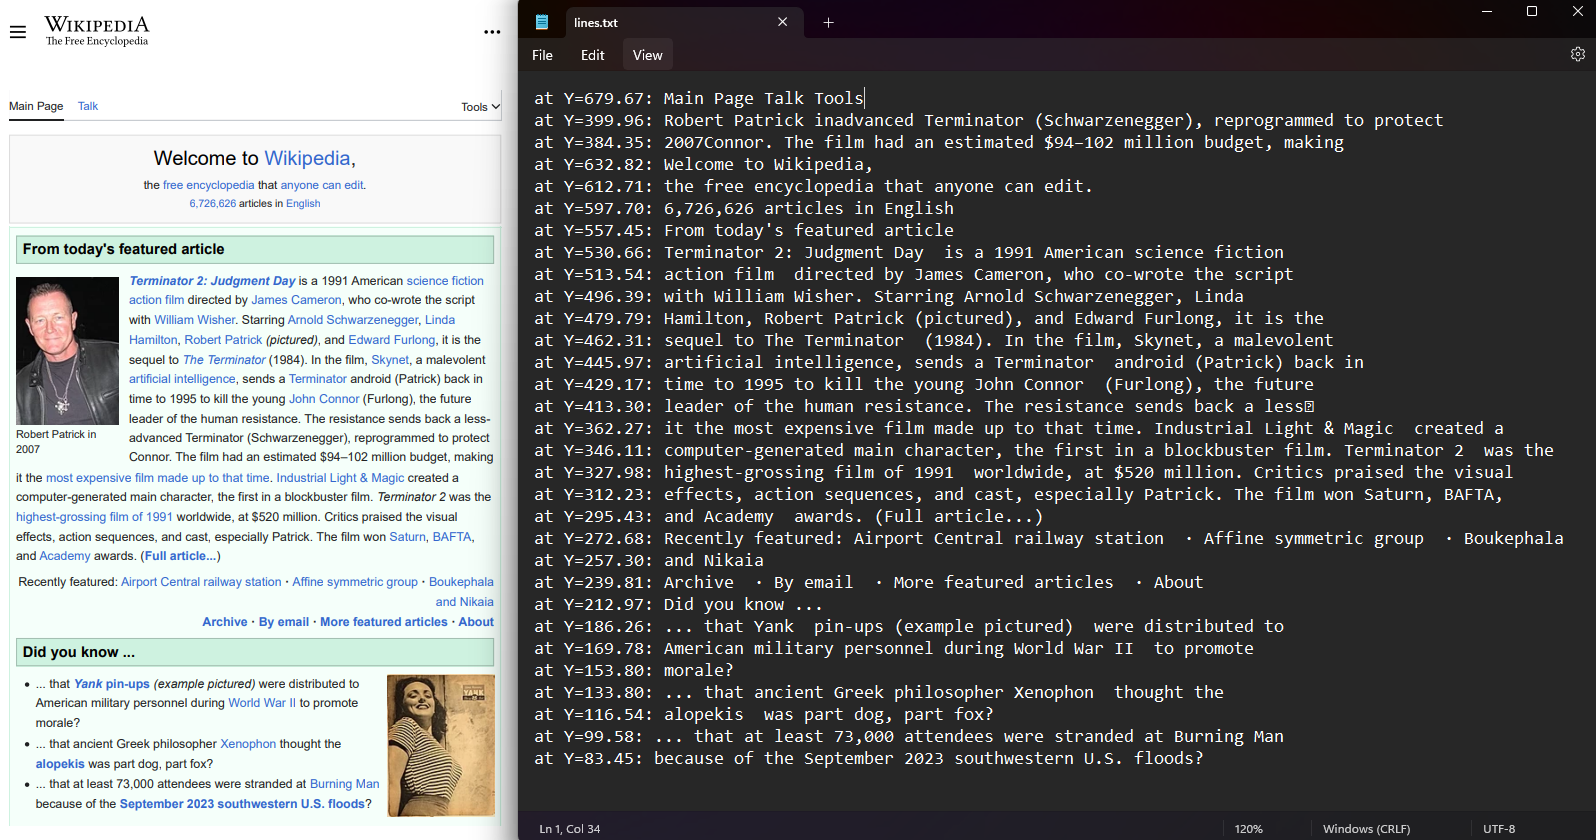
Wie kann ich Bilder aus PDFs extrahieren?
Verwenden Sie die Methode ExtractAllImages, um alle eingebetteten Bilder aus dem Dokument zu extrahieren. Die Methode gibt Bilder als Liste von List von AnyBitmap-Objekten zurück. Aus demselben Dokument haben wir Bilder extrahiert und in den Ordner "images" exportiert. Diese Funktion unterstützt die Bildarchivierung, Inhaltsmigration und das Rasterisieren von PDF-Seiten zu Bildern zur weiteren Verarbeitung.
Extrahierte Bilder behalten die ursprüngliche Qualität bei und können in verschiedenen Formaten gespeichert werden, einschließlich PNG, JPEG und BMP. Für Cloud-Storage-Workflows integrieren Sie diese Funktionalität mit Azure Blob Storage für das Bildmanagement.
using IronPdf;

PdfDocument pdf = PdfDocument.FromFile("sample.pdf");

// Extract images
var images = pdf.ExtractAllImages();

for(int i = 0; i < images.Count; i++)
{
    // Export the extracted images
    images[i].SaveAs($"images/image{i}.png");
}
using IronPdf;
PdfDocument pdf = PdfDocument.FromFile("sample.pdf");
// Extract images
var images = pdf.ExtractAllImages();
for(int i = 0; i < images.Count; i++)
{
// Export the extracted images
images[i].SaveAs($"images/image{i}.png");
}Imports IronPdf
Private pdf As PdfDocument = PdfDocument.FromFile("sample.pdf")
' Extract images
Private images = pdf.ExtractAllImages()
For i As Integer = 0 To images.Count - 1
' Export the extracted images
images(i).SaveAs($"images/image{i}.png")
Next iImports IronPdf
Private pdf As PdfDocument = PdfDocument.FromFile("sample.pdf")
' Extract images
Private images = pdf.ExtractAllImages()
For i As Integer = 0 To images.Count - 1
' Export the extracted images
images(i).SaveAs($"images/image{i}.png")
Next i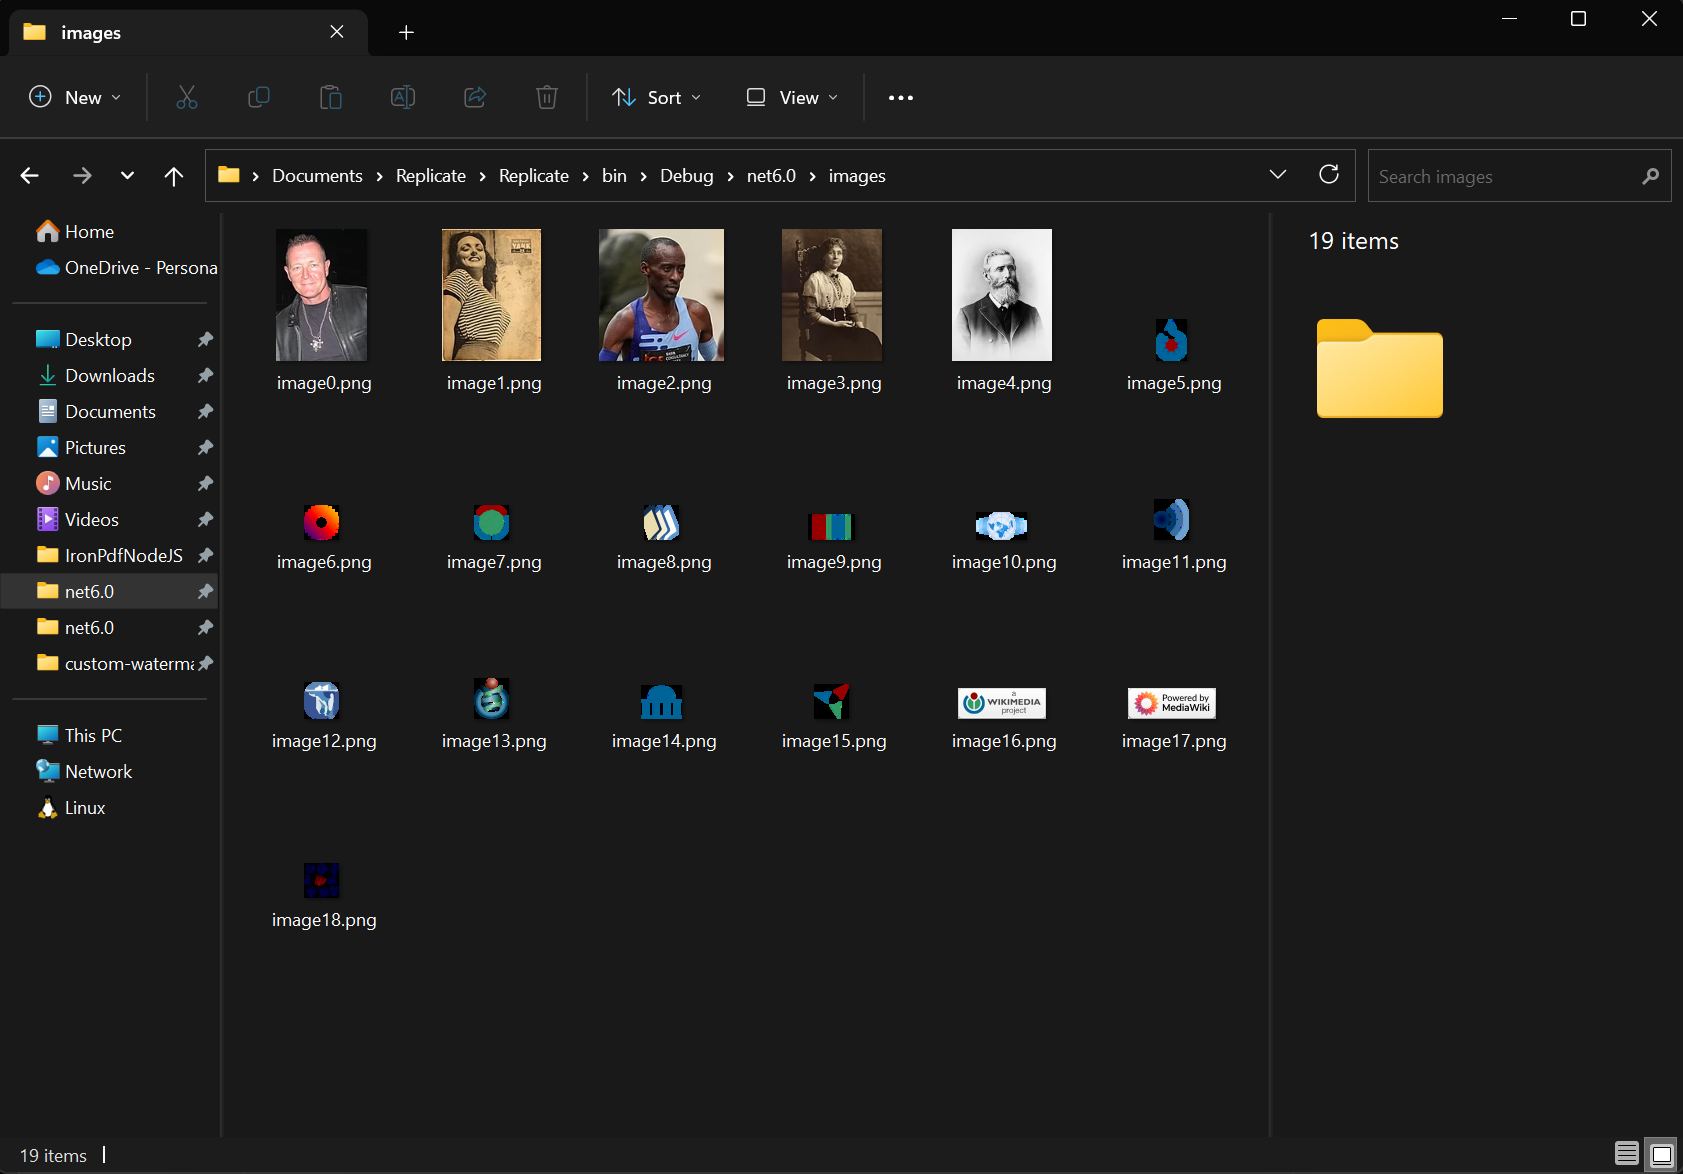
Was sind die verschiedenen Methoden zur Bildextraktion?
Neben der Methode ExtractAllImages verwenden Sie die Methoden ExtractAllBitmaps und ExtractAllRawImages, um Bildinformationen zu extrahieren. Während ExtractAllBitmaps eine List von AnyBitmap zurückgibt, extrahiert ExtractAllRawImages alle Bilder und gibt sie als rohe byte[] (byte[]) zurück.
Die Methode ExtractAllRawImages funktioniert gut, wenn Bilddaten im Speicher verarbeitet oder in Systeme integriert werden, die Byte-Array-Eingaben erfordern. Für Szenarien, die PDFs zu Memory-Streams exportieren umfassen, bietet das Format des rohen Byte-Arrays optimale Flexibilität.

Meine Lieblingsbibliothek dieser Art ist IronPDF. Es ermöglicht eine schnelle und effiziente Bearbeitung von PDF-Dateien. Es verfügt auch über viele wertvolle Funktionen, wie das Exportieren in das PDF/A-Format und das digitale Signieren von PDF-Dokumenten.

IronOCR bedeutet, dass wir jährlich 40.000 $ durch manuelle Verarbeitung einsparen können, während die Produktivität gesteigert wird und Ressourcen für wichtige Aufgaben freigesetzt werden. Ich würde es sehr empfehlen.

Wie extrahiere ich Inhalte aus bestimmten PDF-Seiten?
Extrahieren von Text und Bildern aus einzelnen oder mehreren angegebenen Seiten. Verwenden Sie die Methoden ExtractTextFromPage und ExtractTextFromPages für die Textextraktion aus einer oder mehreren Seiten. Für Bilder verwenden Sie die Methoden ExtractImagesFromPage und ExtractImagesFromPages.
Diese granulare Kontrolle hilft bei der Arbeit mit umfangreichen Dokumenten, bei denen nur bestimmte Abschnitte relevante Inhalte enthalten. Es unterstützt auch Funktionen zum Teilen von PDFs und Extrahieren einzelner Seiten zur separaten Verarbeitung. ExtractImagesFromPage gibt Bilder in derselben Reihenfolge zurück, in der SetImageAltText sie adressiert, sodass es auch der Weg ist, um den Index eines Bildes zu finden, das Sie für Barrierefreiheit beschreiben möchten.
Eingabe
Ein dreiseitiges Beispiel-PDF, jede Seite enthält unterschiedlichen Text.
using IronPdf;

PdfDocument pdf = PdfDocument.FromFile("sample.pdf");

// Extract text from page 1
string textFromPage1 = pdf.ExtractTextFromPage(0);

int[] pages = new[] { 0, 2 };

// Extract text from pages 1 & 3
string textFromPage1_3 = pdf.ExtractTextFromPages(pages);
using IronPdf;
PdfDocument pdf = PdfDocument.FromFile("sample.pdf");
// Extract text from page 1
string textFromPage1 = pdf.ExtractTextFromPage(0);
int[] pages = new[] { 0, 2 };
// Extract text from pages 1 & 3
string textFromPage1_3 = pdf.ExtractTextFromPages(pages);Imports IronPdf
Private pdf As PdfDocument = PdfDocument.FromFile("sample.pdf")
' Extract text from page 1
Private textFromPage1 As String = pdf.ExtractTextFromPage(0)
Private pages() As Integer = { 0, 2 }
' Extract text from pages 1 & 3
Private textFromPage1_3 As String = pdf.ExtractTextFromPages(pages)Imports IronPdf
Private pdf As PdfDocument = PdfDocument.FromFile("sample.pdf")
' Extract text from page 1
Private textFromPage1 As String = pdf.ExtractTextFromPage(0)
Private pages() As Integer = { 0, 2 }
' Extract text from pages 1 & 3
Private textFromPage1_3 As String = pdf.ExtractTextFromPages(pages)Ausgabe
ExtractTextFromPage(0) gibt den Text von Seite 1 zurück:
Page 1 - Executive Summary
Revenue rose 12 percent this quarter.ExtractTextFromPages(new[] { 0, 2 }) gibt die Seiten 1 und 3 kombiniert zurück:
Page 1 - Executive Summary
Revenue rose 12 percent this quarter.
Page 3 - Appendix
Regional breakdown and footnotes.Wann sollte ich von bestimmten Seiten statt von allen Seiten extrahieren?
Auszug aus bestimmten Seiten, wenn:
- Arbeiten mit großen PDFs, die in bestimmten Abschnitten relevante Daten enthalten
- Implementierung von Workflows, die Seiten unabhängig behandeln
- Erstellen von Anwendungen, die inkrementelle Inhalt darstellung oder Verarbeitung erfordern
- Optimierung der Speichernutzung durch Verarbeitung nur erforderlicher Seiten
- Erstellen von seitenbezogenen Such- oder Indizierungsfunktionen
Welche Leistungsaspekte sollte ich kennen?
Berücksichtigen Sie diese Leistungsfaktoren bei der Extraktion von PDF-Inhalten:
- Speichernutzung: Extrahieren Sie Seiten einzeln aus großen Dokumenten, um den Speicherverbrauch zu minimieren
- Verarbeitungszeit: Verwenden Sie parallele Verarbeitung für Mehrseitenextraktionen, wenn angebracht
- Dateigröße: Größere PDFs mit hochauflösenden Bildern erfordern mehr Verarbeitungszeit
- Speicherung: Planen Sie ausreichenden Festplattenspeicher für die Extraktion zahlreicher hochauflösender Bilder ein
- Threading: IronPDF unterstützt Multithreading-Operationen für verbesserte Leistung auf Mehrkernsystemen
Für optimale Leistung mit im Speicher befindlichen PDFs verwenden Sie Memory-Stream-Operationen, um den Festplatten-I/O-Overhead zu reduzieren.
Wie extrahiere ich Text aus einer bestimmten Ebene (OCG)?
Geschichtete PDFs wie CAD-Zeichnungen und Kartenausgaben gruppieren ihren Inhalt in benannte Ebenen, bekannt als Optionale Inhaltsgruppen. Wenn Sie nur den Text von einer von ihnen möchten (der Haftungsausschluss in einer "Titelblock"-Ebene oder jedes Label auf einer "Road - Major"-Ebene), rufen Sie ExtractTextFromLayer mit dem Ebenennamen oder der ID auf. Übergeben Sie mehrere Namen an ExtractTextFromLayers, um sie in einem einzigen Aufruf zu verketten. Um die Ebene-Objekte selbst zu erreichen, gibt GetTextObjectsByLayer die TextObjects für eine gegebene Ebene zurück.
using IronPdf;

// Load a layered PDF, for example a map export with named layers
using PdfDocument pdf = new PdfDocument("architect-plan.pdf");

// Extract the text of a single layer as one string, in reading order.
// Layer names are case-sensitive.
string titleBlock = pdf.ExtractTextFromLayer("Title Block");

// Combine the text of several layers in one call.
// Unknown names are skipped, so this never throws.
string roads = pdf.ExtractTextFromLayers(new[] { "Road - Major", "Road - Highway", "Labels" });
using IronPdf;
// Load a layered PDF, for example a map export with named layers
using PdfDocument pdf = new PdfDocument("architect-plan.pdf");
// Extract the text of a single layer as one string, in reading order.
// Layer names are case-sensitive.
string titleBlock = pdf.ExtractTextFromLayer("Title Block");
// Combine the text of several layers in one call.
// Unknown names are skipped, so this never throws.
string roads = pdf.ExtractTextFromLayers(new[] { "Road - Major", "Road - Highway", "Labels" });Imports IronPdf
' Load a layered PDF, for example a map export with named layers
Using pdf As New PdfDocument("architect-plan.pdf")
' Extract the text of a single layer as one string, in reading order.
' Layer names are case-sensitive.
Dim titleBlock As String = pdf.ExtractTextFromLayer("Title Block")
' Combine the text of several layers in one call.
' Unknown names are skipped, so this never throws.
Dim roads As String = pdf.ExtractTextFromLayers(New String() {"Road - Major", "Road - Highway", "Labels"})
End UsingImports IronPdf
' Load a layered PDF, for example a map export with named layers
Using pdf As New PdfDocument("architect-plan.pdf")
' Extract the text of a single layer as one string, in reading order.
' Layer names are case-sensitive.
Dim titleBlock As String = pdf.ExtractTextFromLayer("Title Block")
' Combine the text of several layers in one call.
' Unknown names are skipped, so this never throws.
Dim roads As String = pdf.ExtractTextFromLayers(New String() {"Road - Major", "Road - Highway", "Labels"})
End Using"Title Block" und "title block" unterschiedliche Ebenen. Unbekannte Namen, schlechte IDs und leere Eingaben geben eine leere Zeichenkette zurück, anstatt einen Fehler auszulösen, und ein PDF ohne Ebenen liefert einfach keinen Text. Um zuerst den vollständigen Ebenenbaum zu durchsuchen, sehen Sie sich den Zugriff auf PDF-DOM-Objekte an.Häufig gestellte Fragen
Wie kann ich Text aus einem PDF mit C# extrahieren?
Sie können Text aus einem PDF in C# mit der IronPDF-Bibliothek extrahieren, indem Sie die ExtractAllText-Methode auf einem PdfDocument-Objekt aufrufen. Diese Methode ruft allen eingebetteten Text aus dem Dokument ab und gibt ihn als Zeichenkette zurück.
Welche Methoden bietet IronPDF zum Extrahieren von Bildern aus einem PDF?
IronPDF bietet mehrere Methoden zum Bildextrahieren, einschließlich ExtractAllImages, ExtractAllBitmaps und ExtractAllRawImages. Diese Methoden erlauben es Ihnen, Bilder als AnyBitmap-Objekte oder rohe Byte-Arrays zu extrahieren, je nach Ihren Bedürfnissen.
Kann ich mit IronPDF Inhalte aus bestimmten Seiten eines PDFs extrahieren?
Ja, IronPDF erlaubt es Ihnen, Inhalte aus bestimmten PDF-Seiten zu extrahieren, indem Sie die Methoden ExtractTextFromPage, ExtractTextFromPages, ExtractImagesFromPage und ExtractImagesFromPages verwenden, womit Sie die Kontrolle darüber haben, welche Teile des Dokuments verarbeitet werden sollen.
Wie geht IronPDF mit der Textextraktion mit präzisen Koordinaten um?
IronPDF kann Text mit präzisen Koordinaten extrahieren, indem es die Eigenschaften Lines und Characters einer Seite nutzt, die Positionsdaten wie Top, Right, Bottom und Left bereitstellen, ideal zur Beibehaltung des Layouts und Durchführung von Textpositionsanalysen.
Was sind die Leistungsüberlegungen beim Extrahieren von PDF-Inhalten mit IronPDF?
Leistungsüberlegungen schließen Speicherverbrauch, Verarbeitungszeit, Dateigröße, Speicheranforderungen und die Verwendung von Multithreading-Operationen ein. Das Extrahieren von Inhalten aus bestimmten Seiten und die Anwendung von Memory-Stream-Operationen können diese Aspekte optimieren.
Wie kann IronPDF bei der Textextraktion aus PDFs helfen, die internationale Sprachen enthalten?
IronPDF behält eine korrekte Codierung und Zeichenrepräsentation für internationale Sprachen und UTF-8-Zeichen bei, um eine richtige Textextraktion und Anzeige für nicht-lateinische Schriften und Sonderzeichen zu gewährleisten.
Ist es möglich, Bilder aus einem PDF für die Verwendung in Azure Blob Storage mit IronPDF zu extrahieren?
Ja, die Bildextraktionsfunktionen von IronPDF sind mit Azure Blob Storage-Workflows kompatibel, wodurch Sie extrahierte Bilder in verschiedenen Formaten speichern und sie effektiv in der Cloud verwalten können.
Unterstützt IronPDF die Textextraktion aus bestimmten Ebenen innerhalb eines PDFs?
Ja, IronPDF kann Text aus bestimmten Ebenen (OCGs) innerhalb eines PDFs extrahieren, indem es die Methoden ExtractTextFromLayer und GetTextObjectsByLayer verwendet, die Inhalte anvisieren, die in benannten Ebenen wie CAD-Zeichnungen oder Kartenexporten gruppiert sind.
How can I extract text with its structure and formatting from a PDF in C#?
IronPDF's TextBlocks property on a page returns its text grouped into blocks, lines and spans in reading order. Each span carries its text, bounding box, font, rendered font size and fill color, so headings can be told apart from body text.

Curtis Chau hat einen Bachelor-Abschluss in Informatik von der Carleton University und ist spezialisiert auf Frontend-Entwicklung mit Expertise in Node.js, TypeScript, JavaScript und React. Leidenschaftlich widmet er sich der Erstellung intuitiver und ästhetisch ansprechender Benutzerschnittstellen und arbeitet gerne mit modernen Frameworks sowie der Erstellung gut strukturierter, optisch ansprechender Handbücher.

