



Aktualisiert 21. April 2026
Wie man TIFF in PDF in Java konvertiert
Dieser umfassende Leitfaden führt Sie durch die Schritte, wie Sie ein TIFF-Bild nahtlos in PDF in Java mit IronPDF konvertieren.
Weiterlesen

In diesem Artikel wird demonstriert, wie PDF-Dateien in Java mit der PDF-Bibliothek für das Demo-Java-Projekt, benannt IronPDF for Java Library Overview, gelesen werden, um Text- und Metadaten-Objekte in PDF-Dateien zu lesen sowie verschlüsselte Dokumente zu erstellen.
PdfDocument.fromFile [method documentation](/java/object-reference/api/com/ironsoftware/ironpdf/PdfDocument.html#fromFile(java.nio.file.Path).Um den Prozess des Lesens von PDF-Dateien in Java zu vereinfachen, greifen Entwickler oft auf Drittanbieterbibliotheken zurück, die umfassende und effiziente Lösungen bieten. Eine solche herausragende Bibliothek ist IronPDF for Java.
IronPDF ist so konzipiert, dass es entwicklerfreundlich ist und eine einfache API bereitstellt, die die Komplexitäten der PDF-Seitenmanipulation abstrahiert. Mit IronPDF können Java-Entwickler nahtlos PDF-Lesefunktionen in ihre Projekte integrieren und so Entwicklungszeit und -aufwand reduzieren. Diese Bibliothek unterstützt eine Vielzahl von PDF-Funktionalitäten und ist daher eine vielseitige Wahl für verschiedene Anwendungsfälle.
Die Hauptmerkmale umfassen die Möglichkeit, ein PDF-Dokument aus verschiedenen Formaten zu erstellen, einschließlich HTML, JavaScript, CSS, XML-Dokumenten und verschiedenen Bildformaten. Zusätzlich bietet IronPDF die Möglichkeit, Kopf- und Fußzeilen zu PDFs hinzuzufügen, Tabellen in PDF-Dokumenten zu erstellen und vieles mehr.
Zur Einrichtung von IronPDF benötigen Sie einen zuverlässigen Java-Compiler. Dieser Artikel empfiehlt die Nutzung von IntelliJ IDEA.
Starten Sie IntelliJ IDEA und beginnen Sie ein neues Maven-Projekt.
Sobald das Projekt eingerichtet ist, greifen Sie auf die pom.xml Datei zu. Fügen Sie die folgenden Maven-Abhängigkeiten hinzu, um IronPDF zu integrieren:
<dependency>
    <groupId>com.ironsoftware</groupId>
    <artifactId>ironpdf</artifactId>
    <version>YOUR_VERSION_HERE</version>
</dependency>Nachdem Sie diese Abhängigkeiten hinzugefügt haben, klicken Sie auf den kleinen Button, der rechts auf dem Bildschirm erscheint, um sie zu installieren.
Lassen Sie uns ein einfaches Java-Codebeispiel untersuchen, das zeigt, wie IronPDF verwendet wird, um den Inhalt einer PDF-Datei zu lesen. In diesem Beispiel konzentrieren wir uns auf die Methode zur Textextraktion aus einem PDF-Dokument.
// Importing necessary classes from IronPDF and Java libraries
import com.ironsoftware.ironpdf.*;

import java.io.IOException;
import java.nio.file.Paths;

// Class definition
class Test {
    public static void main(String[] args) throws IOException {
        // Setting the license key for IronPDF (replace "License-Key" with a valid key)
        License.setLicenseKey("License-Key");

        // Loading a PDF document from the file "html_file_saved.pdf"
        PdfDocument pdf = PdfDocument.fromFile(Paths.get("html_file_saved.pdf"));

        // Extracting all text content from the PDF document
        String text = pdf.extractAllText();

        // Printing the extracted text to the console
        System.out.println(text);
    }
}Dieser Java-Code verwendet die IronPDF-Bibliothek, um Text aus einer bestimmten PDF-Datei zu extrahieren. Er wird die Java-Bibliothek importieren und den Lizenzschlüssel setzen, eine Voraussetzung für die Nutzung der Bibliothek. Der Code lädt dann ein PDF-Dokument aus der Datei 'html_file_saved.pdf' und extrahiert den gesamten Textinhalt aus der Datei als internen Zeichenfolgenpuffer. Der extrahierte Text wird in einer Variablen gespeichert und anschließend in der Konsole ausgegeben.
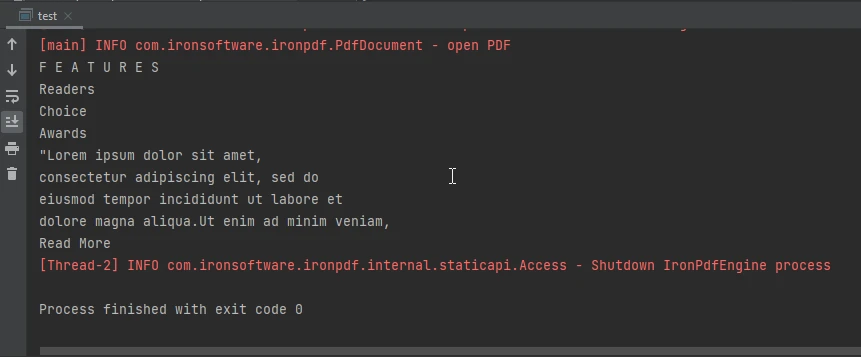 Die Konsolenausgabe
Über seine Fähigkeiten zur Textextraktion hinaus erweitert IronPDF die Unterstützung für die Extraktion von Metadaten aus PDF-Dateien. Um diese Funktionalität zu veranschaulichen, betrachten wir ein Java-Codebeispiel, das den Prozess der Metadatenabfrage aus einem PDF-Dokument zeigt.
// Importing necessary classes from IronPDF and Java libraries
import com.ironsoftware.ironpdf.*;
import com.ironsoftware.ironpdf.metadata.MetadataManager;

import java.io.IOException;
import java.nio.file.Paths;

// Class definition
class Test {
    public static void main(String[] args) throws IOException {
        // Setting the license key for IronPDF (replace "License-Key" with a valid key)
        License.setLicenseKey("License-Key");

        // Loading a PDF document from the file "html_file_saved.pdf"
        PdfDocument document = PdfDocument.fromFile(Paths.get("html_file_saved.pdf"));

        // Creating a MetadataManager object to access document metadata
        MetadataManager metadata = document.getMetadata();

        // Extracting the author information from the document metadata
        String author = metadata.getAuthor();

        // Printing the extracted author information to the console
        System.out.println(author);
    }
}Dieser Java-Code nutzt die IronPDF-Bibliothek, um Metadaten, insbesondere die Autorinformationen, aus einem PDF-Dokument zu extrahieren. Es beginnt mit dem Laden eines PDF-Dokuments aus der Datei 'html_file_saved.pdf'. Der Code holt die Metadaten des Dokuments ab, indem er die Dokumentation der MetadataManager-Klasse verwendet und speziell die Autoreninformationen abruft. Die extrahierten Autorendetails werden in einer Variablen gespeichert und in der Konsole ausgegeben.
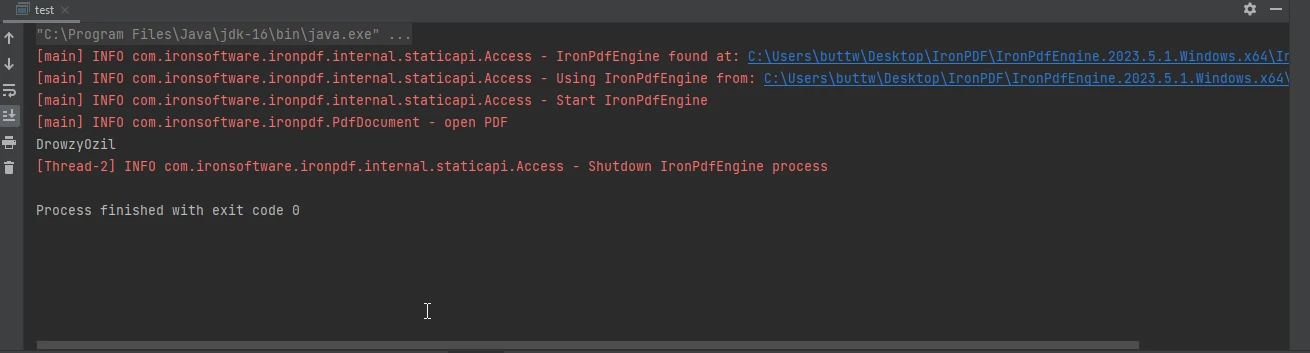 Die Konsolenausgabe
Zusammenfassend lässt sich sagen, dass das Lesen eines bestehenden PDF-Dokuments in einem Java-Programm eine wertvolle Fähigkeit ist, die Entwicklern eine Vielzahl von Möglichkeiten eröffnet. Ob Textextraktion, Bilder oder andere Daten – die Fähigkeit, PDFs programmgesteuert zu bearbeiten, ist ein wesentlicher Aspekt vieler Anwendungen. IronPDF for Java dient als robuste und effiziente Lösung für Entwickler, die PDF-Lesefunktionen in ihre Java-Projekte integrieren möchten.
Durch Befolgung der Installationsschritte und Erkunden der bereitgestellten Codebeispiele können Entwickler schnell die Leistungsfähigkeit von IronPDF nutzen, um neue Dateien zu erstellen und PDF-bezogene Aufgaben mit Leichtigkeit zu bewältigen. Zusätzlich dazu kann man seine Fähigkeiten zur Erstellung verschlüsselter Dokumente weiter erkunden.
Das IronPDF-Produktportal bietet umfassende Unterstützung für seine Entwickler. Um mehr darüber zu erfahren, wie IronPDF for Java funktioniert, besuchen Sie diese umfassenden Dokumentationsseiten. Außerdem bietet IronPDF eine Seite für kostenlose Testlizenzen, die eine großartige Gelegenheit darstellt, IronPDF und seine Funktionen zu erkunden.

Curtis Chau hat einen Bachelor-Abschluss in Informatik von der Carleton University und ist spezialisiert auf Frontend-Entwicklung mit Expertise in Node.js, TypeScript, JavaScript und React. Leidenschaftlich widmet er sich der Erstellung intuitiver und ästhetisch ansprechender Benutzerschnittstellen und arbeitet gerne mit modernen Frameworks sowie der Erstellung gut strukturierter, optisch ansprechender Handbücher.



IronPDF ist ein Teil der IRONSUITE
10 .NET-API-Produkte für Ihre Bürodokumente


Wenn Ihr PDF wie HTML aussehen soll, schnell.

