using IronPdf;

// Disable local disk access or cross-origin requests
Installation.EnableWebSecurity = true;

// Instantiate Renderer
var renderer = new ChromePdfRenderer();

// Create a PDF from a HTML string using C#
var pdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>");

// Export to a file or Stream
pdf.SaveAs("output.pdf");

// Advanced Example with HTML Assets
// Load external html assets: Images, CSS and JavaScript.
// An optional BasePath 'C:\site\assets\' is set as the file location to load assets from
var myAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", @"C:\site\assets\");
myAdvancedPdf.SaveAs("html-with-assets.pdf");
using IronPdf;// Disable local disk access or cross-origin requestsInstallation.EnableWebSecurity = true;// Instantiate Renderervar renderer = new ChromePdfRenderer();// Create a PDF from a HTML string using C#var pdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>");// Export to a file or Streampdf.SaveAs("output.pdf");// Advanced Example with HTML Assets// Load external html assets: Images, CSS and JavaScript.// An optional BasePath 'C:\site\assets\' is set as the file location to load assets fromvar myAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", @"C:\site\assets\");myAdvancedPdf.SaveAs("html-with-assets.pdf");
PM >Install-Package IronPdf
Install-Package IronPdf
ACTUALIZACIONES PARA DESARROLLADORES
Html Agility Pack C# (Cómo Funciona para Desarrolladores)
La necesidad de gestionar y manipular contenido de documentos de forma dinámica está muy extendida en el mundo del desarrollo de C#. Los desarrolladores suelen confiar en bibliotecas robustas para automatizar actividades como la creación de informes PDF y la extracción de datos de páginas web. Este artículo explora la integración sencilla de IronPDF y HTML Agility Pack en C# y proporciona ejemplos de código para demostrar cómo se pueden usar estas bibliotecas para crear documentos PDF sin esfuerzo y leer texto HTML.
IronPDF es una biblioteca .NET rica en funciones para trabajar con archivos PDF. Como IronPDF permite a los desarrolladores generar archivos PDF dinámicamente a partir de contenido HTML, URL o datos sin procesar, sirve como una herramienta valiosa para la creación de documentos, informes y visualización de datos.
Para agilizar la generación de documentos en aplicaciones .NET, veremos cómo conectar IronPDF con HTML Agility Pack en este post. Al combinar estas tecnologías, los programadores pueden trabajar con sistemas remotos, generar páginas PDF dinámicas y obtener datos mediante conectividad de red, todo mientras aumentan la productividad y escalabilidad en sus programas.
## How to Use HtmlAgilityPack in C#
1. Crea un nuevo Proyecto de C#.
2. Instalar la biblioteca HtmlAgilityPack.
3. Importar el espacio de nombres. Crear un objeto.
4. Importar datos desde URL y analizar el HTML.
5. Obtener los datos requeridos y deshacerse del objeto.
## Introducción a HtmlAgilityPack
[HTML Agility Pack](https://html-agility-pack.net/) es una biblioteca de análisis HTML versátil y potente para desarrolladores .NET. Con la ayuda de su extensa colección de API, los desarrolladores pueden navegar, alterar y extraer fácilmente datos de documentos HTML. HTML Agility Pack hace más fácil trabajar con contenido HTML de manera programática para todos los desarrolladores, independientemente del nivel de experiencia.
La capacidad de HTML Agility Pack para gestionar con delicadeza HTML que está mal organizado o es defectuoso es lo que lo hace único. Es perfecto para operaciones de scraping en línea donde la calidad del marcado HTML puede variar, ya que utiliza un algoritmo de análisis permisivo que puede analizar incluso el HTML peor construido.
## Características de HtmlAgilityPack
### Interpretación HTML
Con las potentes características de análisis HTML que ofrece HTML Agility Pack, los desarrolladores pueden cargar documentos HTML desde una variedad de fuentes, incluidos archivos, URL y cadenas. Debido a su enfoque de análisis permisivo, puede manejar con elegancia HTML mal formateado o incorrecto, lo que lo hace adecuado para actividades de scraping web donde la calidad del marcado HTML puede variar.
### Manipulación DOM
Para explorar, navegar y trabajar con la estructura del Modelo de Objeto de Documento (DOM) HTML, HAP ofrece una API fácil de usar. Elementos HTML, atributos y nodos de texto se pueden agregar, eliminar o modificar programáticamente por los desarrolladores, permitiendo la manipulación dinámica de contenido HTML.
### Soporte XPath y LINQ
Para elegir y consultar componentes HTML, HTML Agility Pack admite la sintaxis de búsqueda XPath así como LINQ (consulta integrada en lenguaje). Para elegir elementos en un documento HTML según sus atributos, etiquetas o jerarquía, las consultas de expresiones XPath proporcionan una sintaxis sólida y fácil de entender. Para los desarrolladores acostumbrados a trabajar con LINQ en C#, las consultas LINQ ofrecen una sintaxis de consulta familiar que facilita la integración fluida con otros componentes .NET.
## Cómo empezar con HtmlAgilityPack
### Configuración de HtmlAgilityPack en proyectos de C#
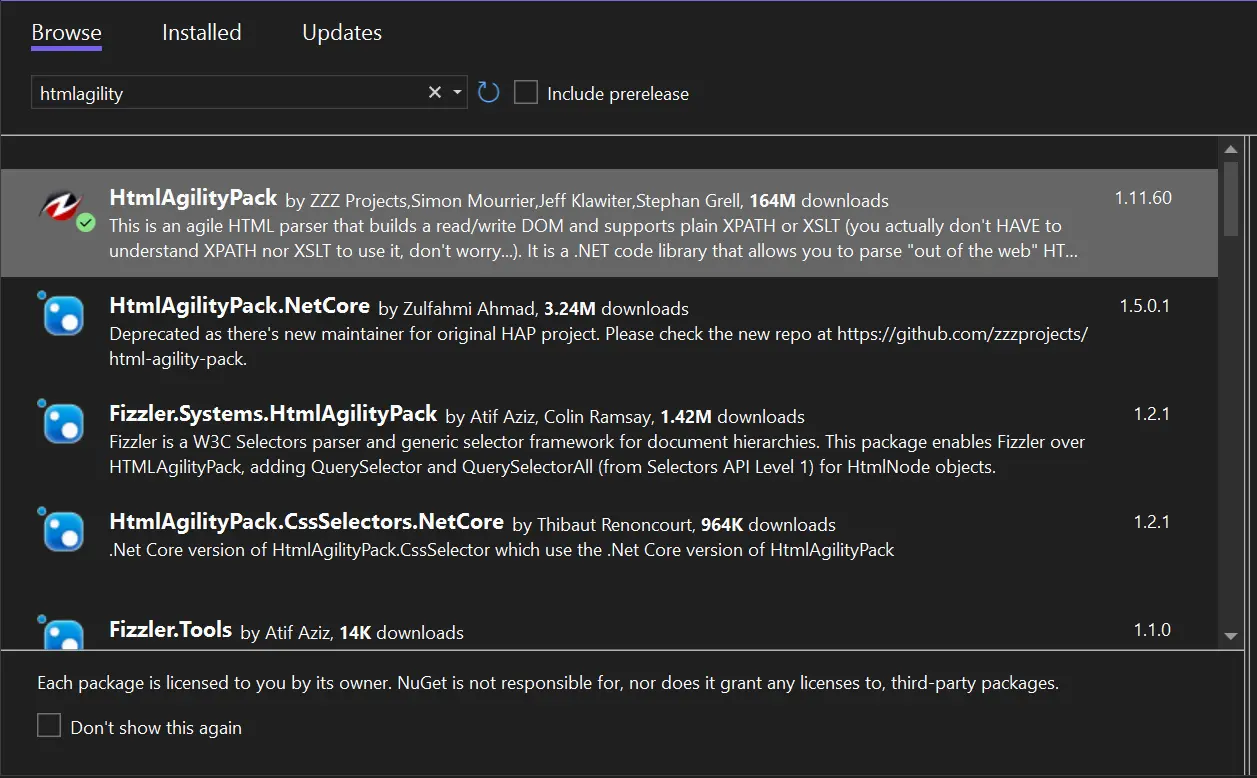
La Biblioteca Base de HtmlAgility viene en un solo paquete empaquetado, que debería estar disponible en NuGet instalándolo y puede usarse en el proyecto C#. Ofrece un analizador HTML y selectores CSS desde el documento HTML y las URL HTML.
### Implementación de HtmlAgilityPack en la consola y formularios de Windows
Muchos tipos de aplicaciones C#, como Formularios de Windows (WinForms) y Consola de Windows, implementan HtmlAgilityPack. Aunque la implementación varía de un marco a otro, la idea fundamental permanece constante.
### Ejemplo de HtmlAgilityPack en C#
Uno de las herramientas más importantes en la caja de herramientas del desarrollador de C# para navegar, procesar y trabajar con documentos HTML es HTML Agility Pack (HAP). La extracción de datos de las páginas HTML se facilita con su API fácil de usar, que funciona como un árbol organizado de elementos. Examinemos un ejemplo de código sencillo para demostrar cómo usarlo.
```csharp
using HtmlAgilityPack;

// Load HTML content from a file or URL
HtmlWeb web = new HtmlWeb();
var doc = web.Load("https://ironpdf.com/");

// Select specific html nodes and parse html string
HtmlNodeCollection nodes = doc.DocumentNode.SelectNodes("//h1[@class='product-homepage-header product-homepage-header--ironpdf']");

// Iterate through selected nodes and extract content
foreach (HtmlNode node in nodes)
{
    Console.WriteLine(node.InnerText);
}
Console.ReadKey();
```
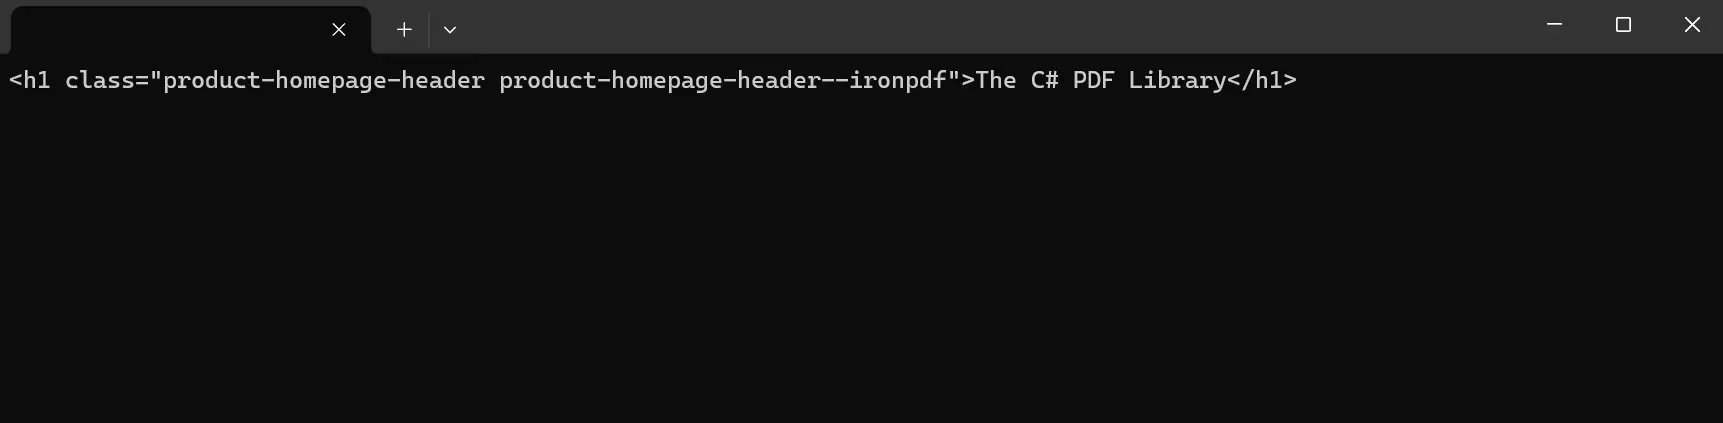
En este ejemplo, cargamos material de nodo HTML desde una URL usando HTML Agility Pack. El HTML se carga luego en el `var doc` para su análisis y manipulación. Para extraer contenido, el programa primero identifica el nodo raíz del documento HTML y luego apunta específicamente a nodos dentro del documento utilizando consultas XPath. Del código anterior, seleccionamos específicamente elementos div con la clase **product-homepage-header** desde los datos HTML en cadena, y luego se imprime el texto interno de cada nodo seleccionado en la consola.
## Operaciones de HtmlAgilityPack
### Transformación HTML
Los desarrolladores pueden realizar varias transformaciones y manipulaciones en textos HTML usando el HTML Agility Pack. Esto cubre operaciones como agregar, eliminar o cambiar nodos de texto, elementos y atributos además de reorganizar la jerarquía del DOM del documento HTML.
### Extensibilidad
Debido a que HAP está destinado a ser ampliable, los programadores pueden agregar nuevas funciones y comportamientos para aumentar su funcionalidad. Usando la API proporcionada, los desarrolladores pueden diseñar sus propios analizadores, filtros o manipuladores HTML para personalizar HAP a sus necesidades y casos de uso únicos.
### Rendimiento y eficacia
Grandes textos HTML pueden ser manejados bien por los algoritmos y estructuras de datos de HTML Agility Pack, que está afinado para la velocidad y eficacia. Garantiza un análisis y manipulación de contenido HTML rápido y receptivo al reducir el uso de memoria y la sobrecarga de procesamiento.
## Integrating HtmlAgilityPack with IronPDF
### Uso de IronPDF con HtmlAgilityPack
Las posibilidades para la gestión de documentos y la creación de informes son infinitas cuando se combinan HTML Agility Pack y [IronPDF para Conversión PDF](https://ironpdf.com). A través del uso de HTML Agility Pack para el análisis HTML y [Documentación de IronPDF](/docs/) para la conversión a PDF, los desarrolladores pueden automáticamente con facilidad la creación de documentos PDF a partir de material dinámico en línea.
## Instalar IronPDF
- Lanzar el proyecto de Visual Studio.
- Seleccione "Herramientas" > "Administrador de Paquetes NuGet" > "Consola de Paquetes".
- Introduce este comando en la Consola del Administrador de Paquetes:
```shell
:ProductInstall
```
- Como alternativa, puedes usar el Administrador de Paquetes NuGet para Soluciones para instalar IronPDF.
- Se pueden navegar los resultados de búsqueda del paquete IronPDF, seleccionar y luego hacer clic en el botón "Instalar". Visual Studio se encargará de la instalación y descarga por ti.
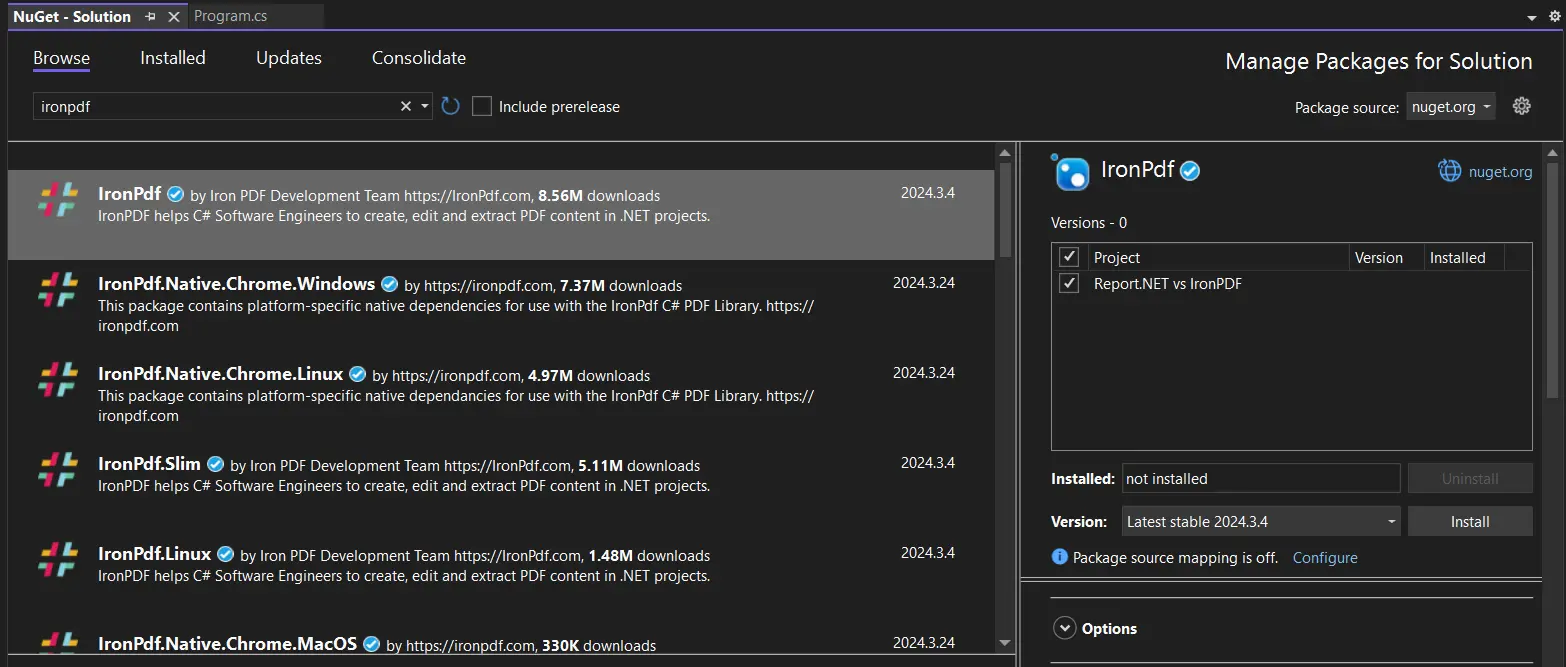
- El paquete IronPDF y cualquier dependencia necesaria para tu proyecto se instalarán por NuGet.
- IronPDF se puede usar para tu proyecto después de la instalación.
### Instalación a través del sitio web de NuGet
Para saber más sobre las características, compatibilidad y otras opciones de descarga de IronPDF, consulta su [Información del Paquete NuGet de IronPDF](https://www.nuget.org/packages/IronPdf) en el sitio web de NuGet.
### Utilizar DLL para instalar
Como alternativa, puedes usar el archivo DLL de IronPDF para integrarlo directamente en tu proyecto. Haz clic en este [Descarga del DLL de IronPDF](https://ironpdf.com/packages/IronPdf.zip) para obtener el archivo ZIP que contiene el DLL. Después de descomprimir, incorpora el DLL en tu proyecto.
## Implementación de la lógica
Al integrar las características de ambas bibliotecas, HTML Agility Pack (HAP) y IronPDF se pueden implementar en C# para leer información HTML y producir documentos PDF sobre la marcha. Los pasos para la implementación se enumeran a continuación, junto con un código de muestra que guía a través de cada uno:
1. **Cargue contenido HTML con HTML Agility Pack:** para cargar material HTML desde una fuente, como un archivo, una cadena o una URL, utilice HTML Agility Pack. En esta fase, el documento HTML se analiza y se crea un objeto de documento HTML manipulable.
2. **Extraer Contenido Deseado:** para elegir y extraer contenido particular del documento HTML, usa HTML Agility Pack junto con consultas XPath o LINQ. Esto podría implicar elegir elementos de acuerdo a sus propiedades, etiquetas o estructura jerárquica.
3. **Convierta HTML a PDF usando IronPDF:** para crear un documento PDF a partir del contenido HTML recuperado, utilice IronPDF. IronPDF convierte el material HTML a formato PDF con facilidad manteniendo el estilo y el diseño.
4. **Opcional: Personalizar la Salida PDF:** usa IronPDF para agregar encabezados, pies de página, numeración de páginas y otros componentes dinámicos para personalizar la salida PDF según se requiera. Este paso mejora la apariencia y la utilidad del documento PDF resultante.
5. **Guardar o transmitir documento PDF:** El documento PDF creado puede transmitirse directamente al cliente o navegador para su descarga, o bien guardarse en un archivo. IronPDF ofrece diversas maneras de guardar archivos PDF en diferentes flujos de salida.
```csharp
using HtmlAgilityPack;
using IronPdf;
using System;
using System.Text;
class Program
{
static void Main()
{
StringBuilder htmlContent = new StringBuilder();
// Load HTML content from a file or URL
HtmlWeb web = new HtmlWeb();
HtmlDocument doc = web.Load("https://ironpdf.com/");
// Select specific elements using XPath or LINQ
HtmlNodeCollection nodes = doc.DocumentNode.SelectNodes("//h1[@class='product-homepage-header product-homepage-header--ironpdf']");
// Iterate through selected nodes and extract content
foreach (HtmlNode node in nodes)
{
htmlContent.Append(node.OuterHtml);
Console.WriteLine(node.InnerText);
}
// Convert HTML content to PDF using IronPDF
var Renderer = new HtmlToPdf();
var PDF = Renderer.RenderHtmlAsPdf(htmlContent.ToString());
// Save PDF to file
PDF.SaveAs("output.pdf");
Console.WriteLine("PDF generated successfully!");
Console.ReadKey();
}
}
```
Visite [Utilizar IronPDF para Conversión](/examples/using-html-to-create-a-pdf/) para saber más sobre el ejemplo de código.
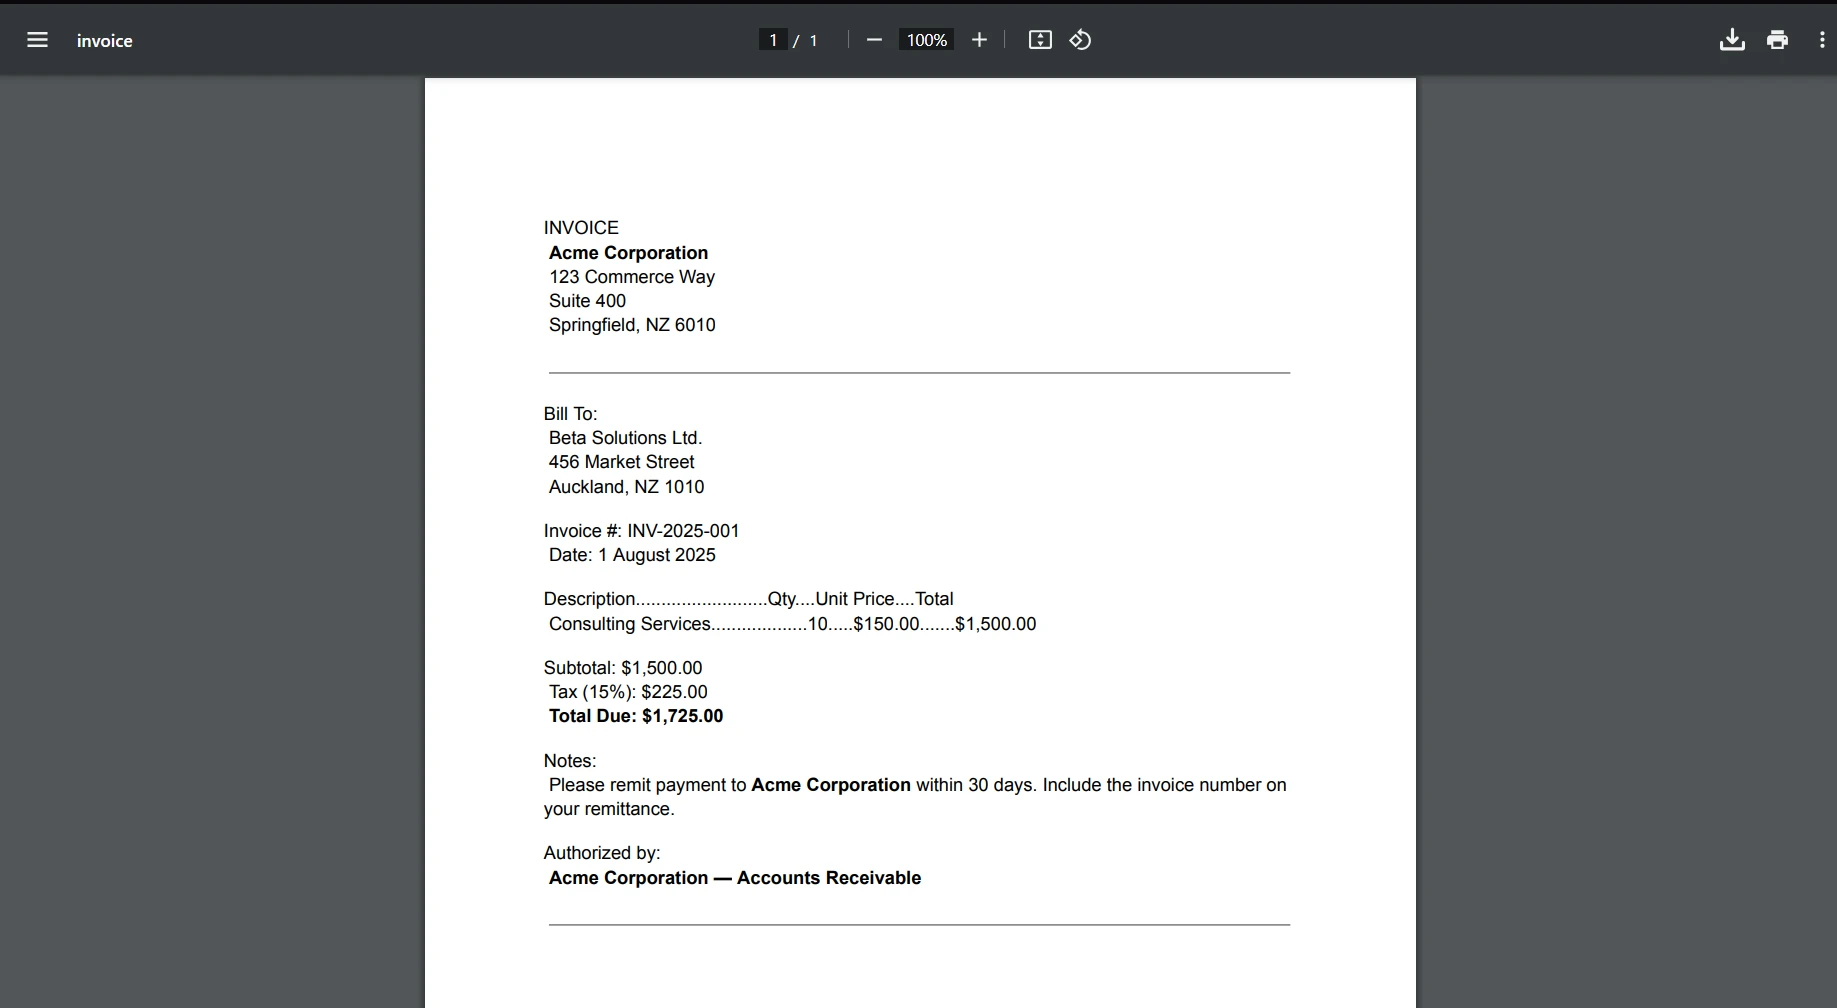
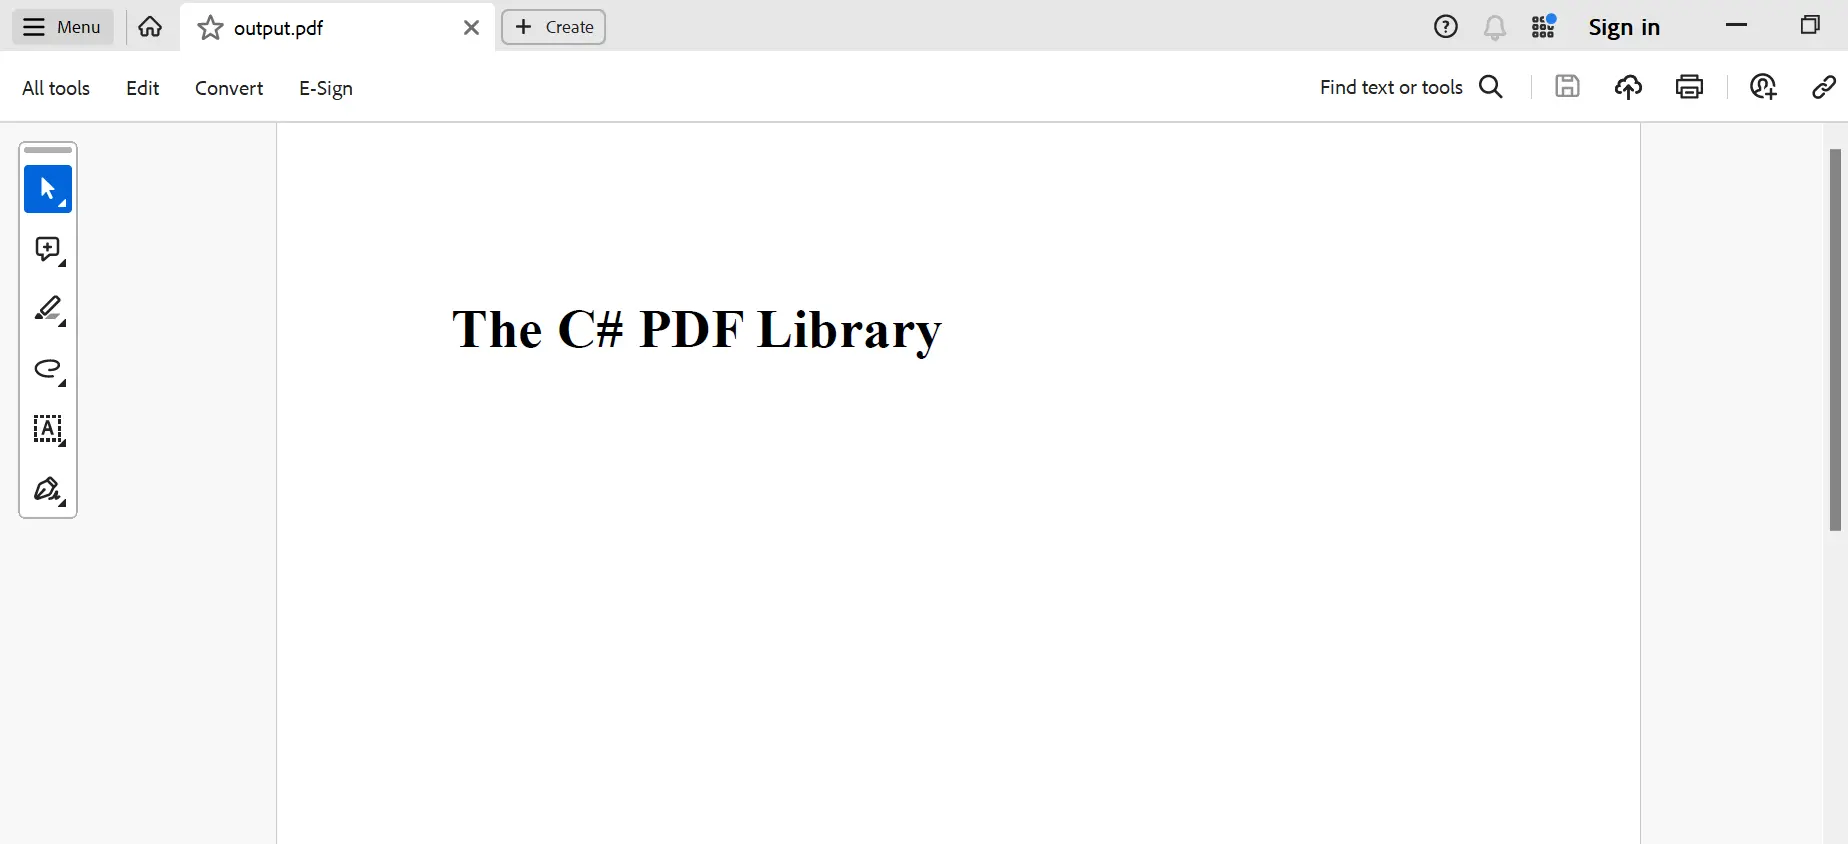
La salida de ejecución se muestra a continuación:
## Conclusión
Ya sea analizando datos HTML o creando informes PDF, los desarrolladores pueden gestionar y alterar el material del documento con facilidad gracias a la integración fluida de HTML Agility Pack e IronPDF en C#. Los desarrolladores pueden fácilmente y con precisión automatizar operaciones relacionadas con documentos al combinar las características de producción de PDF de IronPDF con las capacidades de análisis de HTML Agility Pack. La combinación de estas dos bibliotecas proporciona una solución sólida de gestión de documentos en C# independientemente de si estás construyendo informes dinámicos o extrayendo datos de páginas web.
Una licencia perpetua, un año de mantenimiento de software y una actualización de la biblioteca están todos incluidos en el paquete `$liteLicense` Lite. IronPDF proporciona licencias gratuitas con limitaciones temporales y de redistribución. Durante el período de prueba, los usuarios pueden evaluar la solución sin ver una marca de agua. Por favor, vaya a la [Información de Licencia](/licensing/) de IronPDF para saber más sobre el costo y la licencia.
Obtenga más información sobre las bibliotecas de [Iron Software](https://ironsoftware.com/).
La necesidad de gestionar y manipular contenido de documentos de forma dinámica está muy extendida en el mundo del desarrollo de C#. Los desarrolladores suelen confiar en bibliotecas robustas para automatizar actividades como la creación de informes PDF y la extracción de datos de páginas web. Este artículo explora la integración sencilla de IronPDF y HTML Agility Pack en C# y proporciona ejemplos de código para demostrar cómo se pueden usar estas bibliotecas para crear documentos PDF sin esfuerzo y leer texto HTML.
IronPDF es una biblioteca .NET rica en funciones para trabajar con archivos PDF. Como IronPDF permite a los desarrolladores generar archivos PDF dinámicamente a partir de contenido HTML, URL o datos sin procesar, sirve como una herramienta valiosa para la creación de documentos, informes y visualización de datos.
Para agilizar la generación de documentos en aplicaciones .NET, veremos cómo conectar IronPDF con HTML Agility Pack en este post. Al combinar estas tecnologías, los programadores pueden trabajar con sistemas remotos, generar páginas PDF dinámicas y obtener datos mediante conectividad de red, todo mientras aumentan la productividad y escalabilidad en sus programas.
How to Use HtmlAgilityPack in C#
Crea un nuevo Proyecto de C#.
Instalar la biblioteca HtmlAgilityPack.
Importar el espacio de nombres. Crear un objeto.
Importar datos desde URL y analizar el HTML.
Obtener los datos requeridos y deshacerse del objeto.
Introducción a HtmlAgilityPack
HTML Agility Pack es una biblioteca de análisis HTML versátil y potente para desarrolladores .NET. Con la ayuda de su extensa colección de API, los desarrolladores pueden navegar, alterar y extraer fácilmente datos de documentos HTML. HTML Agility Pack hace más fácil trabajar con contenido HTML de manera programática para todos los desarrolladores, independientemente del nivel de experiencia.
La capacidad de HTML Agility Pack para gestionar con delicadeza HTML que está mal organizado o es defectuoso es lo que lo hace único. Es perfecto para operaciones de scraping en línea donde la calidad del marcado HTML puede variar, ya que utiliza un algoritmo de análisis permisivo que puede analizar incluso el HTML peor construido.
Características de HtmlAgilityPack
Interpretación HTML
Con las potentes características de análisis HTML que ofrece HTML Agility Pack, los desarrolladores pueden cargar documentos HTML desde una variedad de fuentes, incluidos archivos, URL y cadenas. Debido a su enfoque de análisis permisivo, puede manejar con elegancia HTML mal formateado o incorrecto, lo que lo hace adecuado para actividades de scraping web donde la calidad del marcado HTML puede variar.
Manipulación DOM
Para explorar, navegar y trabajar con la estructura del Modelo de Objeto de Documento (DOM) HTML, HAP ofrece una API fácil de usar. Elementos HTML, atributos y nodos de texto se pueden agregar, eliminar o modificar programáticamente por los desarrolladores, permitiendo la manipulación dinámica de contenido HTML.
Soporte XPath y LINQ
Para elegir y consultar componentes HTML, HTML Agility Pack admite la sintaxis de búsqueda XPath así como LINQ (consulta integrada en lenguaje). Para elegir elementos en un documento HTML según sus atributos, etiquetas o jerarquía, las consultas de expresiones XPath proporcionan una sintaxis sólida y fácil de entender. Para los desarrolladores acostumbrados a trabajar con LINQ en C#, las consultas LINQ ofrecen una sintaxis de consulta familiar que facilita la integración fluida con otros componentes .NET.
Cómo empezar con HtmlAgilityPack
Configuración de HtmlAgilityPack en proyectos de C#
La Biblioteca Base de HtmlAgility viene en un solo paquete empaquetado, que debería estar disponible en NuGet instalándolo y puede usarse en el proyecto C#. Ofrece un analizador HTML y selectores CSS desde el documento HTML y las URL HTML.
Implementación de HtmlAgilityPack en la consola y formularios de Windows
Muchos tipos de aplicaciones C#, como Formularios de Windows (WinForms) y Consola de Windows, implementan HtmlAgilityPack. Aunque la implementación varía de un marco a otro, la idea fundamental permanece constante.
Ejemplo de HtmlAgilityPack en C#
Uno de las herramientas más importantes en la caja de herramientas del desarrollador de C# para navegar, procesar y trabajar con documentos HTML es HTML Agility Pack (HAP). La extracción de datos de las páginas HTML se facilita con su API fácil de usar, que funciona como un árbol organizado de elementos. Examinemos un ejemplo de código sencillo para demostrar cómo usarlo.
using HtmlAgilityPack;// Load HTML content from a file or URLHtmlWeb web = new HtmlWeb();var doc = web.Load("https://ironpdf.com/");// Select specific html nodes and parse html stringHtmlNodeCollection nodes = doc.DocumentNode.SelectNodes("//h1[@class='product-homepage-header product-homepage-header--ironpdf']");// Iterate through selected nodes and extract contentforeach (HtmlNode node in nodes){Console.WriteLine(node.InnerText);}Console.ReadKey();
using HtmlAgilityPack;

// Load HTML content from a file or URL
HtmlWeb web = new HtmlWeb();
var doc = web.Load("https://ironpdf.com/");

// Select specific html nodes and parse html string
HtmlNodeCollection nodes = doc.DocumentNode.SelectNodes("//h1[@class='product-homepage-header product-homepage-header--ironpdf']");

// Iterate through selected nodes and extract content
foreach (HtmlNode node in nodes)
{
    Console.WriteLine(node.InnerText);
}
Console.ReadKey();
ImportsHtmlAgilityPack' Load HTML content from a file or URLPrivate web As New HtmlWeb()Private doc = web.Load("https://ironpdf.com/")' Select specific html nodes and parse html stringPrivate nodes AsHtmlNodeCollection = doc.DocumentNode.SelectNodes("//h1[@class='product-homepage-header product-homepage-header--ironpdf']")' Iterate through selected nodes and extract contentFor Each node AsHtmlNodeIn nodesConsole.WriteLine(node.InnerText)Next nodeConsole.ReadKey()
Imports HtmlAgilityPack

' Load HTML content from a file or URL
Private web As New HtmlWeb()
Private doc = web.Load("https://ironpdf.com/")

' Select specific html nodes and parse html string
Private nodes As HtmlNodeCollection = doc.DocumentNode.SelectNodes("//h1[@class='product-homepage-header product-homepage-header--ironpdf']")

' Iterate through selected nodes and extract content
For Each node As HtmlNode In nodes
	Console.WriteLine(node.InnerText)
Next node
Console.ReadKey()
En este ejemplo, cargamos material de nodo HTML desde una URL usando HTML Agility Pack. El HTML se carga luego en el var doc para su análisis y manipulación. Para extraer contenido, el programa primero identifica el nodo raíz del documento HTML y luego apunta específicamente a nodos dentro del documento utilizando consultas XPath. Del código anterior, seleccionamos específicamente elementos div con la clase product-homepage-header desde los datos HTML en cadena, y luego se imprime el texto interno de cada nodo seleccionado en la consola.
Operaciones de HtmlAgilityPack
Transformación HTML
Los desarrolladores pueden realizar varias transformaciones y manipulaciones en textos HTML usando el HTML Agility Pack. Esto cubre operaciones como agregar, eliminar o cambiar nodos de texto, elementos y atributos además de reorganizar la jerarquía del DOM del documento HTML.
Extensibilidad
Debido a que HAP está destinado a ser ampliable, los programadores pueden agregar nuevas funciones y comportamientos para aumentar su funcionalidad. Usando la API proporcionada, los desarrolladores pueden diseñar sus propios analizadores, filtros o manipuladores HTML para personalizar HAP a sus necesidades y casos de uso únicos.
Rendimiento y eficacia
Grandes textos HTML pueden ser manejados bien por los algoritmos y estructuras de datos de HTML Agility Pack, que está afinado para la velocidad y eficacia. Garantiza un análisis y manipulación de contenido HTML rápido y receptivo al reducir el uso de memoria y la sobrecarga de procesamiento.
Integrating HtmlAgilityPack with IronPDF
Uso de IronPDF con HtmlAgilityPack
Las posibilidades para la gestión de documentos y la creación de informes son infinitas cuando se combinan HTML Agility Pack y IronPDF para Conversión PDF. A través del uso de HTML Agility Pack para el análisis HTML y Documentación de IronPDF para la conversión a PDF, los desarrolladores pueden automáticamente con facilidad la creación de documentos PDF a partir de material dinámico en línea.
Instalar IronPDF
Lanzar el proyecto de Visual Studio.
Seleccione "Herramientas" > "Administrador de Paquetes NuGet" > "Consola de Paquetes".
Introduce este comando en la Consola del Administrador de Paquetes:
PM > Install-Package IronPdf
Install-Package IronPdf
Como alternativa, puedes usar el Administrador de Paquetes NuGet para Soluciones para instalar IronPDF.
Se pueden navegar los resultados de búsqueda del paquete IronPDF, seleccionar y luego hacer clic en el botón "Instalar". Visual Studio se encargará de la instalación y descarga por ti.
El paquete IronPDF y cualquier dependencia necesaria para tu proyecto se instalarán por NuGet.
IronPDF se puede usar para tu proyecto después de la instalación.
Instalación a través del sitio web de NuGet
Para saber más sobre las características, compatibilidad y otras opciones de descarga de IronPDF, consulta su Información del Paquete NuGet de IronPDF en el sitio web de NuGet.
Utilizar DLL para instalar
Como alternativa, puedes usar el archivo DLL de IronPDF para integrarlo directamente en tu proyecto. Haz clic en este Descarga del DLL de IronPDF para obtener el archivo ZIP que contiene el DLL. Después de descomprimir, incorpora el DLL en tu proyecto.
Implementación de la lógica
Al integrar las características de ambas bibliotecas, HTML Agility Pack (HAP) y IronPDF se pueden implementar en C# para leer información HTML y producir documentos PDF sobre la marcha. Los pasos para la implementación se enumeran a continuación, junto con un código de muestra que guía a través de cada uno:
Cargue contenido HTML con HTML Agility Pack: para cargar material HTML desde una fuente, como un archivo, una cadena o una URL, utilice HTML Agility Pack. En esta fase, el documento HTML se analiza y se crea un objeto de documento HTML manipulable.
Extraer Contenido Deseado: para elegir y extraer contenido particular del documento HTML, usa HTML Agility Pack junto con consultas XPath o LINQ. Esto podría implicar elegir elementos de acuerdo a sus propiedades, etiquetas o estructura jerárquica.
Convierta HTML a PDF usando IronPDF: para crear un documento PDF a partir del contenido HTML recuperado, utilice IronPDF. IronPDF convierte el material HTML a formato PDF con facilidad manteniendo el estilo y el diseño.
Opcional: Personalizar la Salida PDF: usa IronPDF para agregar encabezados, pies de página, numeración de páginas y otros componentes dinámicos para personalizar la salida PDF según se requiera. Este paso mejora la apariencia y la utilidad del documento PDF resultante.
Guardar o transmitir documento PDF: El documento PDF creado puede transmitirse directamente al cliente o navegador para su descarga, o bien guardarse en un archivo. IronPDF ofrece diversas maneras de guardar archivos PDF en diferentes flujos de salida.
using HtmlAgilityPack;using IronPdf;using System;using System.Text;class Program{ static voidMain() { StringBuilder htmlContent = new StringBuilder(); // Load HTML content from a file or URL HtmlWeb web = new HtmlWeb(); HtmlDocument doc = web.Load("https://ironpdf.com/"); // Select specific elements using XPath or LINQ HtmlNodeCollection nodes = doc.DocumentNode.SelectNodes("//h1[@class='product-homepage-header product-homepage-header--ironpdf']"); // Iterate through selected nodes and extract content foreach (HtmlNode node in nodes) { htmlContent.Append(node.OuterHtml);Console.WriteLine(node.InnerText); } // Convert HTML content to PDF using IronPDF varRenderer = new HtmlToPdf(); varPDF = Renderer.RenderHtmlAsPdf(htmlContent.ToString()); // Save PDF to filePDF.SaveAs("output.pdf");Console.WriteLine("PDF generated successfully!");Console.ReadKey(); }}
using HtmlAgilityPack;
using IronPdf;
using System;
using System.Text;

class Program
{
    static void Main()
    {
        StringBuilder htmlContent = new StringBuilder();

        // Load HTML content from a file or URL
        HtmlWeb web = new HtmlWeb();
        HtmlDocument doc = web.Load("https://ironpdf.com/");

        // Select specific elements using XPath or LINQ
        HtmlNodeCollection nodes = doc.DocumentNode.SelectNodes("//h1[@class='product-homepage-header product-homepage-header--ironpdf']");

        // Iterate through selected nodes and extract content
        foreach (HtmlNode node in nodes)
        {
            htmlContent.Append(node.OuterHtml);
            Console.WriteLine(node.InnerText);
        }

        // Convert HTML content to PDF using IronPDF
        var Renderer = new HtmlToPdf();
        var PDF = Renderer.RenderHtmlAsPdf(htmlContent.ToString());

        // Save PDF to file
        PDF.SaveAs("output.pdf");
        Console.WriteLine("PDF generated successfully!");
        Console.ReadKey();
    }
}
ImportsHtmlAgilityPackImportsIronPdfImportsSystemImportsSystem.TextModuleProgram Sub Main() Dim htmlContent As New StringBuilder() ' Load HTML content from a file or URL Dim web As New HtmlWeb() Dim doc AsHtmlDocument = web.Load("https://ironpdf.com/") ' Select specific elements using XPath or LINQ Dim nodes AsHtmlNodeCollection = doc.DocumentNode.SelectNodes("//h1[@class='product-homepage-header product-homepage-header--ironpdf']") ' Iterate through selected nodes and extract content For Each node AsHtmlNodeIn nodes htmlContent.Append(node.OuterHtml)Console.WriteLine(node.InnerText) Next ' Convert HTML content to PDF using IronPDF DimRendererAs New HtmlToPdf() DimPDF = Renderer.RenderHtmlAsPdf(htmlContent.ToString()) ' Save PDF to filePDF.SaveAs("output.pdf")Console.WriteLine("PDF generated successfully!")Console.ReadKey() End SubEndModule
Imports HtmlAgilityPack
Imports IronPdf
Imports System
Imports System.Text

Module Program
    Sub Main()
        Dim htmlContent As New StringBuilder()

        ' Load HTML content from a file or URL
        Dim web As New HtmlWeb()
        Dim doc As HtmlDocument = web.Load("https://ironpdf.com/")

        ' Select specific elements using XPath or LINQ
        Dim nodes As HtmlNodeCollection = doc.DocumentNode.SelectNodes("//h1[@class='product-homepage-header product-homepage-header--ironpdf']")

        ' Iterate through selected nodes and extract content
        For Each node As HtmlNode In nodes
            htmlContent.Append(node.OuterHtml)
            Console.WriteLine(node.InnerText)
        Next

        ' Convert HTML content to PDF using IronPDF
        Dim Renderer As New HtmlToPdf()
        Dim PDF = Renderer.RenderHtmlAsPdf(htmlContent.ToString())

        ' Save PDF to file
        PDF.SaveAs("output.pdf")
        Console.WriteLine("PDF generated successfully!")
        Console.ReadKey()
    End Sub
End Module
Ya sea analizando datos HTML o creando informes PDF, los desarrolladores pueden gestionar y alterar el material del documento con facilidad gracias a la integración fluida de HTML Agility Pack e IronPDF en C#. Los desarrolladores pueden fácilmente y con precisión automatizar operaciones relacionadas con documentos al combinar las características de producción de PDF de IronPDF con las capacidades de análisis de HTML Agility Pack. La combinación de estas dos bibliotecas proporciona una solución sólida de gestión de documentos en C# independientemente de si estás construyendo informes dinámicos o extrayendo datos de páginas web.
Una licencia perpetua, un año de mantenimiento de software y una actualización de la biblioteca están todos incluidos en el paquete $999 Lite. IronPDF proporciona licencias gratuitas con limitaciones temporales y de redistribución. Durante el período de prueba, los usuarios pueden evaluar la solución sin ver una marca de agua. Por favor, vaya a la Información de Licencia de IronPDF para saber más sobre el costo y la licencia.
Obtenga más información sobre las bibliotecas de Iron Software.
Jacob Mellor es Director de Tecnología de Iron Software y un ingeniero visionario pionero en la tecnología C# PDF. Como desarrollador original de la base de código principal de Iron Software, ha dado forma a la arquitectura de productos de la empresa desde su creación, transformándola, junto con el director ejecutivo Cameron Rimington, en una empresa de más de 50 personas que presta servicios a la NASA, Tesla y organismos gubernamentales de todo el mundo.