from ironpdf import *

# Instantiate Renderer
renderer = ChromePdfRenderer()

# Create a PDF from a HTML string using Python
pdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>")

# Export to a file or Stream
pdf.SaveAs("output.pdf")

# Advanced Example with HTML Assets
# Load external html assets: Images, CSS and JavaScript.
# An optional BasePath 'C:\site\assets\' is set as the file location to load assets from
myAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", r"C:\site\assets")
myAdvancedPdf.SaveAs("html-with-assets.pdf")
from ironpdf import *# Instantiate Rendererrenderer = ChromePdfRenderer()# Create a PDF from a HTML string using Pythonpdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>")# Export to a file or Streampdf.SaveAs("output.pdf")# Advanced Example with HTML Assets# Load external html assets: Images, CSS and JavaScript.# An optional BasePath 'C:\site\assets\' is set as the file location to load assets frommyAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", r"C:\site\assets")myAdvancedPdf.SaveAs("html-with-assets.pdf")
Este artículo demostrará cómo extraer todo el texto de archivos PDF usando IronPDF en Python, proporcionándole el conocimiento y fragmentos de código de Python para realizar esta tarea de manera eficiente.
<div class="hsg-featured-snippet">
<h2>Cómo Extraer Texto De Un PDF en Python</h2>
<ol>
<li><a class="js-modal-open" data-modal-id="download-modal" href="#download-modal">Descargue un módulo Python para extraer texto de PDF</a></li>
<li>Utilice el método <code>FromFile</code> para importar el archivo PDF</li>
<li>Extraer texto del PDF importado con el método <code>ExtractText</code></li>
<li>Extraer texto de páginas específicas con el método <code>ExtractTextFromPage</code></li>
<li>Genera el texto extraído en la consola o un archivo de texto</li>
</ol>
</div>
## IronPDF - Biblioteca Python
[IronPDF for Python](/python/) es una poderosa biblioteca de PDF for Python que permite a los desarrolladores extraer texto de documentos PDF. Con IronPDF, puede automatizar la parte de extracción de datos del contenido textual de archivos PDF, facilitando el procesamiento y análisis de la información contenida en los documentos PDF.
IronPDF proporciona a los programadores de Python la capacidad de manipular, extraer datos e interactuar con archivos PDF utilizando Python, facilitando la automatización de diversas tareas relacionadas con PDF. Ya sea que necesite generar PDFs, modificar PDFs existentes, extraer datos del contenido o realizar otras operaciones con PDF, IronPDF simplifica el proceso con su API intuitiva y potentes capacidades.
### Características clave
Algunas características de la biblioteca IronPDF for Python incluyen:
- [Crear un nuevo archivo PDF](/python/tutorials/html-to-pdf/) desde cero
- [Editar](/python/examples/editing-pdfs/) archivos PDF existentes
- [Extraer texto](/python/blog/using-ironpdf-for-python/extract-data-from-pdf-python-tutorial/), metadatos e imágenes de archivos PDF
- Convertir archivos PDF a otros formatos
- [Proteger archivos PDF](/python/examples/security-and-metadata/) con contraseñas y restricciones
- [Dividir](/python/blog/using-ironpdf-for-python/split-pdf-python-tutorial/) y [fusionar](/python/how-to/python-merge-pdf/) PDFs
## Requisitos previos
Antes de proceder con la extracción de texto usando IronPDF, asegúrese de tener los siguientes requisitos previos:
1. **Instalación de Python:** asegúrese de tener Python instalado en su sistema. IronPDF es compatible con versiones de Python 3.x, así que asegúrese de tener una instalación de Python compatible.
2. **Biblioteca IronPDF:** Instale la biblioteca IronPDF usando `pip`, el gestor de paquetes de Python. Abra su interfaz de línea de comandos y ejecute el siguiente comando:
```shell
:ProductInstall
```
**Nota:** Python debe estar añadido a la variable de entorno PATH para usar los comandos pip.
3. **Entorno de desarrollo integrado (IDE):** si bien no es estrictamente necesario, el uso de un IDE puede mejorar enormemente su experiencia de desarrollo. Proporciona características como autocompletar código, depuración y un flujo de trabajo más eficiente. Un IDE popular para el desarrollo en Python es PyCharm. Puede descargar e instalar PyCharm desde el sitio web de JetBrains [**https://www.jetbrains.com/pycharm/**](https://www.jetbrains.com/pycharm/).
4. **Editor de texto:** como alternativa, si prefiere trabajar con un editor de texto liviano, puede usar cualquier editor de texto de su elección, como Visual Studio Code, Sublime Text o Atom. Estos editores proporcionan resaltado de sintaxis y otras características útiles para el desarrollo en Python. También puede usar la aplicación IDLE de Python.
## Creación de un proyecto de Python con PyCharm
Después de instalar el IDE PyCharm, cree un proyecto Python en PyCharm siguiendo los pasos a continuación:
1. **Lanzar PyCharm:** Abra PyCharm desde el lanzador de aplicaciones de su sistema o el acceso directo del escritorio.
2. **Crear un Nuevo Proyecto:** Haga clic en "Crear Nuevo Proyecto" o abra un proyecto Python existente.
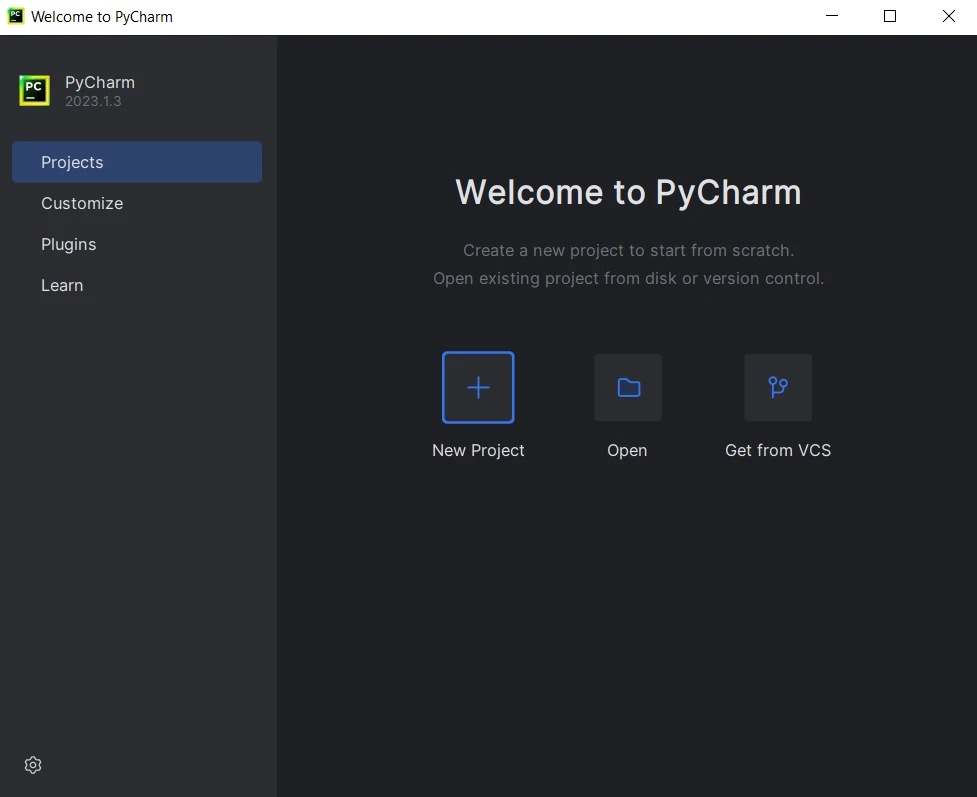
**PyCharm IDE**
3. **Configurar Configuración del Proyecto:** Proporcione un nombre para su proyecto y elija la ubicación para crear el directorio del proyecto. Seleccione el intérprete de Python para su proyecto. Luego haga clic en "Crear".
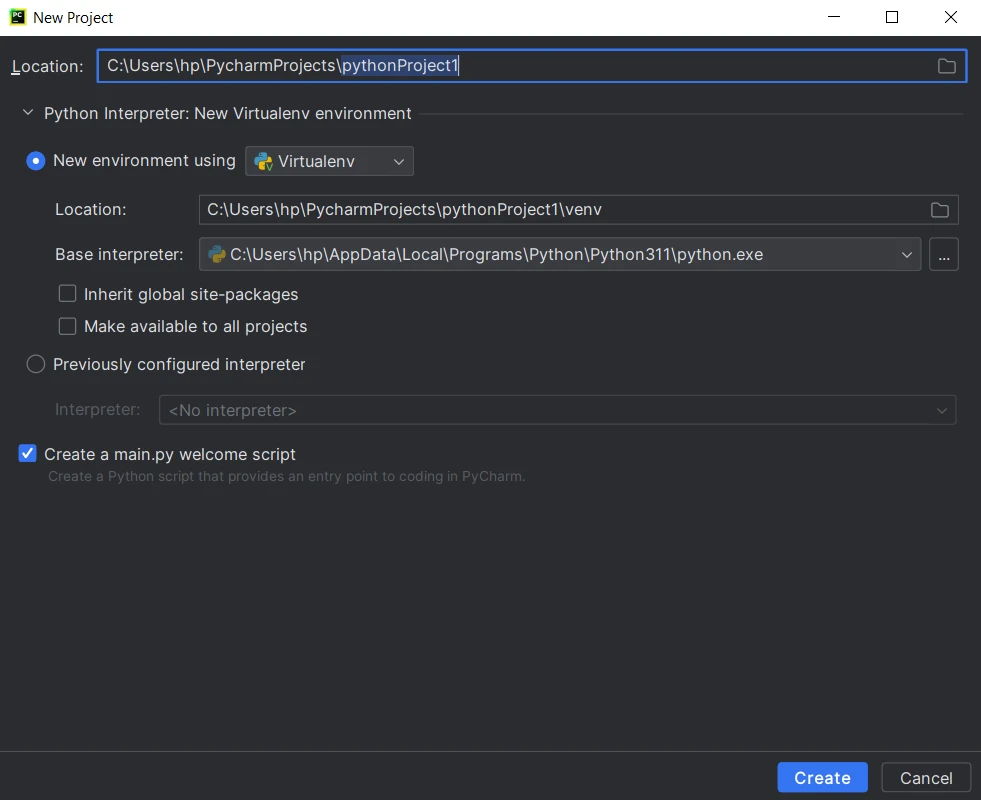
**Crear un nuevo proyecto Python en PyCharm**
4. **Crear Archivos Fuente:** PyCharm creará la estructura del proyecto, incluyendo un archivo Python principal y un directorio para archivos fuente adicionales. Comience a escribir el código y haga clic en el botón de ejecución o presione Shift+F10 para ejecutar el script.
## Extracción de texto de PDF en Python con IronPDF
Ahora vamos a adentrarnos en los pasos involucrados en extraer texto plano de archivos PDF usando IronPDF en el lenguaje de programación Python.
### Importe las bibliotecas necesarias
Para comenzar, importe las bibliotecas necesarias en su script de Python. En este caso, la muestra de código necesita importar la biblioteca **IronPDF**, que proporciona la funcionalidad para trabajar con archivos PDF.
```python
import ironpdf
```
### Configurar la clave de licencia
Para extraer todo el texto de un archivo PDF usando IronPDF, necesita tener IronPDF licenciado. Aplique la licencia o clave de prueba utilizando el siguiente comando:
```python
# Apply your license key
License.LicenseKey = "YOUR-LICENSE-KEY-HERE"
```
**Nota:** Sin una clave de licencia, la extracción de datos con IronPDF se restringe solo a unos pocos caracteres del archivo PDF. Obtenga una clave de licencia [comprando IronPDF](licensing) o inscribiéndose en una [prueba gratuita](trial-license).
### Cargar el documento PDF
A continuación, cargue el archivo PDF usando el método `PdfDocument.FromFile()` de IronPDF. Proporcione la ruta al archivo PDF como argumento para este método. Esto cargará el archivo PDF en un objeto `PdfDocument`.
```python
pdf = ironpdf.PdfDocument.FromFile("path/to/your/pdf_file.pdf")
```
#### Archivo de entrada
Para extraer texto del archivo PDF de entrada e imprimirlo en la pantalla, se utiliza el siguiente documento:
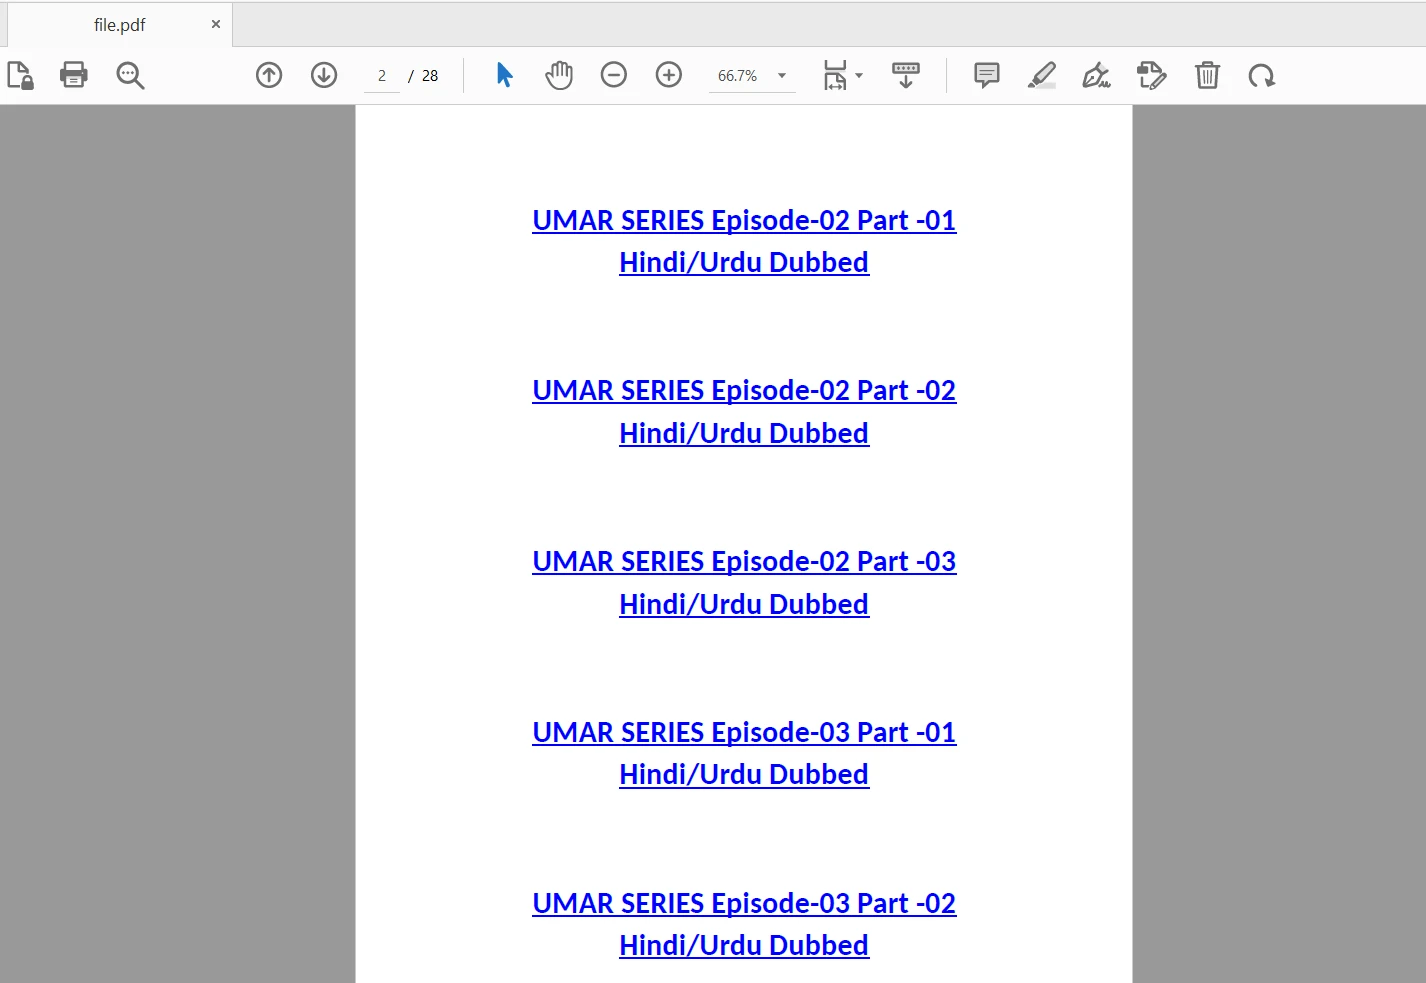
**El archivo de entrada**
### Extraer texto de archivos PDF
Una vez que se carga el documento PDF, puede extraer el contenido del texto utilizando el método `ExtractText`. Este método devuelve el texto extraído como una cadena.
```python
text = pdf.ExtractText()
```
### Procesar y utilizar el texto extraído
Ahora que ha extraído el texto del PDF, puede procesarlo y utilizarlo según sus requerimientos. Puede realizar tareas como analizar el texto, almacenarlo en una base de datos o usarlo para un procesamiento de datos adicional.
```python
# Process and utilize the extracted text
print(text)
# Perform other operations with the extracted text
```
#### Resultado
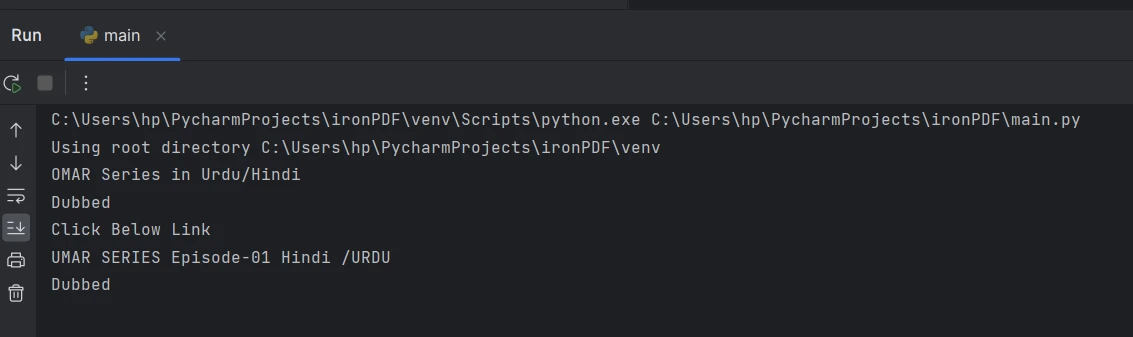
**El texto extraído de la consola**
### Extraer texto de una página específica de un archivo PDF
IronPDF también proporciona un método conveniente para extraer texto de páginas específicas dentro de un archivo PDF. Esta sección explorará cómo extraer texto de una página específica utilizando el método `ExtractTextFromPage` proporcionado por IronPDF.
El siguiente código demuestra cómo extraer texto de una página específica:
```python
# Extract text from a specific page in the document
page_2_text = pdf.ExtractTextFromPage(1)
```
En el código de muestra anterior, `pdf` representa el objeto `PdfDocument` obtenido tras cargar el documento PDF. El método `ExtractTextFromPage()` se usa para extraer texto de una página específica, indicada por el índice de la página pasado como argumento. En este caso, el texto se extrae de la segunda página o página número 2, que corresponde al índice de página 1.
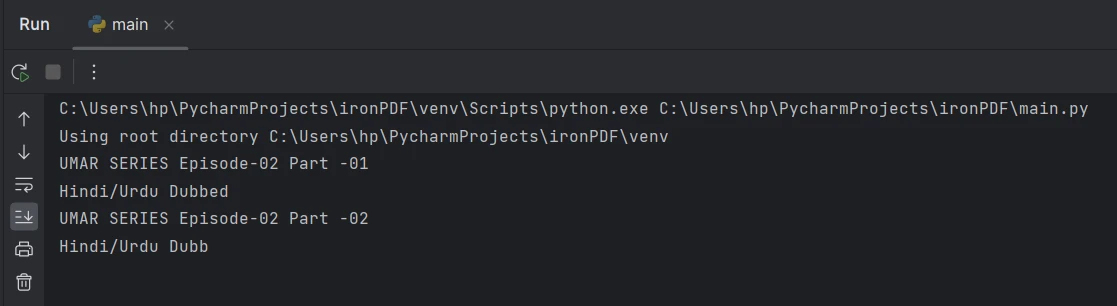
**Extraer texto de la página 2**
## Conclusión
Este artículo exploró cómo extraer texto de archivos PDF usando IronPDF en Python. Cubrió los pasos necesarios, incluyendo la importación de la biblioteca requerida, carga del documento PDF, extracción del contenido de texto y procesamiento del texto extraído.
Con las potentes capacidades de extracción de texto de IronPDF, puede automatizar la extracción y el procesamiento adicional del texto de los PDFs, permitiéndole procesar y analizar fácilmente la información textual dentro de los documentos PDF. Su API intuitiva y sus extensas capacidades lo hacen una opción ideal para una amplia gama de tareas relacionadas con PDF en el desarrollo de Python.
IronPDF es gratuito para propósitos de desarrollo, pero necesita ser licenciado para uso comercial. Para usarlo en modo de producción para prueba, obtenga una [prueba gratuita](trial-license). Descargue e instale la última versión de [IronPDF for Python](/python/) y pruébelo.
Este artículo demostrará cómo extraer todo el texto de archivos PDF usando IronPDF en Python, proporcionándole el conocimiento y fragmentos de código de Python para realizar esta tarea de manera eficiente.
Utilice el método FromFile para importar el archivo PDF
Extraer texto del PDF importado con el método ExtractText
Extraer texto de páginas específicas con el método ExtractTextFromPage
Genera el texto extraído en la consola o un archivo de texto
IronPDF - Biblioteca Python
IronPDF for Python es una poderosa biblioteca de PDF for Python que permite a los desarrolladores extraer texto de documentos PDF. Con IronPDF, puede automatizar la parte de extracción de datos del contenido textual de archivos PDF, facilitando el procesamiento y análisis de la información contenida en los documentos PDF.
IronPDF proporciona a los programadores de Python la capacidad de manipular, extraer datos e interactuar con archivos PDF utilizando Python, facilitando la automatización de diversas tareas relacionadas con PDF. Ya sea que necesite generar PDFs, modificar PDFs existentes, extraer datos del contenido o realizar otras operaciones con PDF, IronPDF simplifica el proceso con su API intuitiva y potentes capacidades.
Características clave
Algunas características de la biblioteca IronPDF for Python incluyen:
Antes de proceder con la extracción de texto usando IronPDF, asegúrese de tener los siguientes requisitos previos:
Instalación de Python: asegúrese de tener Python instalado en su sistema. IronPDF es compatible con versiones de Python 3.x, así que asegúrese de tener una instalación de Python compatible.
Biblioteca IronPDF: Instale la biblioteca IronPDF usando pip, el gestor de paquetes de Python. Abra su interfaz de línea de comandos y ejecute el siguiente comando:
> pip install ironpdf
pip install ironpdf
Nota: Python debe estar añadido a la variable de entorno PATH para usar los comandos pip.
Entorno de desarrollo integrado (IDE): si bien no es estrictamente necesario, el uso de un IDE puede mejorar enormemente su experiencia de desarrollo. Proporciona características como autocompletar código, depuración y un flujo de trabajo más eficiente. Un IDE popular para el desarrollo en Python es PyCharm. Puede descargar e instalar PyCharm desde el sitio web de JetBrains https://www.jetbrains.com/pycharm/.
Editor de texto: como alternativa, si prefiere trabajar con un editor de texto liviano, puede usar cualquier editor de texto de su elección, como Visual Studio Code, Sublime Text o Atom. Estos editores proporcionan resaltado de sintaxis y otras características útiles para el desarrollo en Python. También puede usar la aplicación IDLE de Python.
Creación de un proyecto de Python con PyCharm
Después de instalar el IDE PyCharm, cree un proyecto Python en PyCharm siguiendo los pasos a continuación:
Lanzar PyCharm: Abra PyCharm desde el lanzador de aplicaciones de su sistema o el acceso directo del escritorio.
Crear un Nuevo Proyecto: Haga clic en "Crear Nuevo Proyecto" o abra un proyecto Python existente.
PyCharm IDE
Configurar Configuración del Proyecto: Proporcione un nombre para su proyecto y elija la ubicación para crear el directorio del proyecto. Seleccione el intérprete de Python para su proyecto. Luego haga clic en "Crear".
Crear un nuevo proyecto Python en PyCharm
Crear Archivos Fuente: PyCharm creará la estructura del proyecto, incluyendo un archivo Python principal y un directorio para archivos fuente adicionales. Comience a escribir el código y haga clic en el botón de ejecución o presione Shift+F10 para ejecutar el script.
Extracción de texto de PDF en Python con IronPDF
Ahora vamos a adentrarnos en los pasos involucrados en extraer texto plano de archivos PDF usando IronPDF en el lenguaje de programación Python.
Importe las bibliotecas necesarias
Para comenzar, importe las bibliotecas necesarias en su script de Python. En este caso, la muestra de código necesita importar la biblioteca IronPDF, que proporciona la funcionalidad para trabajar con archivos PDF.
import ironpdf
import ironpdf
Python
Configurar la clave de licencia
Para extraer todo el texto de un archivo PDF usando IronPDF, necesita tener IronPDF licenciado. Aplique la licencia o clave de prueba utilizando el siguiente comando:
# Apply your license keyLicense.LicenseKey = "YOUR-LICENSE-KEY-HERE"
# Apply your license key
License.LicenseKey = "YOUR-LICENSE-KEY-HERE"
Python
Nota: Sin una clave de licencia, la extracción de datos con IronPDF se restringe solo a unos pocos caracteres del archivo PDF. Obtenga una clave de licencia comprando IronPDF o inscribiéndose en una prueba gratuita.
Cargar el documento PDF
A continuación, cargue el archivo PDF usando el método PdfDocument.FromFile() de IronPDF. Proporcione la ruta al archivo PDF como argumento para este método. Esto cargará el archivo PDF en un objeto PdfDocument.
pdf = ironpdf.PdfDocument.FromFile("path/to/your/pdf_file.pdf")
pdf = ironpdf.PdfDocument.FromFile("path/to/your/pdf_file.pdf")
Python
Archivo de entrada
Para extraer texto del archivo PDF de entrada e imprimirlo en la pantalla, se utiliza el siguiente documento:
El archivo de entrada
Extraer texto de archivos PDF
Una vez que se carga el documento PDF, puede extraer el contenido del texto utilizando el método ExtractText. Este método devuelve el texto extraído como una cadena.
text = pdf.ExtractText()
text = pdf.ExtractText()
Python
Procesar y utilizar el texto extraído
Ahora que ha extraído el texto del PDF, puede procesarlo y utilizarlo según sus requerimientos. Puede realizar tareas como analizar el texto, almacenarlo en una base de datos o usarlo para un procesamiento de datos adicional.
# Process and utilize the extracted textprint(text)# Perform other operations with the extracted text
# Process and utilize the extracted text
print(text)
# Perform other operations with the extracted text
Python
Resultado
El texto extraído de la consola
Extraer texto de una página específica de un archivo PDF
IronPDF también proporciona un método conveniente para extraer texto de páginas específicas dentro de un archivo PDF. Esta sección explorará cómo extraer texto de una página específica utilizando el método ExtractTextFromPage proporcionado por IronPDF.
El siguiente código demuestra cómo extraer texto de una página específica:
# Extract text from a specific page in the documentpage_2_text = pdf.ExtractTextFromPage(1)
# Extract text from a specific page in the document
page_2_text = pdf.ExtractTextFromPage(1)
Python
En el código de muestra anterior, pdf representa el objeto PdfDocument obtenido tras cargar el documento PDF. El método ExtractTextFromPage() se usa para extraer texto de una página específica, indicada por el índice de la página pasado como argumento. En este caso, el texto se extrae de la segunda página o página número 2, que corresponde al índice de página 1.
Extraer texto de la página 2
Conclusión
Este artículo exploró cómo extraer texto de archivos PDF usando IronPDF en Python. Cubrió los pasos necesarios, incluyendo la importación de la biblioteca requerida, carga del documento PDF, extracción del contenido de texto y procesamiento del texto extraído.
Con las potentes capacidades de extracción de texto de IronPDF, puede automatizar la extracción y el procesamiento adicional del texto de los PDFs, permitiéndole procesar y analizar fácilmente la información textual dentro de los documentos PDF. Su API intuitiva y sus extensas capacidades lo hacen una opción ideal para una amplia gama de tareas relacionadas con PDF en el desarrollo de Python.
IronPDF es gratuito para propósitos de desarrollo, pero necesita ser licenciado para uso comercial. Para usarlo en modo de producción para prueba, obtenga una prueba gratuita. Descargue e instale la última versión de IronPDF for Python y pruébelo.
Curtis Chau tiene una licenciatura en Ciencias de la Computación (Carleton University) y se especializa en el desarrollo front-end con experiencia en Node.js, TypeScript, JavaScript y React. Apasionado por crear interfaces de usuario intuitivas y estéticamente agradables, disfruta trabajando con frameworks modernos y creando manuales bien estructurados y visualmente atractivos.


 PyCharm IDE
 Crear un nuevo proyecto Python en PyCharm
 El archivo de entrada
 El texto extraído de la consola
 Extraer texto de la página 2







