



Mis à jour 21 avril 2026
Comment convertir TIFF en PDF en Java
Ce guide complet vous guidera à travers les étapes pour convertir une image TIFF en PDF sans effort en Java en utilisant IronPDF.
Lire la suite

Cet article explorera comment extraire des images d'un document PDF existant et les enregistrer dans un seul dossier en utilisant le langage de programmation Java. À cette fin, la bibliothèque IronPDF for Java est utilisée pour extraire des images.
extractAllImages pour extraire les imagesIronPDF est une bibliothèque Java conçue pour aider les développeurs à générer, modifier et extraire des données de fichiers PDF dans leurs applications Java. Avec IronPDF, vous pouvez créer des documents PDF à partir de diverses sources, telles que HTML, images, et plus encore. De plus, vous avez la possibilité de fusionner, diviser et manipuler des PDFs existants. IronPDF comprend également des fonctionnalités de sécurité, telles que la protection par mot de passe et les signatures numériques.
Développé et maintenu par Iron Software, IronPDF est connu pour sa capacité à extraire du texte des PDFs, HTML et URL. Cela en fait un outil polyvalent et puissant pour une variété d'applications, que vous créiez des PDFs de toutes pièces ou que vous travailliez avec des existants.
Avant d'utiliser IronPDF pour extraire des données d'un fichier PDF, quelques prérequis doivent être remplis :
Installer IronPDF for Java est un processus simple, pourvu que toutes les exigences soient remplies. Ce guide utilisera JetBrains IntelliJ IDEA pour démontrer l'installation et exécuter un extrait de code.
Lancer IntelliJ IDEA : Ouvrir JetBrains IntelliJ IDEA sur votre système.
Créer un projet Maven : Dans IntelliJ IDEA, créer un nouveau projet Maven. Cela fournira un environnement adéquat pour l'installation d'IronPDF for Java.
 Créer un nouveau projet Maven
Une nouvelle fenêtre apparaîtra. Entrez le nom du projet et cliquez sur Terminer.
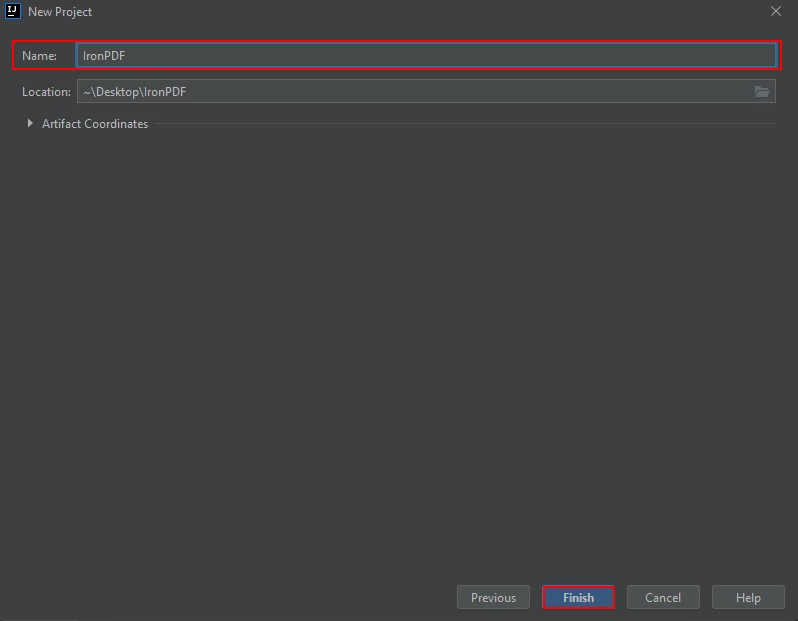 Entrer le nom du projet
Après avoir cliqué sur Terminer, un nouveau projet s'ouvrira sur un fichier pom.xml pour ajouter les dépendances Maven d'IronPDF for Java.
Ensuite, ajoutez les dépendances suivantes dans le fichier pom.xml ou vous pouvez télécharger le fichier JAR depuis le dépôt Maven suivant.
<dependency>
    <groupId>com.ironsoftware</groupId>
    <artifactId>ironpdf</artifactId>
    <version>YOUR_VERSION_HERE</version>
</dependency>Une fois que vous aurez placé les dépendances dans le fichier pom.xml, une petite icône apparaîtra dans le coin supérieur droit du fichier.
 Le fichier pom.xml avec une petite icône pour installer des dépendances
Cliquez sur cette icône pour installer les dépendances Maven de IronPDF for Java. Cela ne prendra que quelques minutes selon votre connexion Internet.
Vous pouvez extraire des images d'un document PDF en utilisant IronPDF avec une seule méthode appelée extractAllImages. Cette méthode renvoie toutes les images disponibles dans un fichier PDF. Ensuite, vous pouvez enregistrer toutes les images extraites dans le chemin de fichier de votre choix en utilisant la méthode ImageIO.write en fournissant le chemin et le format de l'image de sortie.
Dans l'exemple ci-dessous, les images d'un document PDF seront extraites et enregistrées dans le système de fichiers sous forme d'images PNG.
import com.ironsoftware.ironpdf.PdfDocument;
import javax.imageio.ImageIO;
import java.awt.image.BufferedImage;
import java.nio.file.Files;
import java.nio.file.Paths;
import java.util.List;

public class Main {
    public static void main(String[] args) throws Exception {
        // Load PDF document from file
        PdfDocument pdf = PdfDocument.fromFile(Paths.get("Final Project Report Craft Arena.pdf"));

        // Extract all images from the PDF document
        List<BufferedImage> images = pdf.extractAllImages();
        int i = 0;

        // Save each extracted image to the filesystem as a PNG
        for (BufferedImage image : images) {
            ImageIO.write(image, "PNG", Files.newOutputStream(Paths.get("image" + ++i + ".png")));
        }
    }
}Le programme ci-dessus ouvre le fichier "Final Project Report Craft Arena.pdf" et utilise la méthode extractAllImages pour extraire toutes les images du fichier dans une liste d'objets BufferedImage. Il enregistre ensuite chaque nouvelle image de fichier dans des fichiers PNG séparés avec un nom unique.
 Extraction d'Images à partir d'un PDF
Cette section expliquera comment extraire des images directement depuis des URL. Dans le code ci-dessous, l'URL est convertie en page PDF et la navigation bascule pour extraire les images du PDF.
import com.ironsoftware.ironpdf.PdfDocument;
import javax.imageio.ImageIO;
import java.awt.image.BufferedImage;
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.Paths;
import java.util.List;

public class Main {
    public static void main(String[] args) throws IOException {
        // Render PDF from a URL
        PdfDocument pdf = PdfDocument.renderUrlAsPdf("https://www.amazon.com/?tag=hp2-brobookmark-us-20");

        // Extract all images from the rendered PDF document
        List<BufferedImage> images = pdf.extractAllImages();
        int i = 0;

        // Save each extracted image to the filesystem as a PNG
        for (BufferedImage image : images) {
            ImageIO.write(image, "PNG", Files.newOutputStream(Paths.get("image" + ++i + ".png")));
        }
    }
}Dans le code ci-dessus, l'URL de la page d'accueil d'Amazon est fournie en entrée, et elle renvoie 74 images.
 Extraction d'Images à partir d'un PDF
Extraire des images d'un document PDF peut être fait en Java en utilisant la bibliothèque IronPDF. Pour installer IronPDF, vous devez avoir Java, un IDE Java (Eclipse ou IntelliJ), Maven, et la bibliothèque IronPDF installés et intégrés à votre projet. Le processus d'extraction d'images d'un document PDF en utilisant IronPDF est simple et ne nécessite qu'un seul appel de méthode à extractAllImages. Vous pouvez ensuite enregistrer les images dans un chemin de fichier de votre choix en utilisant la méthode ImageIO.write.
Cet article fournit un guide étape par étape sur comment extraire des images d'un document PDF en utilisant Java et la bibliothèque IronPDF. Plus de détails, y compris des informations sur comment extraire du texte des PDFs, peuvent être trouvés dans l'exemple de code d'extraction de texte.
IronPDF est une bibliothèque avec une licence commerciale, à partir de $999. Cependant, vous pouvez l'évaluer en production avec un essai gratuit.

Curtis Chau détient un baccalauréat en informatique (Université de Carleton) et se spécialise dans le développement front-end avec expertise en Node.js, TypeScript, JavaScript et React. Passionné par la création d'interfaces utilisateur intuitives et esthétiquement plaisantes, Curtis aime travailler avec des frameworks modernes et créer des manuels bien structurés et visuellement attrayants.


IronPDF fait partie de IRONSUITE
10 API .NET pour vos documents


Lorsque vous avez besoin que votre PDF ressemble à HTML, rapidement.

