



Mis à jour 21 avril 2026
Comment convertir TIFF en PDF en Java
Ce guide complet vous guidera à travers les étapes pour convertir une image TIFF en PDF sans effort en Java en utilisant IronPDF.
Lire la suite

Cet article créera un analyseur PDF en Java en utilisant la bibliothèque IronPDF de manière efficace.
IronPDF for Java est une bibliothèque PDF Java qui permet la création, la lecture et la manipulation de documents PDF avec facilité et précision. Il est construit sur le succès de IronPDF for .NET et fournit des fonctionnalités efficaces sur différentes plateformes. IronPDF for Java utilizes the IronPdfEngine which is fast and optimized for performance.
Avec IronPDF, vous pouvez extraire du texte et des images des fichiers PDF et il permet également la création de PDF à partir de diverses sources y compris des chaînes HTML, des fichiers, des URL et des images. De plus, vous pouvez facilement ajouter du nouveau contenu, insérer des signatures avec IronPDF, et intégrer des métadonnées dans des documents PDF. IronPDF est spécialement conçu pour Java 8+, Scala, et Kotlin, et est compatible avec les plateformes Windows, Linux, et Cloud.
fromFileextractAllTextrenderUrlAsPdf pour rendre un PDF à partir d'une URLextractAllImagesPour réaliser un projet d'analyse PDF en Java, vous aurez besoin des outils suivants :
Ajouter la dépendance IronPDF dans le fichier pom.xml dans un projet Maven.
<dependency>
    <groupId>com.ironsoftware</groupId>
    <artifactId>ironpdf</artifactId>
    <version>[LATEST_VERSION]</version>
</dependency>Visitez le site du dépôt Maven pour le dernier package IronPDF for Java.
Slf4j-Simple : Cette dépendance est également requise pour ajouter du contenu à un document existant. Il peut être ajouté en utilisant le gestionnaire de dépendances Maven dans IntelliJ, ou il peut être directement téléchargé depuis le site Web de Maven. Ajoutez la dépendance suivante au fichier pom.xml :
<dependency>
    <groupId>org.slf4j</groupId>
    <artifactId>slf4j-simple</artifactId>
    <version>2.0.5</version>
</dependency>Une fois que toutes les prérequis sont installés, la première étape consiste à importer les packages nécessaires d'IronPDF pour travailler avec un document PDF. Ajoutez le code suivant en haut du fichier Main.java :
import com.ironsoftware.ironpdf.*;
import java.io.IOException;
import java.nio.file.Paths;Certaines méthodes disponibles dans IronPDF nécessitent une licence pour être utilisées. Vous pouvez acheter une licence ou essayer IronPDF avec un essai gratuit. Vous pouvez définir la clé comme suit :
License.setLicenseKey("YOUR-KEY");Pour analyser un document existant pour l'extraction de contenu, la classe PdfDocument est utilisée. Sa méthode statique [fromFile](/java/object-reference/api/com/ironsoftware/ironpdf/PdfDocument.html#fromFile(java.nio.file.Path) est utilisée pour analyser un fichier PDF depuis un chemin spécifique avec un nom de fichier spécifique dans un programme Java. Le code est le suivant :
PdfDocument parsedDocument = PdfDocument.fromFile(Paths.get("sample.pdf")); Document analysé
IronPDF for Java fournit une méthode facile pour extraire du texte à partir de documents PDF. Le snippet de code suivant est pour extraire des données textuelles d'un fichier PDF se trouve ci-dessous :
String extractedText = parsedDocument.extractAllText();Le code ci-dessus produit la sortie donnée ci-dessous :
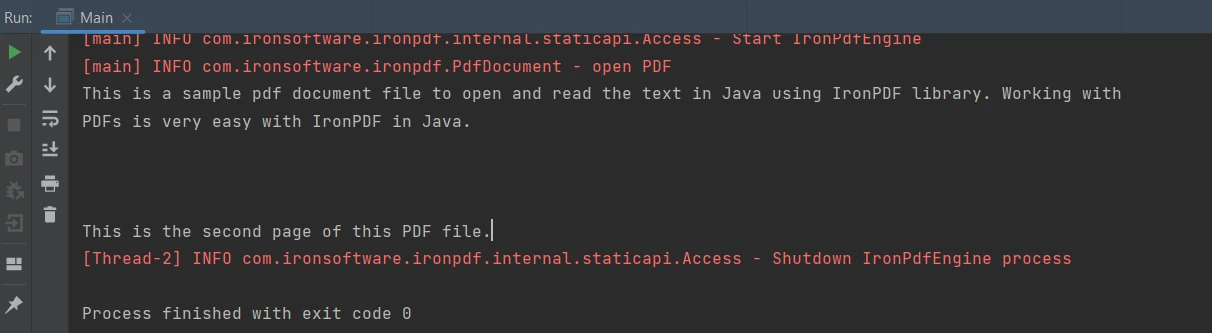 Sortie
La capacité d'IronPDF for Java n'est pas seulement limitée aux PDF existants, mais elle peut également créer et analyser un nouveau fichier pour en extraire du contenu. Ici, ce tutoriel va créer un fichier PDF à partir d'une URL et en extraire le contenu. L'exemple suivant montre comment réaliser cette tâche :
public class Main {
    public static void main(String[] args) throws IOException {
        License.setLicenseKey("YOUR-KEY");

        PdfDocument parsedDocument = PdfDocument.renderUrlAsPdf("https://ironpdf.com/java/");
        String extractedText = parsedDocument.extractAllText();
        System.out.println("Text Extracted from URL:\n" + extractedText);
    }
}La sortie est la suivante :
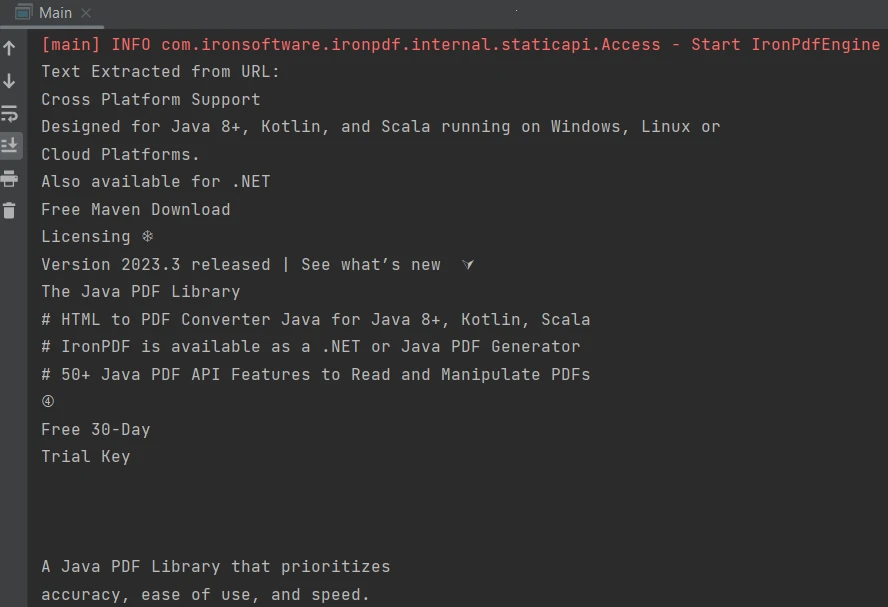 Sortie
IronPDF fournit également une option facile pour extraire toutes les images des documents analysés. Ici, le tutoriel utilisera l'exemple précédent pour voir à quel point il est facile d'extraire les images des fichiers PDF.
import com.ironsoftware.ironpdf.*;

import javax.imageio.ImageIO;
import java.awt.image.BufferedImage;
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.Paths;
import java.util.List;

public class Main {
    public static void main(String[] args) throws IOException {
        License.setLicenseKey("YOUR-KEY");

        PdfDocument parsedDocument = PdfDocument.renderUrlAsPdf("https://ironpdf.com/java/");

        try {
            List<BufferedImage> images = parsedDocument.extractAllImages();
            System.out.println("Number of images extracted from the website: " + images.size());

            int i = 0;
            for (BufferedImage image : images) {
                ImageIO.write(image, "PNG", Files.newOutputStream(Paths.get("assets/extracted_" + ++i + ".png")));
            }
        } catch (Exception exception) {
            System.out.println("Failed to extract images from the website");
            exception.printStackTrace();
        }
    }
}The [extractAllImages](/java/object-reference/api/com/ironsoftware/ironpdf/PdfDocument.html#extractAllImages() method returns a list of BufferedImages. Chaque BufferedImage peut ensuite être stocké sous forme d'images PNG à un emplacement en utilisant la méthode ImageIO.write. Il y a 34 images dans le fichier PDF analysé et chaque image est parfaitement extraite.
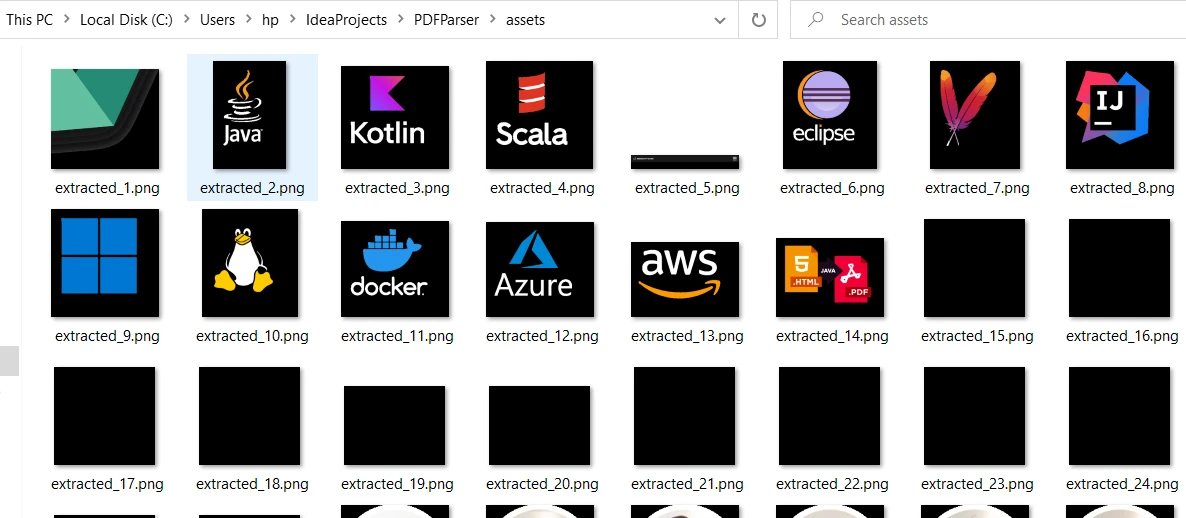 Images extraites
L'extraction de contenu à partir des limites tabulaires dans un fichier PDF est facilitée par un simple code d'une ligne en utilisant la [méthode extractAllText](/java/object-reference/api/com/ironsoftware/ironpdf/PdfDocument.html#extractAllText(). Le snippet de code suivant montre comment extraire du texte d'un tableau dans un fichier PDF :
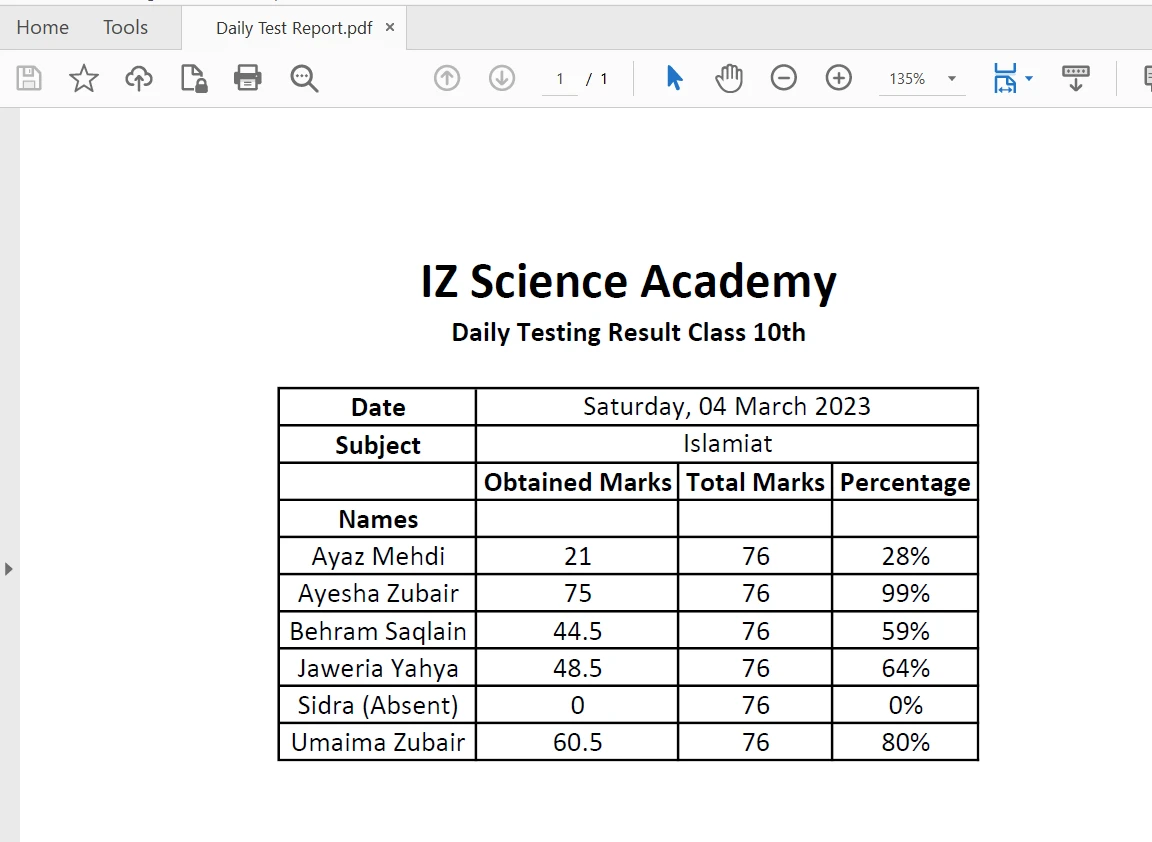 Tableau dans un PDF
PdfDocument parsedDocument = PdfDocument.fromFile(Paths.get("table.pdf"));
String extractedText = parsedDocument.extractAllText();
System.out.println(extractedText);La sortie est la suivante :
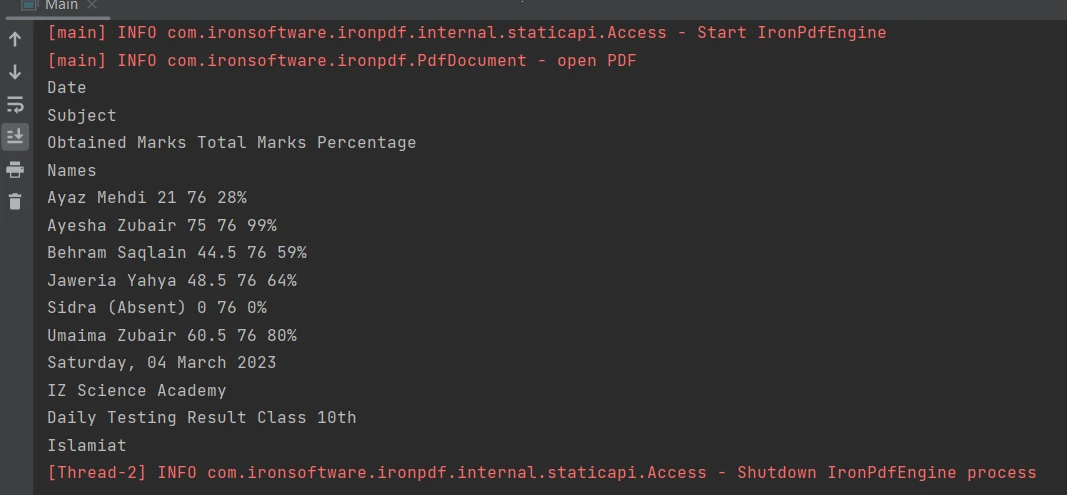 Sortie
Cet article a démontré comment analyser un document PDF existant ou créer un nouveau fichier analyseur PDF à partir d'une URL pour en extraire des données en Java avec IronPDF. Après ouverture du fichier, il peut extraire des données tabulaires, des images, et du texte du PDF, et peut également ajouter le texte extrait à un fichier texte pour une utilisation ultérieure.
Pour des informations plus détaillées sur la façon de travailler avec des fichiers PDF de manière programmatique en Java, veuillez visiter ces exemples de création de fichiers PDF.
La bibliothèque IronPDF for Java est gratuite à des fins de développement avec un essai gratuit disponible. Cependant, pour une utilisation commerciale, il peut être licencié par Iron Software, à partir de $999.

Curtis Chau détient un baccalauréat en informatique (Université de Carleton) et se spécialise dans le développement front-end avec expertise en Node.js, TypeScript, JavaScript et React. Passionné par la création d'interfaces utilisateur intuitives et esthétiquement plaisantes, Curtis aime travailler avec des frameworks modernes et créer des manuels bien structurés et visuellement attrayants.


IronPDF fait partie de IRONSUITE
10 API .NET pour vos documents


Lorsque vous avez besoin que votre PDF ressemble à HTML, rapidement.

