



Mis à jour 21 avril 2026
Comment convertir TIFF en PDF en Java
Ce guide complet vous guidera à travers les étapes pour convertir une image TIFF en PDF sans effort en Java en utilisant IronPDF.
Lire la suite

Cet article démontre comment les fichiers PDF sont lus en Java en utilisant la bibliothèque PDF pour le projet démo Java, nommé Vue d'ensemble de la bibliothèque Java IronPDF, pour lire le texte et les objets de type métadonnées dans les fichiers PDF ainsi que pour créer des documents chiffrés.
PdfDocument.fromFile [documentation de la méthode](/java/object-reference/api/com/ironsoftware/ironpdf/PdfDocument.html#fromFile(java.nio.file.Path).Pour rationaliser le processus de lecture des fichiers PDF en Java, les développeurs se tournent souvent vers des bibliothèques tierces qui offrent des solutions complètes et efficaces. Une telle bibliothèque remarquable est IronPDF for Java.
IronPDF est conçu pour être convivial pour les développeurs, offrant une API simple qui abstrait les complexités de la manipulation des pages PDF. Avec IronPDF, les développeurs Java peuvent intégrer facilement des capacités de lecture de PDF dans leurs projets, réduisant le temps et l'effort de développement. Cette bibliothèque prend en charge un large éventail de fonctionnalités PDF, en faisant un choix polyvalent pour diverses utilisations.
Les principales caractéristiques incluent la possibilité de créer un fichier PDF à partir de différents formats incluant HTML, JavaScript, CSS, documents XML, et divers formats d'image. En outre, IronPDF offre la possibilité d'ajouter des en-têtes et pieds de page aux PDF, créer des tableaux dans les documents PDF, et bien plus encore.
Pour installer IronPDF, assurez-vous d'avoir un compilateur Java fiable. Cet article recommande d'utiliser IntelliJ IDEA.
Lancez IntelliJ IDEA et initiez un nouveau projet Maven.
Une fois le projet établi, accédez au fichier pom.xml. Insérez les dépendances Maven suivantes pour intégrer IronPDF :
<dependency>
    <groupId>com.ironsoftware</groupId>
    <artifactId>ironpdf</artifactId>
    <version>YOUR_VERSION_HERE</version>
</dependency>Après avoir ajouté ces dépendances, cliquez sur le petit bouton qui apparaît sur le côté droit de l'écran pour les installer.
Explorons un exemple de code Java simple qui montre comment utiliser IronPDF pour lire le contenu d'un fichier PDF. Dans cet exemple, concentrons-nous sur la méthode d'extraction de texte d'un document PDF.
// Importing necessary classes from IronPDF and Java libraries
import com.ironsoftware.ironpdf.*;

import java.io.IOException;
import java.nio.file.Paths;

// Class definition
class Test {
    public static void main(String[] args) throws IOException {
        // Setting the license key for IronPDF (replace "License-Key" with a valid key)
        License.setLicenseKey("License-Key");

        // Loading a PDF document from the file "html_file_saved.pdf"
        PdfDocument pdf = PdfDocument.fromFile(Paths.get("html_file_saved.pdf"));

        // Extracting all text content from the PDF document
        String text = pdf.extractAllText();

        // Printing the extracted text to the console
        System.out.println(text);
    }
}Ce code Java utilise la bibliothèque IronPDF pour extraire du texte d'un fichier PDF spécifié. Il importera la bibliothèque Java ainsi que définira la clé de licence, une condition préalable pour utiliser la bibliothèque. Le code charge ensuite un document PDF à partir du fichier "html_file_saved.pdf" et extrait tout son contenu textuel du fichier en tant que tampon de chaîne interne. Le texte extrait est stocké dans une variable et imprimé par la suite sur la console.
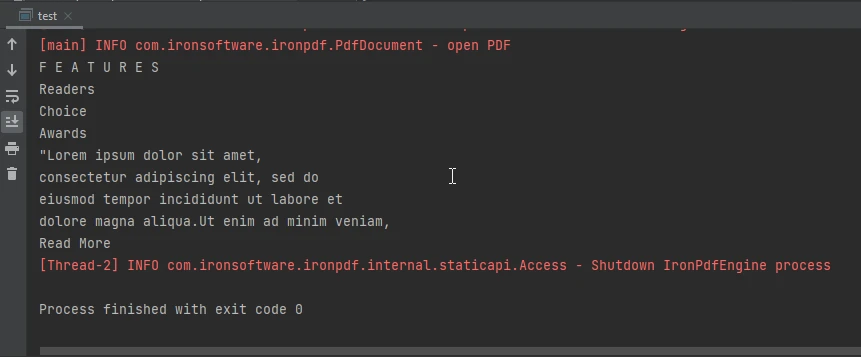 La sortie de la console
En étendant ses capacités au-delà de l'extraction de texte, IronPDF offre également le support pour l'extraction de métadonnées à partir des fichiers PDF. Pour illustrer cette fonctionnalité, explorons un exemple de code Java qui montre le processus de récupération des métadonnées d'un document PDF.
// Importing necessary classes from IronPDF and Java libraries
import com.ironsoftware.ironpdf.*;
import com.ironsoftware.ironpdf.metadata.MetadataManager;

import java.io.IOException;
import java.nio.file.Paths;

// Class definition
class Test {
    public static void main(String[] args) throws IOException {
        // Setting the license key for IronPDF (replace "License-Key" with a valid key)
        License.setLicenseKey("License-Key");

        // Loading a PDF document from the file "html_file_saved.pdf"
        PdfDocument document = PdfDocument.fromFile(Paths.get("html_file_saved.pdf"));

        // Creating a MetadataManager object to access document metadata
        MetadataManager metadata = document.getMetadata();

        // Extracting the author information from the document metadata
        String author = metadata.getAuthor();

        // Printing the extracted author information to the console
        System.out.println(author);
    }
}Ce code Java utilise la bibliothèque IronPDF pour extraire des métadonnées, en particulier les informations de l'auteur, d'un document PDF. Il commence par charger un document PDF à partir du fichier "html_file_saved.pdf". Le code récupère les métadonnées du document en utilisant la documentation de la classe MetadataManager, en récupérant spécifiquement les informations de l'auteur. Les détails de l'auteur extraits sont stockés dans une variable et imprimés sur la console.
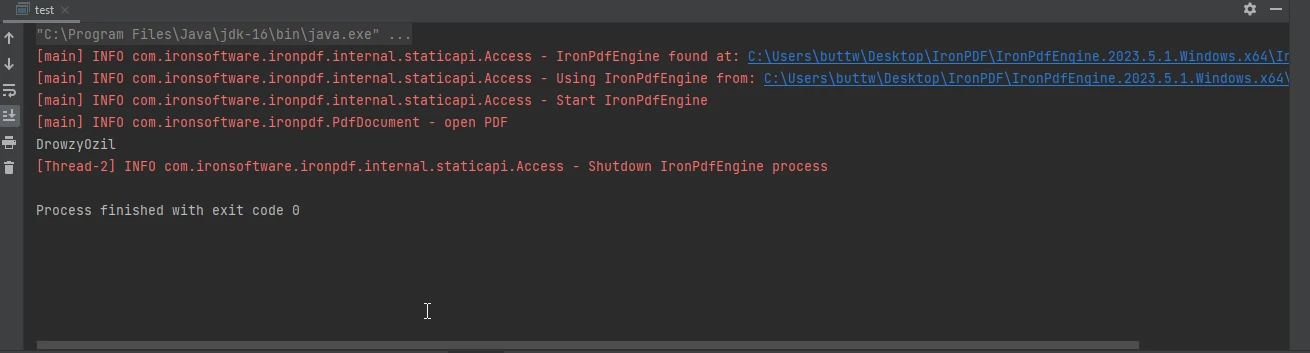 La sortie de la console
En conclusion, lire un document PDF existant dans un programme Java est une compétence précieuse qui ouvre un monde de possibilités aux développeurs. Que ce soit pour extraire du texte, des images ou d'autres données, la capacité à manipuler des PDF par programmation est un aspect crucial de nombreuses applications. IronPDF for Java sert de solution robuste et efficace pour les développeurs cherchant à intégrer des capacités de lecture de PDF dans leurs projets Java.
En suivant les étapes d'installation et en explorant les exemples de code fournis, les développeurs peuvent rapidement tirer parti de la puissance d'IronPDF pour créer de nouveaux fichiers et gérer les tâches liées aux PDF avec facilité. En plus de cela, on peut également explorer davantage ses capacités pour créer des documents chiffrés.
Le portail produit IronPDF offre un support étendu pour ses développeurs. Pour en savoir plus sur le fonctionnement d'IronPDF for Java, visitez ces pages de documentation complètes. De plus, IronPDF propose une page d'offre de licence d'essai gratuite qui est une excellente opportunité pour explorer IronPDF et ses fonctionnalités.

Curtis Chau détient un baccalauréat en informatique (Université de Carleton) et se spécialise dans le développement front-end avec expertise en Node.js, TypeScript, JavaScript et React. Passionné par la création d'interfaces utilisateur intuitives et esthétiquement plaisantes, Curtis aime travailler avec des frameworks modernes et créer des manuels bien structurés et visuellement attrayants.


IronPDF fait partie de IRONSUITE
10 API .NET pour vos documents


Lorsque vous avez besoin que votre PDF ressemble à HTML, rapidement.

