



更新日 2026年4月23日
Microsoft.Extensions.AIを使用した .NET での LLM 統合の簡素化
AI はソフトウェア開発を変革していますが、.NET への大規模言語モデル (LLM) の統合はこれまで複雑でした。IronPdf.AI を使用して AI 統合をさらに進め、OpenAI を活用した PDF 解析、データ抽出、およびコンテンツの要約を .NET アプリケーションにもたらします。
詳しく読む

.NET開発では、異なるデータ型間の変換は重要なスキルであり、特に文字列や整数のような一般的な型を扱う際に重要です。 最も頻繁に行う操作の一つは、文字列変数を整数値に変換することです。 ユーザー入力、ファイル、またはデータベースからの数値文字列を扱う場合でも、文字列変数を整数に効率よく変換できることが重要です。 幸いなことに、C# には int.Parse() および int.TryParse() メソッドのおかげで、これらの変換を効果的に実行するためのさまざまな方法が提供されています。
一方、PDF を扱う際には、請求書、レポート、またはフォームのような整数文字列を含むことが多い文書を扱う際に特に、テキストデータを抽出して操作する能力がさらに重要になります。 ここで役立つのが IronPDF です。これは、.NET で PDF を扱うための強力で使いやすいライブラリです。 この記事では、C#での文字列から整数への変換方法と、IronPDF が .NETプロジェクト内で PDF 関連タスクを処理するのにどのように役立つかについて説明します。
文字列から整数への変換は、文字列として提供された数値データがある多くのアプリケーションで重要なステップです。 以下は一般的な使用例です:
*ユーザー入力処理:ユーザーがフォームまたは UI 要素を通じて数値を入力する場合、多くの場合、データは文字列として入力されます。 これらの値を整数に変換することは、計算やさらにデータ操作が必要な場合に必要です。 *外部ソースからのデータ:ファイル、データベース、または PDF などのドキュメントからデータを読み取る場合、データは多くの場合文字列形式になります。 これらの文字列変数を整数に変換することで、正確な操作、検証、計算を行うことができます。 *パフォーマンスと可読性:整数演算は文字列演算よりも高速であり、データを意図した型のままにしておくと、コードの読みやすさと保守性が向上します。 *デフォルト値の処理:入力文字列に有効な数値が含まれていない場合、変換が失敗したときにデフォルト値を提供して、アプリケーションが引き続きスムーズに実行されるようにする必要があります。
C# では、文字列変数を整数値に変換する方法がいくつかあります。 最も一般的なアプローチには、Parse メソッド、TryParse メソッド、および Convert クラスが含まれます。
int.Parse() メソッドは、文字列を整数に変換する簡単な方法です。 ただし、入力文字列が正しい形式(つまり、有効な数値)であることを前提としており、変換に失敗すると FormatException をスローします。
int number = int.Parse("123");Dim number As Integer = Integer.Parse("123")Dim number As Integer = Integer.Parse("123")利点:
デメリット:
より安全な変換を行うには、TryParse メソッドが一般に使用されます。 それは変換を試み、変換が成功したかどうかを示す真偽値を返します。 変換が失敗した場合は例外をスローせず、単に false を返します。 結果は out パラメータに格納されます。
bool success = int.TryParse("123", out int result);bool success = int.TryParse("123", out int result);Dim result As Integer
Dim success As Boolean = Integer.TryParse("123", result)Dim result As Integer
Dim success As Boolean = Integer.TryParse("123", result)ここで、success は変換が成功したかどうかを示すブール値で、result は変換された整数で、out パラメーターに格納されます。
利点:
デメリット:
文字列変数を整数値に変換する別の方法として、Convert クラスを使用することができます。 変換クラスには、文字列から整数を含む、異なるデータ型を変換できるメソッドが含まれています。
int number = Convert.ToInt32("123");int number = Convert.ToInt32("123");Dim number As Integer = Convert.ToInt32("123")Dim number As Integer = Convert.ToInt32("123")利点:
Convert クラスは、文字列や整数に限らず、より広範囲のデータ型を処理できます。デメリット:
PDF を扱う場合、文書に含まれる整数文字列を抽出して処理する必要があるかもしれません。 IronPDF は PDF の操作を簡単にし、テキストや数値をシームレスに抽出できるようにします。 これは、請求書番号、数量、またはその他の重要なデータを抽出して変換する必要があるシナリオで特に役立ちます。
IronPDF は、PDF を操作するための包括的な機能を提供しています。これには次のものが含まれます:
これらの機能により、IronPDF は PDF 機能を必要とする任意のアプリケーションにとって強力なツールとなり、単純なレポートから複雑な文書処理システムに対応します。
文字列からの整数変換とPDF処理が組み合わさる主なシナリオの1つは、PDFから数値データを抽出する必要がある場合です。 たとえば、PDF文書から請求書番号、注文ID、数量を抽出したい場合があります。これらは通常文字列として提供されます。 次の例では、IronPDFを使用してPDFからテキストを抽出し、TryParse メソッドを用いて整数文字列を整数値に変換する方法を説明します。
IronPDFを使用すると、PDFからテキストを抽出し、その後int.TryParse()を使用して数値文字列を整数に変換できます。 以下の方法です:
using System;
using System.Text.RegularExpressions;
using IronPdf;

public static class PdfNumberExtractor
{
    public static void Main(string[] args)
    {
        // Load the PDF file
        PdfDocument pdf = PdfDocument.FromFile("invoice.pdf");

        // Extract text from the PDF
        string extractedText = pdf.ExtractAllText();

        // Use regex to extract potential numbers from the text
        var matches = Regex.Matches(extractedText, @"\d+");

        if (matches.Count > 0)
        {
            Console.WriteLine("Extracted number(s) from PDF:");

            foreach (Match match in matches)
            {
                // Try to parse each match as an integer
                if (int.TryParse(match.Value, out int num))
                {
                    Console.WriteLine(num); // If successful, print the number
                }
            }
        }
        else
        {
            Console.WriteLine("Could not find any numbers in the extracted text.");
        }
    }
}
using System;
using System.Text.RegularExpressions;
using IronPdf;
public static class PdfNumberExtractor
{
public static void Main(string[] args)
{
// Load the PDF file
PdfDocument pdf = PdfDocument.FromFile("invoice.pdf");
// Extract text from the PDF
string extractedText = pdf.ExtractAllText();
// Use regex to extract potential numbers from the text
var matches = Regex.Matches(extractedText, @"\d+");
if (matches.Count > 0)
{
Console.WriteLine("Extracted number(s) from PDF:");
foreach (Match match in matches)
{
// Try to parse each match as an integer
if (int.TryParse(match.Value, out int num))
{
Console.WriteLine(num); // If successful, print the number
}
}
}
else
{
Console.WriteLine("Could not find any numbers in the extracted text.");
}
}
}Imports System
Imports System.Text.RegularExpressions
Imports IronPdf
Public Module PdfNumberExtractor
Public Sub Main(args As String())
' Load the PDF file
Dim pdf As PdfDocument = PdfDocument.FromFile("invoice.pdf")
' Extract text from the PDF
Dim extractedText As String = pdf.ExtractAllText()
' Use regex to extract potential numbers from the text
Dim matches = Regex.Matches(extractedText, "\d+")
If matches.Count > 0 Then
Console.WriteLine("Extracted number(s) from PDF:")
For Each match As Match In matches
' Try to parse each match as an integer
Dim num As Integer
If Integer.TryParse(match.Value, num) Then
Console.WriteLine(num) ' If successful, print the number
End If
Next
Else
Console.WriteLine("Could not find any numbers in the extracted text.")
End If
End Sub
End ModuleImports System
Imports System.Text.RegularExpressions
Imports IronPdf
Public Module PdfNumberExtractor
Public Sub Main(args As String())
' Load the PDF file
Dim pdf As PdfDocument = PdfDocument.FromFile("invoice.pdf")
' Extract text from the PDF
Dim extractedText As String = pdf.ExtractAllText()
' Use regex to extract potential numbers from the text
Dim matches = Regex.Matches(extractedText, "\d+")
If matches.Count > 0 Then
Console.WriteLine("Extracted number(s) from PDF:")
For Each match As Match In matches
' Try to parse each match as an integer
Dim num As Integer
If Integer.TryParse(match.Value, num) Then
Console.WriteLine(num) ' If successful, print the number
End If
Next
Else
Console.WriteLine("Could not find any numbers in the extracted text.")
End If
End Sub
End Module入力 PDF
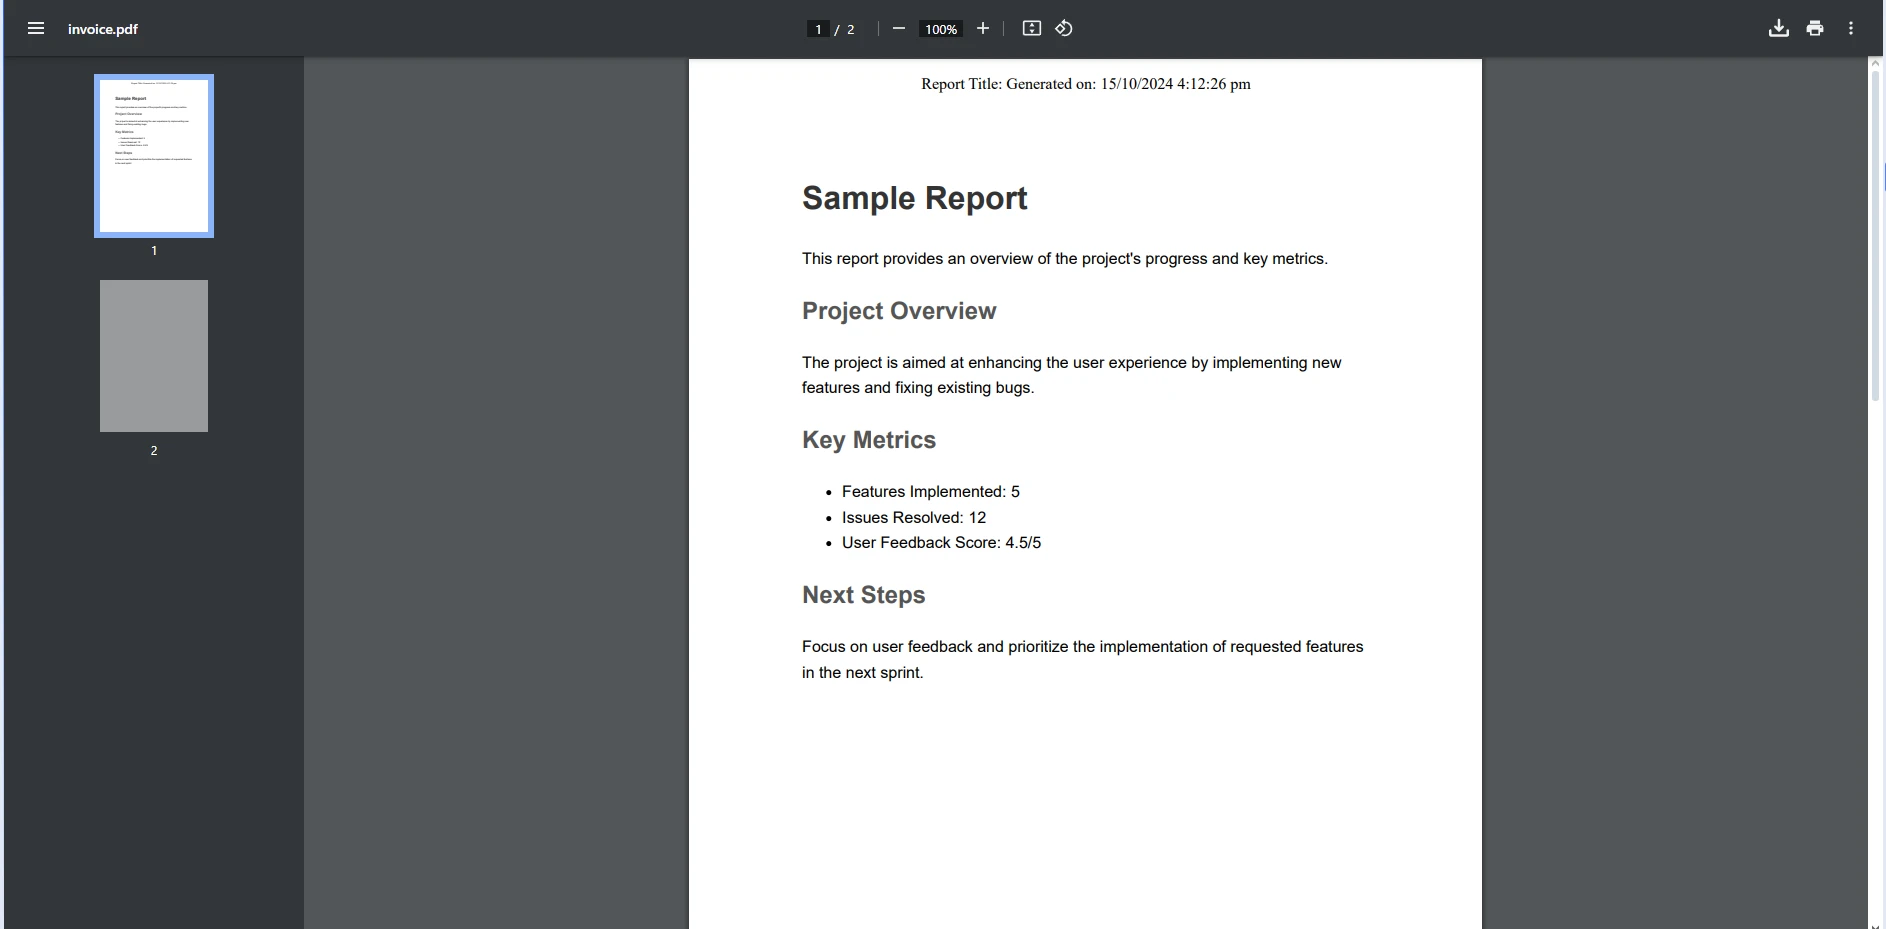
コンソール出力
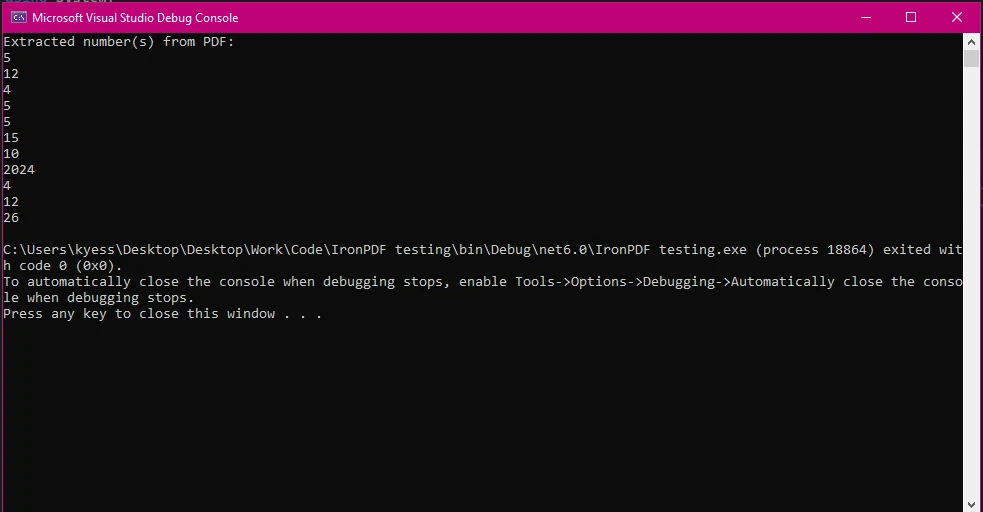
このコード例では、まず"invoice.pdf"という名前のPDFファイルを読み込み、次にExtractAllText() メソッドを使用してドキュメントからすべてのテキストを抽出します。 抽出されたテキスト内の潜在的な数値を特定するために、コードは 正規表現 (regex) \d+ を適用し、数字のシーケンスに一致させます。
一致するものは保存され、もし数値が見つかった場合、それらはコンソールに表示されます。 各一致は、int.TryParse() を使用して個別に整数として解析され、有効な数値のみが処理されます。 数値が見つからない場合、数値が抽出されなかったというメッセージが表示されます。 このアプローチは、請求書を含む数値データを含むPDFを処理するためのもので、数値の抽出と変換が不可欠である場合に役立ちます。
PDFから抽出したテキストを整数に変換することが価値を持つシナリオは次のとおりです:
*請求書処理:自動請求システムの請求書番号または合計金額を抽出して処理します。 *注文追跡:発送または注文確認 PDF から注文 ID または数量を取得します。 *財務レポート:数値データを検証または要約する必要がある財務レポートまたは取引ログを含む PDF を解析します。
文字列を整数に変換することは、特に外部データソースを扱う際にC#での基本的なスキルです。 int.Parse() および int.TryParse() メソッドは、これらの変換を処理する柔軟な方法を提供し、簡単さと安全性を両立させています。
一方で、IronPDF は、.NET開発者が簡単に複雑なPDFワークフローを処理できるようにします。 テキストの抽出、ダイナミックなレポートの作成、またはPDFデータを利用可能な形式に変換する場合でも、IronPDF は開発ツールキットに価値ある追加です。
IronPDFを自分で試してみますか? 今すぐ無料トライアルを開始し、IronPDF が.NET アプリケーションでのPDF扱い方をどのように変革できるかを体験してください!

ジェイコブ・メラーはIron Softwareの最高技術責任者(CTO)であり、C# PDFテクノロジーを開拓する先見的なエンジニアです。Iron Softwareのコアコードベースを支えるオリジナル開発者として、彼は創業以来、会社の製品アーキテクチャを形成し、CEOのCameron Rimingtonとともに、会社をNASA、Tesla、および世界的な政府機関にサービスを提供する50人以上の会社に変えました。1999年にロンドンで最初のソフトウェアビジネスを開業し、2005年に最初 for .NETコンポーネントを作成した後、Microsoftのエコシステム全体で複雑な問題を解決することを専門としました。



IronPDF はIRONSUITEの一部です
オフィス文書向けの.NET API製品10個

PDFがHTMLのように見える必要があるとき、迅速に。
