



更新日 2026年4月21日
Scrapy in Python(開発者向けのしくみ)
ここにScrapy、PythonにおけるWebスクレイピングフレームワークとIronPDFが登場し、オンラインデータの抽出と動的PDFの作成を最適化するための2つの強力なライブラリが協力しています。
詳しく読む

この記事では、IronPDF for Pythonライブラリを使用してPDFドキュメントからテキスト要素を抽出する方法を示します。
Pythonは、開発者がグラフィカルユーザーインターフェースを簡単かつ迅速に作成するためのプログラミング言語です。 他の言語と比較しても、Pythonはプログラマーにとって非常に動的です。 このため、PythonにIronPDFライブラリを追加するのは簡単なプロセスです。 PyQt、wxWidgets、Kivy、およびその他の多くのパッケージやPythonライブラリを含む多数のプリインストールツールを使用して、完全なGUIを迅速かつ安全に構築できます。 IronPDFはPythonを組み込み、.NET Coreなどの他のフレームワークからの機能の統合も可能にします。
IronPDFはウェブ開発を容易にします。 その主な理由は、Pythonウェブ開発パラダイムであるDjango、Flask、Pyramidなどの広範な採用です。 Reddit、Mozilla、Spotifyは、これらのフレームワークを使用したウェブサイトやオンラインサービスのほんの一例です。
Pythonがコンピュータにセットアップされていることを確認してください。 最新バージョン for Pythonをお使いのオペレーティングシステムと互換性のあるバージョンをダウンロードしてインストールするには、公式Pythonウェブサイトをご覧ください。 Pythonをインストールしたら、プロジェクトの要件を分離するために仮想環境を作成してください。 変換プロジェクトのために整然とした別々の作業場所を提供するために、venv モジュールを使用して仮想環境を作成および管理します。
このデモンストレーションには、Pythonコードの開発用IDEとしてPyCharmを推奨します。
PyCharm IDEを起動した後、"新規プロジェクト"を選択します。
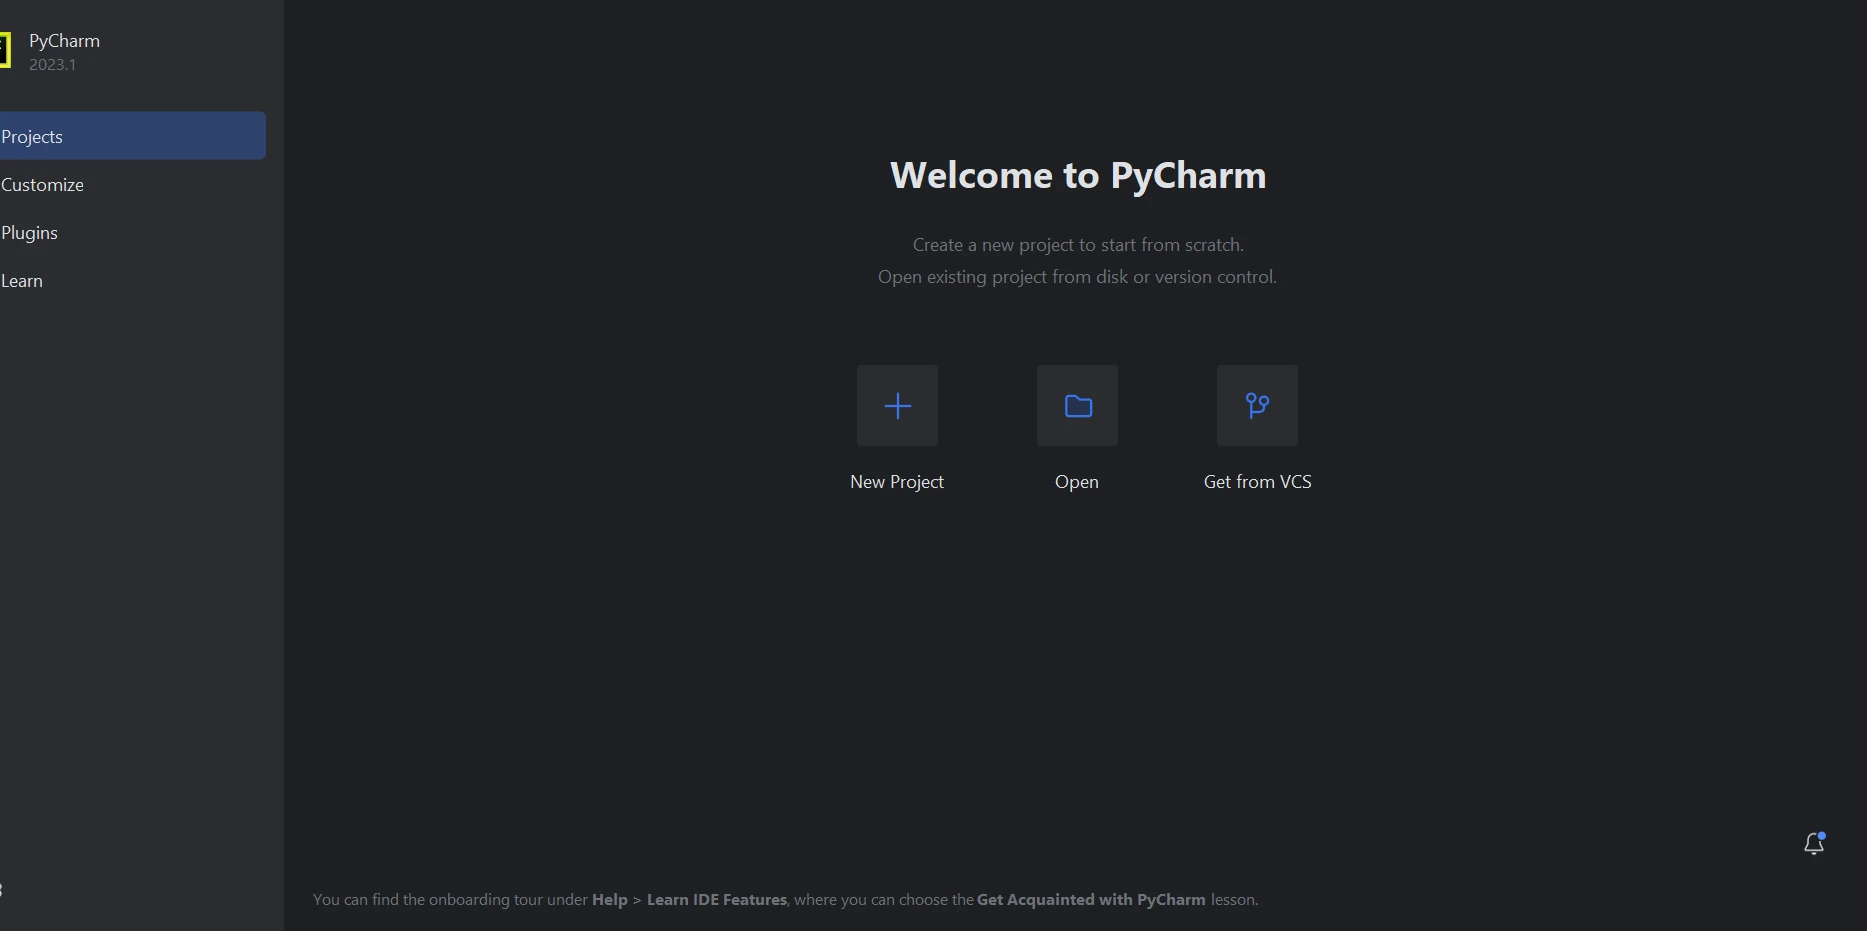 PyCharm
"新規プロジェクト"を選択すると、プロジェクトの場所と環境を設定できる新しいウィンドウが開きます。 これは以下の画像で見ることができます。
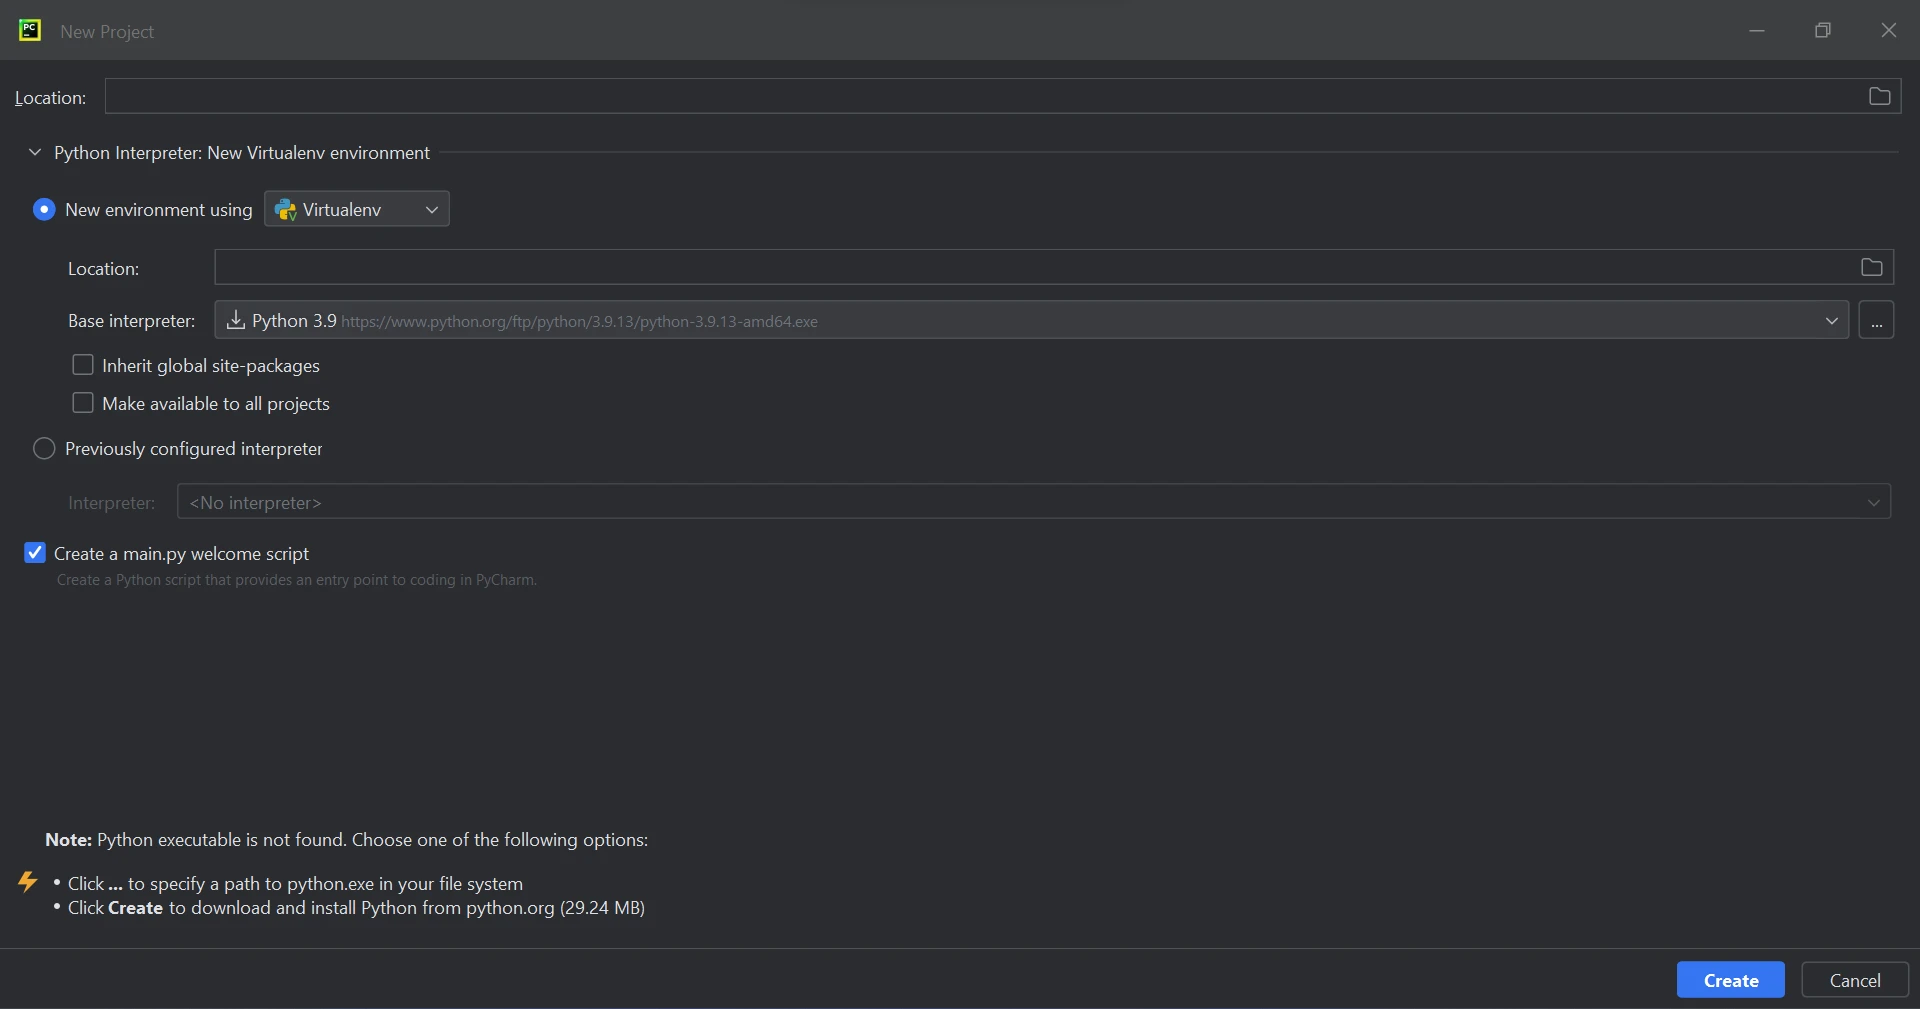 新しいプロジェクト
プロジェクトの場所と環境パスを選択した後、作成ボタンをクリックして新しいプロジェクトを開始します。 その結果、新しいウィンドウが開き、プログラムを作成できます。 このレッスンではPython 3.9を使用します。
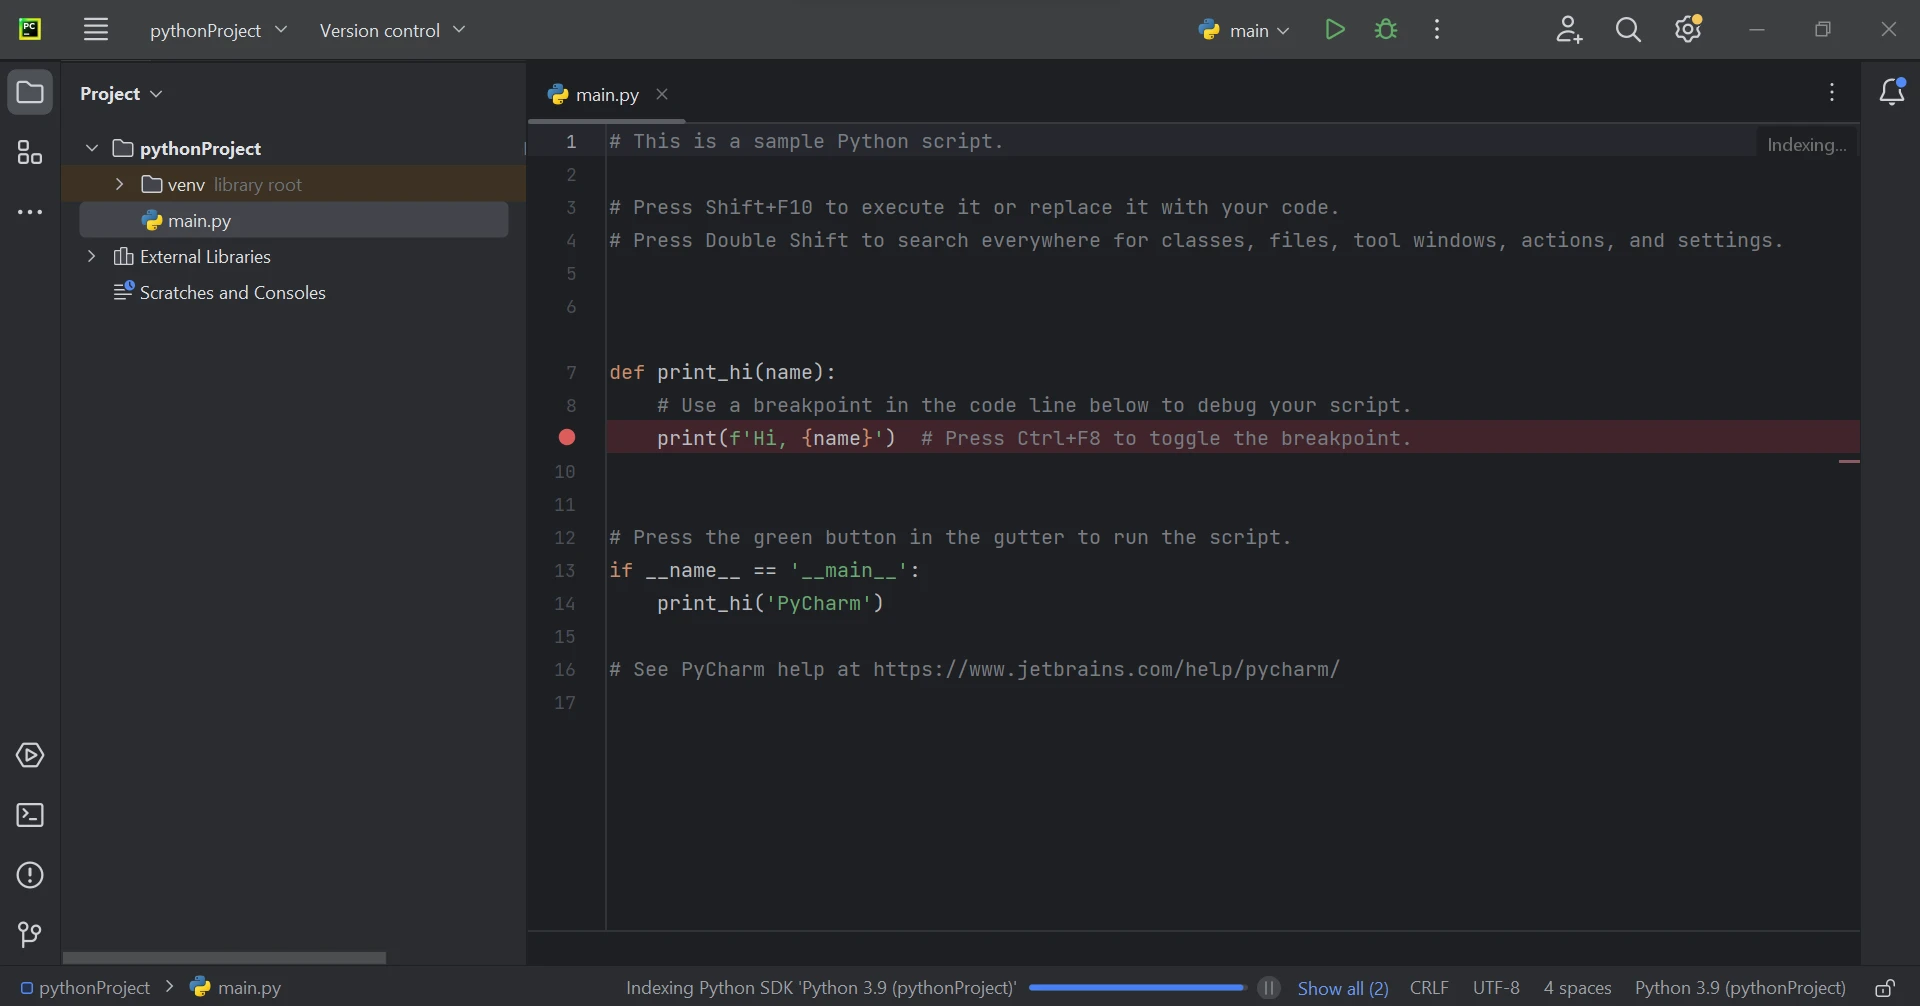 Pythonプロジェクトを作成
PythonライブラリのIronPDFは主に.NET 6.0を使用します。したがって、IronPDF for Pythonを使用するには、コンピュータに.NET 6.0ランタイムがインストールされている必要があります。 LinuxおよびMacユーザーは、こ for Pythonモジュールを使用する前に、.NETのインストールが必要になる場合があります。 必要なランタイム環境を取得するには、Microsoftのダウンロードページをご覧ください。
".pdf"拡張子のファイルを生成、変更、および開くには、"IronPDF"パッケージをインストールする必要があります。 ターミナルウィンドウを開き、PyCharmでパッケージをインストールするために次のコマンドを入力してください:
以下のスクリーンショットに、ironpdf パッケージのインストールが示されています。
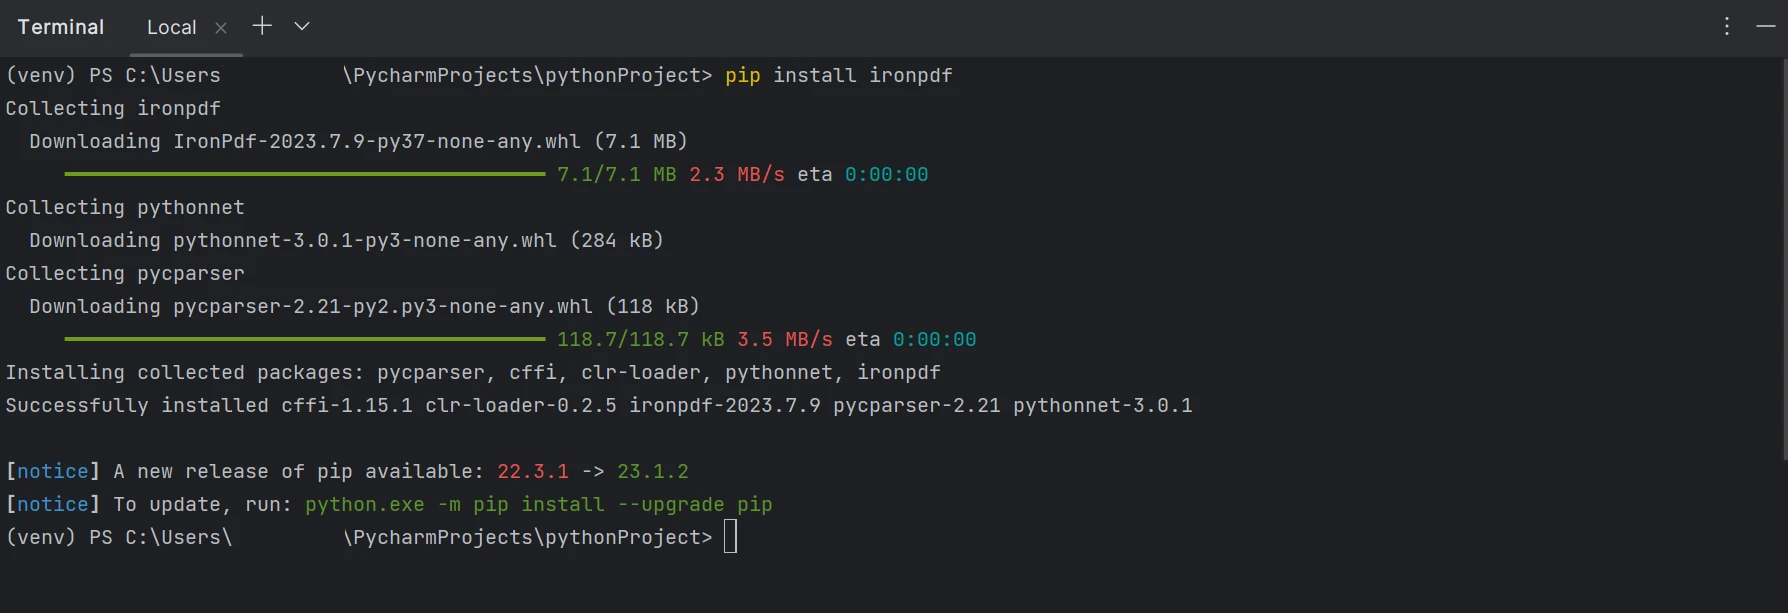 IronPDFをインストール
IronPDFライブラリを使用すると、PDFファイルからテキストを抽出できます。 IronPDFは、複数のテキスト抽出方法を提供します。 最初の方法は、ページ全体の内容を1つの文字列として取得することです。 第二の戦略は、最初のページから始めて内容をページごとに調べることです。 既存のPDFファイルをIronPDFライブラリを使用して調査できます。 以下のコードスニペットは、ライブPDFファイルを調査するためにIronPDFをどのように使用するかを示しています。
PDFから情報を抽出するための2つのオプションがあります:
この記事のサンプルPDFファイルはこちらでご覧いただけます。
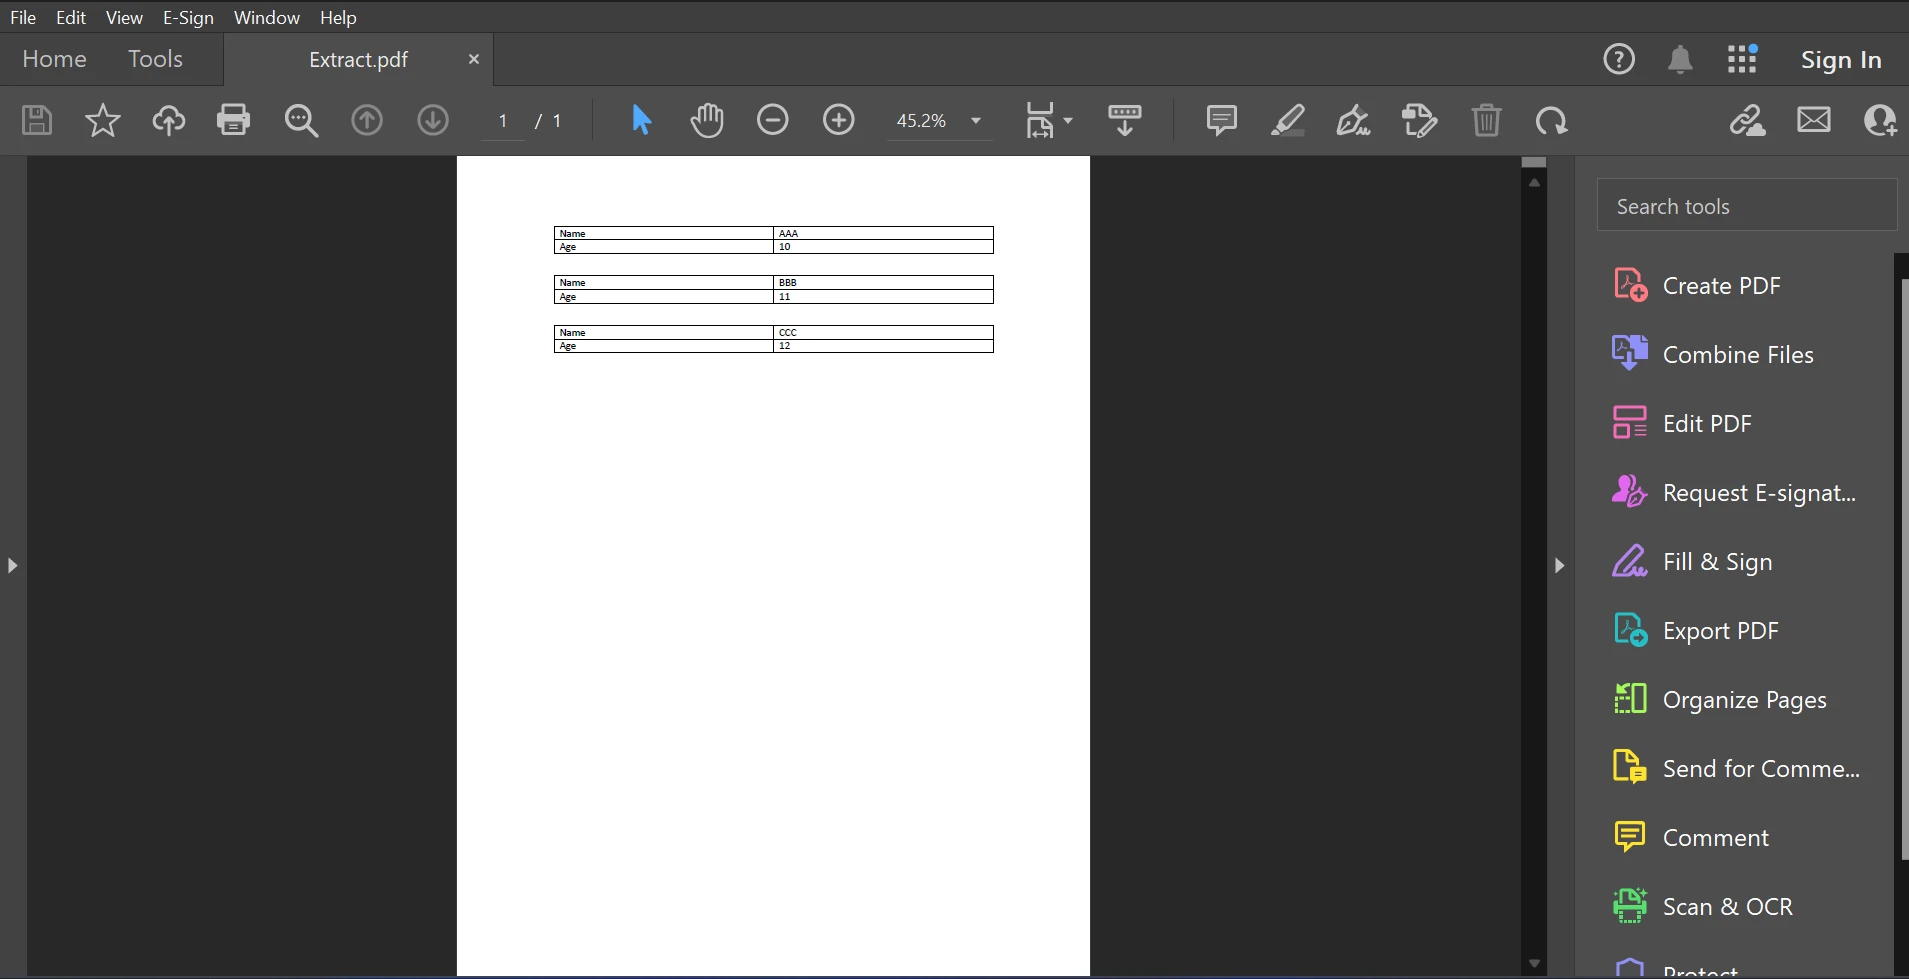 入力PDF
以下の例コードは、ページ番号を使用してPDFファイルからデータを取得する方法を示しています。
from ironpdf import PdfDocument

# Load the PDF file
pdf = PdfDocument.FromFile('F:\\PDF\\Extract.pdf')
# Extract text from the first page of the PDF document
all_text = pdf.ExtractTextFromPage(0)
# Iterate over each line in the extracted text
for line in all_text.split('\n'):
    # Check if the line contains the keyword "Name"
    if 'Name' in line:
        # Print the line if it contains the keyword
print(line)このコードスニペットは、FromFile 関数を使用してPDFファイルを読み込み、PDFオブジェクトを構築する方法を示しています。 このオブジェクトを使用して、PDFのテキストと画像にアクセスできます。 ページ番号をExtractTextFromPage 関数のパラメータとして渡すことで、特定のページからテキストを取得することができます。 選択されたページ上のすべての単語が含まれる文字列がこのメソッドによって返されます。 その後、split 関数をPythonで使用して、抽出されたテキストからすべての改行を分割します。 その後、抽出されたテキストの各行が必要なキーワードを含むかどうかを確認します。 キーワードが一致した場合、コマンドプロンプトに特定の行が表示されます。 そうでない場合は、その行は無視され、次の行に進みます。抽出されたテキストの出力は以下のようになります。
以下のコードサンプルは、PDFのすべての内容をすばやく簡単に取得するための最初の方法を示しています。
from ironpdf import PdfDocument

# Load the PDF file
pdf = PdfDocument.FromFile('F:\\PDF\\Extract.pdf')
# Extract all text from the PDF document
all_text = pdf.ExtractAllText()
# Iterate over each line in the extracted text
for line in all_text.split('\n'):
    # Check if the line contains the keyword "Name"
    if 'Name' in line:
        # Print the line if it contains the keyword
print(line)上記の例のコードは、FromFile 関数を使用して既存のファイルパスからPDFを読み込み、それをPDFファイルオブジェクトに変換する方法を示しています。 その結果、このPDFリーダーオブジェクトを使用して、PDF内のテキストと画像を見ることができます。 オブジェクトのExtractAllText 関数を使用してPDFからデータをプレーンテキストに抽出し、それを文字列に変換し、上記と同様のロジックを使用して特定のキーワードを見つけ、結果をターミナルに表示します。 結果は次のように表示されます。
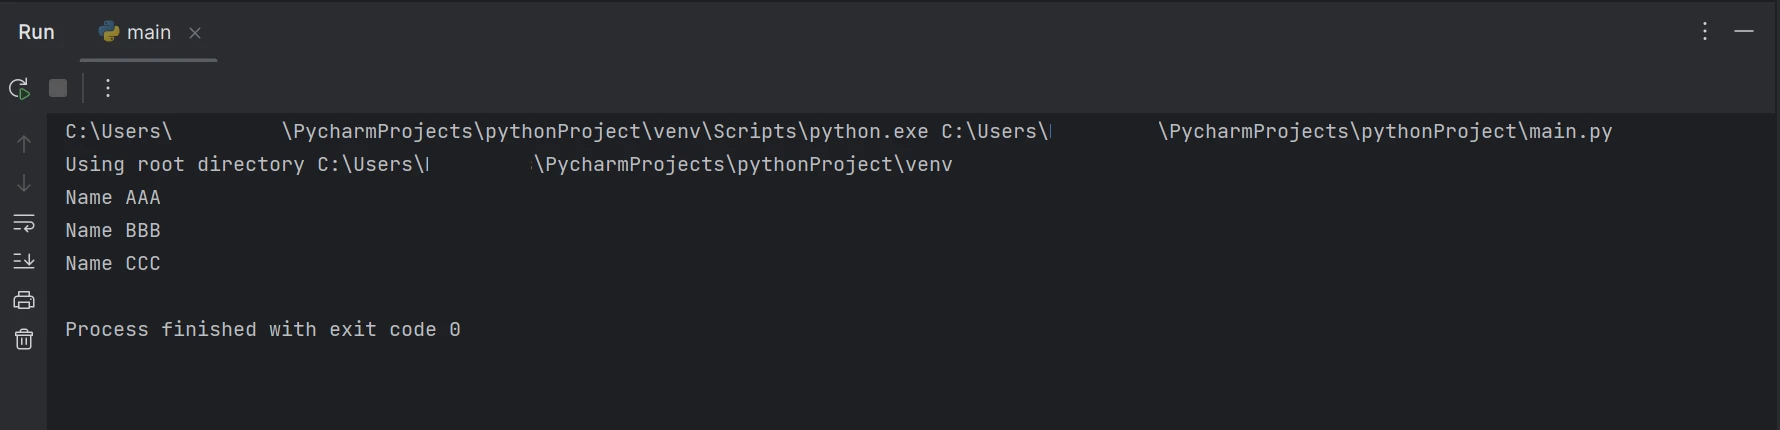 出力
上記のコード/出力は、指定されたPDFドキュメントに名前と年齢が含まれていることを示していますが、結果にはPDFドキュメント内にある名前のみが示されています。
IronPDFライブラリは、脅威を減らしデータの安全性を確保するための強力なセキュリティメカニズムを提供します。 特定のブラウザに制限されておらず、すべての主要なブラウザと互換性があります。 数行のコードで、プログラマーはIronPDFを使用してPDFファイルを迅速に生成および読み取ることができます。 IronPDFライブラリは、開発者のさまざまなニーズに応じて、無料の開発者ライセンスや購入可能な追加の開発ライセンスを含むさまざまなライセンスオプションを提供します。
ライセンスのライトパッケージには、永続ライセンス、30日間の返金保証、1年間のソフトウェアメンテナンス、およびアップグレードオプションが含まれています。ライトパッケージ。 これらのライセンスはすべての環境で使用できます。 さらに、IronPDFは一部の再配布制限付きで無料ライセンスを提供しています。 試用ライセンスは、ユーザーが透かしなしで製品を評価できるようにします。
商業ライセンスについての詳細については、利用可能なIronPDFライセンスをご覧ください。

Curtis Chauは、カールトン大学でコンピュータサイエンスの学士号を取得し、Node.js、TypeScript、JavaScript、およびReactに精通したフロントエンド開発を専門としています。直感的で美しいユーザーインターフェースを作成することに情熱を持ち、Curtisは現代のフレームワークを用いた開発や、構造の良い視覚的に魅力的なマニュアルの作成を楽しんでいます。



IronPDF はIRONSUITEの一部です
オフィス文書向けの.NET API製品10個

PDFがHTMLのように見える必要があるとき、迅速に。



