


已更新 2026年4月23日
简化 .NET 与 Microsoft.Extensions.AI 的 LLM 集成
AI正在改变软件开发,但将大型语言模型(LLM)集成到.NET中直到现在一直很复杂。通过IronPdf.AI,将AI集成更进一步,该产品为.NET应用程序带来了OpenAI驱动的PDF解析、数据提取和内容摘要。
阅读更多

C# out 参数。 通过将此功能与IronPDF配对,开发人员可以大规模自动化PDF工作流。 例如,您可以使用 Directory.GetFiles 定位文件夹中的所有 PDF 文件,然后通过IronPDF批量处理它们,用于合并、添加注释或生成报告等任务。 这种组合允许简化操作,尤其是在处理文件系统中的大量文件时。
IronPDF是一个强大的.NET库,为开发人员提供了与PDF文件无缝工作的工具。 使用IronPDF,您可以通过简单直观的方法创建、编辑、合并、拆分并操作PDF。 它包括强大的功能,例如HTML到PDF转换、高级样式和元数据处理。 对于从事需要PDF处理的应用程序的.NET开发人员而言,IronPDF是一个无价的工具,简化了工作流并提高了生产力。
首先,通过NuGet将IronPDF添加到您的项目中:
1.在 Visual Studio 中打开您的项目。 2. 前往工具菜单,选择NuGet包管理器 > 为解决方案管理NuGet包。 3. 在NuGet包管理器中搜索IronPDF。
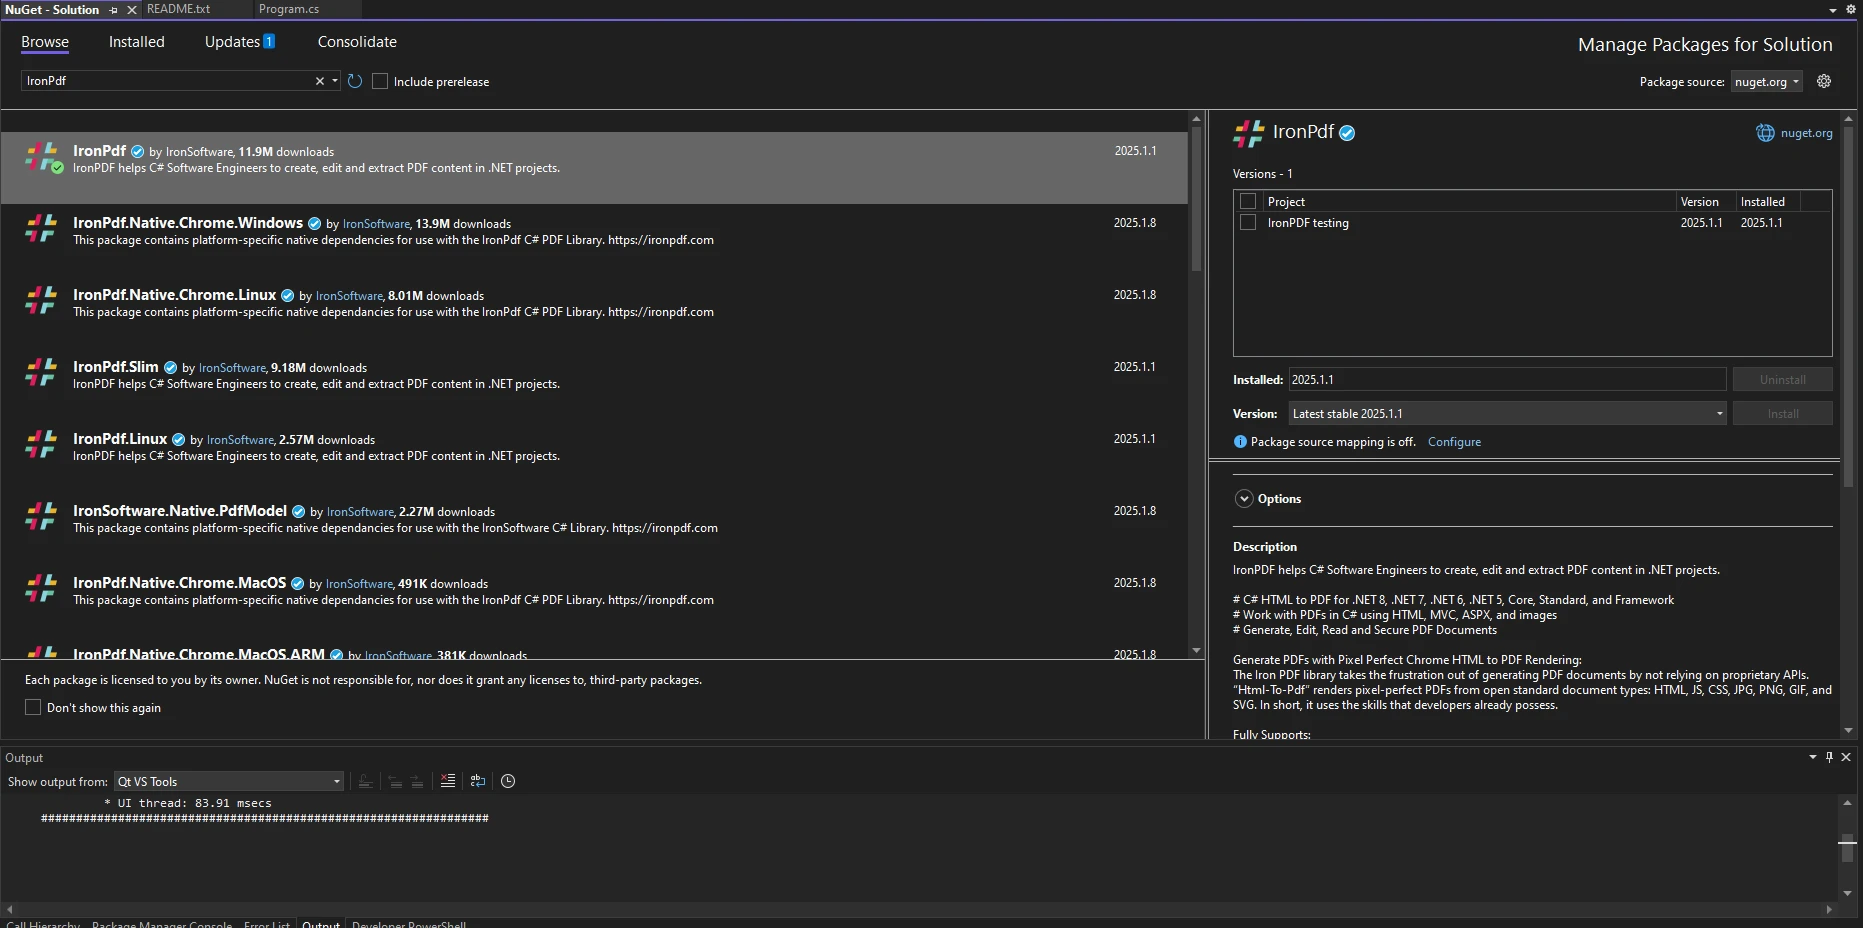
或者,使用NuGet包管理器控制台:
System.IO命名空间的一部分,用于从文件系统中检索文件名。 这个方法是Directory类的一个公共静态字符串成员,简化了访问文件路径。 例如:
string[] pdfFiles = Directory.GetFiles("C:\\Documents\\PDFs", "*.pdf");Dim pdfFiles() As String = Directory.GetFiles("C:\Documents\PDFs", "*.pdf")这个代码片段检索当前目录中的所有PDF文件。 通过将此方法与IronPDF结合使用,您可以创建自动化解决方案一次性处理多个文件。 您还可以应用指定的搜索模式,定义为字符串模式,以根据扩展名或名称过滤文件。
您可以通过指定搜索选项进一步优化文件检索逻辑,例如包括搜索子目录:
string[] pdfFiles = Directory.GetFiles("C:\\Documents\\PDFs", "*.pdf", SearchOption.AllDirectories);Dim pdfFiles() As String = Directory.GetFiles("C:\Documents\PDFs", "*.pdf", SearchOption.AllDirectories)这确保了嵌套文件夹中的文件也被包括在内,检索每个文件的绝对路径,使此方法在各种场景中具有适用性。
使用Directory.GetFiles,您可以遍历目录中的所有 PDF 文件,并使用 IronPDF 处理它们:
string[] pdfFiles = Directory.GetFiles("C:\\Documents\\PDFs", "*.pdf");
foreach (string file in pdfFiles)
{
    // Load the PDF with IronPDF
    var pdf = PdfDocument.FromFile(file);
    Console.WriteLine($"Processing file: {Path.GetFileName(file)}");
}Dim pdfFiles() As String = Directory.GetFiles("C:\Documents\PDFs", "*.pdf")
For Each file As String In pdfFiles
' Load the PDF with IronPDF
Dim pdf = PdfDocument.FromFile(file)
Console.WriteLine($"Processing file: {Path.GetFileName(file)}")
Next file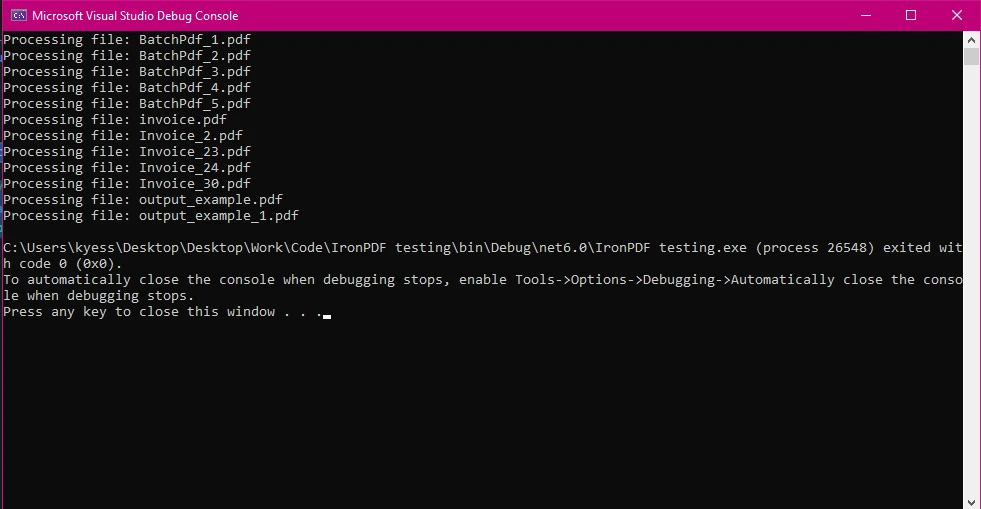
这个例子演示了如何从目录中加载多个PDF进行处理。 加载后,您可以执行各种操作,例如提取文本、添加注释或根据内容生成新的PDF。
您可以将Directory.GetFiles与 LINQ 结合以根据创建或修改日期等标准过滤文件:
string[] pdfFiles = Directory.GetFiles("C:\\Documents\\PDFs", "*.pdf");
var recentFiles = pdfFiles.Where(file => File.GetLastWriteTime(file) > DateTime.Now.AddDays(-7));
foreach (string file in recentFiles)
{
    Console.WriteLine($"Recent file: {Path.GetFileName(file)}");
}Dim pdfFiles() As String = Directory.GetFiles("C:\Documents\PDFs", "*.pdf")
Dim recentFiles = pdfFiles.Where(Function(file) File.GetLastWriteTime(file) > DateTime.Now.AddDays(-7))
For Each file As String In recentFiles
Console.WriteLine($"Recent file: {Path.GetFileName(file)}")
Next file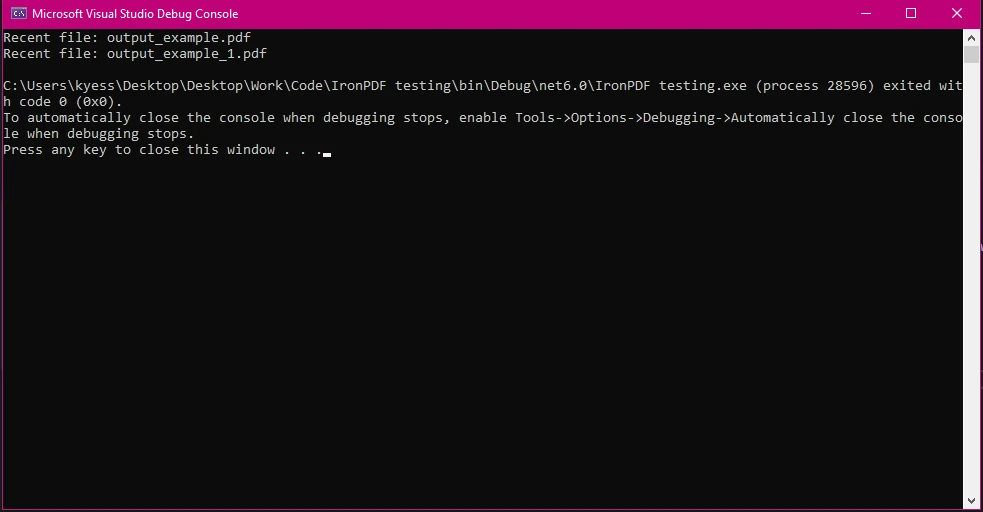
这种方法确保只有相关的文件被处理,节省时间和计算资源。 例如,您可能使用这种方法仅处理最近一周生成的最新发票或报告。
您可以将目录中的多个PDF追加到一个文件中:
string[] pdfFiles = Directory.GetFiles("C:\\Documents\\PDFs", "*.pdf");
var pdfAppend = new PdfDocument(200, 200);
foreach (string file in pdfFiles)
{
    var pdf = PdfDocument.FromFile(file);
    pdfAppend.AppendPdf(pdf);
}
pdfAppend.SaveAs("LargePdf.pdf");
Console.WriteLine("PDFs Appended successfully!");Dim pdfFiles() As String = Directory.GetFiles("C:\Documents\PDFs", "*.pdf")
Dim pdfAppend = New PdfDocument(200, 200)
For Each file As String In pdfFiles
Dim pdf = PdfDocument.FromFile(file)
pdfAppend.AppendPdf(pdf)
Next file
pdfAppend.SaveAs("LargePdf.pdf")
Console.WriteLine("PDFs Appended successfully!")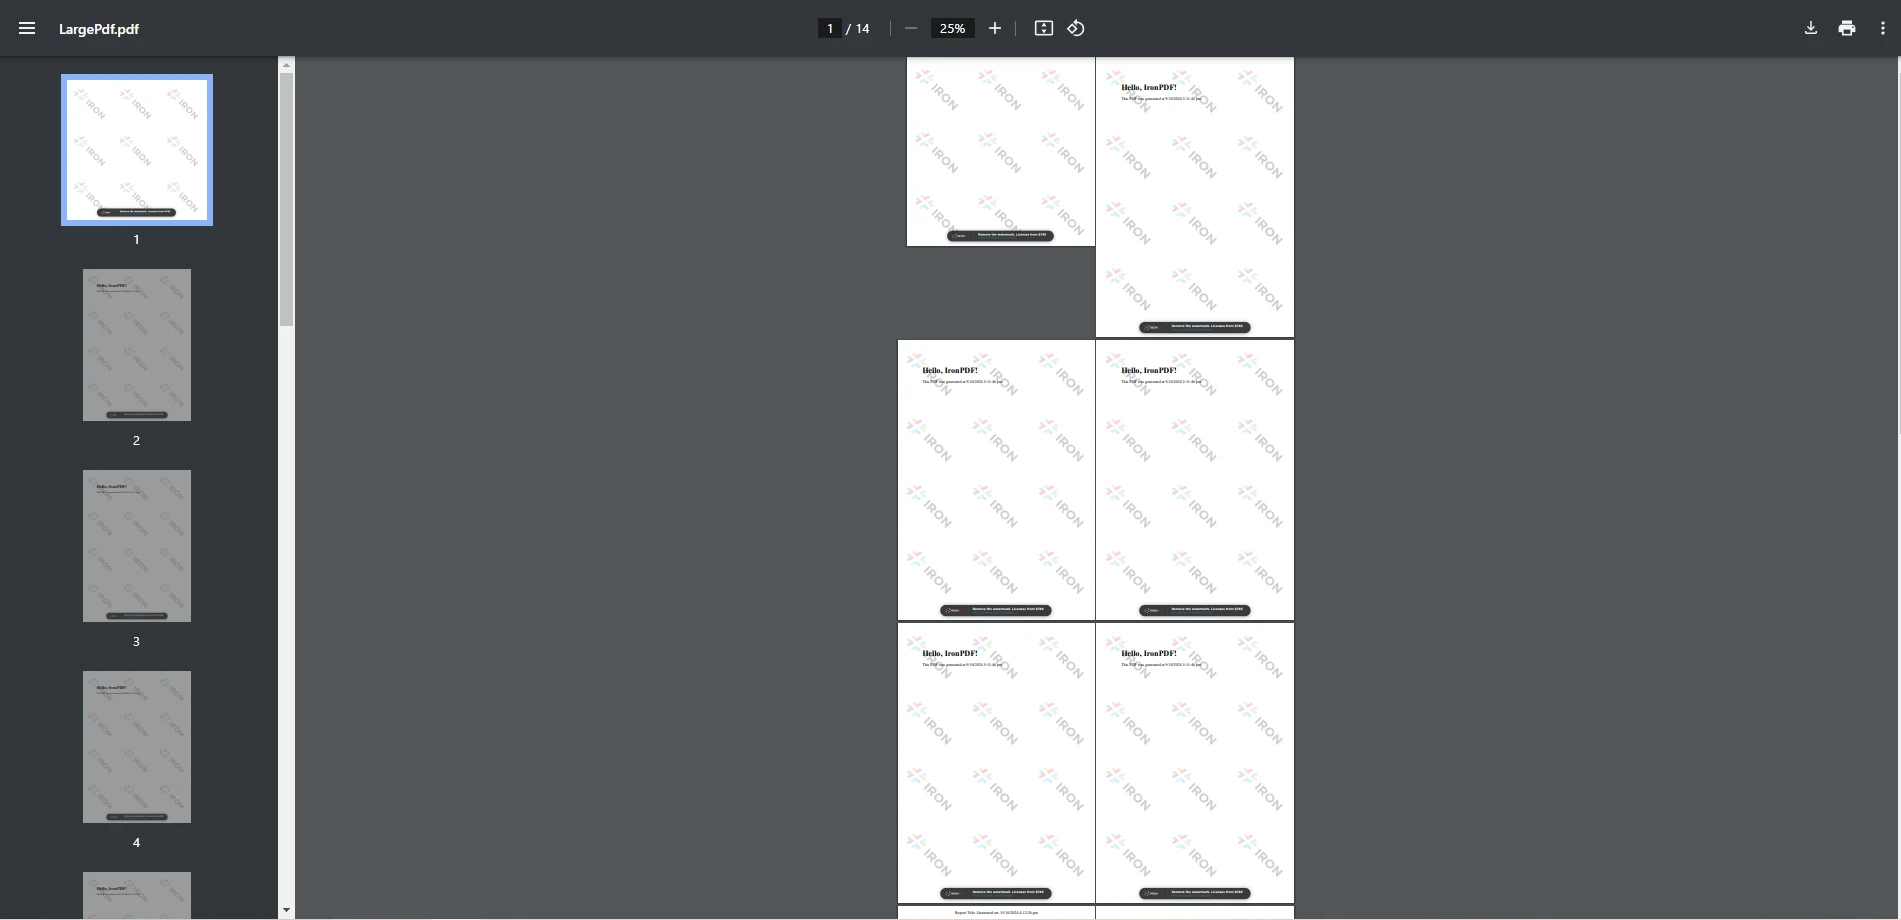
这种方法特别适用于创建合并报告、存档多个文档或准备演示。 通过自动化此过程,您可以轻松处理大量文件集合。
以下代码演示了如何结合使用IronPDF和Directory.GetFiles加载和处理PDF文档。
using IronPdf;
using System;
using System.IO;

class Program
{
    static void Main()
    {
        // Retrieve all PDF file paths from the specified directory
        string[] pdfFiles = Directory.GetFiles("C:\\Users\\kyess\\Documents\\PDFs", "*.pdf");

        // Initialize a PdfDocument
        var pdfAppend = new PdfDocument(200, 200);

        // Create a text annotation to add to each PDF
        TextAnnotation annotation = new TextAnnotation(0)
        {
            Contents = "Processed by IronPDF",
            X = 50,
            Y = 50,
        };

        // Iterate over each file path, load, annotate, and save
        foreach (string file in pdfFiles)
        {
            var pdf = PdfDocument.FromFile(file);
            pdf.Annotations.Add(annotation);
            pdf.SaveAs(file);
        }
    }
}Imports IronPdf
Imports System
Imports System.IO
Friend Class Program
Shared Sub Main()
' Retrieve all PDF file paths from the specified directory
Dim pdfFiles() As String = Directory.GetFiles("C:\Users\kyess\Documents\PDFs", "*.pdf")
' Initialize a PdfDocument
Dim pdfAppend = New PdfDocument(200, 200)
' Create a text annotation to add to each PDF
Dim annotation As New TextAnnotation(0) With {
.Contents = "Processed by IronPDF",
.X = 50,
.Y = 50
}
' Iterate over each file path, load, annotate, and save
For Each file As String In pdfFiles
Dim pdf = PdfDocument.FromFile(file)
pdf.Annotations.Add(annotation)
pdf.SaveAs(file)
Next file
End Sub
End Class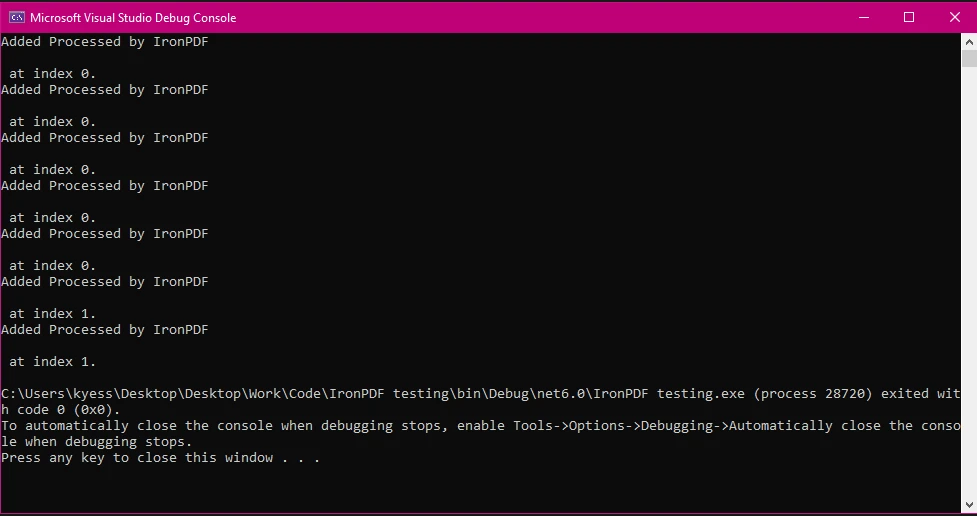
此代码演示了如何使用C#中的IronPDF向指定目录中的所有PDF文件添加文本注释。 该程序首先使用Directory.GetFiles方法从提供的文件夹中检索所有 PDF 文件路径,该方法通过一个字符串路径指定目录,并支持按文件扩展名过滤,返回一个包含所有扩展名为".pdf"的 PDF 文件路径的字符串数组。
接下来,代码初始化一个PdfDocument对象 (pdfAppend),尺寸为200x200,尽管此特定实例在循环中没有直接使用。然后,它创建一个文本为"Processed by IronPDF"的TextAnnotation,并将其定位在坐标(50, 50)。 此注释会添加到每个PDF文件中。
在 foreach 循环中,程序遍历pdfFiles数组中的每个文件路径。 对于每个文件,程序使用PdfDocument.FromFile(file)加载 PDF,将先前创建的注释添加到 PDF 的 Annotations 集合中,然后使用pdf.SaveAs(file)将更新后的 PDF 保存回其绝对路径。
这个过程确保指定目录中的每个PDF都接收到相同的注释,并且保存时包含注释。
使用像Directory.EnumerateFiles这样的异步方法来提高处理大型目录的性能。
以较小的批次处理文件以减少内存消耗:
foreach (var batch in pdfFiles.Batch(10))
{
    foreach (string file in batch)
    {
        var pdf = PdfDocument.FromFile(file);
        // Process PDF
    }
}For Each batch In pdfFiles.Batch(10)
For Each file As String In batch
Dim pdf = PdfDocument.FromFile(file)
' Process PDF
Next file
Next batch将文件处理包裹在try-catch块中以处理异常:
try
{
    var pdf = PdfDocument.FromFile(file);
    // Process PDF
}
catch (Exception ex)
{
    Console.WriteLine($"Error processing {file}: {ex.Message}");
}Try
Dim pdf = PdfDocument.FromFile(file)
' Process PDF
Catch ex As Exception
Console.WriteLine($"Error processing {file}: {ex.Message}")
End Try将Directory.GetFiles的强大功能与 IronPDF 结合使用,开发人员可以有效地管理和处理大规模的 PDF 文件。 采用这种方法,批量处理、合并、过滤和转换PDF等任务变得无缝,显著减少了手动操作并提高了生产力。 通过利用IronPDF的高级功能,包括添加页眉、元数据和样式,开发人员可以创建高质量的、专业的PDF文档,满足其需求。
在本指南中,我们探讨了如何使用Directory.GetFiles来检索和操作 IronPDF 中的 PDF。 从项目设置到实施实际用例,我们涵盖了可以应用于现实场景的重要技术。 无论您是从事自动化文档工作流还是增强.NET应用程序的功能,这种组合提供了强大和可扩展的解决方案。
如果您准备深入了解IronPDF并探索高级功能,请考虑参考官方文档,以便您在自己的项目中测试库。
Jacob Mellor 是 Iron Software 的首席技术官,也是一位开创 C# PDF 技术的有远见的工程师。作为 Iron Software 核心代码库的原始开发者,他从公司成立之初就开始塑造公司的产品架构,与首席执行官 Cameron Rimington 一起将公司转变为一家拥有 50 多名员工的公司,为 NASA、特斯拉和全球政府机构提供服务。

当您需要PDF看起来像HTML时,速度快。



