



Aktualisiert 21. April 2026
Wie man TIFF in PDF in Java konvertiert
Dieser umfassende Leitfaden führt Sie durch die Schritte, wie Sie ein TIFF-Bild nahtlos in PDF in Java mit IronPDF konvertieren.
Weiterlesen

Dieser Artikel wird untersuchen, wie man Bilder aus einem vorhandenen PDF-Dokument extrahiert und sie in einem einzigen Ordner mit der Programmiersprache Java speichert. Zu diesem Zweck wird die IronPDF for Java Bibliothek verwendet, um Bilder zu extrahieren.
extractAllImages, um die Bilder zu extrahierenIronPDF ist eine Java-Bibliothek, die Entwicklern hilft, Daten aus PDF-Dateien innerhalb ihrer Java-Anwendungen zu erstellen, zu modifizieren und zu extrahieren. Mit IronPDF können Sie PDF-Dokumente aus verschiedenen Quellen wie HTML, Bildern und mehr erstellen. Zusätzlich haben Sie die Möglichkeit, bestehende PDFs zusammenzuführen, zu teilen und zu bearbeiten. IronPDF enthält auch Sicherheitsfunktionen wie Passwortschutz und digitale Signaturen.
Entwickelt und gewartet von Iron Software, ist IronPDF bekannt für seine Fähigkeit, Text aus PDFs, HTML und URLs zu extrahieren. Dies macht es zu einem vielseitigen und leistungsstarken Tool für eine Vielzahl von Anwendungen, egal ob Sie PDFs von Grund auf neu erstellen oder mit bestehenden arbeiten.
Bevor man mit IronPDF Daten aus einer PDF-Datei extrahiert, müssen einige Voraussetzungen erfüllt sein:
Die Installation von IronPDF for Java ist ein unkomplizierter Prozess, vorausgesetzt, alle Anforderungen sind erfüllt. Dieser Leitfaden verwendet die JetBrains IntelliJ IDEA, um die Installation zu demonstrieren und einige Beispielcodes auszuführen.
Starten Sie IntelliJ IDEA: Öffnen Sie JetBrains IntelliJ IDEA auf Ihrem System.
Erstellen Sie ein Maven-Projekt: Erstellen Sie in IntelliJ IDEA ein neues Maven-Projekt. Dies bietet eine geeignete Umgebung für die Installation von IronPDF for Java.
 Ein neues Maven-Projekt erstellen
Ein neues Fenster wird geöffnet. Geben Sie den Namen des Projekts ein und klicken Sie auf Fertig stellen.
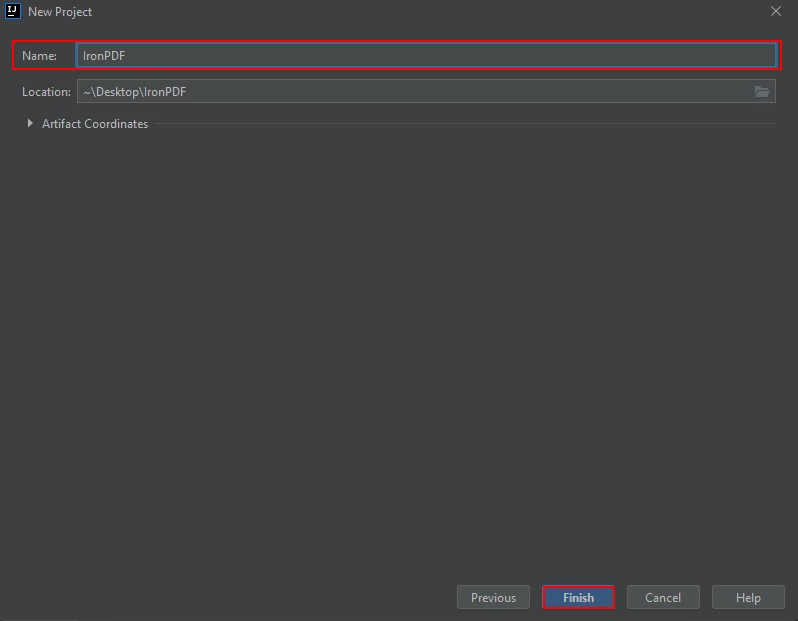 Projektnamen eingeben
Nachdem Sie auf Fertig stellen geklickt haben, wird ein neues Projekt in einer pom.xml Datei geöffnet, um die Maven-Abhängigkeiten von IronPDF for Java hinzuzufügen.
Fügen Sie als Nächstes die folgenden Abhängigkeiten in die pom.xml Datei ein oder Sie können die JAR-Datei aus dem folgenden Maven-Repository herunterladen.
<dependency>
    <groupId>com.ironsoftware</groupId>
    <artifactId>ironpdf</artifactId>
    <version>YOUR_VERSION_HERE</version>
</dependency>Sobald Sie die Abhängigkeiten in die pom.xml Datei eingefügt haben, erscheint ein kleines Symbol in der rechten oberen Ecke der Datei.
 Die pom.xml-Datei mit einem kleinen Icon zum Installieren von Abhängigkeiten
Klicken Sie auf dieses Symbol, um die Maven-Abhängigkeiten von IronPDF for Java zu installieren. Je nach Ihrer Internetverbindung dauert dies nur wenige Minuten.
Sie können Bilder aus einem PDF-Dokument mit IronPDF extrahieren, indem Sie eine einzige Methode namens extractAllImages verwenden. Diese Methode gibt alle in einer PDF-Datei verfügbaren Bilder zurück. Danach können Sie alle extrahierten Bilder mit der ImageIO.write Methode, indem Sie den Pfad und das Format des Ausgabebildes angeben, an einem gewünschten Dateipfad speichern.
Im untenstehenden Beispiel werden die Bilder aus einem PDF-Dokument extrahiert und als PNG-Bilder in das Dateisystem gespeichert.
import com.ironsoftware.ironpdf.PdfDocument;
import javax.imageio.ImageIO;
import java.awt.image.BufferedImage;
import java.nio.file.Files;
import java.nio.file.Paths;
import java.util.List;

public class Main {
    public static void main(String[] args) throws Exception {
        // Load PDF document from file
        PdfDocument pdf = PdfDocument.fromFile(Paths.get("Final Project Report Craft Arena.pdf"));

        // Extract all images from the PDF document
        List<BufferedImage> images = pdf.extractAllImages();
        int i = 0;

        // Save each extracted image to the filesystem as a PNG
        for (BufferedImage image : images) {
            ImageIO.write(image, "PNG", Files.newOutputStream(Paths.get("image" + ++i + ".png")));
        }
    }
}Das obige Programm öffnet die Datei "Final Project Report Craft Arena.pdf" und verwendet die extractAllImages Methode, um alle Bilder in der Datei in eine Liste von BufferedImage Objekten zu extrahieren. Es speichert dann jedes neue Datei-Bild in separaten PNG-Dateien mit einem eindeutigen Namen.
 Bildextraktion aus PDF-Ausgabe
In diesem Abschnitt wird erläutert, wie man Bilder direkt aus URLs extrahiert. Im untenstehenden Code wird die URL in eine PDF-Seite umgewandelt und dann die Navigation umgeschaltet, um Bilder aus dem PDF zu extrahieren.
import com.ironsoftware.ironpdf.PdfDocument;
import javax.imageio.ImageIO;
import java.awt.image.BufferedImage;
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.Paths;
import java.util.List;

public class Main {
    public static void main(String[] args) throws IOException {
        // Render PDF from a URL
        PdfDocument pdf = PdfDocument.renderUrlAsPdf("https://www.amazon.com/?tag=hp2-brobookmark-us-20");

        // Extract all images from the rendered PDF document
        List<BufferedImage> images = pdf.extractAllImages();
        int i = 0;

        // Save each extracted image to the filesystem as a PNG
        for (BufferedImage image : images) {
            ImageIO.write(image, "PNG", Files.newOutputStream(Paths.get("image" + ++i + ".png")));
        }
    }
}Im obigen Code wird die Amazon-Startseite-URL als Eingabe angegeben und es werden 74 Bilder zurückgegeben.
 Bildextraktion aus PDF-Ausgabe
Das Extrahieren von Bildern aus einem PDF-Dokument kann in Java mit der IronPDF-Bibliothek durchgeführt werden. Zum Installieren von IronPDF benötigen Sie Java, eine Java-IDE (Eclipse oder IntelliJ), Maven und die IronPDF-Bibliothek, die in Ihr Projekt integriert ist. Der Prozess der Bildextraktion aus einem PDF-Dokument mit IronPDF ist einfach und erfordert nur einen einzigen Methodenaufruf von extractAllImages. Sie können die Bilder dann mit der ImageIO.write Methode an einem Dateipfad Ihrer Wahl speichern.
Dieser Artikel bietet eine Schritt-für-Schritt-Anleitung zum Extrahieren von Bildern aus einem PDF-Dokument mit Java und der IronPDF-Bibliothek. Weitere Details, einschließlich Informationen darüber, wie man Text aus PDFs extrahiert, finden Sie im Text-Extraktions-Code-Beispiel.
IronPDF ist eine Bibliothek mit einer kommerziellen Lizenz, die bei $999 beginnt. Sie können es jedoch in der Produktion mit einer kostenlosen Testversion evaluieren.

Curtis Chau hat einen Bachelor-Abschluss in Informatik von der Carleton University und ist spezialisiert auf Frontend-Entwicklung mit Expertise in Node.js, TypeScript, JavaScript und React. Leidenschaftlich widmet er sich der Erstellung intuitiver und ästhetisch ansprechender Benutzerschnittstellen und arbeitet gerne mit modernen Frameworks sowie der Erstellung gut strukturierter, optisch ansprechender Handbücher.



IronPDF ist ein Teil der IRONSUITE
10 .NET-API-Produkte für Ihre Bürodokumente


Wenn Ihr PDF wie HTML aussehen soll, schnell.

