from ironpdf import *

# Instantiate Renderer
renderer = ChromePdfRenderer()

# Create a PDF from a HTML string using Python
pdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>")

# Export to a file or Stream
pdf.SaveAs("output.pdf")

# Advanced Example with HTML Assets
# Load external html assets: Images, CSS and JavaScript.
# An optional BasePath 'C:\site\assets\' is set as the file location to load assets from
myAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", r"C:\site\assets")
myAdvancedPdf.SaveAs("html-with-assets.pdf")
from ironpdf import *# Instantiate Rendererrenderer = ChromePdfRenderer()# Create a PDF from a HTML string using Pythonpdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>")# Export to a file or Streampdf.SaveAs("output.pdf")# Advanced Example with HTML Assets# Load external html assets: Images, CSS and JavaScript.# An optional BasePath 'C:\site\assets\' is set as the file location to load assets frommyAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", r"C:\site\assets")myAdvancedPdf.SaveAs("html-with-assets.pdf")
Dieser Artikel zeigt Ihnen, wie Sie mit IronPDF in Python den gesamten Text aus PDF-Dateien extrahieren können. Er liefert Ihnen das nötige Wissen und Python-Codebeispiele, um diese Aufgabe effizient zu erledigen.
<div class="hsg-featured-snippet">
<h2>Wie man Text aus PDF in Python extrahiert</h2>
<ol>
<li><a class="js-modal-open" data-modal-id="download-modal" href="#download-modal">Herunterladen eines Python-Moduls zur Extraktion von Text aus PDF</a></li>
<li>Verwenden Sie die Methode <code>FromFile</code>, um die PDF-Datei zu importieren</li>
<li>Extrahieren von Text aus der importierten PDF-Datei mit der Methode <code>ExtractText</code></li>
<li>Extrahieren von Text aus bestimmten Seiten mit der Methode <code>ExtractTextFromPage</code></li>
<li>Geben Sie den extrahierten Text auf der Konsole oder in einer Textdatei aus</li>
</ol>
</div>
## IronPDF - Python-Bibliothek
[IronPDF for Python](/python/) ist eine leistungsstarke Python-PDF-Bibliothek, die es Entwicklern ermöglicht, Text aus PDF-Dokumenten zu extrahieren. Mit IronPDF können Sie die Datenextraktion von Textinhalten aus PDF-Dateien automatisieren, was die Verarbeitung und Analyse der in PDF-Dokumenten enthaltenen Informationen erleichtert.
IronPDF bietet Python-Programmierern die Möglichkeit, PDF-Dateien mit Python zu bearbeiten, Daten daraus zu extrahieren und mit ihnen zu interagieren, wodurch die Automatisierung verschiedener PDF-bezogener Aufgaben erleichtert wird. Egal ob Sie PDFs generieren, bestehende PDFs bearbeiten, Daten aus Inhalten extrahieren oder andere PDF-Operationen durchführen müssen, IronPDF vereinfacht den Prozess mit seiner intuitiven API und seinen leistungsstarken Funktionen.
### Wichtige Merkmale
Zu den Funktionen der IronPDF-Bibliothek für Python gehören unter anderem:
- [Erstellen Sie eine neue PDF-Datei](/python/tutorials/html-to-pdf/) von Grund auf.
- [Bearbeiten](/python/examples/editing-pdfs/) vorhandener PDF-Dateien
- [Extrahieren von Text](/python/blog/using-ironpdf-for-python/extract-data-from-pdf-python-tutorial/) , Metadaten und Bildern aus PDF-Dateien
- Konvertierung von PDF-Dateien in andere Formate
- [PDF-Dateien mit Passwörtern und Beschränkungen schützen](/python/examples/security-and-metadata/)
- PDFs [teilen](/python/blog/using-ironpdf-for-python/split-pdf-python-tutorial/) und [zusammenführen](/python/how-to/python-merge-pdf/)
## Voraussetzungen
Bevor Sie mit der Textextraktion mithilfe von IronPDF fortfahren, stellen Sie sicher, dass die folgenden Voraussetzungen erfüllt sind:
1. **Python-Installation:** Stellen Sie sicher, dass Python auf Ihrem System installiert ist. IronPDF ist mit Python 3.x-Versionen kompatibel. Stellen Sie daher sicher, dass Sie über eine kompatible Python-Installation verfügen.
2. **IronPDF-Bibliothek:** Installieren Sie die IronPDF-Bibliothek mit `pip`, dem Python-Paketmanager. Öffnen Sie Ihre Befehlszeilenschnittstelle und führen Sie folgenden Befehl aus:
```shell
:ProductInstall
```
**Hinweis:** Um pip-Befehle verwenden zu können, muss Python zur Umgebungsvariablen PATH hinzugefügt werden.
3. **Integrierte Entwicklungsumgebung (IDE):** Die Verwendung einer IDE ist zwar nicht unbedingt notwendig, kann aber Ihr Entwicklungserlebnis erheblich verbessern. Es bietet Funktionen wie Codevervollständigung, Debugging und einen optimierten Arbeitsablauf. Eine beliebte IDE für die Python-Entwicklung ist PyCharm. Sie können PyCharm von der JetBrains-Website herunterladen und installieren [**: https://www.jetbrains.com/pycharm/**](https://www.jetbrains.com/pycharm/) .
4. **Texteditor:** Alternativ können Sie, wenn Sie lieber mit einem schlanken Texteditor arbeiten möchten, einen beliebigen Texteditor Ihrer Wahl verwenden, wie z. B. Visual Studio Code, Sublime Text oder Atom. Diese Editoren bieten Syntaxhervorhebung und andere nützliche Funktionen für die Python-Entwicklung. Alternativ können Sie auch die IDLE-Anwendung von Python verwenden.
## Erstellen eines Python-Projekts mit PyCharm
Nach der Installation der PyCharm IDE erstellen Sie ein PyCharm Python-Projekt, indem Sie die folgenden Schritte ausführen:
1. **Starten Sie PyCharm:** Öffnen Sie PyCharm über den Anwendungsstarter Ihres Systems oder die Desktopverknüpfung.
2. **Neues Projekt erstellen:** Klicken Sie auf "Neues Projekt erstellen" oder öffnen Sie ein bestehendes Python-Projekt.
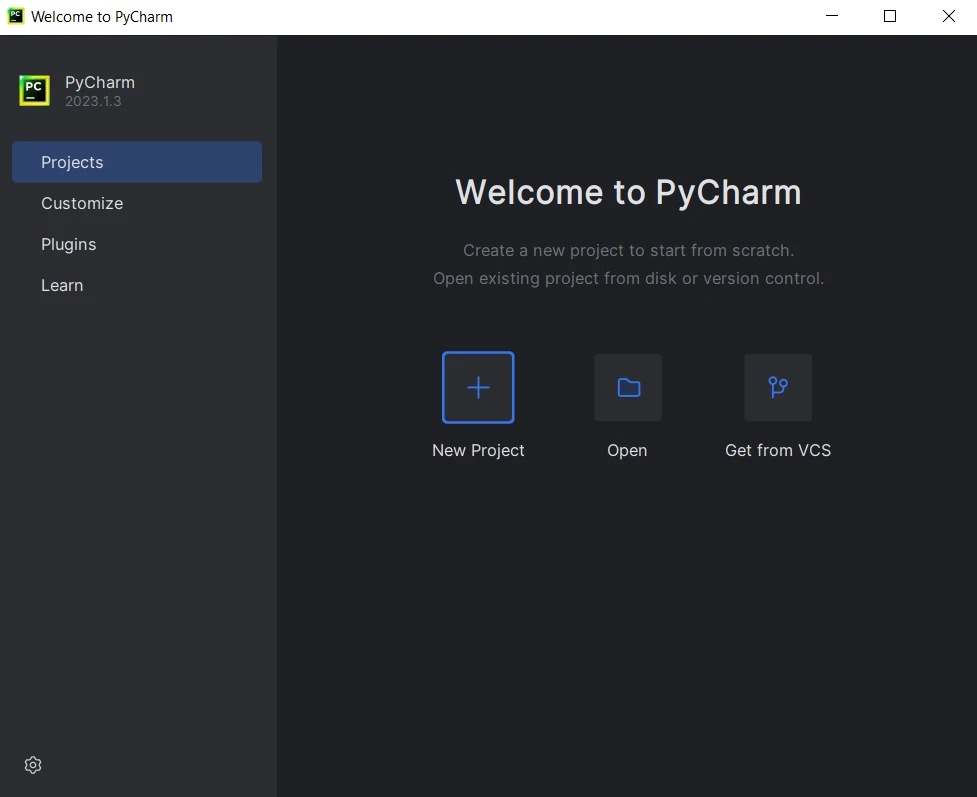
**PyCharm IDE**
3. **Projekteinstellungen konfigurieren:** Geben Sie Ihrem Projekt einen Namen und wählen Sie den Speicherort für das Projektverzeichnis. Wählen Sie den Python-Interpreter für Ihr Projekt aus. Klicken Sie anschließend auf "Erstellen".
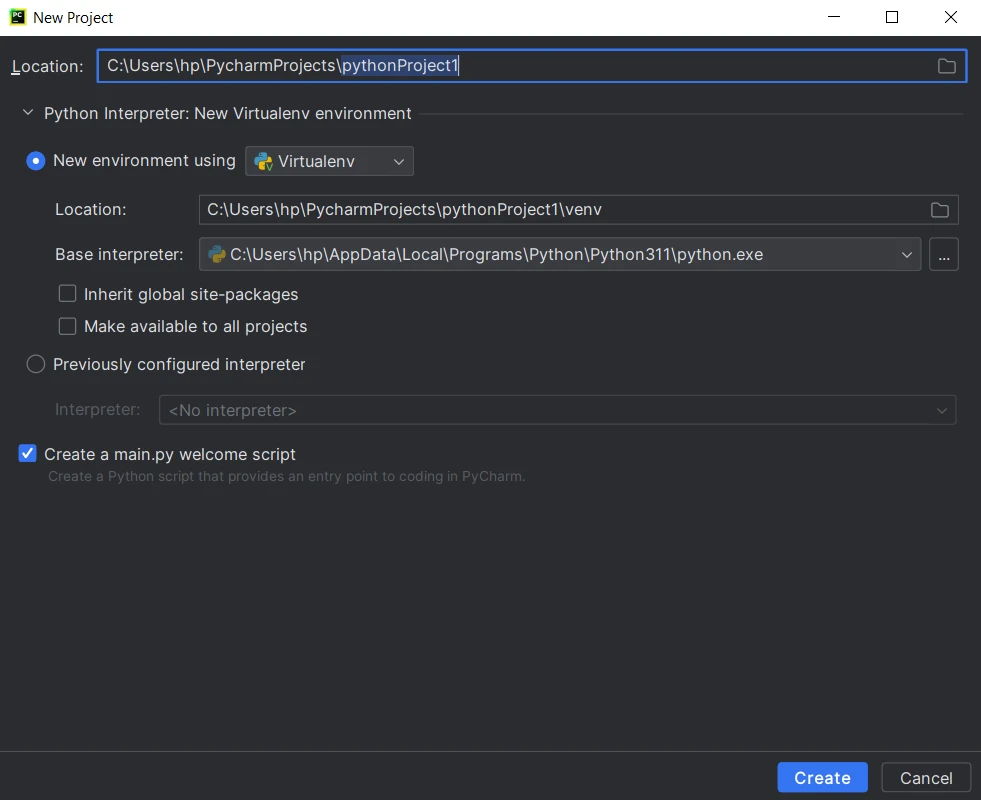
**Erstelle ein neues Python-Projekt in PyCharm**
4. **Quelldateien erstellen:** PyCharm erstellt die Projektstruktur, einschließlich einer Haupt-Python-Datei und eines Verzeichnisses für zusätzliche Quelldateien. Beginnen Sie mit dem Schreiben des Codes und klicken Sie auf die Schaltfläche "Ausführen" oder drücken Sie Shift+F10, um das Skript auszuführen.
## Textextraktion aus PDFs in Python mit IronPDF
Nun wollen wir uns die einzelnen Schritte ansehen, die zum Extrahieren von Klartext aus PDF-Dateien mit IronPDF in der Programmiersprache Python erforderlich sind.
### Importieren Sie die erforderlichen Bibliotheken
Importieren Sie zunächst die benötigten Bibliotheken in Ihr Python-Skript. In diesem Fall muss der Code die **IronPDF** -Bibliothek importieren, die die Funktionalität für die Arbeit mit PDF-Dateien bereitstellt.
```python
import ironpdf
```
### Lizenzschlüssel festlegen
Um mit IronPDF den Volltext aus einer PDF-Datei zu extrahieren, benötigen Sie eine IronPDF-Lizenz. Wenden Sie den Lizenz- oder Testschlüssel mit folgendem Befehl an:
```python
# Apply your license key
License.LicenseKey = "YOUR-LICENSE-KEY-HERE"
```
**Hinweis:** Ohne Lizenzschlüssel kann IronPDF nur wenige Zeichen aus der PDF-Datei extrahieren. Sie erhalten einen Lizenzschlüssel beim [Kauf von IronPDF](licensing) oder durch die Anmeldung zu einer [kostenlosen Testversion](trial-license) .
### Laden Sie das PDF-Dokument
Laden Sie als Nächstes die PDF-Datei mit der `PdfDocument.FromFile()`-Methode von IronPDF. Geben Sie den Pfad zur PDF-Datei als Argument für diese Methode an. Dadurch wird die PDF-Datei in ein `PdfDocument`-Objekt geladen.
```python
pdf = ironpdf.PdfDocument.FromFile("path/to/your/pdf_file.pdf")
```
#### Eingabedatei
Um Text aus der eingegebenen PDF-Datei zu extrahieren und auf dem Bildschirm auszugeben, wird folgendes Dokument verwendet:
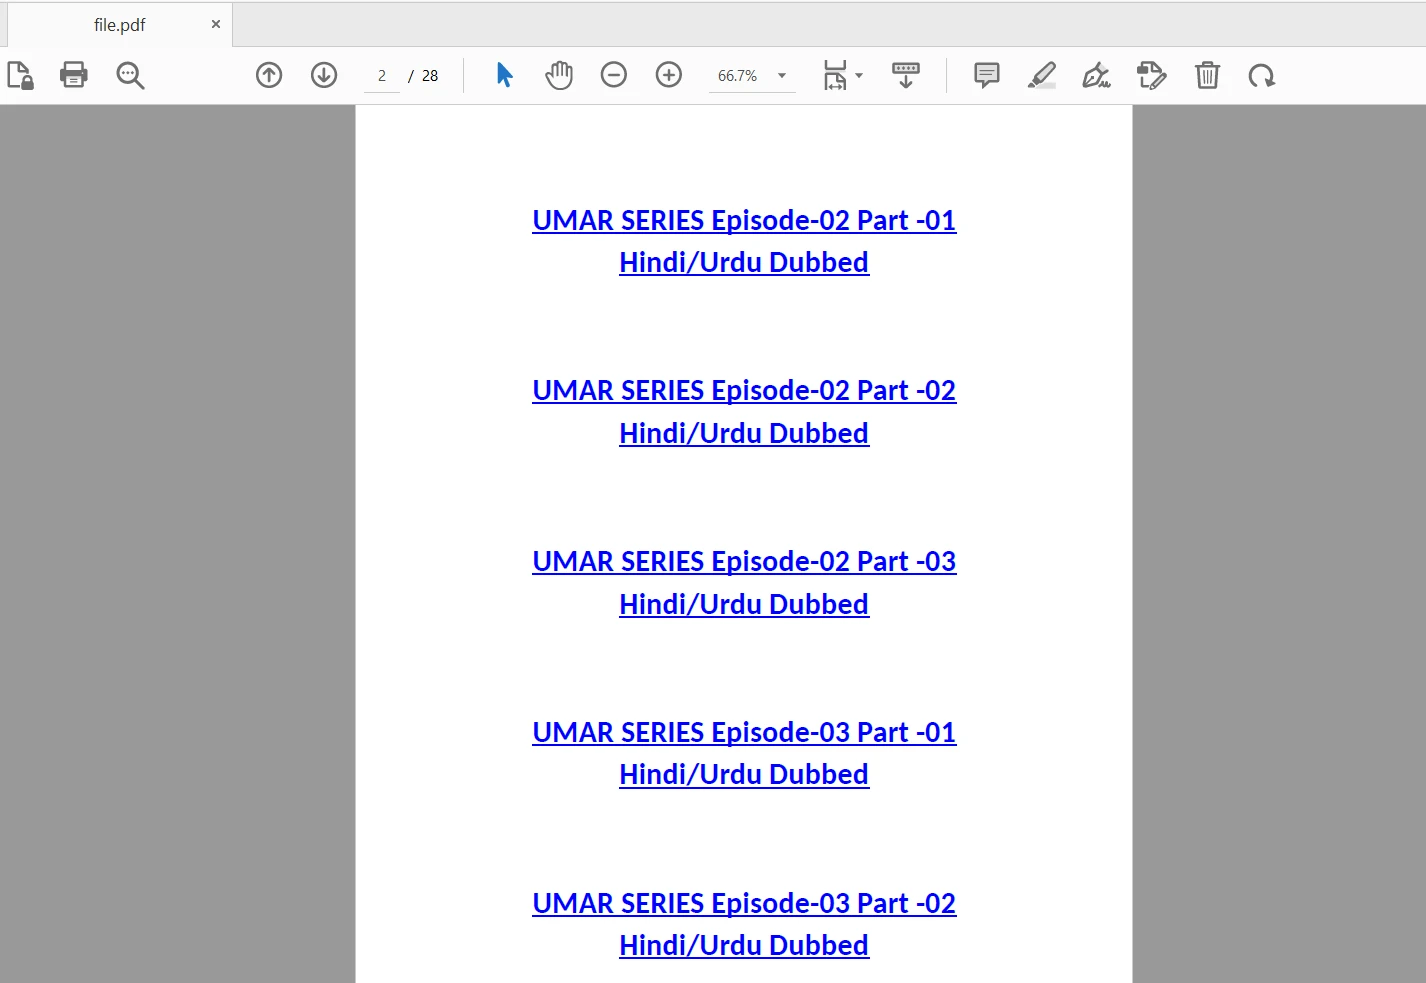
**Die Eingabedatei**
### Text aus PDF-Dateien extrahieren
Sobald das PDF-Dokument geladen ist, können Sie den Textinhalt mit der `ExtractText`-Methode extrahieren. Diese Methode gibt den extrahierten Text als Zeichenkette zurück.
```python
text = pdf.ExtractText()
```
### Verarbeiten und Nutzen des extrahierten Texts
Nachdem Sie den Text aus der PDF-Datei extrahiert haben, können Sie ihn nun entsprechend Ihren Anforderungen verarbeiten und nutzen. Sie können Aufgaben wie das Parsen des Textes, das Analysieren, das Speichern in einer Datenbank oder die Verwendung für die weitere Datenverarbeitung durchführen.
```python
# Process and utilize the extracted text
print(text)
# Perform other operations with the extracted text
```
#### Ausgabe
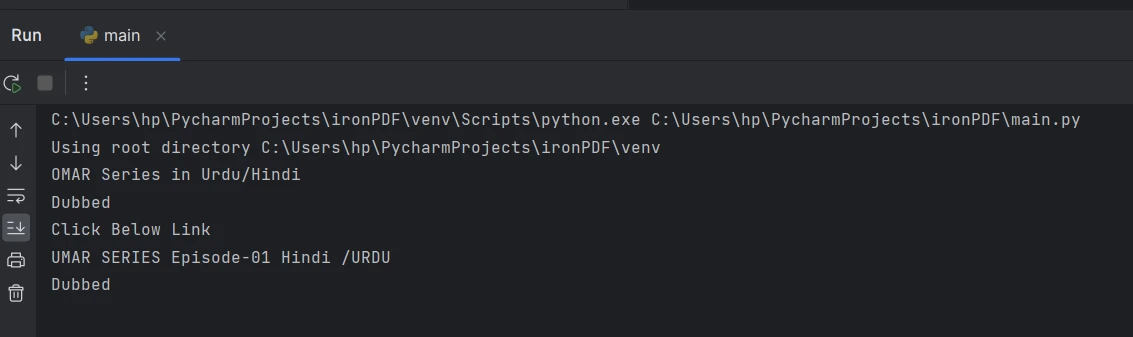
**Der aus der Konsole extrahierte Text**
### Text von einer bestimmten Seite in einer PDF-Datei extrahieren
IronPDF bietet auch eine bequeme Methode, um Text aus bestimmten Seiten innerhalb einer PDF-Datei zu extrahieren. Dieser Abschnitt erforscht, wie man Text aus einer bestimmten Seite mit der von IronPDF bereitgestellten `ExtractTextFromPage`-Methode extrahiert.
Der folgende Code veranschaulicht, wie man Text von einer bestimmten Seite extrahiert:
```python
# Extract text from a specific page in the document
page_2_text = pdf.ExtractTextFromPage(1)
```
Im obigen Beispielcode stellt `pdf` das `PdfDocument`-Objekt dar, das nach dem Laden des PDF-Dokuments erhalten wurde. Die `ExtractTextFromPage()`-Methode wird verwendet, um Text von einer bestimmten Seite zu extrahieren, die durch den als Argument übergebenen Seitenindex angegeben ist. In diesem Fall wird der Text von der zweiten Seite bzw. der Seitenzahl 2 entnommen, was dem Seitenindex 1 entspricht.
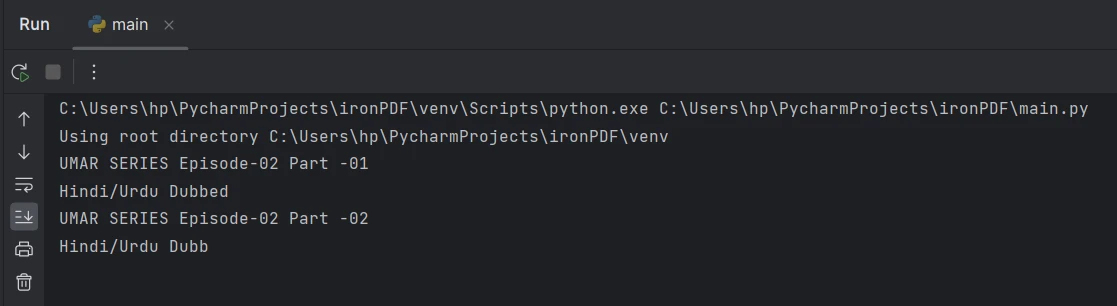
**Text von Seite 2 extrahieren**
## Abschluss
Dieser Artikel untersuchte, wie man mit IronPDF in Python Text aus PDF-Dateien extrahieren kann. Es umfasste die notwendigen Schritte, einschließlich des Importierens der benötigten Bibliothek, des Ladens des PDF-Dokuments, des Extrahierens des Textinhalts und der Verarbeitung des extrahierten Textes.
Mit den leistungsstarken Textextraktionsfunktionen von IronPDF können Sie die Extraktion und Weiterverarbeitung von Text aus PDFs automatisieren und so die Textinformationen in PDF-Dokumenten einfach verarbeiten und analysieren. Dank seiner intuitiven API und umfangreichen Funktionen ist es die ideale Wahl für eine breite Palette von PDF-bezogenen Aufgaben in der Python-Entwicklung.
IronPDF ist für Entwicklungszwecke kostenlos, für die kommerzielle Nutzung ist jedoch eine Lizenz erforderlich. Um es im Produktionsmodus zu Testzwecken zu nutzen, fordern Sie eine [kostenlose Testversion](trial-license) an. Laden Sie die neueste Version von [IronPDF for Python](/python/) herunter, installieren Sie sie und probieren Sie sie aus.
Dieser Artikel zeigt Ihnen, wie Sie mit IronPDF in Python den gesamten Text aus PDF-Dateien extrahieren können. Er liefert Ihnen das nötige Wissen und Python-Codebeispiele, um diese Aufgabe effizient zu erledigen.
Verwenden Sie die Methode FromFile, um die PDF-Datei zu importieren
Extrahieren von Text aus der importierten PDF-Datei mit der Methode ExtractText
Extrahieren von Text aus bestimmten Seiten mit der Methode ExtractTextFromPage
Geben Sie den extrahierten Text auf der Konsole oder in einer Textdatei aus
IronPDF - Python-Bibliothek
IronPDF for Python ist eine leistungsstarke Python-PDF-Bibliothek, die es Entwicklern ermöglicht, Text aus PDF-Dokumenten zu extrahieren. Mit IronPDF können Sie die Datenextraktion von Textinhalten aus PDF-Dateien automatisieren, was die Verarbeitung und Analyse der in PDF-Dokumenten enthaltenen Informationen erleichtert.
IronPDF bietet Python-Programmierern die Möglichkeit, PDF-Dateien mit Python zu bearbeiten, Daten daraus zu extrahieren und mit ihnen zu interagieren, wodurch die Automatisierung verschiedener PDF-bezogener Aufgaben erleichtert wird. Egal ob Sie PDFs generieren, bestehende PDFs bearbeiten, Daten aus Inhalten extrahieren oder andere PDF-Operationen durchführen müssen, IronPDF vereinfacht den Prozess mit seiner intuitiven API und seinen leistungsstarken Funktionen.
Wichtige Merkmale
Zu den Funktionen der IronPDF-Bibliothek für Python gehören unter anderem:
Bevor Sie mit der Textextraktion mithilfe von IronPDF fortfahren, stellen Sie sicher, dass die folgenden Voraussetzungen erfüllt sind:
Python-Installation: Stellen Sie sicher, dass Python auf Ihrem System installiert ist. IronPDF ist mit Python 3.x-Versionen kompatibel. Stellen Sie daher sicher, dass Sie über eine kompatible Python-Installation verfügen.
IronPDF-Bibliothek: Installieren Sie die IronPDF-Bibliothek mit pip, dem Python-Paketmanager. Öffnen Sie Ihre Befehlszeilenschnittstelle und führen Sie folgenden Befehl aus:
> pip install ironpdf
pip install ironpdf
Hinweis: Um pip-Befehle verwenden zu können, muss Python zur Umgebungsvariablen PATH hinzugefügt werden.
Integrierte Entwicklungsumgebung (IDE): Die Verwendung einer IDE ist zwar nicht unbedingt notwendig, kann aber Ihr Entwicklungserlebnis erheblich verbessern. Es bietet Funktionen wie Codevervollständigung, Debugging und einen optimierten Arbeitsablauf. Eine beliebte IDE für die Python-Entwicklung ist PyCharm. Sie können PyCharm von der JetBrains-Website herunterladen und installieren : https://www.jetbrains.com/pycharm/ .
Texteditor: Alternativ können Sie, wenn Sie lieber mit einem schlanken Texteditor arbeiten möchten, einen beliebigen Texteditor Ihrer Wahl verwenden, wie z. B. Visual Studio Code, Sublime Text oder Atom. Diese Editoren bieten Syntaxhervorhebung und andere nützliche Funktionen für die Python-Entwicklung. Alternativ können Sie auch die IDLE-Anwendung von Python verwenden.
Erstellen eines Python-Projekts mit PyCharm
Nach der Installation der PyCharm IDE erstellen Sie ein PyCharm Python-Projekt, indem Sie die folgenden Schritte ausführen:
Starten Sie PyCharm: Öffnen Sie PyCharm über den Anwendungsstarter Ihres Systems oder die Desktopverknüpfung.
Neues Projekt erstellen: Klicken Sie auf "Neues Projekt erstellen" oder öffnen Sie ein bestehendes Python-Projekt.
PyCharm IDE
Projekteinstellungen konfigurieren: Geben Sie Ihrem Projekt einen Namen und wählen Sie den Speicherort für das Projektverzeichnis. Wählen Sie den Python-Interpreter für Ihr Projekt aus. Klicken Sie anschließend auf "Erstellen".
Erstelle ein neues Python-Projekt in PyCharm
Quelldateien erstellen: PyCharm erstellt die Projektstruktur, einschließlich einer Haupt-Python-Datei und eines Verzeichnisses für zusätzliche Quelldateien. Beginnen Sie mit dem Schreiben des Codes und klicken Sie auf die Schaltfläche "Ausführen" oder drücken Sie Shift+F10, um das Skript auszuführen.
Textextraktion aus PDFs in Python mit IronPDF
Nun wollen wir uns die einzelnen Schritte ansehen, die zum Extrahieren von Klartext aus PDF-Dateien mit IronPDF in der Programmiersprache Python erforderlich sind.
Importieren Sie die erforderlichen Bibliotheken
Importieren Sie zunächst die benötigten Bibliotheken in Ihr Python-Skript. In diesem Fall muss der Code die IronPDF -Bibliothek importieren, die die Funktionalität für die Arbeit mit PDF-Dateien bereitstellt.
import ironpdf
import ironpdf
Python
Lizenzschlüssel festlegen
Um mit IronPDF den Volltext aus einer PDF-Datei zu extrahieren, benötigen Sie eine IronPDF-Lizenz. Wenden Sie den Lizenz- oder Testschlüssel mit folgendem Befehl an:
# Apply your license keyLicense.LicenseKey = "YOUR-LICENSE-KEY-HERE"
# Apply your license key
License.LicenseKey = "YOUR-LICENSE-KEY-HERE"
Python
Hinweis: Ohne Lizenzschlüssel kann IronPDF nur wenige Zeichen aus der PDF-Datei extrahieren. Sie erhalten einen Lizenzschlüssel beim Kauf von IronPDF oder durch die Anmeldung zu einer kostenlosen Testversion .
Laden Sie das PDF-Dokument
Laden Sie als Nächstes die PDF-Datei mit der PdfDocument.FromFile()-Methode von IronPDF. Geben Sie den Pfad zur PDF-Datei als Argument für diese Methode an. Dadurch wird die PDF-Datei in ein PdfDocument-Objekt geladen.
pdf = ironpdf.PdfDocument.FromFile("path/to/your/pdf_file.pdf")
pdf = ironpdf.PdfDocument.FromFile("path/to/your/pdf_file.pdf")
Python
Eingabedatei
Um Text aus der eingegebenen PDF-Datei zu extrahieren und auf dem Bildschirm auszugeben, wird folgendes Dokument verwendet:
Die Eingabedatei
Text aus PDF-Dateien extrahieren
Sobald das PDF-Dokument geladen ist, können Sie den Textinhalt mit der ExtractText-Methode extrahieren. Diese Methode gibt den extrahierten Text als Zeichenkette zurück.
text = pdf.ExtractText()
text = pdf.ExtractText()
Python
Verarbeiten und Nutzen des extrahierten Texts
Nachdem Sie den Text aus der PDF-Datei extrahiert haben, können Sie ihn nun entsprechend Ihren Anforderungen verarbeiten und nutzen. Sie können Aufgaben wie das Parsen des Textes, das Analysieren, das Speichern in einer Datenbank oder die Verwendung für die weitere Datenverarbeitung durchführen.
# Process and utilize the extracted textprint(text)# Perform other operations with the extracted text
# Process and utilize the extracted text
print(text)
# Perform other operations with the extracted text
Python
Ausgabe
Der aus der Konsole extrahierte Text
Text von einer bestimmten Seite in einer PDF-Datei extrahieren
IronPDF bietet auch eine bequeme Methode, um Text aus bestimmten Seiten innerhalb einer PDF-Datei zu extrahieren. Dieser Abschnitt erforscht, wie man Text aus einer bestimmten Seite mit der von IronPDF bereitgestellten ExtractTextFromPage-Methode extrahiert.
Der folgende Code veranschaulicht, wie man Text von einer bestimmten Seite extrahiert:
# Extract text from a specific page in the documentpage_2_text = pdf.ExtractTextFromPage(1)
# Extract text from a specific page in the document
page_2_text = pdf.ExtractTextFromPage(1)
Python
Im obigen Beispielcode stellt pdf das PdfDocument-Objekt dar, das nach dem Laden des PDF-Dokuments erhalten wurde. Die ExtractTextFromPage()-Methode wird verwendet, um Text von einer bestimmten Seite zu extrahieren, die durch den als Argument übergebenen Seitenindex angegeben ist. In diesem Fall wird der Text von der zweiten Seite bzw. der Seitenzahl 2 entnommen, was dem Seitenindex 1 entspricht.
Text von Seite 2 extrahieren
Abschluss
Dieser Artikel untersuchte, wie man mit IronPDF in Python Text aus PDF-Dateien extrahieren kann. Es umfasste die notwendigen Schritte, einschließlich des Importierens der benötigten Bibliothek, des Ladens des PDF-Dokuments, des Extrahierens des Textinhalts und der Verarbeitung des extrahierten Textes.
Mit den leistungsstarken Textextraktionsfunktionen von IronPDF können Sie die Extraktion und Weiterverarbeitung von Text aus PDFs automatisieren und so die Textinformationen in PDF-Dokumenten einfach verarbeiten und analysieren. Dank seiner intuitiven API und umfangreichen Funktionen ist es die ideale Wahl für eine breite Palette von PDF-bezogenen Aufgaben in der Python-Entwicklung.
IronPDF ist für Entwicklungszwecke kostenlos, für die kommerzielle Nutzung ist jedoch eine Lizenz erforderlich. Um es im Produktionsmodus zu Testzwecken zu nutzen, fordern Sie eine kostenlose Testversion an. Laden Sie die neueste Version von IronPDF for Python herunter, installieren Sie sie und probieren Sie sie aus.
Curtis Chau hat einen Bachelor-Abschluss in Informatik von der Carleton University und ist spezialisiert auf Frontend-Entwicklung mit Expertise in Node.js, TypeScript, JavaScript und React. Leidenschaftlich widmet er sich der Erstellung intuitiver und ästhetisch ansprechender Benutzerschnittstellen und arbeitet gerne mit modernen Frameworks sowie der Erstellung gut strukturierter, optisch ansprechender Handbücher.


 PyCharm IDE
 Erstelle ein neues Python-Projekt in PyCharm
 Die Eingabedatei
 Der aus der Konsole extrahierte Text
 Text von Seite 2 extrahieren







