using IronPdf;

// Disable local disk access or cross-origin requests
Installation.EnableWebSecurity = true;

// Instantiate Renderer
var renderer = new ChromePdfRenderer();

// Create a PDF from a HTML string using C#
var pdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>");

// Export to a file or Stream
pdf.SaveAs("output.pdf");

// Advanced Example with HTML Assets
// Load external html assets: Images, CSS and JavaScript.
// An optional BasePath 'C:\site\assets\' is set as the file location to load assets from
var myAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", @"C:\site\assets\");
myAdvancedPdf.SaveAs("html-with-assets.pdf");
using IronPdf;// Disable local disk access or cross-origin requestsInstallation.EnableWebSecurity = true;// Instantiate Renderervar renderer = new ChromePdfRenderer();// Create a PDF from a HTML string using C#var pdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>");// Export to a file or Streampdf.SaveAs("output.pdf");// Advanced Example with HTML Assets// Load external html assets: Images, CSS and JavaScript.// An optional BasePath 'C:\site\assets\' is set as the file location to load assets fromvar myAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", @"C:\site\assets\");myAdvancedPdf.SaveAs("html-with-assets.pdf");
PM >Install-Package IronPdf
Install-Package IronPdf
MISES À JOUR POUR LES DÉVELOPPEURS
C# Foreach parallèle (Comment cela fonctionne pour les développeurs)
### Qu'est-ce que Parallel.ForEach en C# ?
[Parallel.ForEach](https://learn.microsoft.com/en-us/dotnet/api/system.threading.tasks.parallel.foreach?view=net-9.0) est une méthode en C# qui vous permet d'effectuer des itérations parallèles sur une collection ou une source de données. Au lieu de traiter chaque élément de la collection de manière séquentielle, une boucle parallèle permet une exécution simultanée, ce qui peut améliorer significativement les performances en réduisant le temps d'exécution global. Le traitement en parallèle fonctionne en répartissant le travail sur plusieurs processeurs, permettant ainsi aux tâches de s'exécuter simultanément. Cela est particulièrement utile pour traiter des tâches indépendantes les unes des autres.
Contrairement à une boucle foreach normale, qui traite les éléments de manière séquentielle, l'approche parallèle peut gérer de grands ensembles de données beaucoup plus rapidement en utilisant plusieurs threads simultanément.
### Pourquoi utiliser le traitement parallèle avec IronPDF ?
[IronPDF](https://ironpdf.com) est une bibliothèque puissante pour gérer les PDF dans .NET, capable de [convertir HTML en PDF](/how-to/html-string-to-pdf/), [extraire du texte des PDF](/how-to/extract-text-and-images/), [fusionner et séparer des documents](/how-to/merge-or-split-pdfs/), et plus encore. Lorsqu'on traite de gros volumes de tâches PDF, utiliser le traitement parallèle avec Parallel.ForEach peut réduire significativement le temps d'exécution. Que vous génériez des centaines de PDFs ou que vous extrayiez des données depuis plusieurs fichiers en même temps, exploiter le parallélisme des données avec IronPDF garantit des tâches accomplies plus rapidement et plus efficacement.
Ce guide est destiné aux développeurs .NET qui souhaitent optimiser leurs tâches de traitement de PDF avec IronPDF et Parallel.ForEach. Une connaissance de base du C# et une familiarité avec la bibliothèque IronPDF sont recommandées. À la fin de ce guide, vous serez capable de mettre en œuvre le traitement parallèle pour traiter plusieurs tâches PDF simultanément, améliorant ainsi la performance et la scalabilité.
## Commencer
### Installer IronPDF
Pour utiliser [IronPDF](https://www.nuget.org/packages/IronPdf/) dans votre projet, vous devez installer la bibliothèque via NuGet.
#### Installation du package NuGet
Pour installer IronPDF, suivez ces étapes :
1. Ouvrez votre projet dans Visual Studio.
2. Allez dans **Outils** → **Gestionnaire de packages NuGet** → **Gérer les packages NuGet pour la solution**.
3. Recherchez IronPDF dans le gestionnaire de packages NuGet.

4. Cliquez sur **Installer** pour ajouter la bibliothèque IronPDF à votre projet.

Alternativement, vous pouvez l'installer via la console du Gestionnaire de packages NuGet :
```shell
:ProductInstall
```
Une fois IronPDF installé, vous êtes prêt à l'utiliser pour des tâches de génération et de manipulation de PDF.
### Basic Concepts of Parallel.ForEach in C#
`Parallel.ForEach` fait partie de l'espace de noms `System.Threading.Tasks` et offre une manière simple et efficace d'exécuter des itérations simultanément. La syntaxe pour `Parallel.ForEach` est la suivante :
```csharp
Parallel.ForEach(collection, item =>
{
    // Code to process each item
});
```
Chaque élément de la collection est traité en parallèle, et le système décide comment répartir la charge de travail sur les threads disponibles. Vous pouvez également spécifier des options pour contrôler le degré de parallélisme, comme le nombre maximum de threads utilisés.
En comparaison, une boucle `foreach` traditionnelle traite chaque élément l'un après l'autre, tandis que la boucle parallèle peut traiter plusieurs éléments simultanément, améliorant ainsi les performances lors de la gestion de grandes collections.
## Mise en œuvre étape par étape
### Configuration du projet
Tout d'abord, assurez-vous qu'IronPDF est installé comme décrit dans la section Démarrage. Après cela, vous pouvez commencer à écrire votre logique de traitement PDF parallèle.
### Écriture de la logique de traitement parallèle
#### Exemple de code : Utilisation de Parallel.ForEach pour la conversion de HTML en PDF
```csharp
string[] htmlFiles = { "page1.html", "page2.html", "page3.html" };
Parallel.ForEach(htmlFiles, htmlFile =>
{
// Load the HTML content into IronPDF and convert it to PDF
ChromePdfRenderer renderer = new ChromePdfRenderer();
PdfDocument pdf = renderer.RenderHtmlAsPdf(htmlFile);
// Save the generated PDF to the output folder
pdf.SaveAs($"output_{htmlFile}.pdf");
});
```
Ce code démontre comment convertir plusieurs pages HTML en PDFs en parallèle.
### Gestion des erreurs de traitement parallèle
Lorsqu'on traite des tâches parallèles, la gestion des erreurs est cruciale. Utilisez des blocs try-catch à l'intérieur de la boucle `Parallel.ForEach` pour gérer toutes les exceptions.
#### Exemple de code : Gestion des erreurs dans les tâches PDF parallèles
```csharp
Parallel.ForEach(pdfFiles, pdfFile =>
{
try
{
var pdf = IronPdf.PdfDocument.FromFile(pdfFile);
string text = pdf.ExtractAllText();
System.IO.File.WriteAllText($"extracted_{pdfFile}.txt", text);
}
catch (Exception ex)
{
Console.WriteLine($"Error processing {pdfFile}: {ex.Message}");
}
});
```
## Cas d'utilisation pratiques avec des exemples de code complets
### Extraction de texte de plusieurs PDFs simultanément
Un autre cas d'utilisation du traitement parallèle est l'extraction de texte d'un lot de PDFs. En traitant plusieurs fichiers PDF, effectuer l'extraction de texte simultanément peut permettre de gagner beaucoup de temps. L'exemple suivant démontre comment cela peut être fait.
#### Exemple : Extraction de texte en parallèle de plusieurs documents
```csharp
using IronPdf;
using System.Linq;
using System.Threading.Tasks;
class Program
{
static void Main(string[] args)
{
string[] pdfFiles = { "doc1.pdf", "doc2.pdf", "doc3.pdf" };
Parallel.ForEach(pdfFiles, pdfFile =>
{
var pdf = IronPdf.PdfDocument.FromFile(pdfFile);
string text = pdf.ExtractText();
System.IO.File.WriteAllText($"extracted_{pdfFile}.txt", text);
});
}
}
```
### Documents de sortie

Dans ce code, chaque fichier PDF est traité en parallèle pour extraire le texte, et le texte extrait est sauvegardé dans des fichiers texte séparés.
### Exemple : Génération de PDFs en lot à partir de fichiers HTML en parallèle
Dans cet exemple, nous allons générer plusieurs PDFs à partir d'une liste de fichiers HTML en parallèle, ce qui peut être un scénario typique lorsque vous devez convertir plusieurs pages HTML dynamiques en documents PDF.
### Code
```csharp
using IronPdf;
using System;
using System.Threading.Tasks;
class Program
{
static void Main(string[] args)
{
string[] htmlFiles = { "example.html", "example_1.html", "example_2.html" };
Parallel.ForEach(htmlFiles, htmlFile =>
{
try
{
// Load the HTML content into IronPDF and convert it to PDF
ChromePdfRenderer renderer = new ChromePdfRenderer();
PdfDocument pdf = renderer.RenderHtmlFileAsPdf(htmlFile);
// Save the generated PDF to the output folder
pdf.SaveAs($"output_{htmlFile}.pdf");
Console.WriteLine($"PDF created for {htmlFile}");
}
catch (Exception ex)
{
Console.WriteLine($"Error processing {htmlFile}: {ex.Message}");
}
});
}
}
```
### Sortie console

### PDF en sortie

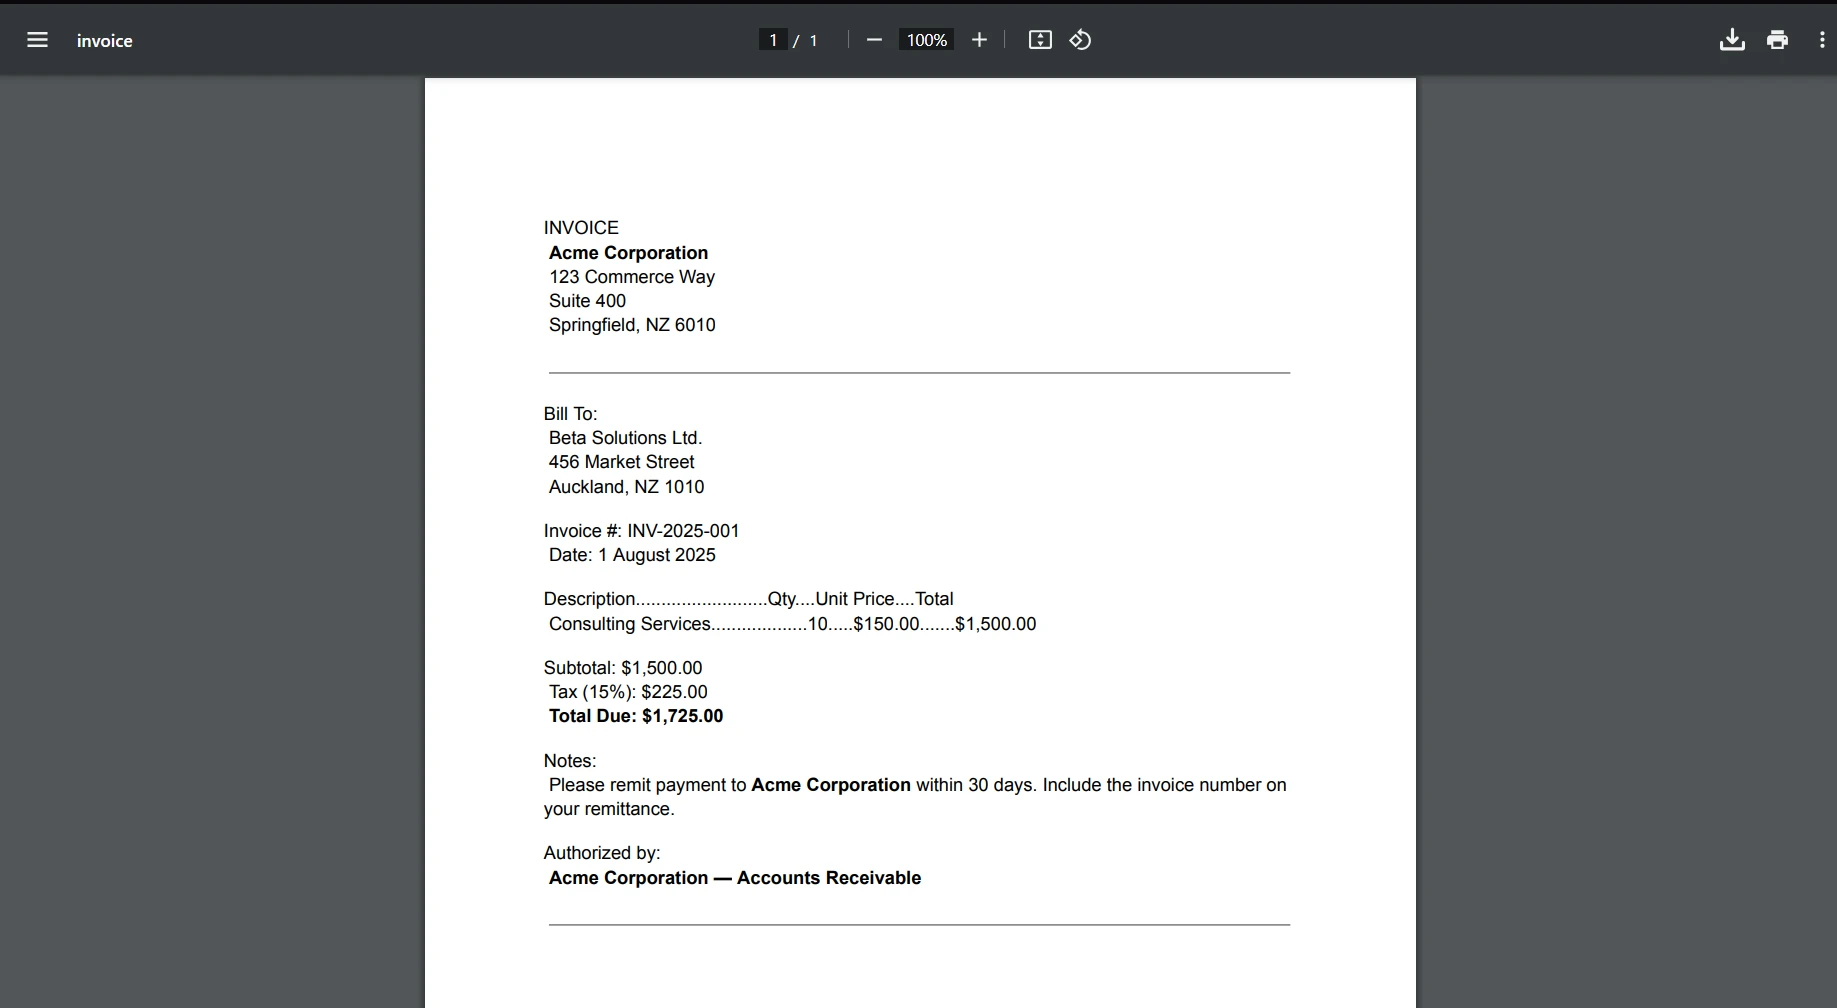
### Explication
1. **Fichiers HTML :** Le tableau `htmlFiles` contient les chemins vers plusieurs fichiers HTML que vous souhaitez convertir en PDF.
2. **Traitement parallèle :**
- `Parallel.ForEach(htmlFiles, htmlFile => {...})` traite chaque fichier HTML simultanément, ce qui accélère l'opération lorsqu'il s'agit de plusieurs fichiers.
- Pour chaque fichier dans le tableau `htmlFiles`, le code le convertit en PDF en utilisant `renderer.RenderHtmlFileAsPdf(htmlFile);`.
3. **Enregistrer le PDF :** Après avoir généré le PDF, il est enregistré en utilisant la méthode `pdf.SaveAs`, en ajoutant le nom de fichier de sortie au nom du fichier HTML d'origine.
4. **Gestion des erreurs :** Si une erreur se produit (par ex., le fichier HTML n'existe pas ou il y a un problème lors de la conversion), elle est capturée par le bloc try-catch, et un message d'erreur est affiché pour le fichier spécifique.
## Astuces de performance et meilleures pratiques
### Éviter les problèmes de sécurité des threads avec IronPDF
IronPDF est thread-safe pour la plupart des opérations. Cependant, certaines opérations comme l'écriture dans le même fichier en parallèle peuvent causer des problèmes. Assurez-vous toujours que chaque tâche parallèle opère sur un fichier ou une ressource de sortie distincts.
### Optimiser le traitement parallèle pour les grandes ensembles de données
Pour optimiser les performances, envisagez de contrôler le degré de parallélisme. Pour les grands ensembles de données, vous voudrez peut-être limiter le nombre de threads simultanés pour éviter la surcharge du système.
```csharp
var options = new ExecutionDataflowBlockOptions
{
MaxDegreeOfParallelism = 4
};
```
### Gestion de la mémoire dans les opérations PDF parallèles
Lors du traitement d'un grand nombre de PDFs, faites attention à l'utilisation de la mémoire. Essayez de libérer les ressources comme les objets `PdfDocument` dès qu'ils ne sont plus nécessaires.
### Utilisation des méthodes d'extension
Une méthode d'extension est un type spécial de méthode statique qui vous permet d'ajouter de nouvelles fonctionnalités à un type existant sans modifier son code source. Cela peut être utile lorsque vous travaillez avec des bibliothèques comme IronPDF, où vous pourriez vouloir ajouter des méthodes de traitement personnalisées ou étendre ses fonctionnalités pour rendre le travail avec des PDFs plus pratique, en particulier dans les scénarios de traitement parallèle.
#### Les avantages de l'utilisation des méthodes d'extension dans le traitement parallèle
En utilisant des méthodes d'extension, vous pouvez créer un code concis et réutilisable qui simplifie la logique dans les boucles parallèles. Cette approche ne réduit pas seulement la duplication mais vous aide aussi à maintenir une base de code propre, surtout lorsque vous traitez des flux de travail PDF complexes et du parallélisme des données.
## Conclusion
L'utilisation de boucles parallèles comme `Parallel.ForEach` avec [IronPDF](https://ironpdf.com) offre des gains de performance significatifs lors du traitement de grands volumes de PDF. Que vous convertissiez du HTML en PDFs, extrayiez du texte, ou manipuliez des documents, le parallélisme des données permet une exécution plus rapide en exécutant les tâches simultanément. L'approche parallèle garantit que les opérations peuvent être exécutées sur plusieurs processeurs, ce qui réduit le temps d'exécution global et améliore les performances pour les tâches de traitement en lots.
Bien que le traitement parallèle accélère les tâches, soyez conscient de la sécurité des threads et de la gestion des ressources. IronPDF est thread-safe pour la plupart des opérations, mais il est important de gérer les conflits potentiels lors de l'accès aux ressources partagées. Considérez la gestion des erreurs et de la mémoire pour assurer la stabilité, surtout à mesure que votre application évolue.
Si vous êtes prêt à plonger plus profondément dans IronPDF et explorer des fonctionnalités avancées, la [documentation officielle](https://ironpdf.com) offre des informations détaillées. De plus, vous pouvez profiter d'une licence d'essai, vous permettant de tester la bibliothèque dans vos propres projets avant de vous engager à un achat.
Parallel.ForEach est une méthode en C# qui vous permet d'effectuer des itérations parallèles sur une collection ou une source de données. Au lieu de traiter chaque élément de la collection de manière séquentielle, une boucle parallèle permet une exécution simultanée, ce qui peut améliorer significativement les performances en réduisant le temps d'exécution global. Le traitement en parallèle fonctionne en répartissant le travail sur plusieurs processeurs, permettant ainsi aux tâches de s'exécuter simultanément. Cela est particulièrement utile pour traiter des tâches indépendantes les unes des autres.
Contrairement à une boucle foreach normale, qui traite les éléments de manière séquentielle, l'approche parallèle peut gérer de grands ensembles de données beaucoup plus rapidement en utilisant plusieurs threads simultanément.
Pourquoi utiliser le traitement parallèle avec IronPDF ?
IronPDF est une bibliothèque puissante pour gérer les PDF dans .NET, capable de convertir HTML en PDF, extraire du texte des PDF, fusionner et séparer des documents, et plus encore. Lorsqu'on traite de gros volumes de tâches PDF, utiliser le traitement parallèle avec Parallel.ForEach peut réduire significativement le temps d'exécution. Que vous génériez des centaines de PDFs ou que vous extrayiez des données depuis plusieurs fichiers en même temps, exploiter le parallélisme des données avec IronPDF garantit des tâches accomplies plus rapidement et plus efficacement.
Ce guide est destiné aux développeurs .NET qui souhaitent optimiser leurs tâches de traitement de PDF avec IronPDF et Parallel.ForEach. Une connaissance de base du C# et une familiarité avec la bibliothèque IronPDF sont recommandées. À la fin de ce guide, vous serez capable de mettre en œuvre le traitement parallèle pour traiter plusieurs tâches PDF simultanément, améliorant ainsi la performance et la scalabilité.
Commencer
Installer IronPDF
Pour utiliser IronPDF dans votre projet, vous devez installer la bibliothèque via NuGet.
Installation du package NuGet
Pour installer IronPDF, suivez ces étapes :
Ouvrez votre projet dans Visual Studio.
Allez dans Outils → Gestionnaire de packages NuGet → Gérer les packages NuGet pour la solution.
Recherchez IronPDF dans le gestionnaire de packages NuGet.
Cliquez sur Installer pour ajouter la bibliothèque IronPDF à votre projet.
Alternativement, vous pouvez l'installer via la console du Gestionnaire de packages NuGet :
PM > Install-Package IronPdf
Install-Package IronPdf
Une fois IronPDF installé, vous êtes prêt à l'utiliser pour des tâches de génération et de manipulation de PDF.
Basic Concepts of Parallel.ForEach in C#
Parallel.ForEach fait partie de l'espace de noms System.Threading.Tasks et offre une manière simple et efficace d'exécuter des itérations simultanément. La syntaxe pour Parallel.ForEach est la suivante :
Parallel.ForEach(collection, item =>{ // Code to process each item});
Parallel.ForEach(collection, item =>
{
    // Code to process each item
});
Parallel.ForEach(collection, Sub(item) ' Code to process each itemEnd Sub)
Parallel.ForEach(collection, Sub(item)
	' Code to process each item
End Sub)
Chaque élément de la collection est traité en parallèle, et le système décide comment répartir la charge de travail sur les threads disponibles. Vous pouvez également spécifier des options pour contrôler le degré de parallélisme, comme le nombre maximum de threads utilisés.
En comparaison, une boucle foreach traditionnelle traite chaque élément l'un après l'autre, tandis que la boucle parallèle peut traiter plusieurs éléments simultanément, améliorant ainsi les performances lors de la gestion de grandes collections.
Mise en œuvre étape par étape
Configuration du projet
Tout d'abord, assurez-vous qu'IronPDF est installé comme décrit dans la section Démarrage. Après cela, vous pouvez commencer à écrire votre logique de traitement PDF parallèle.
Écriture de la logique de traitement parallèle
Exemple de code : Utilisation de Parallel.ForEach pour la conversion de HTML en PDF
string[] htmlFiles = { "page1.html", "page2.html", "page3.html" };Parallel.ForEach(htmlFiles, htmlFile =>{ // Load the HTML content into IronPDF and convert it to PDF ChromePdfRenderer renderer = new ChromePdfRenderer(); PdfDocument pdf = renderer.RenderHtmlAsPdf(htmlFile); // Save the generated PDF to the output folder pdf.SaveAs($"output_{htmlFile}.pdf");});
string[] htmlFiles = { "page1.html", "page2.html", "page3.html" };
Parallel.ForEach(htmlFiles, htmlFile =>
{
    // Load the HTML content into IronPDF and convert it to PDF
    ChromePdfRenderer renderer = new ChromePdfRenderer();
    PdfDocument pdf = renderer.RenderHtmlAsPdf(htmlFile);
    // Save the generated PDF to the output folder
    pdf.SaveAs($"output_{htmlFile}.pdf");
});
Dim htmlFiles() AsString = { "page1.html", "page2.html", "page3.html" }Parallel.ForEach(htmlFiles, Sub(htmlFile) ' Load the HTML content into IronPDF and convert it to PDF Dim renderer As New ChromePdfRenderer() Dim pdf AsPdfDocument = renderer.RenderHtmlAsPdf(htmlFile) ' Save the generated PDF to the output folder pdf.SaveAs($"output_{htmlFile}.pdf")End Sub)
Dim htmlFiles() As String = { "page1.html", "page2.html", "page3.html" }
Parallel.ForEach(htmlFiles, Sub(htmlFile)
	' Load the HTML content into IronPDF and convert it to PDF
	Dim renderer As New ChromePdfRenderer()
	Dim pdf As PdfDocument = renderer.RenderHtmlAsPdf(htmlFile)
	' Save the generated PDF to the output folder
	pdf.SaveAs($"output_{htmlFile}.pdf")
End Sub)
Ce code démontre comment convertir plusieurs pages HTML en PDFs en parallèle.
Gestion des erreurs de traitement parallèle
Lorsqu'on traite des tâches parallèles, la gestion des erreurs est cruciale. Utilisez des blocs try-catch à l'intérieur de la boucle Parallel.ForEach pour gérer toutes les exceptions.
Exemple de code : Gestion des erreurs dans les tâches PDF parallèles
Parallel.ForEach(pdfFiles, pdfFile =>{ try { var pdf = IronPdf.PdfDocument.FromFile(pdfFile); string text = pdf.ExtractAllText();System.IO.File.WriteAllText($"extracted_{pdfFile}.txt", text); } catch (Exception ex) {Console.WriteLine($"Error processing {pdfFile}: {ex.Message}"); }});
Parallel.ForEach(pdfFiles, pdfFile =>
{
    try
    {
        var pdf = IronPdf.PdfDocument.FromFile(pdfFile);
        string text = pdf.ExtractAllText();
        System.IO.File.WriteAllText($"extracted_{pdfFile}.txt", text);
    }
    catch (Exception ex)
    {
        Console.WriteLine($"Error processing {pdfFile}: {ex.Message}");
    }
});
Parallel.ForEach(pdfFiles, Sub(pdfFile)Try Dim pdf = IronPdf.PdfDocument.FromFile(pdfFile) Dim text AsString = pdf.ExtractAllText()System.IO.File.WriteAllText($"extracted_{pdfFile}.txt", text)Catch ex AsExceptionConsole.WriteLine($"Error processing {pdfFile}: {ex.Message}")EndTryEnd Sub)
Parallel.ForEach(pdfFiles, Sub(pdfFile)
	Try
		Dim pdf = IronPdf.PdfDocument.FromFile(pdfFile)
		Dim text As String = pdf.ExtractAllText()
		System.IO.File.WriteAllText($"extracted_{pdfFile}.txt", text)
	Catch ex As Exception
		Console.WriteLine($"Error processing {pdfFile}: {ex.Message}")
	End Try
End Sub)
Cas d'utilisation pratiques avec des exemples de code complets
Extraction de texte de plusieurs PDFs simultanément
Un autre cas d'utilisation du traitement parallèle est l'extraction de texte d'un lot de PDFs. En traitant plusieurs fichiers PDF, effectuer l'extraction de texte simultanément peut permettre de gagner beaucoup de temps. L'exemple suivant démontre comment cela peut être fait.
Exemple : Extraction de texte en parallèle de plusieurs documents
using IronPdf;using System.Linq;using System.Threading.Tasks;class Program{ static voidMain(string[] args) { string[] pdfFiles = { "doc1.pdf", "doc2.pdf", "doc3.pdf" };Parallel.ForEach(pdfFiles, pdfFile => { var pdf = IronPdf.PdfDocument.FromFile(pdfFile); string text = pdf.ExtractText();System.IO.File.WriteAllText($"extracted_{pdfFile}.txt", text); }); }}
using IronPdf;
using System.Linq;
using System.Threading.Tasks;

class Program
{
    static void Main(string[] args)
    {
        string[] pdfFiles = { "doc1.pdf", "doc2.pdf", "doc3.pdf" };
        Parallel.ForEach(pdfFiles, pdfFile =>
        {
            var pdf = IronPdf.PdfDocument.FromFile(pdfFile);
            string text = pdf.ExtractText();
            System.IO.File.WriteAllText($"extracted_{pdfFile}.txt", text);
        });
    }
}
ImportsIronPdfImportsSystem.LinqImportsSystem.Threading.TasksFriend Class ProgramShared Sub Main(ByVal args() AsString) Dim pdfFiles() AsString = { "doc1.pdf", "doc2.pdf", "doc3.pdf" }Parallel.ForEach(pdfFiles, Sub(pdfFile) Dim pdf = IronPdf.PdfDocument.FromFile(pdfFile) Dim text AsString = pdf.ExtractText()System.IO.File.WriteAllText($"extracted_{pdfFile}.txt", text) End Sub) End SubEnd Class
Imports IronPdf
Imports System.Linq
Imports System.Threading.Tasks

Friend Class Program
	Shared Sub Main(ByVal args() As String)
		Dim pdfFiles() As String = { "doc1.pdf", "doc2.pdf", "doc3.pdf" }
		Parallel.ForEach(pdfFiles, Sub(pdfFile)
			Dim pdf = IronPdf.PdfDocument.FromFile(pdfFile)
			Dim text As String = pdf.ExtractText()
			System.IO.File.WriteAllText($"extracted_{pdfFile}.txt", text)
		End Sub)
	End Sub
End Class
Documents de sortie
Dans ce code, chaque fichier PDF est traité en parallèle pour extraire le texte, et le texte extrait est sauvegardé dans des fichiers texte séparés.
Exemple : Génération de PDFs en lot à partir de fichiers HTML en parallèle
Dans cet exemple, nous allons générer plusieurs PDFs à partir d'une liste de fichiers HTML en parallèle, ce qui peut être un scénario typique lorsque vous devez convertir plusieurs pages HTML dynamiques en documents PDF.
Code
using IronPdf;using System;using System.Threading.Tasks;class Program{ static voidMain(string[] args) { string[] htmlFiles = { "example.html", "example_1.html", "example_2.html" };Parallel.ForEach(htmlFiles, htmlFile => { try { // Load the HTML content into IronPDF and convert it to PDF ChromePdfRenderer renderer = new ChromePdfRenderer(); PdfDocument pdf = renderer.RenderHtmlFileAsPdf(htmlFile); // Save the generated PDF to the output folder pdf.SaveAs($"output_{htmlFile}.pdf");Console.WriteLine($"PDF created for {htmlFile}"); } catch (Exception ex) {Console.WriteLine($"Error processing {htmlFile}: {ex.Message}"); } }); }}
using IronPdf;
using System;
using System.Threading.Tasks;

class Program
{
    static void Main(string[] args)
    {
        string[] htmlFiles = { "example.html", "example_1.html", "example_2.html" };
        Parallel.ForEach(htmlFiles, htmlFile =>
        {
            try
            {
                // Load the HTML content into IronPDF and convert it to PDF
                ChromePdfRenderer renderer = new ChromePdfRenderer();
                PdfDocument pdf = renderer.RenderHtmlFileAsPdf(htmlFile);
                // Save the generated PDF to the output folder
                pdf.SaveAs($"output_{htmlFile}.pdf");
                Console.WriteLine($"PDF created for {htmlFile}");
            }
            catch (Exception ex)
            {
                Console.WriteLine($"Error processing {htmlFile}: {ex.Message}");
            }
        });
    }
}
ImportsIronPdfImportsSystemImportsSystem.Threading.TasksFriend Class ProgramShared Sub Main(ByVal args() AsString) Dim htmlFiles() AsString = { "example.html", "example_1.html", "example_2.html" }Parallel.ForEach(htmlFiles, Sub(htmlFile)Try ' Load the HTML content into IronPDF and convert it to PDF Dim renderer As New ChromePdfRenderer() Dim pdf AsPdfDocument = renderer.RenderHtmlFileAsPdf(htmlFile) ' Save the generated PDF to the output folder pdf.SaveAs($"output_{htmlFile}.pdf")Console.WriteLine($"PDF created for {htmlFile}")Catch ex AsExceptionConsole.WriteLine($"Error processing {htmlFile}: {ex.Message}")EndTry End Sub) End SubEnd Class
Imports IronPdf
Imports System
Imports System.Threading.Tasks

Friend Class Program
	Shared Sub Main(ByVal args() As String)
		Dim htmlFiles() As String = { "example.html", "example_1.html", "example_2.html" }
		Parallel.ForEach(htmlFiles, Sub(htmlFile)
			Try
				' Load the HTML content into IronPDF and convert it to PDF
				Dim renderer As New ChromePdfRenderer()
				Dim pdf As PdfDocument = renderer.RenderHtmlFileAsPdf(htmlFile)
				' Save the generated PDF to the output folder
				pdf.SaveAs($"output_{htmlFile}.pdf")
				Console.WriteLine($"PDF created for {htmlFile}")
			Catch ex As Exception
				Console.WriteLine($"Error processing {htmlFile}: {ex.Message}")
			End Try
		End Sub)
	End Sub
End Class
Sortie console
PDF en sortie
Explication
Fichiers HTML : Le tableau htmlFiles contient les chemins vers plusieurs fichiers HTML que vous souhaitez convertir en PDF.
Traitement parallèle :
Parallel.ForEach(htmlFiles, htmlFile => {...}) traite chaque fichier HTML simultanément, ce qui accélère l'opération lorsqu'il s'agit de plusieurs fichiers.
Pour chaque fichier dans le tableau htmlFiles, le code le convertit en PDF en utilisant renderer.RenderHtmlFileAsPdf(htmlFile);.
Enregistrer le PDF : Après avoir généré le PDF, il est enregistré en utilisant la méthode pdf.SaveAs, en ajoutant le nom de fichier de sortie au nom du fichier HTML d'origine.
Gestion des erreurs : Si une erreur se produit (par ex., le fichier HTML n'existe pas ou il y a un problème lors de la conversion), elle est capturée par le bloc try-catch, et un message d'erreur est affiché pour le fichier spécifique.
Astuces de performance et meilleures pratiques
Éviter les problèmes de sécurité des threads avec IronPDF
IronPDF est thread-safe pour la plupart des opérations. Cependant, certaines opérations comme l'écriture dans le même fichier en parallèle peuvent causer des problèmes. Assurez-vous toujours que chaque tâche parallèle opère sur un fichier ou une ressource de sortie distincts.
Optimiser le traitement parallèle pour les grandes ensembles de données
Pour optimiser les performances, envisagez de contrôler le degré de parallélisme. Pour les grands ensembles de données, vous voudrez peut-être limiter le nombre de threads simultanés pour éviter la surcharge du système.
var options = new ExecutionDataflowBlockOptions{MaxDegreeOfParallelism = 4};
var options = new ExecutionDataflowBlockOptions
{
    MaxDegreeOfParallelism = 4
};
Dim options = New ExecutionDataflowBlockOptionsWith {.MaxDegreeOfParallelism = 4}
Dim options = New ExecutionDataflowBlockOptions With {.MaxDegreeOfParallelism = 4}
Gestion de la mémoire dans les opérations PDF parallèles
Lors du traitement d'un grand nombre de PDFs, faites attention à l'utilisation de la mémoire. Essayez de libérer les ressources comme les objets PdfDocument dès qu'ils ne sont plus nécessaires.
Utilisation des méthodes d'extension
Une méthode d'extension est un type spécial de méthode statique qui vous permet d'ajouter de nouvelles fonctionnalités à un type existant sans modifier son code source. Cela peut être utile lorsque vous travaillez avec des bibliothèques comme IronPDF, où vous pourriez vouloir ajouter des méthodes de traitement personnalisées ou étendre ses fonctionnalités pour rendre le travail avec des PDFs plus pratique, en particulier dans les scénarios de traitement parallèle.
Les avantages de l'utilisation des méthodes d'extension dans le traitement parallèle
En utilisant des méthodes d'extension, vous pouvez créer un code concis et réutilisable qui simplifie la logique dans les boucles parallèles. Cette approche ne réduit pas seulement la duplication mais vous aide aussi à maintenir une base de code propre, surtout lorsque vous traitez des flux de travail PDF complexes et du parallélisme des données.
Conclusion
L'utilisation de boucles parallèles comme Parallel.ForEach avec IronPDF offre des gains de performance significatifs lors du traitement de grands volumes de PDF. Que vous convertissiez du HTML en PDFs, extrayiez du texte, ou manipuliez des documents, le parallélisme des données permet une exécution plus rapide en exécutant les tâches simultanément. L'approche parallèle garantit que les opérations peuvent être exécutées sur plusieurs processeurs, ce qui réduit le temps d'exécution global et améliore les performances pour les tâches de traitement en lots.
Bien que le traitement parallèle accélère les tâches, soyez conscient de la sécurité des threads et de la gestion des ressources. IronPDF est thread-safe pour la plupart des opérations, mais il est important de gérer les conflits potentiels lors de l'accès aux ressources partagées. Considérez la gestion des erreurs et de la mémoire pour assurer la stabilité, surtout à mesure que votre application évolue.
Si vous êtes prêt à plonger plus profondément dans IronPDF et explorer des fonctionnalités avancées, la documentation officielle offre des informations détaillées. De plus, vous pouvez profiter d'une licence d'essai, vous permettant de tester la bibliothèque dans vos propres projets avant de vous engager à un achat.
Jacob Mellor est directeur de la technologie chez Iron Software et un ingénieur visionnaire pionnier de la technologie C# PDF. En tant que développeur à l'origine de la base de code centrale d'Iron Software, il a façonné l'architecture des produits de l'entreprise depuis sa création, la transformant aux côtés du PDG Cameron Rimington en une entreprise de plus de 50 personnes au service de la NASA, de Tesla et d'agences gouvernementales mondiales.