



Mis à jour 21 avril 2026
Comment convertir TIFF en PDF en Java
Ce guide complet vous guidera à travers les étapes pour convertir une image TIFF en PDF sans effort en Java en utilisant IronPDF.
Lire la suite

Ce tutoriel vous montrera comment utiliser IronPDF for Java pour extraire des données d'un fichier PDF. La configuration de l'environnement, l'importation de la bibliothèque, la lecture du fichier d'entrée et l'extraction des données nécessaires sont toutes expliquées avec des exemples de code.
IronPDF est une bibliothèque logicielle qui permet aux développeurs de générer, modifier et extraire des données de fichiers PDF avec IronPDF for Java dans leurs applications Java. Il vous permet de créer des PDFs à partir de documents HTML, d'images et bien plus, ainsi que de fusionner plusieurs PDFs, diviser des fichiers PDF et manipuler des PDFs existants. IronPDF offre également la possibilité de sécuriser des PDFs avec des fonctionnalités de protection par mot de passe et d'ajouter des signatures numériques aux PDFs, entre autres fonctionnalités.
IronPDF for Java est développé et maintenu par Iron Software. L'une de ses fonctions les mieux notées est d'extraire du texte et des données de fichiers PDF ainsi que de HTML et d'URL.
Pour utiliser IronPDF pour extraire des données de fichiers PDF, vous devez répondre aux prérequis suivants :
L'installation d'IronPDF for Java est simple et facile, à condition que toutes les exigences soient remplies. Ce guide utilisera IntelliJ IDEA de JetBrains pour démontrer l'installation et exécuter un code d'exemple.
Voici ce qu'il faut faire :
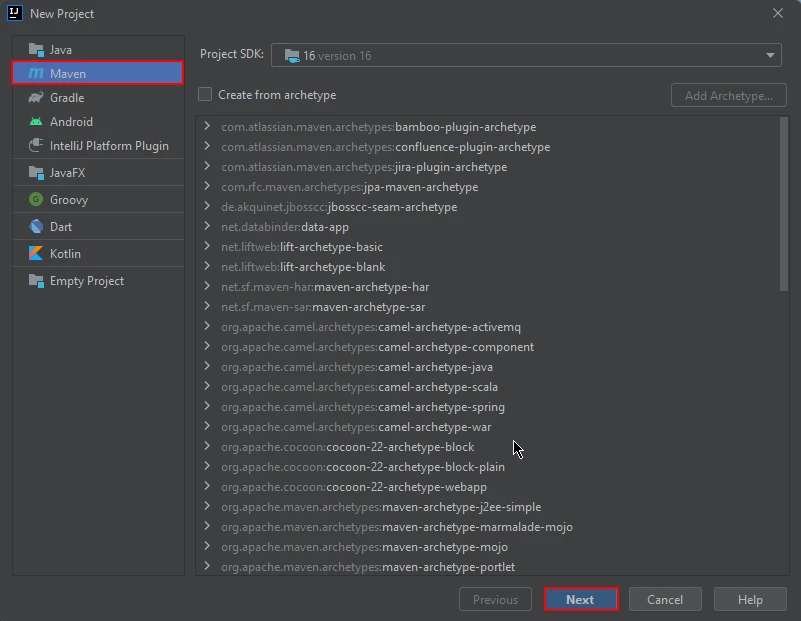 Nouveau projet Maven dans IntelliJ
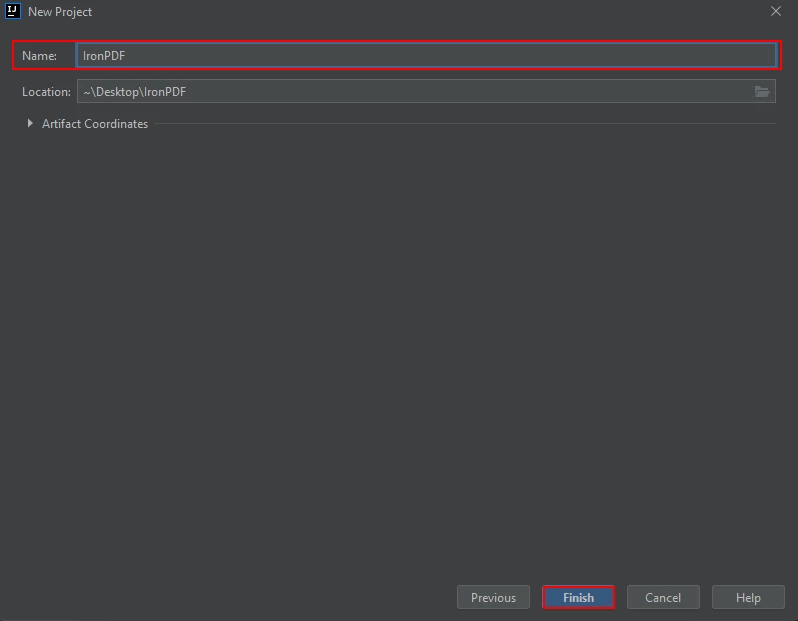 Nommez le projet Maven et cliquez sur Terminer
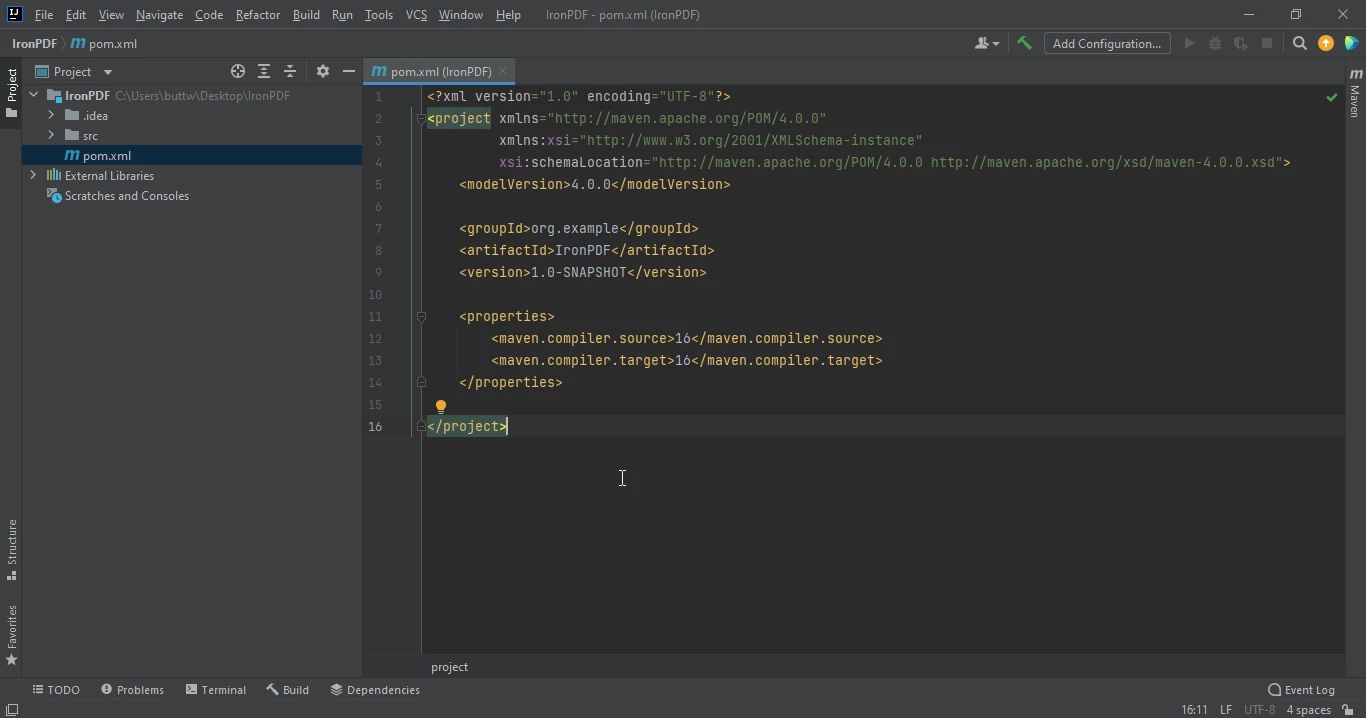 Le fichier pom.xml
Ajoutez les dépendances suivantes dans le fichier pom.xml ou vous pouvez télécharger le fichier JAR depuis la page de la bibliothèque IronPDF sur Sonatype Central.
<dependency>
    <groupId>com.ironsoftware</groupId>
    <artifactId>ironpdf</artifactId>
    <version>1.0.0</version> <!-- replace with the latest version -->
</dependency>Une fois que vous avez placé les dépendances dans le fichier pom.xml, une petite icône apparaîtra dans le coin supérieur droit du fichier.
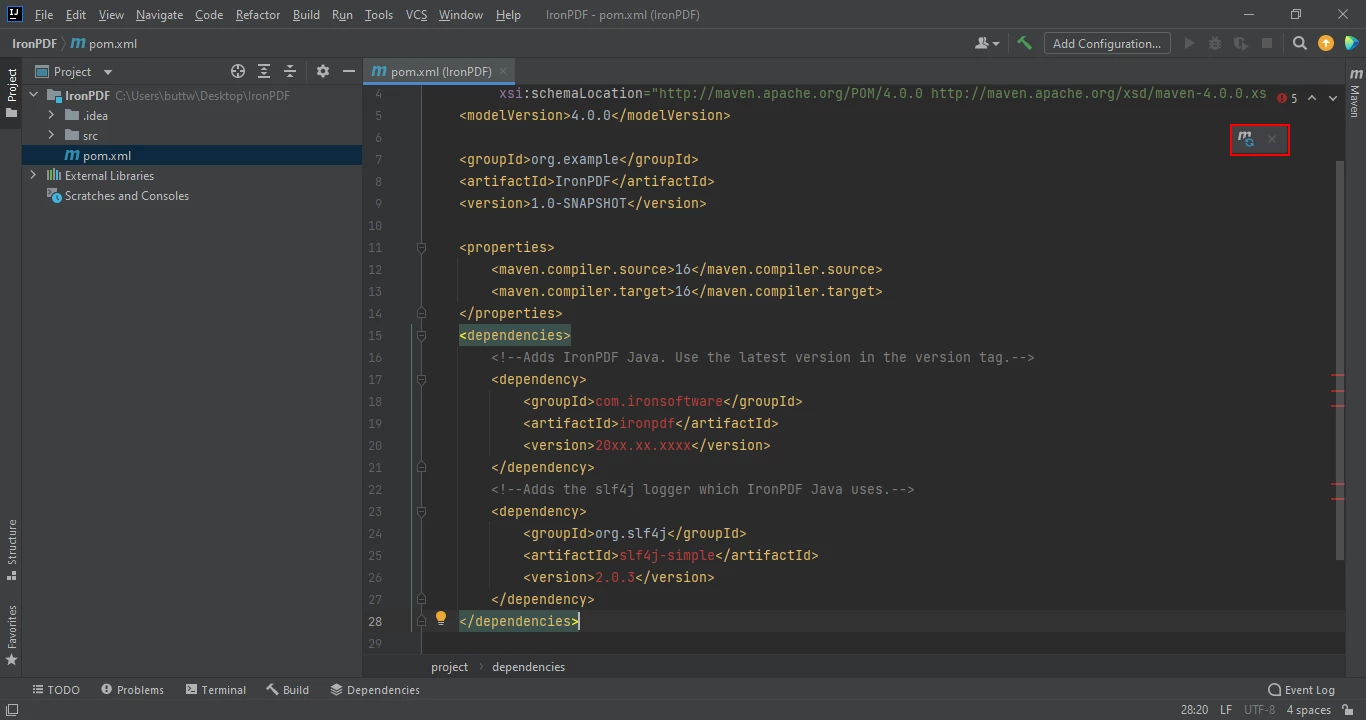 Cliquez sur l'icône flottante pour installer automatiquement les dépendances Maven
Installez les dépendances Maven d'IronPDF for Java en cliquant sur ce bouton. En fonction de la vitesse de votre connexion Internet, cela ne devrait prendre que quelques minutes.
IronPDF est une bibliothèque Java pour créer, modifier et extraire des données de documents PDF. Elle fournit une API simple pour extraire du texte de fichiers PDF, d'URL et de tableaux.
En utilisant IronPDF for Java, vous pouvez facilement extraire des données de texte des documents PDF. Ci-dessous se trouve le code d'exemple pour extraire des données d'un fichier PDF.
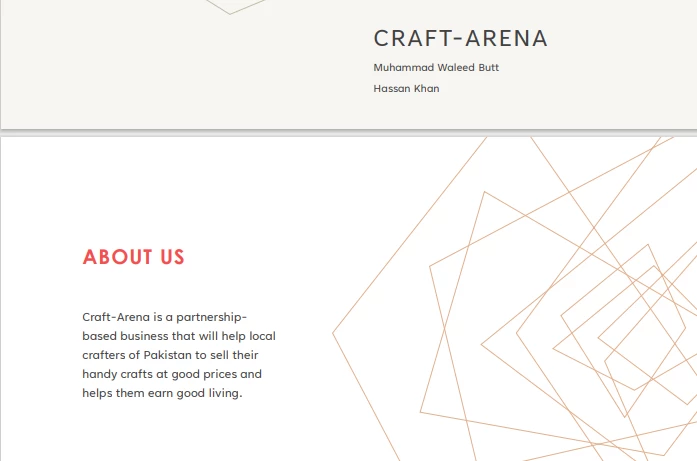 Entrée PDF
// Import the necessary IronPDF package for working with PDF documents
import com.ironsoftware.ironpdf.PdfDocument;

import java.io.IOException;
import java.nio.file.Paths;

public class Main {
    public static void main(String[] args) throws IOException {
        // Load the PDF document from the specified file
        PdfDocument pdf = PdfDocument.fromFile(Paths.get("business plan.pdf"));

        // Extract all text from the PDF document
        String text = pdf.extractAllText();

        // Print the extracted text to the console
        System.out.println("Text extracted from the PDF: " + text);
    }
}Le code source produit la sortie donnée ci-dessous :
> Text extracted from the PDF:
>
> CRAFT-ARENA
>
> Muhammad Waleed Butt
>
> Hassan Khan
>
> ABOUT US
>
> Craft-Arena is a partnership based business that will help local crafters of Pakistan to sell their handicrafts at good prices and helps them earn a good living.IronPDF for Java convertit l'URL en PDF à l'exécution et en extrait le texte. Cet exemple montrera le code source pour extraire du texte d'URL.
// Import the necessary IronPDF package for working with PDF documents
import com.ironsoftware.ironpdf.PdfDocument;

import java.io.IOException;

public class Main {
    public static void main(String[] args) throws IOException {
        // Convert a URL to a PDF and load it into a PdfDocument
        PdfDocument pdf = PdfDocument.renderUrlAsPdf("https://ironpdf.com/java/");

        // Extract all text from the PDF document
        String text = pdf.extractAllText();

        // Print the extracted text to the console
        System.out.println("Text extracted from the URLs: " + text);
    }
}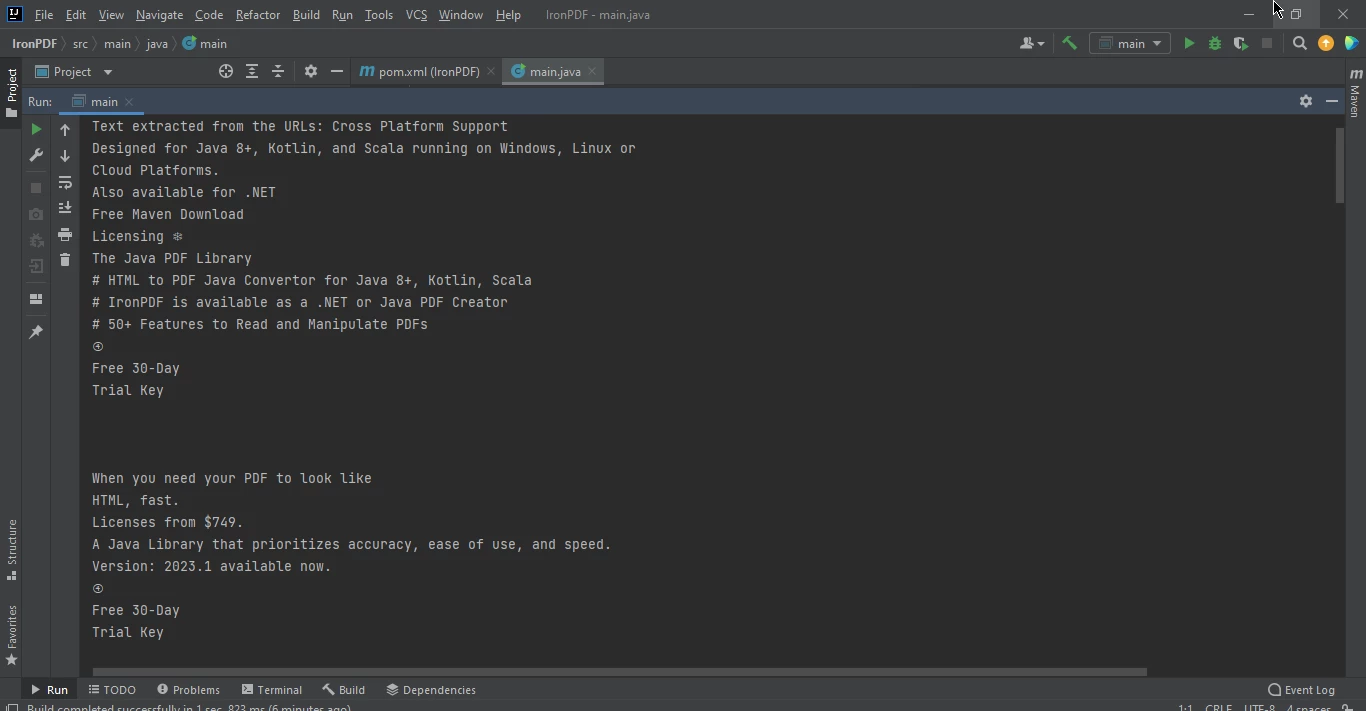 Données de page web extraites
Pour extraire des données de tableaux d'un PDF avec IronPDF for Java est très simple ; il suffit d'avoir un PDF contenant un tableau et d'exécuter le code ci-dessous.
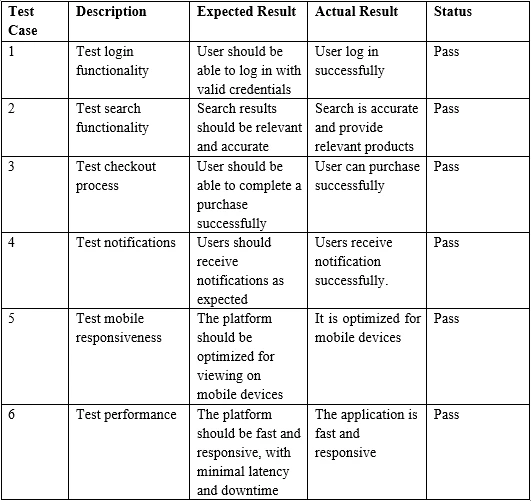 Exemple d'entrée tableau PDF
// Import the necessary IronPDF package for working with PDF documents
import com.ironsoftware.ironpdf.PdfDocument;

import java.io.IOException;
import java.nio.file.Paths;

public class Main {
    public static void main(String[] args) throws IOException {
        // Load the PDF document from the specified file
        PdfDocument pdf = PdfDocument.fromFile(Paths.get("table.pdf"));

        // Extract all text from the PDF document, including table data
        String text = pdf.extractAllText();

        // Print the extracted table data to the console
        System.out.print("Text extracted from the Marked tables: " + text);
    }
}> Test Case Description Expected Result Actual Result Status
>
> 1 Test login functionality User should be able to log in with valid credentials
>
> User log in successfully Pass
>
> 2 Test search functionality Search results should be relevant and accurate
>
> Search is accurate and provide relevant products Pass
>
> 3 Test checkout process User should be able to complete a purchase successfully
>
> User can purchase successfully PassEn conclusion, ce tutoriel a démontré comment extraire des données, spécifiquement des données tabulaires, d'un fichier PDF avec IronPDF for Java.
Pour plus d'informations, veuillez consulter l'exemple d'extraction de texte d'un PDF sur le site IronPDF.
IronPDF est une bibliothèque avec des détails de licence commerciale, commençant à $999. Cependant, vous pouvez l'évaluer en production avec un essai gratuit en utilisant la licence d'essai d'IronPDF.

Curtis Chau détient un baccalauréat en informatique (Université de Carleton) et se spécialise dans le développement front-end avec expertise en Node.js, TypeScript, JavaScript et React. Passionné par la création d'interfaces utilisateur intuitives et esthétiquement plaisantes, Curtis aime travailler avec des frameworks modernes et créer des manuels bien structurés et visuellement attrayants.


IronPDF fait partie de IRONSUITE
10 API .NET pour vos documents


Lorsque vous avez besoin que votre PDF ressemble à HTML, rapidement.

