



已更新 2026年4月21日
如何在 Java 中将 TIFF 转换为 PDF
本完整指南将引导您在 Java 中使用 IronPDF 无缝地将 TIFF 图像转换为 PDF。
阅读更多

在Java中读取PDF文档可以是任何项目的重要组成部分,从商业应用到数据分析。 使用IronPDF库,将PDF处理功能集成到您的Java项目中比以往更加容易。
fromFile 方法加载现有 PDF 文档extractAllText 方法从打开的 PDF 中读取文本IronPDF 适用于 Java PDF库概述是软件开发人员需要快速从HTML生成高质量捕获准备好的PDF的完美解决方案。 该库还提供强大的文档操作工具,能够动态控制IronPDF中的页面布局和格式、内容和格式。
让我们看看如何使用IronPDF库在Java程序中读取位于路径中的PDF文件。
第一步是使用Maven安装IronPDF; 可以在IronPDF安装指南中找到更多详细信息。
以下是在Maven项目中安装IronPDF的步骤:
在您首选的IDE中打开您的Maven项目。
在dependencies部分添加IronPDF库依赖。
<!-- Add this dependency to your pom.xml -->
<dependency>
    <groupId>com.ironsoftware</groupId>
    <artifactId>ironpdf</artifactId>
    <version>Your_IronPDF_Version_Here</version>
</dependency>保存pom.xml文件,让Maven下载并安装IronPDF库。
一旦安装完成,您应该能够在项目中导入并使用IronPDF的类。
这里是您可以使用的代码,无论是否有表格边界,都可以使用IronPDF库来读取文件。
import com.ironsoftware.ironpdf.PdfDocument;
import java.io.IOException;
import java.nio.file.Paths;

/**
 * This class demonstrates how to read text from a PDF document using the IronPDF library.
 */
public class PdfReader {
    public static void main(String[] args) {
        try {
            // Load the PDF document from the specified file path
            PdfDocument pdf = PdfDocument.fromFile(Paths.get("C:\\sample.pdf"));

            // Extract all text content from the loaded PDF document
            String text = pdf.extractAllText();

            // Print the extracted text to the console
            System.out.println(text);
        } catch (IOException e) {
            // Handle exceptions that may occur during file loading or reading.
            e.printStackTrace();
        }
    }
}在此程序中,使用IronPDF中的PdfDocument对象。 然后在该对象上调用String。 提取的文本将打印到控制台。 程序包含错误处理,使用try-catch块来管理潜在的IOException。
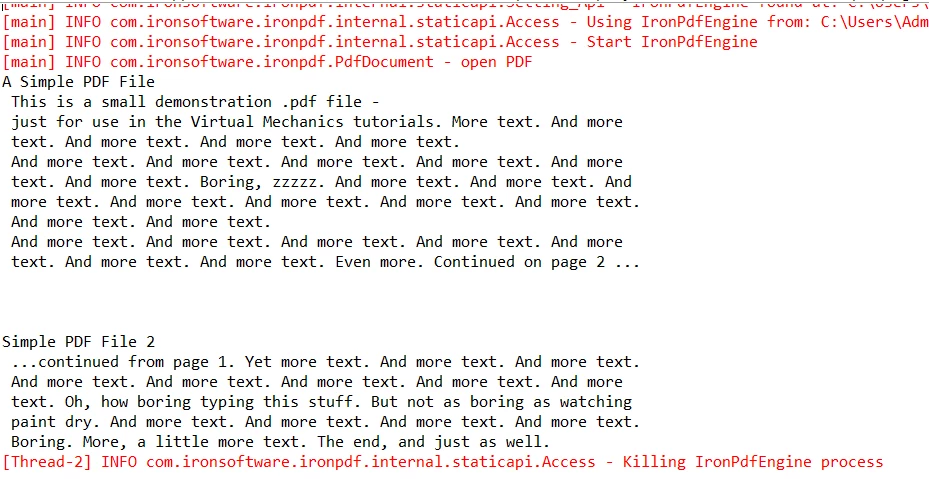 程序输出
IronPDF是一个在Java中同一路径或多条不同路径中读取PDF文件的绝佳解决方案,因为它提供了高性能和许多使PDF开发变得简单的功能。 其语法简单明了且用户友好。 其API允许开发人员快速设计他们需要的项目代码。
探索IronPDF许可选项计划起价仅为$999,使预算有限的人也可使用。 总体而言,IronPDF为任何希望在其应用程序中处理PDF的Java开发人员提供了绝佳的选择。

Curtis Chau 拥有卡尔顿大学的计算机科学学士学位,专注于前端开发,精通 Node.js、TypeScript、JavaScript 和 React。他热衷于打造直观且美观的用户界面,喜欢使用现代框架并创建结构良好、视觉吸引力强的手册。

当您需要PDF看起来像HTML时,速度快。





