



已更新 2026年4月21日
Python 中的 Scrapy(开发人员如何使用)
介绍 Scrapy,一个 Python 中的网络抓取框架,以及 IronPDF,这两个强大的库共同优化在线数据的提取和动态 PDF 的创建。
阅读更多

本文将演示如何使用Python和一个名为IronPDF 适用于 Python的PDF库来添加或移除PDF页面。
IronPDF是市场领先的PDF Python库,它为开发人员提供了在其应用程序中轻松生成、操作和处理PDF文档的能力。 通过IronPDF,开发人员可以将PDF功能无缝集成到他们的Python项目中,无论是用于创建动态报告、生成发票还是将网页内容转换为PDF文件。 这个库提供了一种用户友好且高效的方式来处理与PDF相关的任务,使您能够轻松创建和操作PDF。
无论您是构建Web应用程序、桌面软件还是自动化文档工作流程,IronPDF都是一款有价值的工具,可以让您在Python环境中处理PDF,使其成为任何开发人员工具包中的重要补充。 本介绍指南将探讨IronPDF for Python的主要功能与能力。 使用IronPDF,开发人员可以将多个PDF文件合并成一个文档,从特定页面提取文本,添加水印,以及执行删除页面、去除空白页、旋转页面、添加页面和读取PDF文件等其他操作。
要安装IronPDF,只需打开PyCharm或任何其他Python编译器,创建一个新的Python项目或打开一个现有的项目。 一旦项目创建或打开,打开终端。
IronPDF 适用于 Python可以通过终端命令轻松安装。 只需在终端中运行以下命令,IronPDF即可在一分钟内安装完成。
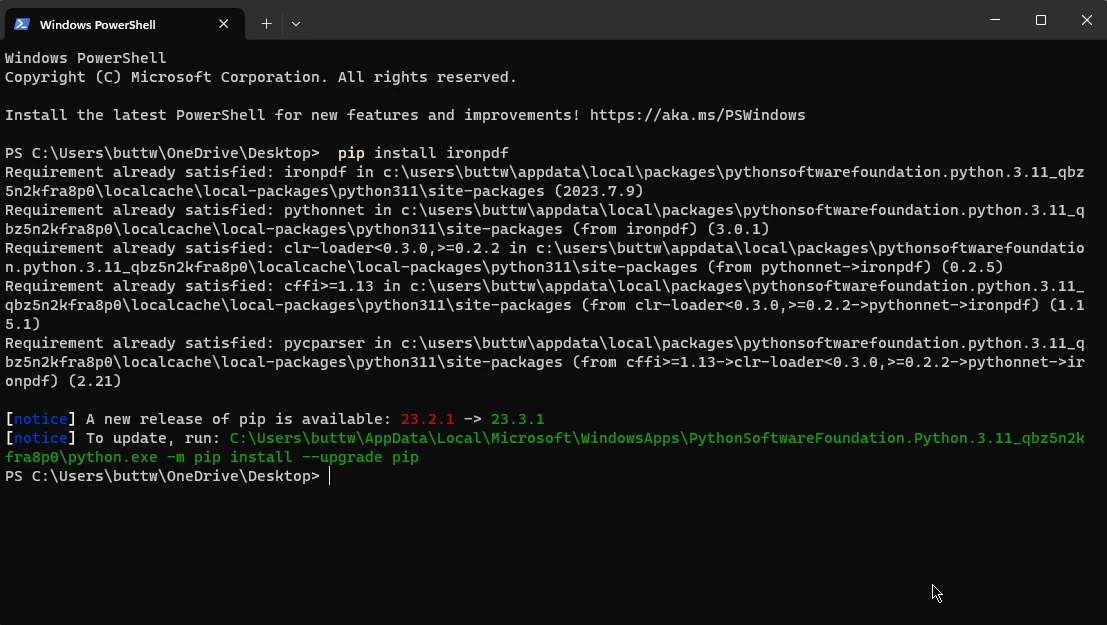 安装IronPDF包
安装完成后,您就可以开始进行代码操作了。
在向PDF文档中添加和删除PDF页面之前,我们先使用HTML到PDF转换创建一个4页的简单PDF文件。 以下代码创建PDF文件,以用作即将到来的代码示例中的输入PDF文档。
from ironpdf import *

# HTML content to be converted to PDF
html = """
<p> Hello Iron</p>
<p> This is 1st Page </p>
<div style='page-break-after: always;'></div>
<p> This is 2nd Page</p>
<div style='page-break-after: always;'></div>
<p> This is 3rd Page</p>
<div style='page-break-after: always;'></div>
<p> This is 4th Page</p>
"""

# Initialize the renderer
renderer = ChromePdfRenderer()

# Render the HTML as a PDF document
pdf = renderer.RenderHtmlAsPdf(html)

# Save the PDF to a file
pdf.SaveAs("Page1And4.pdf")此Python代码使用IronPDF库从HTML内容创建一个PDF文档。 HTML内容被定义为一个字符串,包含段落和表示分页符的"page-break-after" div标签。 它的结构是为了有四页。 然后代码使用ChromePdfRenderer将此HTML转换为PDF文档。 最后,将生成的PDF保存为"Page1And4.pdf"。
本质上,这段代码生成了一个多页的PDF,其中每一页对应于HTML中的两个连续"page-break" div标签之间的内容,并将此HTML内容保存到一个PDF文件中。
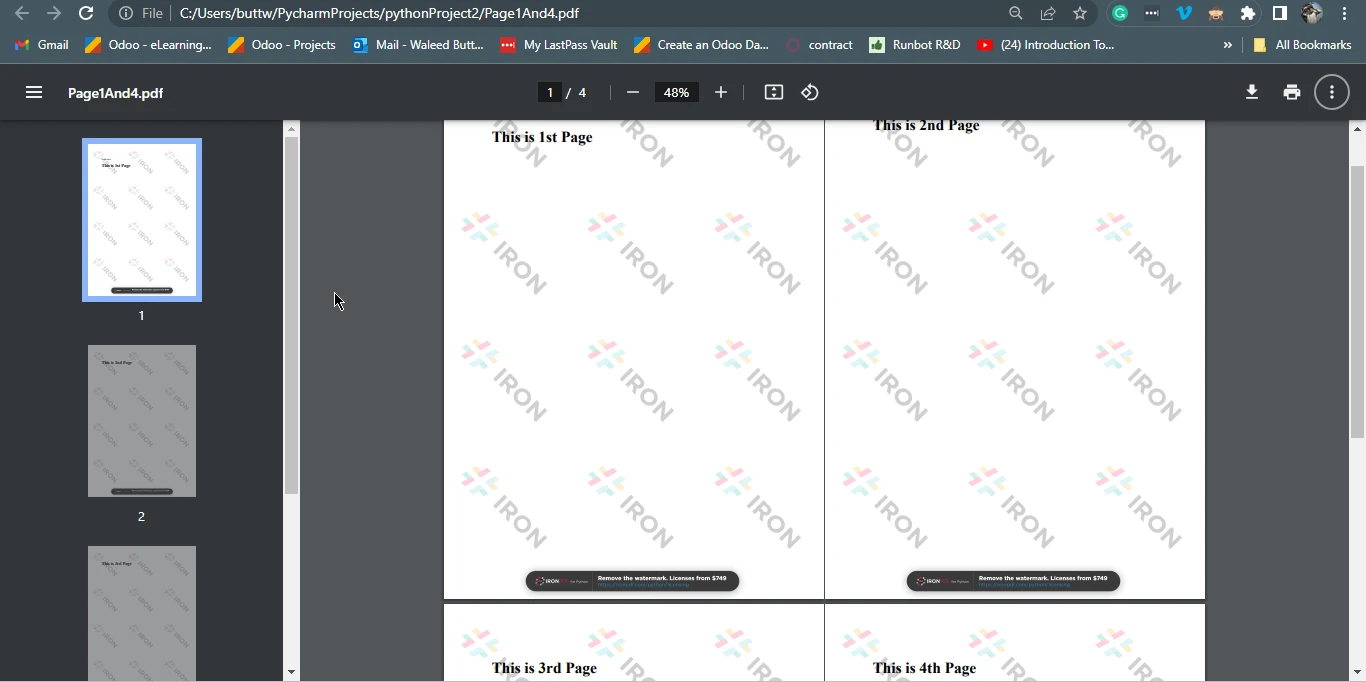 Page1And4.pdf
本节将从之前创建的PDF中删除页面。 以下代码将从PDF文件中删除一个页面。
from ironpdf import *

# Load the existing PDF document
pdf = PdfDocument.FromFile("Page1And4.pdf")

# Remove the page at index 1 (second page)
pdf.RemovePage(1)

# Save the modified PDF to a new file
pdf.SaveAs("removed.pdf")上述代码利用IronPDF库操作PDF文档。 它首先导入必要的组件,然后通过FromFile()方法加载一个名为"Page1And4.pdf"的现有PDF文档。 接着,它从PDF删除索引为'1'的页面,然后调用removed.pdf的新PDF文件。 本质上,这段代码完成了从原始PDF文档中删除第二页并将结果文档保存为单独文件的任务。
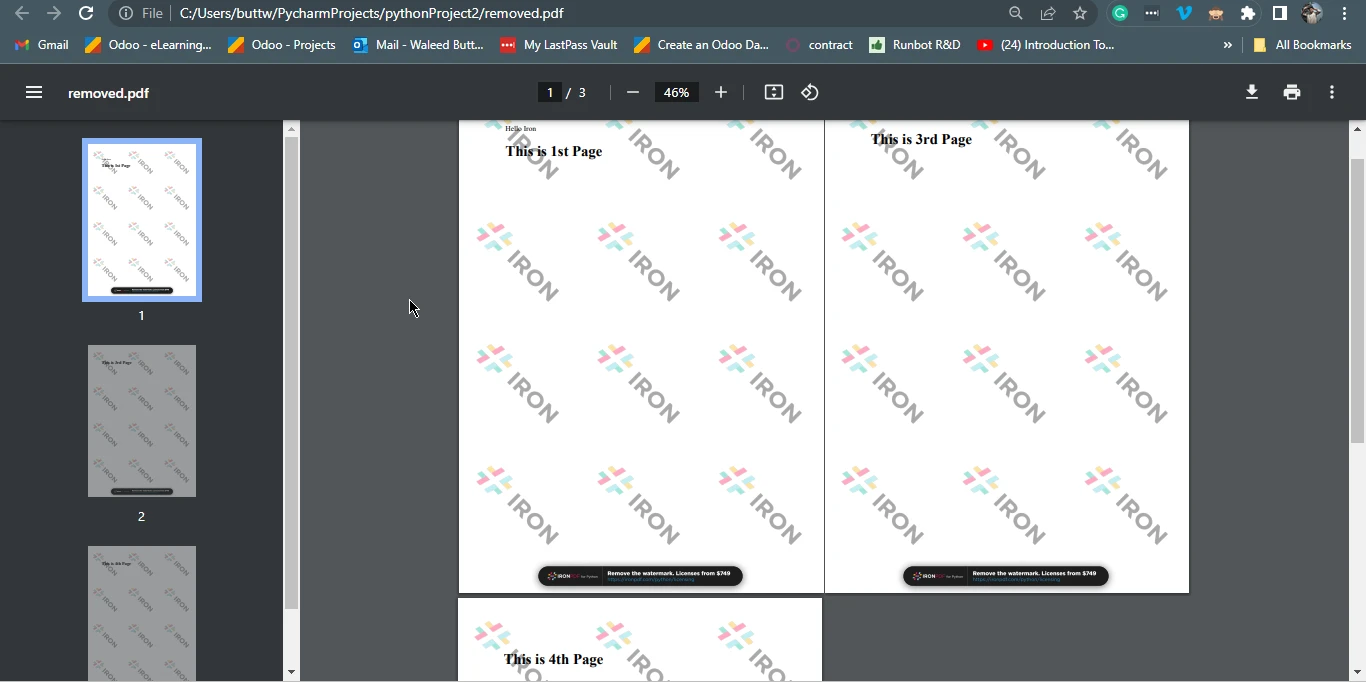 输出文件
本节将讨论如何在现有的PDF文件中添加新页面。 为此,让我们创建一个新的PDF文件,然后使用页面编号通过简单的几行代码将新创建的PDF添加到之前创建的PDF文件中。
以下是将新PDF页面添加到原始文档中的示例代码。
from ironpdf import *

# HTML content to represent a new page
pdf_page = """
<h1> Cover Page</h1>
"""

# Initialize the renderer and render the new PDF page
renderer = ChromePdfRenderer()
pdfdoc_a = renderer.RenderHtmlAsPdf(pdf_page)

# Load the existing PDF file
pdf = PdfDocument.FromFile("removed.pdf")

# Prepend the new page to the beginning of the existing PDF
pdf.PrependPdf(pdfdoc_a)

# Save the combined PDF to a new file
pdf.SaveAs("addPage.pdf")此Python代码片段利用IronPDF库来操控PDF文档。 首先,它定义了一个表示封面带有标题的HTML内容片段。 然后,它使用pdfdoc_a。
然后使用PdfDocument.FromFile("removed.pdf")加载一个现有的PDF文档,"removed.pdf"。 代码接着使用pdfdoc_a的内容添加到这个现有PDF文档中。 本质上,这段代码将封面PDF与"removed.pdf"结合,创建一个名为"addPage.pdf"的新PDF文档,有效地在原始PDF的开头添加封面。
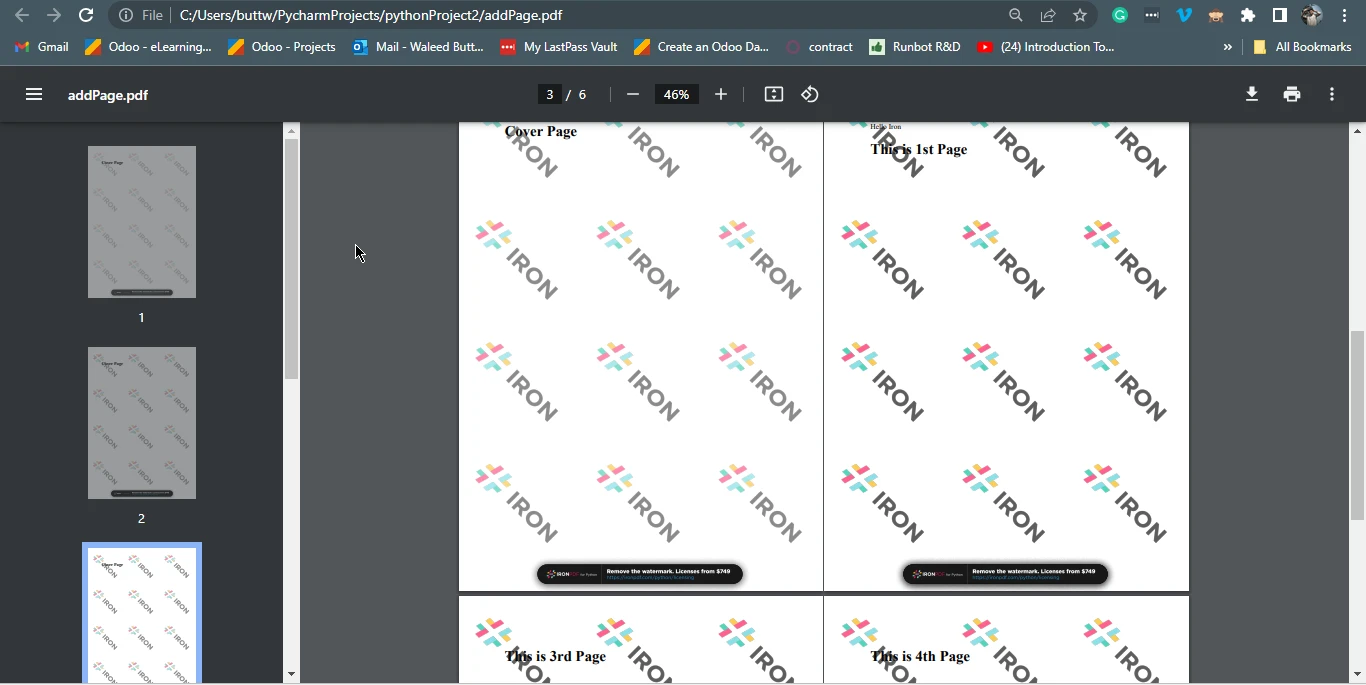 输出文件
本文探讨了使用Python进行PDF操作的世界,重点是IronPDF库。 能够从PDF文档中添加或删除页面是当今数字环境中的一项有价值的技能,而Python则为实现这些任务提供了一种易于访问且强大的方式。 本文涵盖了安装IronPDF的基本步骤,并提供了代码示例以说明创建,删除和添加PDF页面的过程。
通过IronPDF,Python开发人员可以高效处理PDF文档,无论是用于生成报告、定制内容还是改进文档工作流程。 随着数字世界继续依赖PDF用于各种目的,掌握这些技术使开发人员能够满足各种需求,使Python和IronPDF成为进行PDF操作的动态组合。
删除PDF页面的代码示例可以在以下示例代码中找到。 添加PDF页面的代码示例可以在另一Python代码示例中找到。 此外,如果您对HTML到PDF转换的工作原理感到好奇,请访问此教程页面。
探索IronPDF 适用于 Python库的多样化功能,并选择免费试用来体验转变。

Curtis Chau 拥有卡尔顿大学的计算机科学学士学位,专注于前端开发,精通 Node.js、TypeScript、JavaScript 和 React。他热衷于打造直观且美观的用户界面,喜欢使用现代框架并创建结构良好、视觉吸引力强的手册。



当您需要PDF看起来像HTML时,速度快。



