
在Python中将HTML转换为PDF

IronPDF为Python开发者提供了一条从HTML标记到生产就绪的PDF文件的直接路径。 没有中间设计工具,没有专有布局引擎,没有单独的渲染管道。库的ChromePdfRenderer类在后台使用Chromium引擎,因此任何在Chrome中正确显示的HTML都将准确转换为PDF。 本教程详细介绍了每种支持的转换方法(HTML字符串、本地HTML文件和实时URL),然后介绍了控制页面大小、边距、页眉、页脚等内容的渲染选项。
如果您需要C#或VB.NET的工作流程,可以查看在.NET应用中将HTML转换为PDF的伴随教程。
快速入门:在Python中将HTML转为PDF最小工作流程(5 个步骤)
- 通过pip安装IronPDF for Python
- 使用
from ironpdf import *导入库 - 实例化
ChromePdfRenderer - 调用
RenderHtmlAsPdf、RenderUrlAsPdf或RenderHtmlFileAsPdf - 使用
pdf.SaveAs("output.pdf")保存结果
目录
- 如何安装IronPDF for Python?
- 在转换之前如何配置IronPDF?
- 如何将HTML字符串转换为PDF?
- 如何将URL转换为PDF?
- 如何将HTML文件转换为PDF?
- 如何控制PDF渲染选项?
- 如何添加自定义页眉和页脚?
- 下一步是什么?
入门
如何安装Python上的IronPDF?
IronPDF通过pip分发,这是Python的标准包管理器。 在终端中运行以下命令以安装最新版本:
要固定特定版本(在CI管道或容器化环境中很有用),请附加版本号:
IronPDF首次初始化时,会下载兼容的Chromium二进制文件。 在新机器上下载稍需片刻,但每个环境仅发生一次。 随后的运行启动速度快得多,因为二进制文件被本地缓存。
操作指南和代码示例
您如何在转换之前配置IronPDF?
在首次转换调用之前,有两个设置任务值得完成:设置许可证密钥,以及可选地配置日志文件路径。
导入包
每个使用IronPDF的Python文件都需要这一行导入。将其放在文件顶部:
from ironpdf import *所有 IronPDF 类(ChromePdfRenderer、PdfDocument、License、Logger 及其他)均可通过此通配符导入获得。
设置许可证密钥
没有许可证密钥,IronPDF会在每个生成的PDF上添加平铺水印。 水印适合开发和测试,但生产部署需要有效密钥。
生成的PDF如果没有许可证密钥,将包含平铺水印。访问许可页面获取密钥。
在任何其他IronPDF调用之前设置密钥:
from ironpdf import *

# Set the license key before any PDF operations
License.LicenseKey = "IRONPDF-MYLICENSE-KEY-1EF01"开始免费试用以获取临时密钥,或购买许可证以便无限制的生产使用。
配置日志输出
IronPDF将诊断输出写入脚本工作目录下名为Default.log的文件中。 要将日志重定向到不同的路径或捕获更多用于调试的细节,请在首次转换之前设置Logger属性:
from ironpdf import *

# Configure logging before running any conversions
Logger.EnableDebugging = True
Logger.LogFilePath = "ironpdf-debug.log"
Logger.LoggingMode = Logger.LoggingModes.AllLogger.LogFilePath 必须在第一次 PDF 转换调用之前设置。 随后进行的更改对当前会话无效。详细日志在诊断特定HTML页面未按预期渲染时最有用; 它们捕获网络请求、CSS加载事件和JavaScript执行时间。
如何将HTML字符串转换为PDF?
转换内存中的HTML字符串是最直接的方法,当HTML由程序生成时效果很好,例如从Jinja2模板或数据库驱动报告生成。
基本HTML字符串转换
实例化 ChromePdfRenderer,将 HTML 字符串传递给 RenderHtmlAsPdf,并在返回的 PdfDocument 上调用 SaveAs:
from ironpdf import *

renderer = ChromePdfRenderer()

# Convert an HTML string to a PDF document
pdf = renderer.RenderHtmlAsPdf("<h1>Hello from IronPDF!</h1><p>Generated in Python.</p>")

pdf.SaveAs("hello.pdf")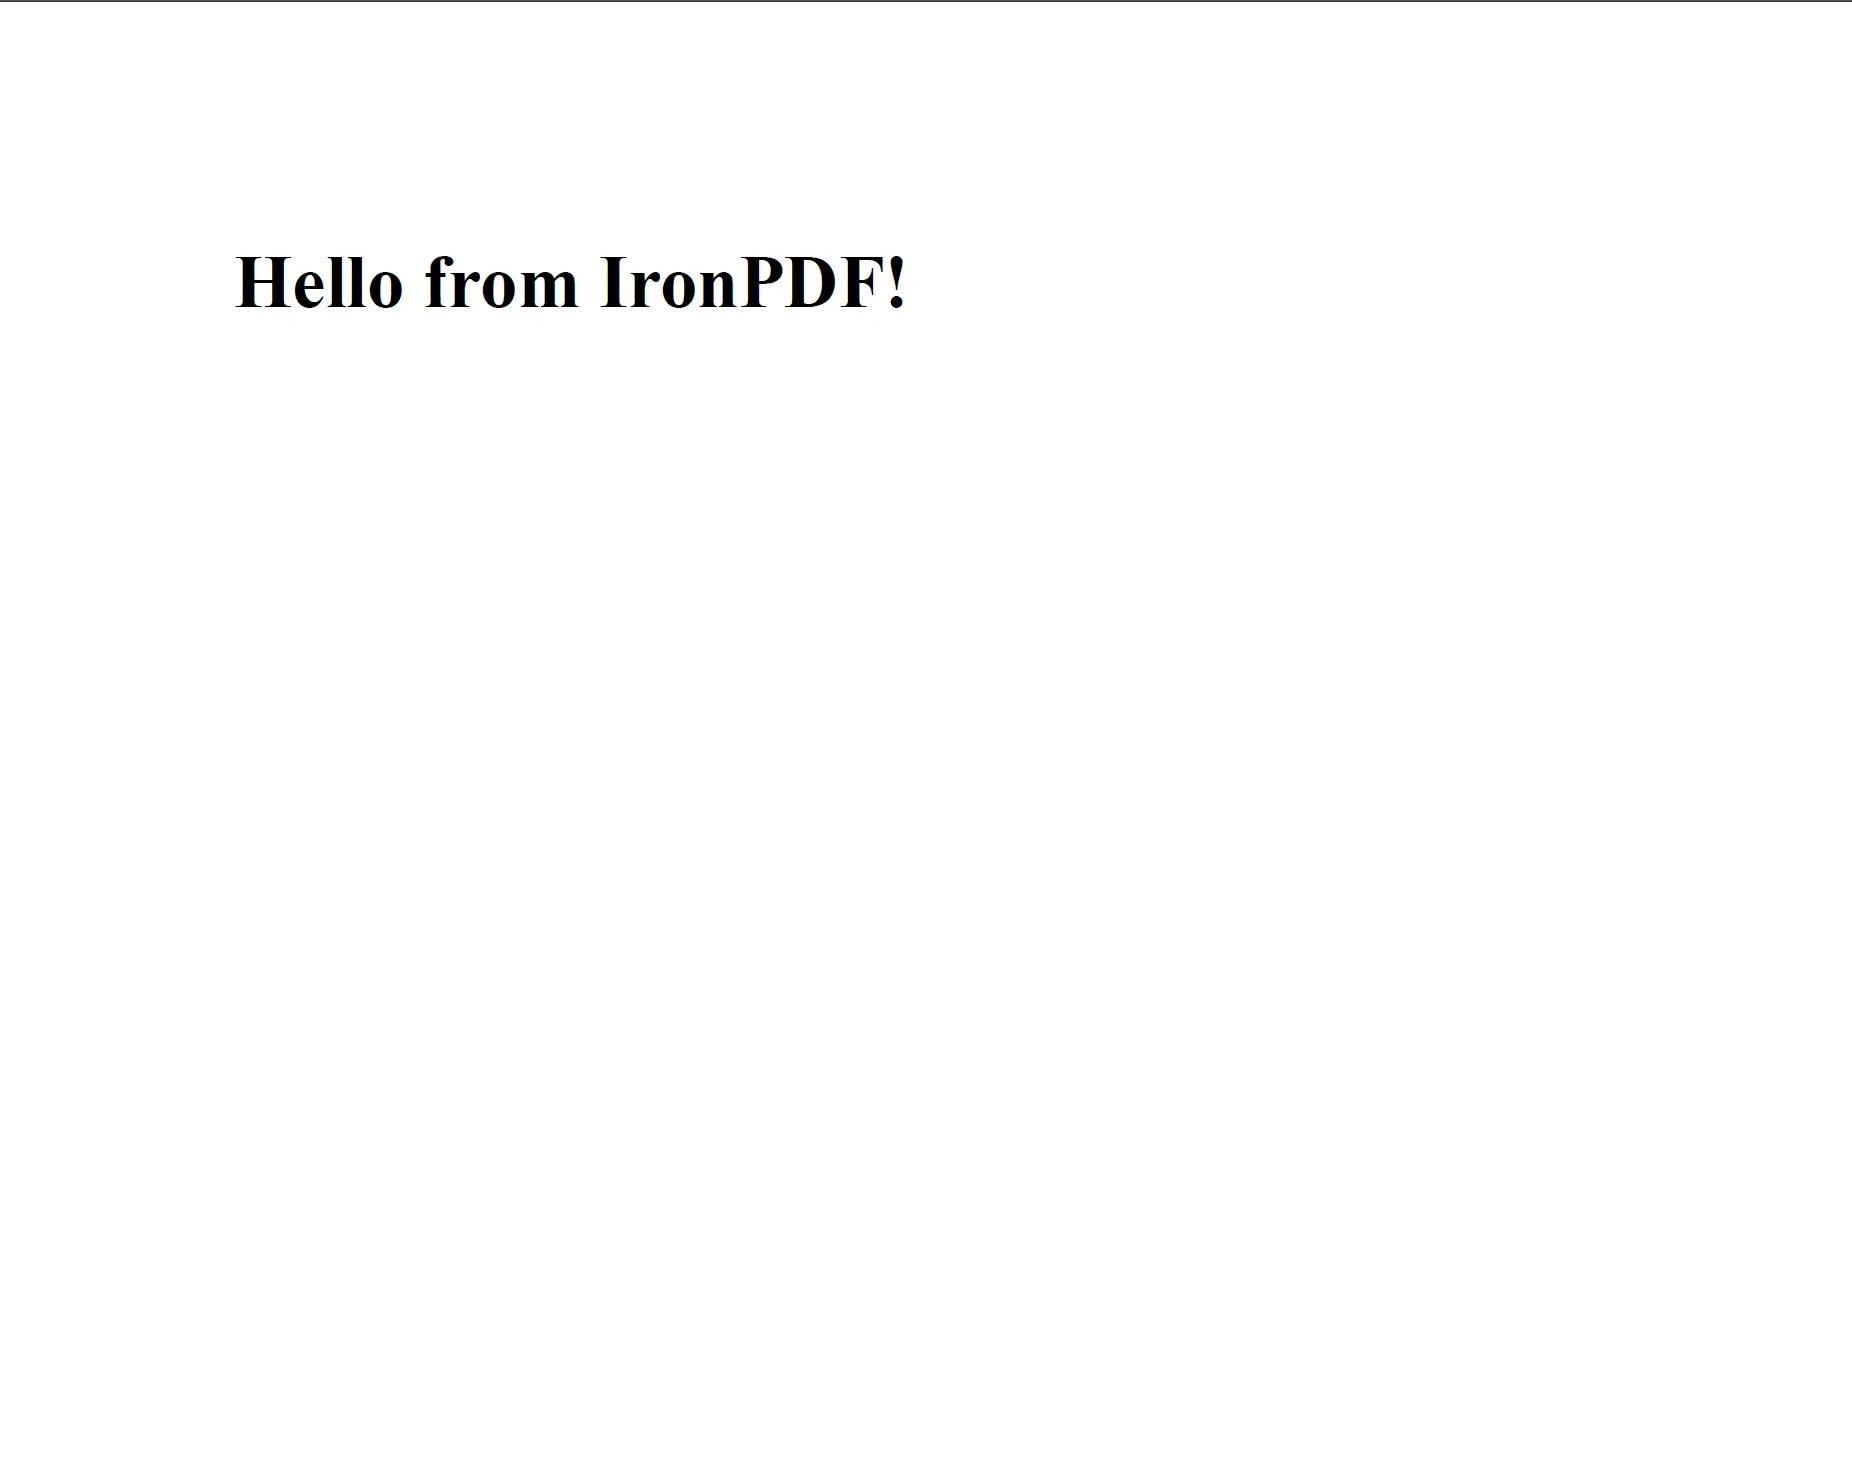
RenderHtmlAsPdf精确处理HTML,就像Chrome会做的,包括CSS和JavaScript。
ChromePdfRenderer以现代浏览器的方式处理HTML、CSS和JavaScript。 在Chrome中正确渲染的任何内容将生成准确的PDF。
具有外部资产的HTML字符串
当HTML字符串引用本地资源(样式表、图像、脚本)时,将目录路径作为第二个参数传递给RenderHtmlAsPdf。 IronPDF将此路径用作基础URL,以解析相对引用:
from ironpdf import *

html_content = """
<html>
  <head>
    <title>Styled Report</title>
    <link rel='stylesheet' href='assets/style.css'>
  </head>
  <body>
    <h1>Monthly Report</h1>
    <img src='assets/logo.png' alt='Company logo'>
    <p>Data as of Q1 2024.</p>
  </body>
</html>
"""

renderer = ChromePdfRenderer()

# The second argument sets the base path for resolving relative asset URLs
pdf = renderer.RenderHtmlAsPdf(html_content, "./")

pdf.SaveAs("styled-report.pdf")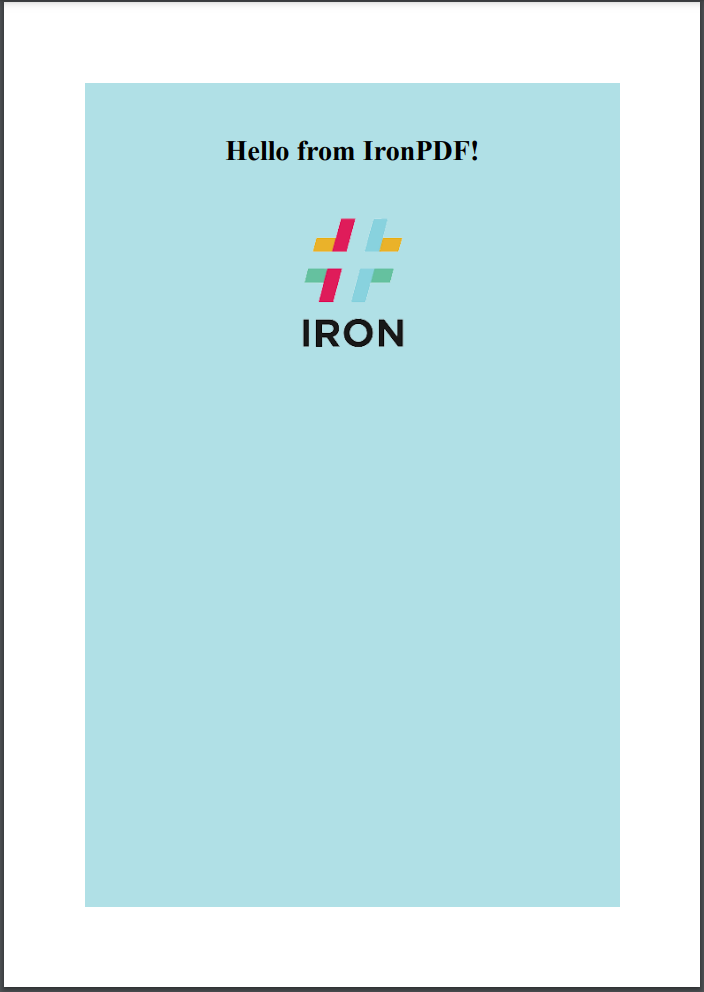
当您提供基路径给RenderHtmlAsPdf时,外部CSS和图像正确加载。
基路径可以指向任何本地目录或网络共享。 子目录中的资产相对于它解析。 有关更复杂HTML字符串的更多模式,请参见HTML字符串到PDF代码示例。
如何将URL转换为PDF?
RenderUrlAsPdf方法获取实时URL,等待页面完全加载(包括任何JavaScript驱动的内容),并将渲染结果转换为PDF。 这使其适用于捕捉仪表板、报告或任何视觉状态取决于JavaScript执行的页面。
from ironpdf import *

renderer = ChromePdfRenderer()

# Fetch and convert a live web page to PDF
pdf = renderer.RenderUrlAsPdf("https://en.wikipedia.org/wiki/Portable_Document_Format")

pdf.SaveAs("wikipedia-pdf.pdf")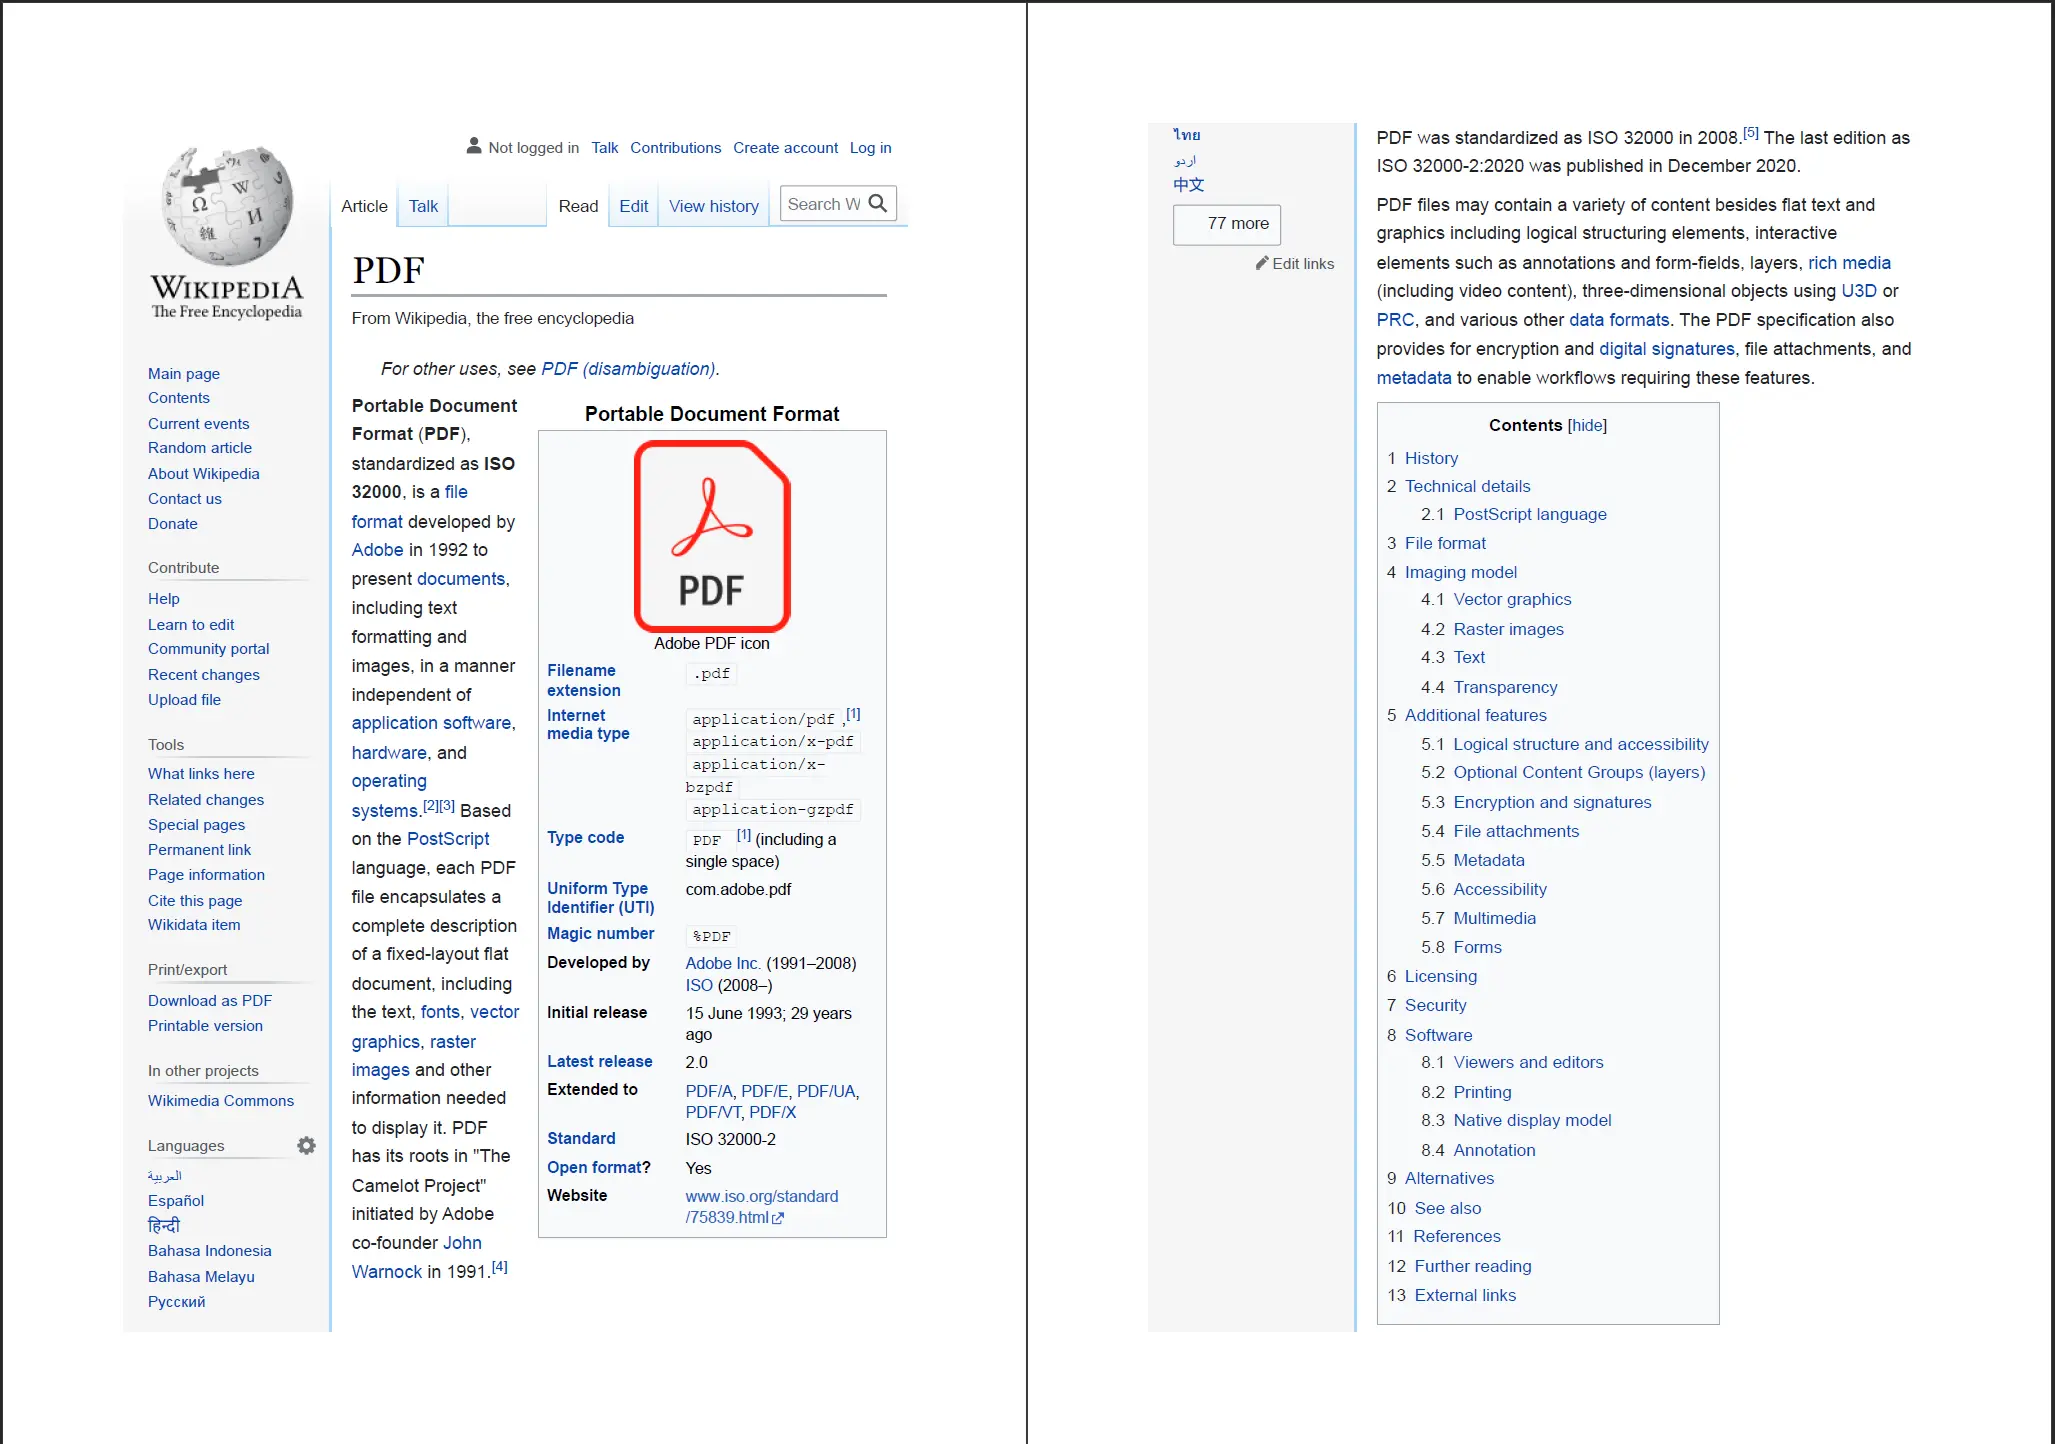
IronPDF在生成PDF之前获取实时URL并渲染整个页面(包括JavaScript)。
RenderUrlAsPdf 之前,在 ChromePdfRenderer 实例上设置 cookies 或 HTTP 请求头。 有关详细信息,请参见HTTP登录凭据指南。当目标页面加载异步内容时,IronPDF会等待Chromium渲染引擎发出文档完全绘制的信号。 对于含有大量 JavaScript 或延迟网络请求的页面,请考虑调整 WaitFor 属性在 ChromePdfRenderOptions 上(在下面的渲染选项部分中涵盖)。 URL到PDF代码示例显示了其他配置模式。
您如何将HTML文件转换为PDF?
RenderHtmlFileAsPdf接受本地HTML文件的路径并直接转换。 HTML中的相对路径(到CSS文件、图像或JavaScript)将自动相对于HTML文件的目录解决,因此不需要基路径参数。
from ironpdf import *

renderer = ChromePdfRenderer()

# Convert a local HTML file (and its linked CSS/JS) to PDF
pdf = renderer.RenderHtmlFileAsPdf("invoices/TestInvoice1.html")

pdf.SaveAs("invoice.pdf")这种方法特别适用于服务器端文档生成,其中HTML模板已经写入磁盘,这是使用Django或Flask渲染Jinja2模板到文件再转换为PDF供下载时的常见模式。
IronPDF 相对于 HTML 文件位置解析任何 <link>、<script> 和 <img> 标签,因此链接的样式表、嵌入的字体和图像在 PDF 中的显示与浏览器中完全相同。 此过程与RenderHtmlAsPdf处理内联资产的方式类似,不同之处在于无需提供显式基路径。
您如何控制PDF渲染选项?
ChromePdfRenderOptions 是传递给 ChromePdfRenderer 的配置对象(或直接传递给任何渲染方法)以控制页面布局、边距、纸张大小和其他输出特性。 在转换之前设置选项是定制PDF输出的标准方式。
纸张尺寸和方向
from ironpdf import *

renderer = ChromePdfRenderer()

# Configure page layout before rendering
renderer.RenderingOptions.PaperSize = PdfPaperSize.A4
renderer.RenderingOptions.PaperOrientation = PdfPaperOrientation.Landscape
renderer.RenderingOptions.MarginTop = 20
renderer.RenderingOptions.MarginBottom = 20
renderer.RenderingOptions.MarginLeft = 15
renderer.RenderingOptions.MarginRight = 15

pdf = renderer.RenderHtmlAsPdf("<h1>Landscape Report</h1><p>Content here.</p>")
pdf.SaveAs("landscape-a4.pdf")边距以毫米表示。 PdfPaperSize 支持所有标准 ISO 尺寸(A0 到 A10、信纸、法律纸、报纸纸)以及 Custom 用于由 CustomPaperWidth 和 CustomPaperHeight 定义的任意尺寸。
自定义纸张尺寸
当标准纸张尺寸不符合输出要求时(例如收据或标签打印机格式),请明确定义宽度和高度:
from ironpdf import *

renderer = ChromePdfRenderer()

# Set a custom paper size (in millimetres)
renderer.RenderingOptions.PaperSize = PdfPaperSize.Custom
renderer.RenderingOptions.CustomPaperWidth = 80   # 80 mm receipt roll width
renderer.RenderingOptions.CustomPaperHeight = 200

pdf = renderer.RenderHtmlAsPdf("<h2>Receipt</h2><p>Total: $12.50</p>")
pdf.SaveAs("receipt.pdf")启用JavaScript执行
默认情况下,IronPDF在渲染期间执行JavaScript。 如果页面依赖JavaScript生成可见内容(图表、数据表、动态表单值),这种行为意味着渲染的PDF反映了最终的DOM状态。 要在不必要的页面上禁用JavaScript:
from ironpdf import *

renderer = ChromePdfRenderer()

# Disable JavaScript for static HTML pages
renderer.RenderingOptions.EnableJavaScript = False

pdf = renderer.RenderHtmlAsPdf("<p>Static content only.</p>")
pdf.SaveAs("static.pdf")禁用JavaScript可减少简单、静态HTML文档的渲染时间。
有关更多渲染配置详细信息,请参见PDF生成设置和自定义纸张尺寸示例。
如何添加自定义页眉和页脚?
IronPDF 中的页眉和页脚通过附加到渲染器的 RenderingOptions 的 HtmlHeaderFooter 或 TextHeaderFooter 对象应用。 HtmlHeaderFooter为您提供完整的HTML和CSS控制,适用于带有徽标的品牌化信头。 TextHeaderFooter更简单,涵盖了大多数基于文本的要求,包括动态页码。
基于文本的页眉和页脚
from ironpdf import *

renderer = ChromePdfRenderer()

# Add a text header with the document title
renderer.RenderingOptions.TextHeader = TextHeaderFooter()
renderer.RenderingOptions.TextHeader.CenterText = "Quarterly Report — Q1 2024"
renderer.RenderingOptions.TextHeader.DrawDividerLine = True
renderer.RenderingOptions.TextHeader.FontSize = 10

# Add a footer with page numbers
renderer.RenderingOptions.TextFooter = TextHeaderFooter()
renderer.RenderingOptions.TextFooter.RightText = "Page {page} of {total-pages}"
renderer.RenderingOptions.TextFooter.FontSize = 9
renderer.RenderingOptions.TextFooter.DrawDividerLine = True

html = "<h1>Executive Summary</h1><p>Revenue increased 12% year-over-year.</p>"
pdf = renderer.RenderHtmlAsPdf(html)
pdf.SaveAs("report-with-footer.pdf"){page} 和 {total-pages} 占位符在渲染时被替换为正确的值。 其他可用的占位符包括 {date}、{time} 和 {url}。
带有徽标的HTML页眉
当需要品牌化页眉时(公司徽标、色带或格式化的地址块),请改用HtmlHeaderFooter:
from ironpdf import *

renderer = ChromePdfRenderer()

header_html = """
<div style="font-family: Arial, sans-serif; border-bottom: 2px solid #003366; padding: 8px 0;">
  <img src='assets/logo.png' style='height: 40px; float: left;' alt='Company logo'>
  <span style='float: right; font-size: 11px; color: #666;'>Confidential</span>
  <div style='clear:both;'></div>
</div>
"""

renderer.RenderingOptions.HtmlHeader = HtmlHeaderFooter()
renderer.RenderingOptions.HtmlHeader.HtmlFragment = header_html
renderer.RenderingOptions.HtmlHeader.BaseUrl = "./"

html_body = "<h1>Project Status Update</h1><p>All milestones on track.</p>"
pdf = renderer.RenderHtmlAsPdf(html_body, "./")
pdf.SaveAs("branded-report.pdf")HtmlHeaderFooter 上设置 BaseUrl 为与文档主体相同的基本路径。 这可确保页眉HTML中引用的图像和样式表正确解决。页眉和页脚出现在生成的PDF的每一页上,包括多页文档。 有关带有页脚页面级元数据的工作示例,请参见HTML 页眉和页脚代码示例。
页眉和页脚的边距调整
添加页眉或页脚时,请增加相应的边距以防内容与页面主体重叠:
from ironpdf import *

renderer = ChromePdfRenderer()

renderer.RenderingOptions.MarginTop = 30     # Make room for header
renderer.RenderingOptions.MarginBottom = 20  # Make room for footer

renderer.RenderingOptions.TextHeader = TextHeaderFooter()
renderer.RenderingOptions.TextHeader.CenterText = "Internal Use Only"

renderer.RenderingOptions.TextFooter = TextHeaderFooter()
renderer.RenderingOptions.TextFooter.CenterText = "Page {page} of {total-pages}"

pdf = renderer.RenderHtmlAsPdf("<h1>Internal Document</h1><p>Body content.</p>")
pdf.SaveAs("margined-report.pdf")对于布局关键的文档,将边距调整与PaperSize设置相结合,以完全匹配打印规格。 更多布局控制(如IronSoftwareSystemDrawingColor背景填充和CSS @page规则)详见自定义边距示例。
下一步是什么?
本教程涵盖了三个核心HTML到PDF的转换方法及其输出控制的渲染选项。 以下指南是在此基础上构建的,并涵盖更专业的任务:
- PDF 生成设置:深入探讨
ChromePdfRenderOptions:DPI、背景渲染、CSS 媒体类型、JavaScript 等待策略,以及打印模式与屏幕模式。 - HTML页眉和页脚:带有徽标、页码、日期和多列布局的品牌页眉和页脚模板。
- 自定义边距和纸张尺寸:微调页面几何以实现打印就绪输出和非标准格式。
- 为PDF添加水印:将文本或图像水印加盖到现有或新生成的PDF上。
- 从PDF中提取文本:以编程方式读取生成的或现有PDF的文本内容。
开始免费30天试用在评估期间生成无限制的无水印PDF。 准备生产时,请查看团队和企业部署的许可选项。
常见问题
IronPDF在Python中的用途是什么?
IronPDF为Python开发者提供了一种直接将HTML标记转换为生产就绪的PDF文件的简便方法。利用基于Chromium的引擎,确保HTML到PDF的准确转换。
如何在Python中使用IronPDF将HTML字符串转换为PDF?
要将HTML字符串转换为PDF,您需要使用ChromePdfRenderer类。调用RenderHtmlAsPdf函数并传入HTML字符串,然后使用SaveAs方法保存文档。
如何使用IronPDF将URL转换为PDF?
使用ChromePdfRenderer类中的RenderUrlAsPdf方法。此方法获取实时URL,等待页面完全加载,并将渲染的页面转换为PDF文档。
在将HTML转换为PDF时如何处理外部资源?
当转换引用本地资源的HTML时,在RenderHtmlAsPdf方法中使用第二个参数提供基路径。这有助于IronPDF正确解析资源路径。
如何配置IronPDF中的PDF渲染选项?
使用ChromePdfRenderOptions配置PDF渲染选项。您可以设置页面布局、边距、纸张大小以及启用或禁用JavaScript执行的参数。
在Python中开始IronPDF转换之前需要什么?
在开始转换之前,重要的是设置一个许可证密钥以避免水印,并使用IronPDF配置任何必要的日志输出设置。
如何为IronPDF生成的PDF添加自定义页眉和页脚?
IronPDF允许您通过HtmlHeaderFooter或TextHeaderFooter对象添加页眉和页脚。这些可以包括文本、图像、页码等。
IronPDF中自定义纸张尺寸的应用场景有哪些?
自定义纸张尺寸对于不支持标准尺寸的格式非常有用,如热敏打印机收据或运输标签。
IronPDF 能否在 PDF 转换过程中执行 JavaScript?
是的,IronPDF可以在渲染过程中执行JavaScript,以确保任何由JavaScript生成的动态内容都包含在最终的PDF中。
如何在Python中开始使用IronPDF?
您可以使用pip安装IronPDF,配置必要的选项如许可证密钥或日志记录,然后利用诸如RenderHtmlAsPdf之类的功能将HTML转换为PDF。

Curtis Chau 拥有卡尔顿大学的计算机科学学士学位,专注于前端开发,精通 Node.js、TypeScript、JavaScript 和 React。他热衷于打造直观且美观的用户界面,喜欢使用现代框架并创建结构良好、视觉吸引力强的手册。

