En muchas industrias, los archivos PDF son el formato de referencia para compartir documentos estructurados como informes, facturas y tablas de datos. Sin embargo, extraer datos de PDFs, especialmente cuando se trata de tablas, puede ser un desafío debido a la naturaleza del formato PDF. A diferencia de los formatos de datos estructurados, los PDFs están diseñados principalmente para la presentación, no para la extracción de datos.
Sin embargo, con IronPDF, una poderosa biblioteca C# PDF .NET, puedes extraer fácilmente datos estructurados como tablas directamente de PDFs y procesarlos en tus aplicaciones .NET. Este artículo te guiará paso a paso sobre cómo extraer datos tabulares de archivos PDF usando IronPDF.
Las tablas son una forma práctica de estructurar y mostrar tus datos, ya sea realizando la gestión de inventarios, entrada de datos, registrando datos como la lluvia, etc. Por lo tanto, puede haber muchas razones para necesitar extraer tablas y datos de tablas de documentos PDF. Algunos de los casos de uso más comunes incluyen:
- Automatización de entrada de datos: Extraer datos de tablas en informes o facturas PDF puede automatizar procesos como completar bases de datos o hojas de cálculo.
- Análisis de datos: Las empresas a menudo reciben informes estructurados en formato PDF. Extraer tablas te permite analizar estos datos de manera programática.
- Conversión de documentos: Extraer datos tabulares en formatos más accesibles como Excel o CSV permite una manipulación, almacenamiento y compartición más fácil.
- Auditoría y cumplimiento: Para registros legales o financieros, extraer datos tabulares de documentos PDF de manera programática puede ayudar a automatizar auditorías y asegurar el cumplimiento.
¿Cómo funcionan las tablas PDF?
El formato de archivo PDF no ofrece ninguna capacidad nativa para almacenar datos en formatos estructurados como tablas. La tabla que usamos en el ejemplo de hoy fue creada en HTML, antes de convertirse al formato PDF. Las tablas se muestran como texto y líneas, por lo que extraer datos de tablas a menudo requiere cierto análisis e interpretación del contenido a menos que estés usando software OCR, como IronOCR.
Antes de explorar cómo IronPDF puede abordar esta tarea, primero exploremos una herramienta en línea capaz de manejar la extracción de PDF. Para extraer una tabla de un documento PDF usando una herramienta PDF en línea, sigue los pasos que se describen a continuación:
- Navega hasta la herramienta gratuita de extracción de PDF en línea
- Sube el PDF que contiene la tabla
- Revisa y descarga los resultados
Hoy utilizaremos Docsumo como nuestro ejemplo de herramienta de PDF en línea. Docsumo es un AI de documento PDF en línea que ofrece una herramienta gratuita de extracción de tablas PDF.
Segundo paso: cargar el PDF que contiene la tabla
Ahora, haz clic en el botón "Cargar archivo" para subir tu archivo PDF para la extracción. La herramienta comenzará inmediatamente a procesar tu PDF.
Paso 3: Ver y descargar los resultados
Una vez que Docsumo haya terminado de procesar el PDF, mostrará la tabla extraída. Luego puedes hacer ajustes en la estructura de la tabla como añadir y remover filas. Aquí, puedes descargar la tabla como un PDF, XLS, JSON, o Texto.
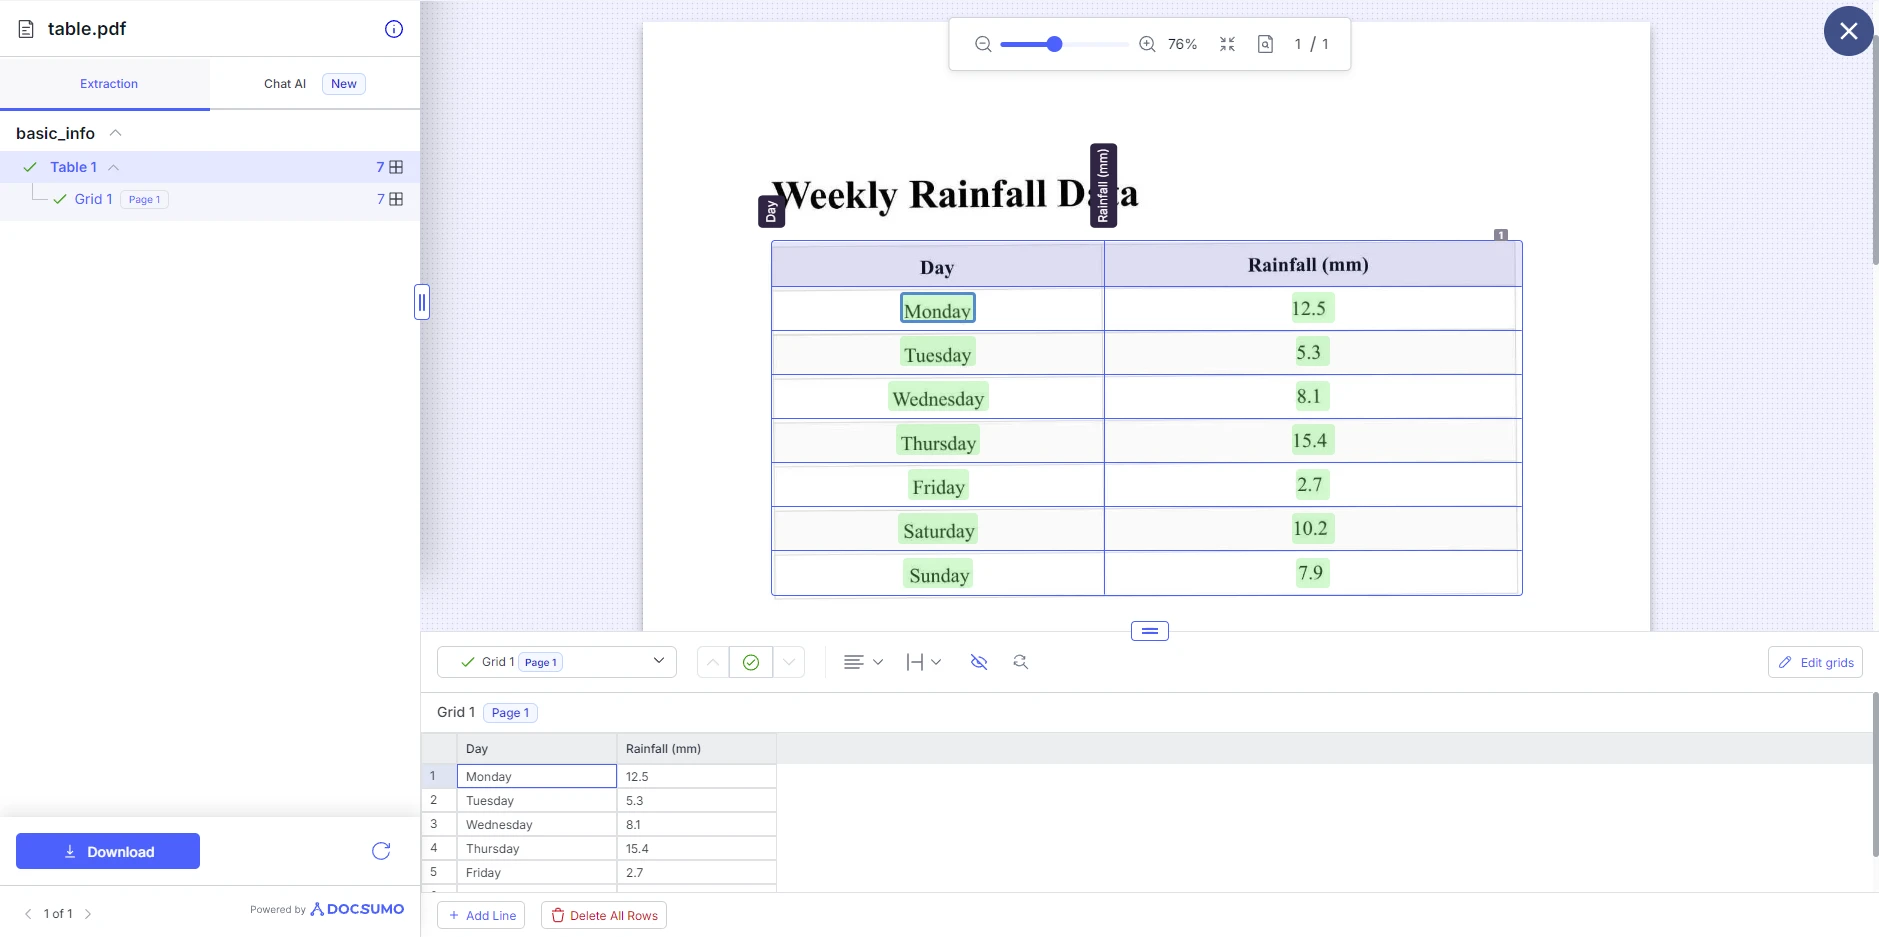
IronPDF le permite extraer datos, texto y gráficos de PDFs, los cuales luego pueden ser usados para reconstruir tablas programáticamente. Para hacer esto, primero necesitarás extraer el contenido textual de la tabla en el PDF y luego usar ese texto para analizar la tabla en filas y columnas. Antes de comenzar a extraer tablas, echemos un vistazo a cómo funciona el método ExtractAllText() de IronPDF extrayendo los datos dentro de una tabla:
using IronPDF;

class Program
{
    static void Main(string[] args)
    {
        // Load the PDF document
        PdfDocument pdf = PdfDocument.FromFile("example.pdf");

        // Extract all text from the PDF
        string text = pdf.ExtractAllText();

        // Output the extracted text to the console
        Console.WriteLine(text);
    }
}
using IronPDF;

class Program
{
    static void Main(string[] args)
    {
        // Load the PDF document
        PdfDocument pdf = PdfDocument.FromFile("example.pdf");

        // Extract all text from the PDF
        string text = pdf.ExtractAllText();

        // Output the extracted text to the console
        Console.WriteLine(text);
    }
}
Imports IronPDF
Module Program
Sub Main(args As String())
' Load the PDF document
Dim pdf As PdfDocument = PdfDocument.FromFile("example.pdf")
' Extract all text from the PDF
Dim text As String = pdf.ExtractAllText()
' Output the extracted text to the console
Console.WriteLine(text)
End Sub
End Module
Imports IronPDF

Module Program
    Sub Main(args As String())
        ' Load the PDF document
        Dim pdf As PdfDocument = PdfDocument.FromFile("example.pdf")

        ' Extract all text from the PDF
        Dim text As String = pdf.ExtractAllText()

        ' Output the extracted text to the console
        Console.WriteLine(text)
    End Sub
End Module
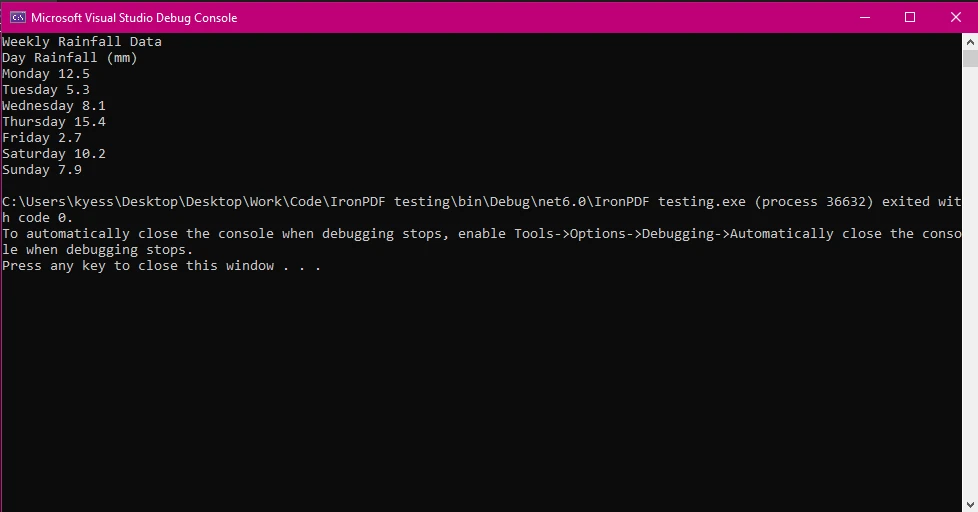
En este ejemplo, hemos cargado el documento PDF usando la clase PdfDocument, y luego usamos el método ExtractAllText() para extraer todo el texto dentro del documento, antes de finalmente mostrar el texto en la consola.
Después de extraer texto del PDF, la tabla aparecerá como una serie de filas y columnas en texto sin formato. Puedes dividir este texto en función de los saltos de línea (\n) y luego dividir más las filas en columnas en función de espacios consistentes o delimitadores como comas o pestañas. Aquí tienes un ejemplo básico de cómo analizar la tabla del texto:
using IronPDF;
using System;
using System.Linq;

class Program
{
    static void Main(string[] args)
    {
        // Load the PDF document
        PdfDocument pdf = PdfDocument.FromFile("table.pdf");

        // Extract all text from the PDF
        string text = pdf.ExtractAllText();

        // Split the text into lines (rows)
        string[] lines = text.Split('\n');

        foreach (string line in lines)
        {
            // Split the line into columns using the tab character
            string[] columns = line.Split('\t').Where(col => !string.IsNullOrWhiteSpace(col)).ToArray();
            Console.WriteLine("Row:");

            foreach (string column in columns)
            {
                Console.WriteLine("  " + column); // Output each column in the row
            }
        }
    }
}
using IronPDF;
using System;
using System.Linq;

class Program
{
    static void Main(string[] args)
    {
        // Load the PDF document
        PdfDocument pdf = PdfDocument.FromFile("table.pdf");

        // Extract all text from the PDF
        string text = pdf.ExtractAllText();

        // Split the text into lines (rows)
        string[] lines = text.Split('\n');

        foreach (string line in lines)
        {
            // Split the line into columns using the tab character
            string[] columns = line.Split('\t').Where(col => !string.IsNullOrWhiteSpace(col)).ToArray();
            Console.WriteLine("Row:");

            foreach (string column in columns)
            {
                Console.WriteLine("  " + column); // Output each column in the row
            }
        }
    }
}
Imports IronPDF
Imports System
Imports System.Linq
Module Program
Sub Main(args As String())
' Load the PDF document
Dim pdf As PdfDocument = PdfDocument.FromFile("table.pdf")
' Extract all text from the PDF
Dim text As String = pdf.ExtractAllText()
' Split the text into lines (rows)
Dim lines As String() = text.Split(ControlChars.Lf)
For Each line As String In lines
' Split the line into columns using the tab character
Dim columns As String() = line.Split(ControlChars.Tab).Where(Function(col) Not String.IsNullOrWhiteSpace(col)).ToArray()
Console.WriteLine("Row:")
For Each column As String In columns
Console.WriteLine(" " & column) ' Output each column in the row
Next
Next
End Sub
End Module
Imports IronPDF
Imports System
Imports System.Linq

Module Program
    Sub Main(args As String())
        ' Load the PDF document
        Dim pdf As PdfDocument = PdfDocument.FromFile("table.pdf")

        ' Extract all text from the PDF
        Dim text As String = pdf.ExtractAllText()

        ' Split the text into lines (rows)
        Dim lines As String() = text.Split(ControlChars.Lf)

        For Each line As String In lines
            ' Split the line into columns using the tab character
            Dim columns As String() = line.Split(ControlChars.Tab).Where(Function(col) Not String.IsNullOrWhiteSpace(col)).ToArray()
            Console.WriteLine("Row:")

            For Each column As String In columns
                Console.WriteLine("  " & column) ' Output each column in the row
            Next
        Next
    End Sub
End Module
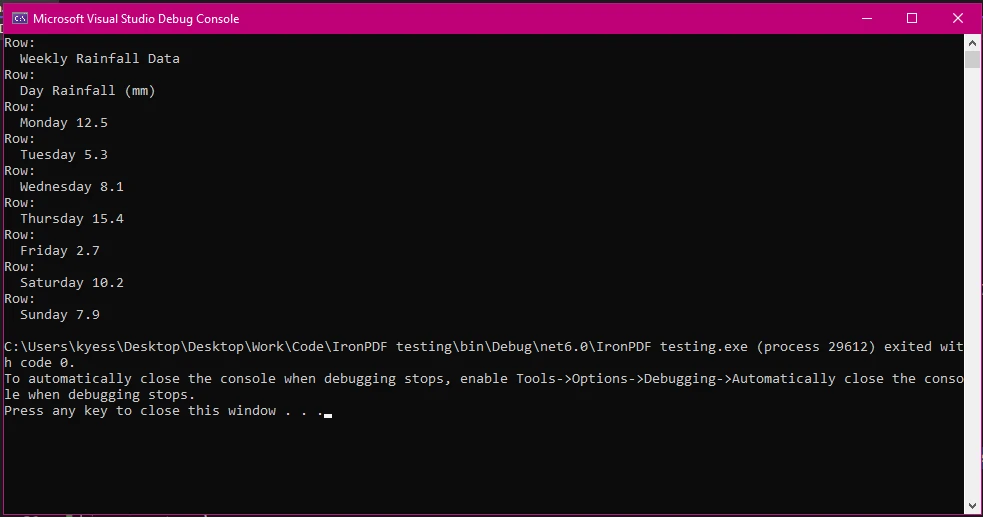
En este ejemplo, seguimos los mismos pasos que antes para cargar nuestro documento PDF y extraer el texto. Luego, usando text.Split('\n') dividimos el texto extraído en filas en función de los saltos de línea y almacenamos los resultados en el array lines. Después se utiliza un bucle foreach para recorrer las filas en el array, donde line.Split('\t') se usa para dividir aún más las filas en columnas utilizando el carácter de tabulación '\t' como el delimitador. La siguiente parte del array de columnas, Where(col => !string.IsNullOrWhiteSpace(col)).ToArray() filtra columnas vacías que pueden surgir debido a espacios adicionales, y luego añade las columnas al array de columnas.
Finalmente, escribimos el texto en la ventana de salida de la consola con una estructura básica de filas y columnas.
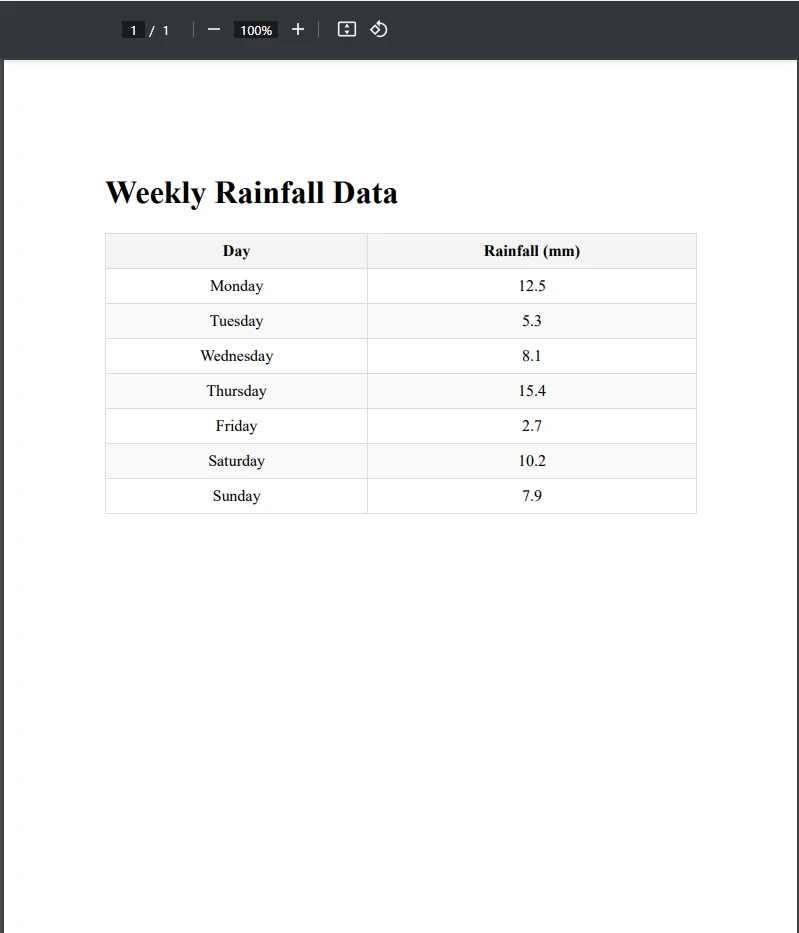
Ahora que hemos cubierto cómo extraer tablas de archivos PDF, echemos un vistazo a lo que podemos hacer con esos datos extraídos. Exportar la tabla extraída como un archivo CSV es una forma útil de manejar datos de tablas y automatizar tareas como la entrada de datos. Para este ejemplo, hemos llenado una tabla con datos simulados, en este caso, la cantidad diaria de lluvia en una semana, extraído la tabla del PDF, y luego exportado a un archivo CSV.
using System;
using System.Collections.Generic;
using System.IO;
using System.Linq;
using IronPDF;

class Program
{
    static void Main(string[] args)
    {
        string pdfPath = "table.pdf";
        string csvPath = "output.csv";

        // Extract and parse table data
        var tableData = ExtractTableDataFromPdf(pdfPath);

        // Write the extracted data to a CSV file
        WriteDataToCsv(tableData, csvPath);
        Console.WriteLine($"Data extracted and saved to {csvPath}");
    }

    static List<string[]> ExtractTableDataFromPdf(string pdfPath)
    {
        var pdf = PdfDocument.FromFile(pdfPath);

        // Extract text from the first page
        var text = pdf.ExtractTextFromPage(0);
        var rows = new List<string[]>();

        // Split text into lines (rows)
        var lines = text.Split('\n');

        // Variable to hold column values temporarily
        var tempColumns = new List<string>();

        foreach (var line in lines)
        {
            var trimmedLine = line.Trim();

            // Check for empty lines or lines that don't contain table data
            if (string.IsNullOrEmpty(trimmedLine) || trimmedLine.Contains("Header"))
            {
                continue;
            }

            // Split line into columns. Adjust this based on how columns are separated.
            var columns = trimmedLine.Split(new[] { ' ', '\t' }, StringSplitOptions.RemoveEmptyEntries);

            if (columns.Length > 0)
            {
                // Add columns to temporary list
                tempColumns.AddRange(columns);
                rows.Add(tempColumns.ToArray());
                tempColumns.Clear(); // Clear temporary list after adding to rows
            }
        }

        return rows;
    }

    static void WriteDataToCsv(List<string[]> data, string csvPath)
    {
        using (var writer = new StreamWriter(csvPath))
        {
            foreach (var row in data)
            {
                // Join columns with commas and quote each field to handle commas within data
                var csvRow = string.Join(",", row.Select(field => $"\"{field.Replace("\"", "\"\"")}\""));
                writer.WriteLine(csvRow);
            }
        }
    }
}
using System;
using System.Collections.Generic;
using System.IO;
using System.Linq;
using IronPDF;

class Program
{
    static void Main(string[] args)
    {
        string pdfPath = "table.pdf";
        string csvPath = "output.csv";

        // Extract and parse table data
        var tableData = ExtractTableDataFromPdf(pdfPath);

        // Write the extracted data to a CSV file
        WriteDataToCsv(tableData, csvPath);
        Console.WriteLine($"Data extracted and saved to {csvPath}");
    }

    static List<string[]> ExtractTableDataFromPdf(string pdfPath)
    {
        var pdf = PdfDocument.FromFile(pdfPath);

        // Extract text from the first page
        var text = pdf.ExtractTextFromPage(0);
        var rows = new List<string[]>();

        // Split text into lines (rows)
        var lines = text.Split('\n');

        // Variable to hold column values temporarily
        var tempColumns = new List<string>();

        foreach (var line in lines)
        {
            var trimmedLine = line.Trim();

            // Check for empty lines or lines that don't contain table data
            if (string.IsNullOrEmpty(trimmedLine) || trimmedLine.Contains("Header"))
            {
                continue;
            }

            // Split line into columns. Adjust this based on how columns are separated.
            var columns = trimmedLine.Split(new[] { ' ', '\t' }, StringSplitOptions.RemoveEmptyEntries);

            if (columns.Length > 0)
            {
                // Add columns to temporary list
                tempColumns.AddRange(columns);
                rows.Add(tempColumns.ToArray());
                tempColumns.Clear(); // Clear temporary list after adding to rows
            }
        }

        return rows;
    }

    static void WriteDataToCsv(List<string[]> data, string csvPath)
    {
        using (var writer = new StreamWriter(csvPath))
        {
            foreach (var row in data)
            {
                // Join columns with commas and quote each field to handle commas within data
                var csvRow = string.Join(",", row.Select(field => $"\"{field.Replace("\"", "\"\"")}\""));
                writer.WriteLine(csvRow);
            }
        }
    }
}
Imports System
Imports System.Collections.Generic
Imports System.IO
Imports System.Linq
Imports IronPdf
Module Program
Sub Main(args As String())
Dim pdfPath As String = "table.pdf"
Dim csvPath As String = "output.csv"
' Extract and parse table data
Dim tableData = ExtractTableDataFromPdf(pdfPath)
' Write the extracted data to a CSV file
WriteDataToCsv(tableData, csvPath)
Console.WriteLine($"Data extracted and saved to {csvPath}")
End Sub
Function ExtractTableDataFromPdf(pdfPath As String) As List(Of String())
Dim pdf = PdfDocument.FromFile(pdfPath)
' Extract text from the first page
Dim text = pdf.ExtractTextFromPage(0)
Dim rows = New List(Of String())()
' Split text into lines (rows)
Dim lines = text.Split(ControlChars.Lf)
' Variable to hold column values temporarily
Dim tempColumns = New List(Of String)()
For Each line In lines
Dim trimmedLine = line.Trim()
' Check for empty lines or lines that don't contain table data
If String.IsNullOrEmpty(trimmedLine) OrElse trimmedLine.Contains("Header") Then
Continue For
End If
' Split line into columns. Adjust this based on how columns are separated.
Dim columns = trimmedLine.Split(New Char() { " "c, ControlChars.Tab }, StringSplitOptions.RemoveEmptyEntries)
If columns.Length > 0 Then
' Add columns to temporary list
tempColumns.AddRange(columns)
rows.Add(tempColumns.ToArray())
tempColumns.Clear() ' Clear temporary list after adding to rows
End If
Next
Return rows
End Function
Sub WriteDataToCsv(data As List(Of String()), csvPath As String)
Using writer = New StreamWriter(csvPath)
For Each row In data
' Join columns with commas and quote each field to handle commas within data
Dim csvRow = String.Join(",", row.Select(Function(field) $"""{field.Replace("""", """""")}"""))
writer.WriteLine(csvRow)
Next
End Using
End Sub
End Module
Imports System
Imports System.Collections.Generic
Imports System.IO
Imports System.Linq
Imports IronPdf

Module Program
    Sub Main(args As String())
        Dim pdfPath As String = "table.pdf"
        Dim csvPath As String = "output.csv"

        ' Extract and parse table data
        Dim tableData = ExtractTableDataFromPdf(pdfPath)

        ' Write the extracted data to a CSV file
        WriteDataToCsv(tableData, csvPath)
        Console.WriteLine($"Data extracted and saved to {csvPath}")
    End Sub

    Function ExtractTableDataFromPdf(pdfPath As String) As List(Of String())
        Dim pdf = PdfDocument.FromFile(pdfPath)

        ' Extract text from the first page
        Dim text = pdf.ExtractTextFromPage(0)
        Dim rows = New List(Of String())()

        ' Split text into lines (rows)
        Dim lines = text.Split(ControlChars.Lf)

        ' Variable to hold column values temporarily
        Dim tempColumns = New List(Of String)()

        For Each line In lines
            Dim trimmedLine = line.Trim()

            ' Check for empty lines or lines that don't contain table data
            If String.IsNullOrEmpty(trimmedLine) OrElse trimmedLine.Contains("Header") Then
                Continue For
            End If

            ' Split line into columns. Adjust this based on how columns are separated.
            Dim columns = trimmedLine.Split(New Char() { " "c, ControlChars.Tab }, StringSplitOptions.RemoveEmptyEntries)

            If columns.Length > 0 Then
                ' Add columns to temporary list
                tempColumns.AddRange(columns)
                rows.Add(tempColumns.ToArray())
                tempColumns.Clear() ' Clear temporary list after adding to rows
            End If
        Next

        Return rows
    End Function

    Sub WriteDataToCsv(data As List(Of String()), csvPath As String)
        Using writer = New StreamWriter(csvPath)
            For Each row In data
                ' Join columns with commas and quote each field to handle commas within data
                Dim csvRow = String.Join(",", row.Select(Function(field) $"""{field.Replace("""", """""")}"""))
                writer.WriteLine(csvRow)
            Next
        End Using
    End Sub
End Module
Fichero PDF de ejemplo
Fichero CSV de salida
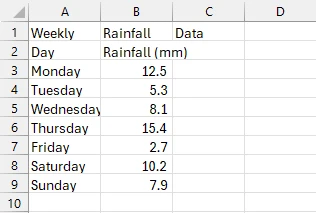
Como puedes ver, hemos exportado exitosamente la tabla PDF a CSV. Primero, cargamos el PDF que contiene la tabla y creamos una nueva ruta de archivo CSV. Después de esto, extraemos la tabla usando la línea var tableData = ExtractTableDataFromPdf(pdfPath), que llama al método ExtractTableDataFromPdf(). Este método extrae todo el texto en la página PDF en la que reside la tabla, almacenándolo en la variable text.
Luego, dividimos el texto en líneas y columnas. Finalmente, después de devolver el resultado de este proceso de división, llamamos al método static void WriteDataToCsv() que toma el texto extraído y dividido y lo escribe en nuestro archivo CSV usando StreamWriter.
Consejos y buenas prácticas
Al trabajar con tablas PDF, seguir algunas prácticas básicas puede ayudar a asegurar que minimices la posibilidad de encontrarte con errores o problemas.
- Preprocesa PDFs: Si es posible, preprocesa tus PDFs para asegurar un formato consistente, lo que simplifica el proceso de extracción.
- Valida datos: Siempre valida los datos extraídos para asegurar precisión y completitud.
- Maneja errores: Implementa manejo de errores para gestionar casos donde la extracción de texto o análisis falle, como envolver tu código en un bloque try-catch.
- Optimiza el rendimiento: Para archivos PDF grandes, considera optimizar la extracción de texto y el análisis para manejar problemas de rendimiento.
En el ecosistema de facturación electrónica español, la extracción de datos tabulares de PDFs cobra especial relevancia en varios contextos regulatorios. Las empresas sujetas al SII (Suministro Inmediato de Información) con la AEAT deben mantener libros de registro de IVA que frecuentemente se generan o reciben en formato PDF. La extracción programática de tablas con IronPDF permite automatizar la validación de estos registros contra los datos declarados.
Bajo el sistema VERI*FACTU, la verificación de integridad de facturas requiere comparar el contenido visual (PDF) con el registro XML encadenado. IronPDF puede extraer el contenido textual de las tablas de facturas PDF para su cotejo automatizado, un control de auditoría interna recomendado para proveedores de software de facturación. En el ámbito de TicketBAI - el sistema obligatorio para las haciendas forales de Bizkaia (bizkaia.eus), Gipuzkoa (gipuzkoa.eus) y Araba (araba.eus) - los ISVs también pueden necesitar extraer datos de PDFs de facturas XAdES-firmadas para procesos de reconciliación o auditoría.
Para flujos de trabajo de facturación B2G mediante Facturae y FACe, la extracción de tablas de PDFs recibidos permite automatizar la entrada de datos en sistemas ERP. IronPDF, con licencia comercial propietaria, evita las complicaciones de la licencia AGPL de alternativas como iText en estos contextos de alta penalización normativa (hasta 150.000 €/año para proveedores de software bajo VeriFactu).
Licencias de IronPDF
IronPDF ofrece diferentes opciones de licencias, permitiéndote probar por ti mismo todas las características poderosas que IronPDF tiene para ofrecer antes de comprometerte a obtener una licencia.
Conclusión
Extraer tablas de PDFs usando IronPDF es una manera poderosa de automatizar la extracción de datos, facilitar el análisis y convertir documentos en formatos más accesibles. Ya sea que estés tratando con tablas simples o formatos complejos e irregulares, IronPDF proporciona las herramientas necesarias para extraer y procesar datos de tabla de manera eficiente.
Con IronPDF, puedes optimizar flujos de trabajo como la entrada de datos automatizada, conversión de documentos y análisis de datos. La flexibilidad y características avanzadas que ofrece IronPDF lo convierten en una herramienta valiosa para manejar diversas tareas basadas en PDFs.








