Dans de nombreuses industries, les fichiers PDF sont le format de référence pour partager des documents structurés tels que des rapports, des factures et des tableaux de données. Cependant, extraire des données des PDF, surtout lorsqu'il s'agit de tableaux, peut être difficile en raison de la nature du format PDF. Contrairement aux formats de données structurés, les PDF sont conçus principalement pour la présentation, pas pour l'extraction de données.
Cependant, avec IronPDF, une puissante bibliothèque C# PDF .NET, vous pouvez facilement extraire des données structurées comme des tableaux directement à partir des PDFs et les traiter dans vos applications .NET. Cet article vous guidera étape par étape sur la façon d'extraire des données tabulaires à partir de fichiers PDF avec IronPDF.
Quand avez-vous besoin d'extraire des tables à partir de documents PDF ?
Les tableaux sont un moyen pratique de structurer et d'afficher vos données, que ce soit pour la gestion d'inventaire, la saisie de données, l'enregistrement de données telles que la pluviométrie, etc. Ainsi, il peut également y avoir de nombreuses raisons de devoir extraire des tableaux et des données tabulaires à partir de documents PDF. Certains des cas d'utilisation les plus courants comprennent :
- Automatisation de la saisie de données : L'extraction de données des tableaux dans les rapports ou factures PDF peut automatiser des processus tels que le remplissage de bases de données ou de feuilles de calcul.
- Analyse de données : Les entreprises reçoivent souvent des rapports structurés au format PDF. L'extraction des tableaux vous permet d'analyser ces données de manière programmée.
- Conversion de documents : L'extraction de données tabulaires dans des formats plus accessibles comme Excel ou CSV permet une manipulation, un stockage et un partage plus faciles.
- Audit et conformité : Pour les dossiers juridiques ou financiers, l'extraction programmée de données tabulaires à partir de documents PDF peut aider à automatiser les audits et garantir la conformité.
Le format de fichier PDF n'offre aucune capacité native pour stocker des données dans des formats structurés comme des tableaux. Le tableau utilisé dans l'exemple d'aujourd'hui a été créé en HTML, avant d'être converti au format PDF. Les tableaux sont rendus sous forme de texte et de lignes, donc l'extraction des données tabulaires nécessite souvent une certaine analyse et interprétation du contenu, sauf si vous utilisez un logiciel OCR, tel que IronOCR.
Avant d'explorer comment IronPDF peut s'attaquer à cette tâche, examinons d'abord un outil en ligne capable de gérer l'extraction PDF. Pour extraire un tableau d'un document PDF à l'aide d'un outil PDF en ligne, suivez les étapes ci-dessous :
- Accédez à l'outil d'extraction PDF en ligne gratuit
- Téléchargez le PDF contenant le tableau
- Visualisez et téléchargez les résultats
Aujourd'hui, nous utiliserons Docsumo comme exemple d'outil PDF en ligne. Docsumo est une IA de document PDF en ligne qui offre un outil gratuit d'extraction de tableaux PDF.
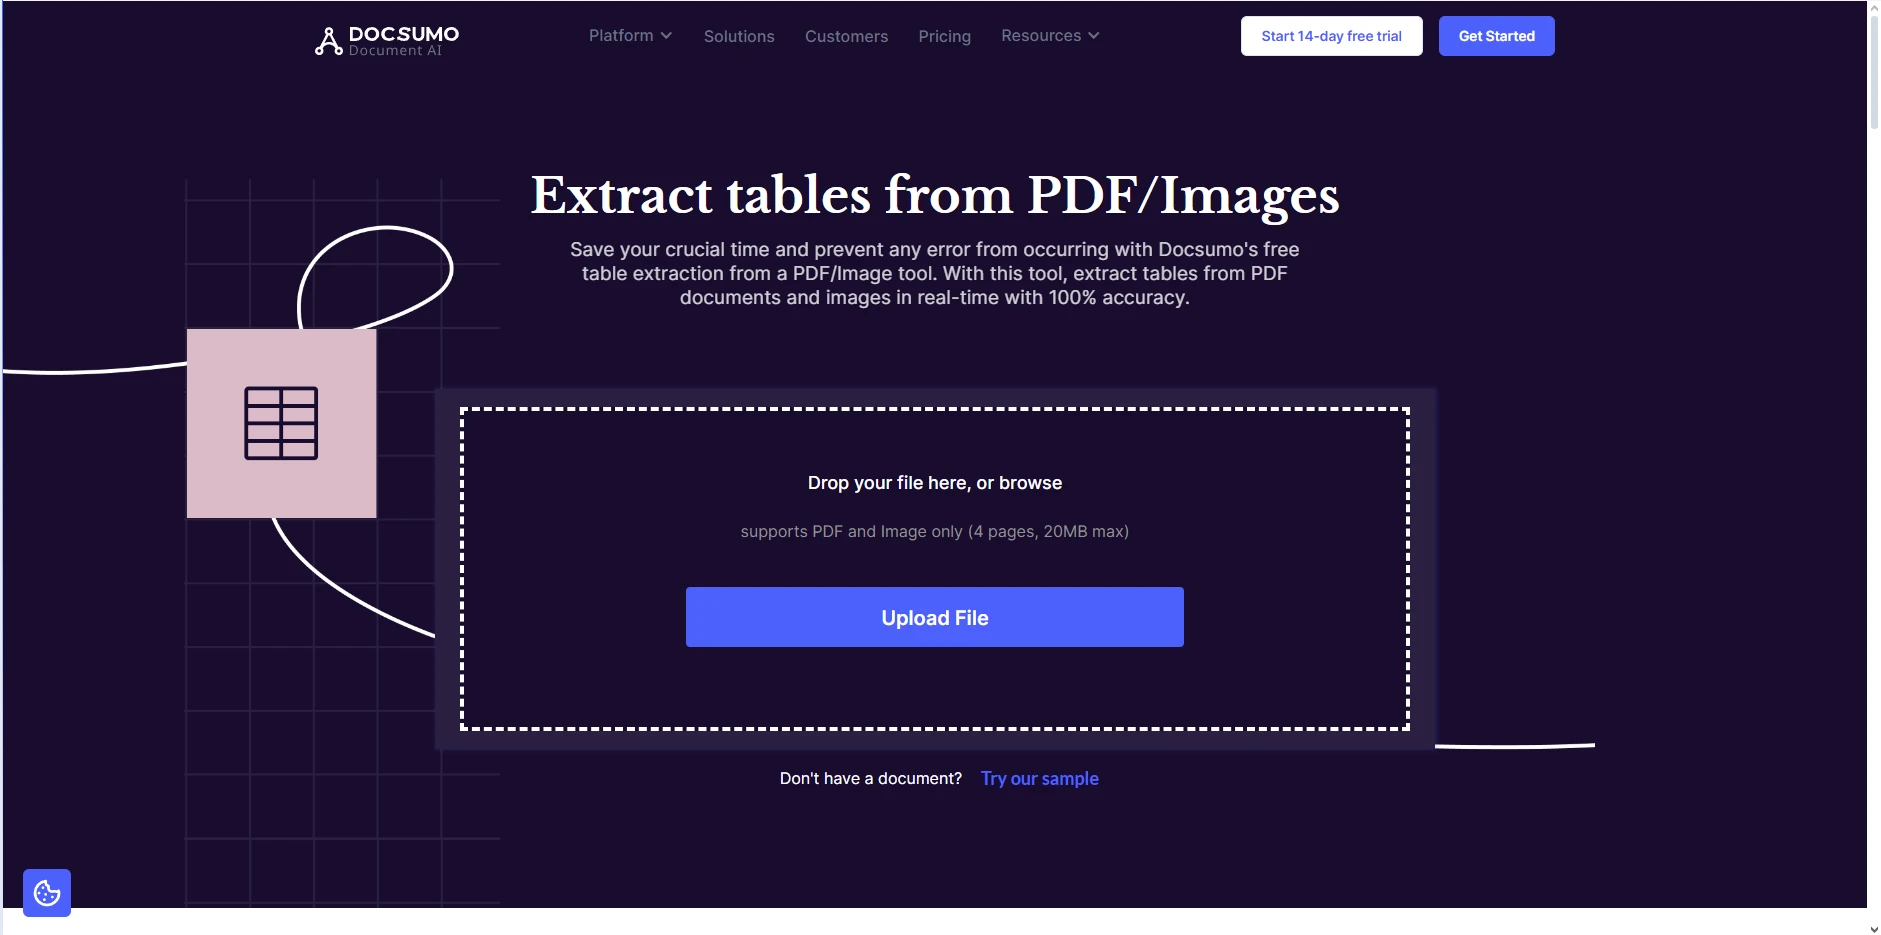
Étape deux : Téléchargez le PDF contenant le tableau
Maintenant, cliquez sur le bouton "Télécharger le fichier" pour télécharger votre fichier PDF pour extraction. L'outil commencera immédiatement à traiter votre PDF.
Étape trois : Visualisez et téléchargez les résultats
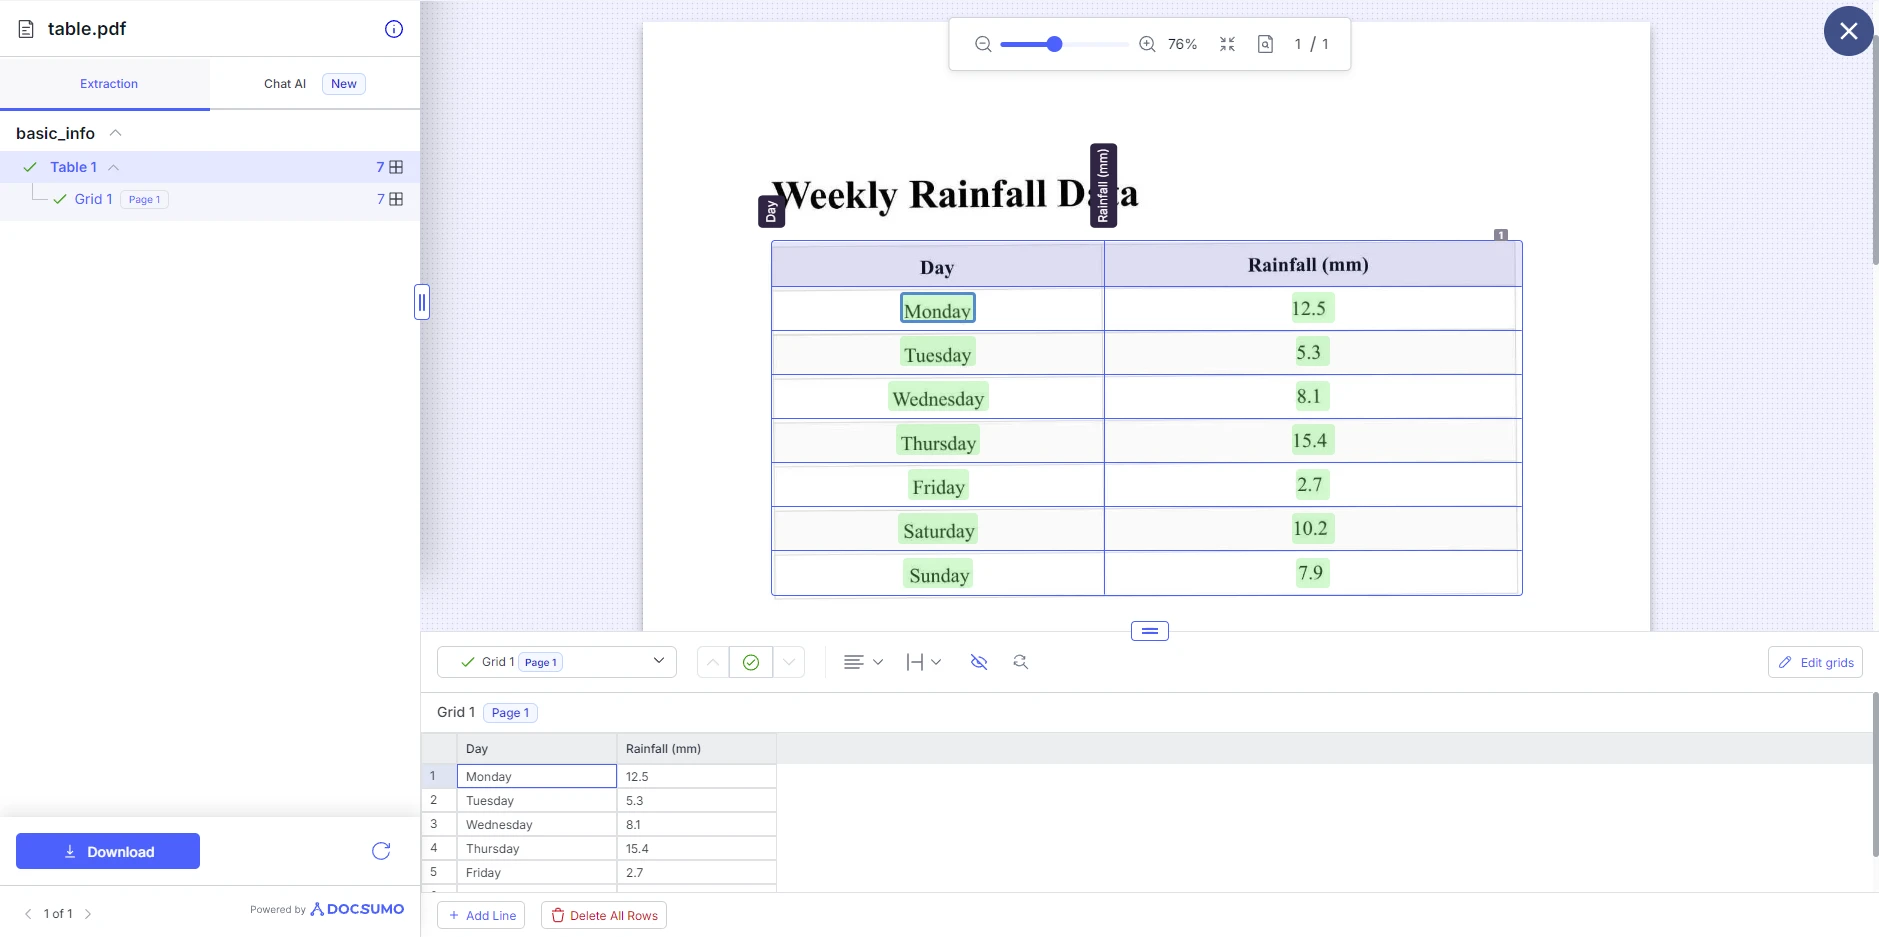
Une fois que Docsumo a terminé le traitement du PDF, il affichera le tableau extrait. Vous pouvez ensuite apporter des modifications à la structure du tableau, telles que l'ajout et la suppression de lignes. Ici, vous pouvez télécharger le tableau soit comme un autre PDF, soit en XLS, JSON ou Texte.
IronPDF vous permet d'extraire des données, du texte et des graphiques à partir de PDFs, qui peuvent ensuite être utilisés pour reconstruire des tables de manière programmatique. Pour ce faire, vous devrez d'abord extraire le contenu textuel du tableau PDF, puis utiliser ce texte pour analyser le tableau en lignes et colonnes. Avant de commencer à extraire des tableaux, voyons comment fonctionne la méthode d'IronPDF ExtractAllText() en extrayant les données d'un tableau :
using IronPDF;

class Program
{
    static void Main(string[] args)
    {
        // Load the PDF document
        PdfDocument pdf = PdfDocument.FromFile("example.pdf");

        // Extract all text from the PDF
        string text = pdf.ExtractAllText();

        // Output the extracted text to the console
        Console.WriteLine(text);
    }
}
using IronPDF;

class Program
{
    static void Main(string[] args)
    {
        // Load the PDF document
        PdfDocument pdf = PdfDocument.FromFile("example.pdf");

        // Extract all text from the PDF
        string text = pdf.ExtractAllText();

        // Output the extracted text to the console
        Console.WriteLine(text);
    }
}
Imports IronPDF
Module Program
Sub Main(args As String())
' Load the PDF document
Dim pdf As PdfDocument = PdfDocument.FromFile("example.pdf")
' Extract all text from the PDF
Dim text As String = pdf.ExtractAllText()
' Output the extracted text to the console
Console.WriteLine(text)
End Sub
End Module
Imports IronPDF

Module Program
    Sub Main(args As String())
        ' Load the PDF document
        Dim pdf As PdfDocument = PdfDocument.FromFile("example.pdf")

        ' Extract all text from the PDF
        Dim text As String = pdf.ExtractAllText()

        ' Output the extracted text to the console
        Console.WriteLine(text)
    End Sub
End Module
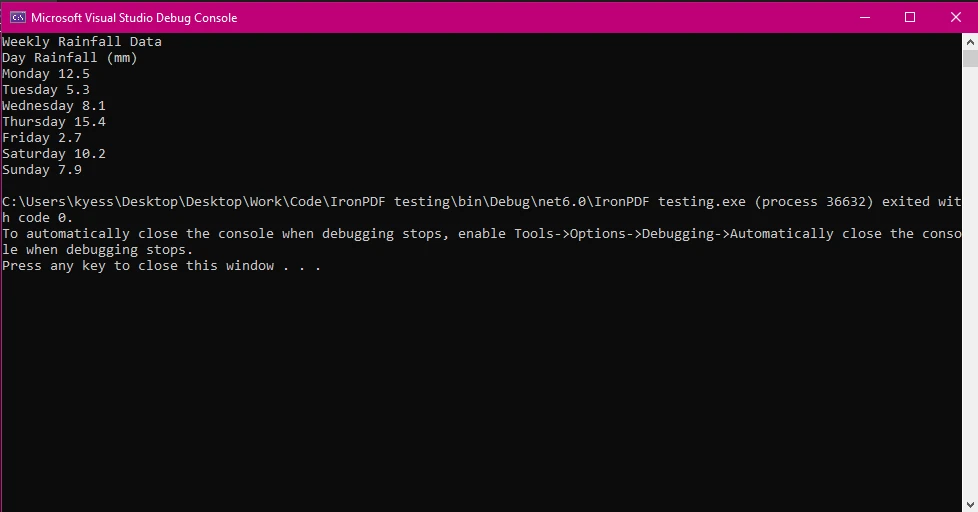
Dans cet exemple, nous avons chargé le document PDF en utilisant la classe PdfDocument, puis utilisé la méthode ExtractAllText() pour extraire tout le texte du document, avant de finalement afficher le texte sur la console.
Après avoir extrait le texte du PDF, le tableau apparaîtra comme une série de lignes et de colonnes en texte brut. Vous pouvez diviser ce texte en fonction des sauts de ligne (\n) et ensuite diviser encore plus les lignes en colonnes en fonction d'un espacement constant ou de délimiteurs tels que des virgules ou des tabulations. Voici un exemple de base sur la façon d'analyser le tableau à partir du texte :
using IronPDF;
using System;
using System.Linq;

class Program
{
    static void Main(string[] args)
    {
        // Load the PDF document
        PdfDocument pdf = PdfDocument.FromFile("table.pdf");

        // Extract all text from the PDF
        string text = pdf.ExtractAllText();

        // Split the text into lines (rows)
        string[] lines = text.Split('\n');

        foreach (string line in lines)
        {
            // Split the line into columns using the tab character
            string[] columns = line.Split('\t').Where(col => !string.IsNullOrWhiteSpace(col)).ToArray();
            Console.WriteLine("Row:");

            foreach (string column in columns)
            {
                Console.WriteLine("  " + column); // Output each column in the row
            }
        }
    }
}
using IronPDF;
using System;
using System.Linq;

class Program
{
    static void Main(string[] args)
    {
        // Load the PDF document
        PdfDocument pdf = PdfDocument.FromFile("table.pdf");

        // Extract all text from the PDF
        string text = pdf.ExtractAllText();

        // Split the text into lines (rows)
        string[] lines = text.Split('\n');

        foreach (string line in lines)
        {
            // Split the line into columns using the tab character
            string[] columns = line.Split('\t').Where(col => !string.IsNullOrWhiteSpace(col)).ToArray();
            Console.WriteLine("Row:");

            foreach (string column in columns)
            {
                Console.WriteLine("  " + column); // Output each column in the row
            }
        }
    }
}
Imports IronPDF
Imports System
Imports System.Linq
Module Program
Sub Main(args As String())
' Load the PDF document
Dim pdf As PdfDocument = PdfDocument.FromFile("table.pdf")
' Extract all text from the PDF
Dim text As String = pdf.ExtractAllText()
' Split the text into lines (rows)
Dim lines As String() = text.Split(ControlChars.Lf)
For Each line As String In lines
' Split the line into columns using the tab character
Dim columns As String() = line.Split(ControlChars.Tab).Where(Function(col) Not String.IsNullOrWhiteSpace(col)).ToArray()
Console.WriteLine("Row:")
For Each column As String In columns
Console.WriteLine(" " & column) ' Output each column in the row
Next
Next
End Sub
End Module
Imports IronPDF
Imports System
Imports System.Linq

Module Program
    Sub Main(args As String())
        ' Load the PDF document
        Dim pdf As PdfDocument = PdfDocument.FromFile("table.pdf")

        ' Extract all text from the PDF
        Dim text As String = pdf.ExtractAllText()

        ' Split the text into lines (rows)
        Dim lines As String() = text.Split(ControlChars.Lf)

        For Each line As String In lines
            ' Split the line into columns using the tab character
            Dim columns As String() = line.Split(ControlChars.Tab).Where(Function(col) Not String.IsNullOrWhiteSpace(col)).ToArray()
            Console.WriteLine("Row:")

            For Each column As String In columns
                Console.WriteLine("  " & column) ' Output each column in the row
            Next
        Next
    End Sub
End Module
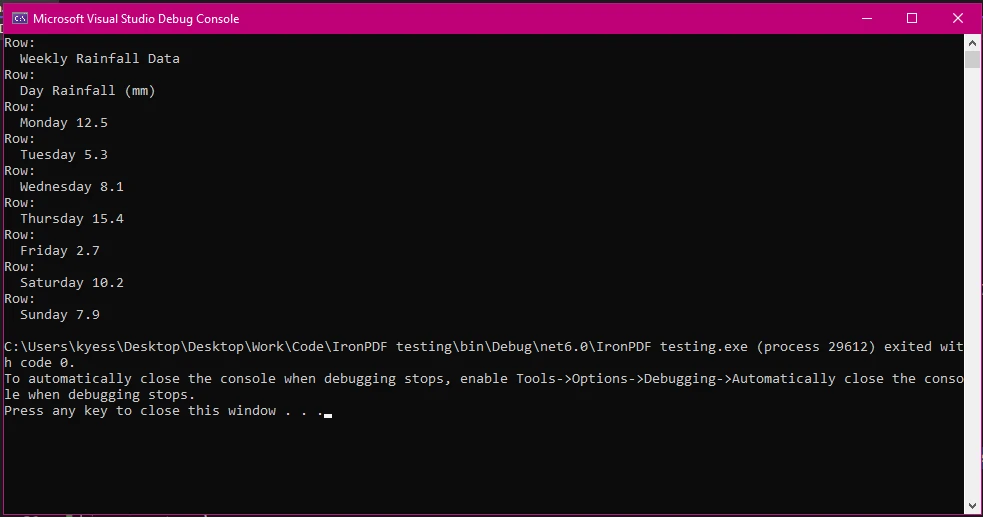
Dans cet exemple, nous avons suivi les mêmes étapes qu'auparavant pour charger notre document PDF et extraire le texte. Ensuite, en utilisant text.Split('\n') nous divisons le texte extrait en lignes en fonction des sauts de ligne et stockons les résultats dans le tableau lines. Une boucle foreach est ensuite utilisée pour parcourir les lignes du tableau, où line.Split('\t') est utilisé pour diviser encore plus les lignes en colonnes à l'aide du caractère de tabulation '\t' comme délimiteur. La prochaine partie du tableau de colonnes, Where(col => !string.IsNullOrWhiteSpace(col)).ToArray() filtre les colonnes vides qui peuvent apparaître à cause d'espaces supplémentaires, puis ajoute les colonnes au tableau des colonnes.
Enfin, nous écrivons le texte dans la fenêtre de sortie de la console avec une structure de base pour les lignes et les colonnes.
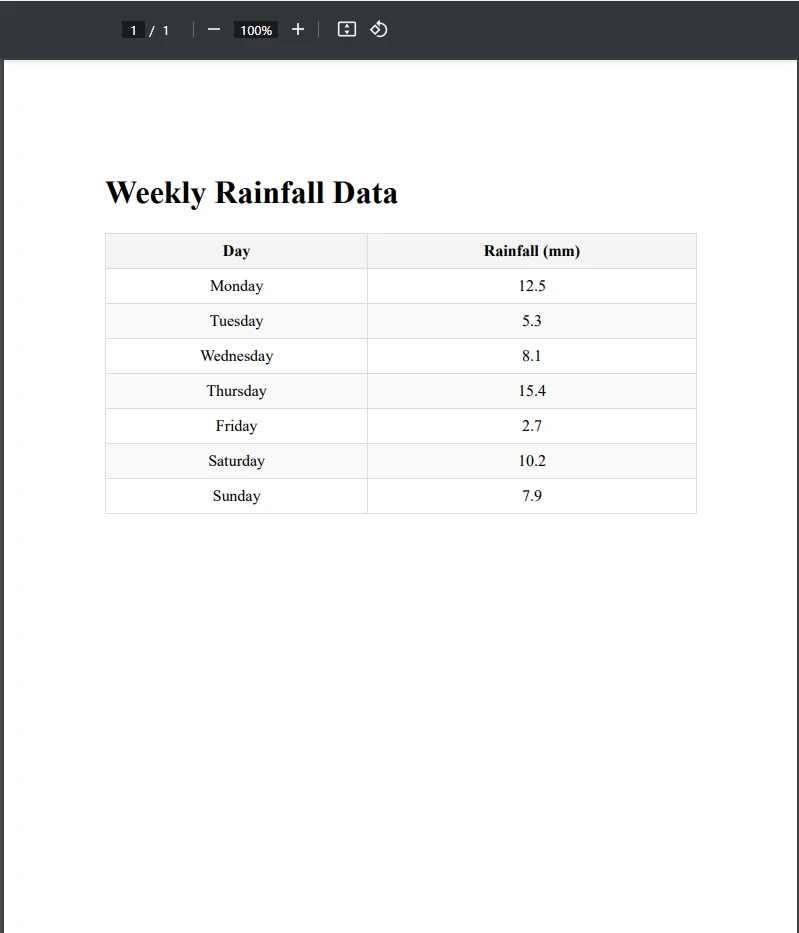
Maintenant que nous avons couvert comment extraire des tableaux à partir de fichiers PDF, examinons ce que nous pouvons faire avec ces données extraites. Exporter le tableau extrait sous forme de fichier CSV est un moyen utile de gérer les données tabulaires et d'automatiser des tâches telles que la saisie de données. Pour cet exemple, nous avons rempli un tableau avec des données simulées, dans ce cas, la quantité de pluie quotidienne en une semaine, extrait le tableau du PDF, puis exporté celui-ci vers un fichier CSV.
using System;
using System.Collections.Generic;
using System.IO;
using System.Linq;
using IronPDF;

class Program
{
    static void Main(string[] args)
    {
        string pdfPath = "table.pdf";
        string csvPath = "output.csv";

        // Extract and parse table data
        var tableData = ExtractTableDataFromPdf(pdfPath);

        // Write the extracted data to a CSV file
        WriteDataToCsv(tableData, csvPath);
        Console.WriteLine($"Data extracted and saved to {csvPath}");
    }

    static List<string[]> ExtractTableDataFromPdf(string pdfPath)
    {
        var pdf = PdfDocument.FromFile(pdfPath);

        // Extract text from the first page
        var text = pdf.ExtractTextFromPage(0);
        var rows = new List<string[]>();

        // Split text into lines (rows)
        var lines = text.Split('\n');

        // Variable to hold column values temporarily
        var tempColumns = new List<string>();

        foreach (var line in lines)
        {
            var trimmedLine = line.Trim();

            // Check for empty lines or lines that don't contain table data
            if (string.IsNullOrEmpty(trimmedLine) || trimmedLine.Contains("Header"))
            {
                continue;
            }

            // Split line into columns. Adjust this based on how columns are separated.
            var columns = trimmedLine.Split(new[] { ' ', '\t' }, StringSplitOptions.RemoveEmptyEntries);

            if (columns.Length > 0)
            {
                // Add columns to temporary list
                tempColumns.AddRange(columns);
                rows.Add(tempColumns.ToArray());
                tempColumns.Clear(); // Clear temporary list after adding to rows
            }
        }

        return rows;
    }

    static void WriteDataToCsv(List<string[]> data, string csvPath)
    {
        using (var writer = new StreamWriter(csvPath))
        {
            foreach (var row in data)
            {
                // Join columns with commas and quote each field to handle commas within data
                var csvRow = string.Join(",", row.Select(field => $"\"{field.Replace("\"", "\"\"")}\""));
                writer.WriteLine(csvRow);
            }
        }
    }
}
using System;
using System.Collections.Generic;
using System.IO;
using System.Linq;
using IronPDF;

class Program
{
    static void Main(string[] args)
    {
        string pdfPath = "table.pdf";
        string csvPath = "output.csv";

        // Extract and parse table data
        var tableData = ExtractTableDataFromPdf(pdfPath);

        // Write the extracted data to a CSV file
        WriteDataToCsv(tableData, csvPath);
        Console.WriteLine($"Data extracted and saved to {csvPath}");
    }

    static List<string[]> ExtractTableDataFromPdf(string pdfPath)
    {
        var pdf = PdfDocument.FromFile(pdfPath);

        // Extract text from the first page
        var text = pdf.ExtractTextFromPage(0);
        var rows = new List<string[]>();

        // Split text into lines (rows)
        var lines = text.Split('\n');

        // Variable to hold column values temporarily
        var tempColumns = new List<string>();

        foreach (var line in lines)
        {
            var trimmedLine = line.Trim();

            // Check for empty lines or lines that don't contain table data
            if (string.IsNullOrEmpty(trimmedLine) || trimmedLine.Contains("Header"))
            {
                continue;
            }

            // Split line into columns. Adjust this based on how columns are separated.
            var columns = trimmedLine.Split(new[] { ' ', '\t' }, StringSplitOptions.RemoveEmptyEntries);

            if (columns.Length > 0)
            {
                // Add columns to temporary list
                tempColumns.AddRange(columns);
                rows.Add(tempColumns.ToArray());
                tempColumns.Clear(); // Clear temporary list after adding to rows
            }
        }

        return rows;
    }

    static void WriteDataToCsv(List<string[]> data, string csvPath)
    {
        using (var writer = new StreamWriter(csvPath))
        {
            foreach (var row in data)
            {
                // Join columns with commas and quote each field to handle commas within data
                var csvRow = string.Join(",", row.Select(field => $"\"{field.Replace("\"", "\"\"")}\""));
                writer.WriteLine(csvRow);
            }
        }
    }
}
Imports System
Imports System.Collections.Generic
Imports System.IO
Imports System.Linq
Imports IronPdf
Module Program
Sub Main(args As String())
Dim pdfPath As String = "table.pdf"
Dim csvPath As String = "output.csv"
' Extract and parse table data
Dim tableData = ExtractTableDataFromPdf(pdfPath)
' Write the extracted data to a CSV file
WriteDataToCsv(tableData, csvPath)
Console.WriteLine($"Data extracted and saved to {csvPath}")
End Sub
Function ExtractTableDataFromPdf(pdfPath As String) As List(Of String())
Dim pdf = PdfDocument.FromFile(pdfPath)
' Extract text from the first page
Dim text = pdf.ExtractTextFromPage(0)
Dim rows = New List(Of String())()
' Split text into lines (rows)
Dim lines = text.Split(ControlChars.Lf)
' Variable to hold column values temporarily
Dim tempColumns = New List(Of String)()
For Each line In lines
Dim trimmedLine = line.Trim()
' Check for empty lines or lines that don't contain table data
If String.IsNullOrEmpty(trimmedLine) OrElse trimmedLine.Contains("Header") Then
Continue For
End If
' Split line into columns. Adjust this based on how columns are separated.
Dim columns = trimmedLine.Split(New Char() { " "c, ControlChars.Tab }, StringSplitOptions.RemoveEmptyEntries)
If columns.Length > 0 Then
' Add columns to temporary list
tempColumns.AddRange(columns)
rows.Add(tempColumns.ToArray())
tempColumns.Clear() ' Clear temporary list after adding to rows
End If
Next
Return rows
End Function
Sub WriteDataToCsv(data As List(Of String()), csvPath As String)
Using writer = New StreamWriter(csvPath)
For Each row In data
' Join columns with commas and quote each field to handle commas within data
Dim csvRow = String.Join(",", row.Select(Function(field) $"""{field.Replace("""", """""")}"""))
writer.WriteLine(csvRow)
Next
End Using
End Sub
End Module
Imports System
Imports System.Collections.Generic
Imports System.IO
Imports System.Linq
Imports IronPdf

Module Program
    Sub Main(args As String())
        Dim pdfPath As String = "table.pdf"
        Dim csvPath As String = "output.csv"

        ' Extract and parse table data
        Dim tableData = ExtractTableDataFromPdf(pdfPath)

        ' Write the extracted data to a CSV file
        WriteDataToCsv(tableData, csvPath)
        Console.WriteLine($"Data extracted and saved to {csvPath}")
    End Sub

    Function ExtractTableDataFromPdf(pdfPath As String) As List(Of String())
        Dim pdf = PdfDocument.FromFile(pdfPath)

        ' Extract text from the first page
        Dim text = pdf.ExtractTextFromPage(0)
        Dim rows = New List(Of String())()

        ' Split text into lines (rows)
        Dim lines = text.Split(ControlChars.Lf)

        ' Variable to hold column values temporarily
        Dim tempColumns = New List(Of String)()

        For Each line In lines
            Dim trimmedLine = line.Trim()

            ' Check for empty lines or lines that don't contain table data
            If String.IsNullOrEmpty(trimmedLine) OrElse trimmedLine.Contains("Header") Then
                Continue For
            End If

            ' Split line into columns. Adjust this based on how columns are separated.
            Dim columns = trimmedLine.Split(New Char() { " "c, ControlChars.Tab }, StringSplitOptions.RemoveEmptyEntries)

            If columns.Length > 0 Then
                ' Add columns to temporary list
                tempColumns.AddRange(columns)
                rows.Add(tempColumns.ToArray())
                tempColumns.Clear() ' Clear temporary list after adding to rows
            End If
        Next

        Return rows
    End Function

    Sub WriteDataToCsv(data As List(Of String()), csvPath As String)
        Using writer = New StreamWriter(csvPath)
            For Each row In data
                ' Join columns with commas and quote each field to handle commas within data
                Dim csvRow = String.Join(",", row.Select(Function(field) $"""{field.Replace("""", """""")}"""))
                writer.WriteLine(csvRow)
            Next
        End Using
    End Sub
End Module
Exemple de fichier PDF
Fichier CSV de sortie
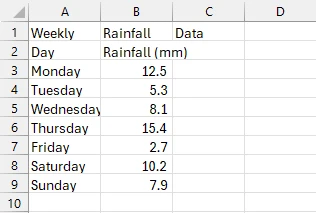
Comme vous pouvez le voir, nous avons réussi à exporter le tableau PDF vers CSV. Tout d'abord, nous avons chargé le PDF contenant le tableau et créé un nouveau chemin de fichier CSV. Après cela, nous avons extrait le tableau à l'aide de la ligne var tableData = ExtractTableDataFromPdf(pdfPath), qui appelle la méthode ExtractTableDataFromPdf(). Cette méthode extrait tout le texte sur la page PDF où se trouve le tableau, en le stockant dans la variable text.
Ensuite, nous avons divisé le texte en lignes et colonnes. Enfin, après avoir retourné le résultat de ce processus de division, nous appelons la méthode static void WriteDataToCsv() qui prend le texte extrait et divisé, et l'écrit dans notre fichier CSV en utilisant StreamWriter.
Conseils et meilleures pratiques
Lorsque vous travaillez avec des tableaux PDF, suivre quelques pratiques élémentaires peut aider à minimiser les chances de rencontrer des erreurs ou des problèmes.
- Prétraiter les PDF : Si possible, prétraitez vos PDF pour garantir un formatage cohérent, ce qui simplifie le processus d'extraction.
- Valider les données : Validez toujours les données extraites pour assurer leur exactitude et leur exhaustivité.
- Gérer les erreurs : Implémentez la gestion des erreurs pour gérer les cas où l'extraction ou l'analyse du texte échoue, comme en encapsulant votre code dans un bloc try-catch.
- Optimiser les performances : Pour les fichiers PDF volumineux, envisagez d'optimiser l'extraction et l'analyse de texte pour gérer les problèmes de performances.
Licences IronPDF
IronPDF propose différentes options de licence, vous permettant d'essayer toutes les fonctionnalités puissantes d'IronPDF avant de vous engager dans une licence.
Conclusion
Extraire des tableaux à partir de PDF en utilisant IronPDF est un moyen puissant d'automatiser l'extraction de données, faciliter l'analyse et convertir des documents en formats plus accessibles. Que vous traitiez de tableaux simples ou de formats complexes et irréguliers, IronPDF fournit les outils nécessaires pour extraire et traiter efficacement les données tabulaires.
Avec IronPDF, vous pouvez rationaliser des flux de travail comme la saisie automatique de données, la conversion de documents et l'analyse de données. La flexibilité et les fonctionnalités avancées offertes par IronPDF en font un outil précieux pour gérer diverses tâches basées sur les PDF.








