from ironpdf import *

# Instantiate Renderer
renderer = ChromePdfRenderer()

# Create a PDF from a HTML string using Python
pdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>")

# Export to a file or Stream
pdf.SaveAs("output.pdf")

# Advanced Example with HTML Assets
# Load external html assets: Images, CSS and JavaScript.
# An optional BasePath 'C:\site\assets\' is set as the file location to load assets from
myAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", r"C:\site\assets")
myAdvancedPdf.SaveAs("html-with-assets.pdf")
from ironpdf import *# Instantiate Rendererrenderer = ChromePdfRenderer()# Create a PDF from a HTML string using Pythonpdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>")# Export to a file or Streampdf.SaveAs("output.pdf")# Advanced Example with HTML Assets# Load external html assets: Images, CSS and JavaScript.# An optional BasePath 'C:\site\assets\' is set as the file location to load assets frommyAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", r"C:\site\assets")myAdvancedPdf.SaveAs("html-with-assets.pdf")
Cet article va démontrer comment utiliser IronPDF, une bibliothèque de traitement PDF puissante, pour extraire facilement des données de tables complexes dans n'importe quel fichier PDF.
## IronPDF
Python offre beaucoup plus de flexibilité pour les programmeurs comparé à d'autres langages et permet aux développeurs de concevoir facilement et efficacement des interfaces utilisateur graphiques. Par conséquent, l'incorporation de la bibliothèque IronPDF dans Python est un processus simple. Pour créer rapidement et en toute sécurité une interface graphique entièrement fonctionnelle, une gamme d'outils préinstallés, y compris PyQt, wxWidgets, Kivy, et divers autres packages et bibliothèques, peut être utilisée.
IronPDF simplifie la conception et le développement web avec Python. Ceci est principalement dû à l'abondance de frameworks de développement web Python disponibles, tels que Django, Flask, et Pyramid. Quelques sites web et services en ligne remarquables qui ont employé ces frameworks incluent Reddit, Mozilla, et Spotify.
<div class="hsg-featured-snippet">
<h2>Comment extraire un tableau d'un PDF en Python</h2>
<ol>
<li><a class="js-modal-open" data-modal-id="download-modal" href="#download-modal">Téléchargez un module Python pour extraire un tableau d'un PDF</a></li>
<li>Utilisez la méthode <code>FromFile</code> pour importer le fichier PDF</li>
<li>Extrayez le texte des tableaux à l'aide de la méthode <code>ExtractAllText</code></li>
<li>Parcourir le texte extrait pour diviser les lignes</li>
<li>Sortir le texte extrait vers la console ou un fichier texte</li>
</ol>
</div>
## Fonctionnalités d'IronPDF
Voici quelques caractéristiques de [IronPDF](/python/) :
* Les fichiers PDF peuvent être [créés à partir de diverses sources](/python/tutorials/html-to-pdf/) comme HTML, HTML5, ASP, PHP, et plus encore. De plus, [les fichiers image peuvent être convertis en PDF](/python/blog/using-ironpdf-for-python/image-to-pdf-python-tutorial/) avec les fichiers HTML.
* IronPDF permet la création de documents PDF interactifs. Il offre des fonctionnalités telles que diviser et combiner des fichiers PDF, [extraire du texte et des images](/python/blog/using-ironpdf-for-python/extract-data-from-pdf-python-tutorial/) depuis des fichiers PDF, [rasteriser des pages PDF en images](/python/examples/rasterize-a-pdf-to-images/), convertir des PDF en HTML, imprimer des fichiers PDF, remplir et soumettre [des formulaires interactifs](/python/examples/form-data/), et [diviser](/python/blog/using-ironpdf-for-python/split-pdf-python-tutorial/) et [fusionner](/python/how-to/python-merge-pdf/) des fichiers PDF.
* Avec IronPDF, il est possible de générer un document à partir d'une URL. Il prend également en charge les agents utilisateurs se connectant via des formulaires de connexion HTML, des proxys, des cookies, des en-têtes HTTP, des identifiants de connexion réseau spéciaux, des variables de formulaire, et des agents utilisateurs.
* Le programme IronPDF permet l'inspection et [l'annotation](/python/blog/using-ironpdf-for-python/pdf-annotate-python-tutorial/) des fichiers PDF.
* IronPDF permet d'extraire des images de documents.
* IronPDF fournit aux utilisateurs la possibilité d'ajouter des en-têtes, pieds de page, texte, photos, [marque-pages](/python/examples/bookmarks/), [filigranes](/python/blog/using-ironpdf-for-python/python-pdf-watermark-tutorial/), et plus aux documents.
* En utilisant IronPDF, vous pouvez diviser et fusionner des pages dans un document nouveau ou existant.
* La conversion de documents en objets PDF est possible sans avoir besoin d'une visionneuse Acrobat.
* IronPDF permet la création d'un document PDF à partir d'un fichier CSS.
* Les documents peuvent être créés en utilisant des fichiers CSS contenant des définitions de type de média avec IronPDF.
## Configurer l'environnement Python
### Configurer Python
Assurez-vous que Python est installé sur votre ordinateur. Pour télécharger et configurer la version la plus récente de Python pour votre système d'exploitation, rendez-vous sur le [site officiel de Python](https://www.python.org/downloads/). Une fois Python installé, séparez les besoins de votre projet en créant un environnement virtuel. Avec l'aide du module `venv`, vous pouvez créer et gérer des environnements virtuels pour offrir à votre projet de conversion un espace de travail propre et organisé.
### Nouveau projet dans PyCharm
Pour ce tutoriel, il est recommandé d'utiliser PyCharm, un IDE pour le développement en Python.
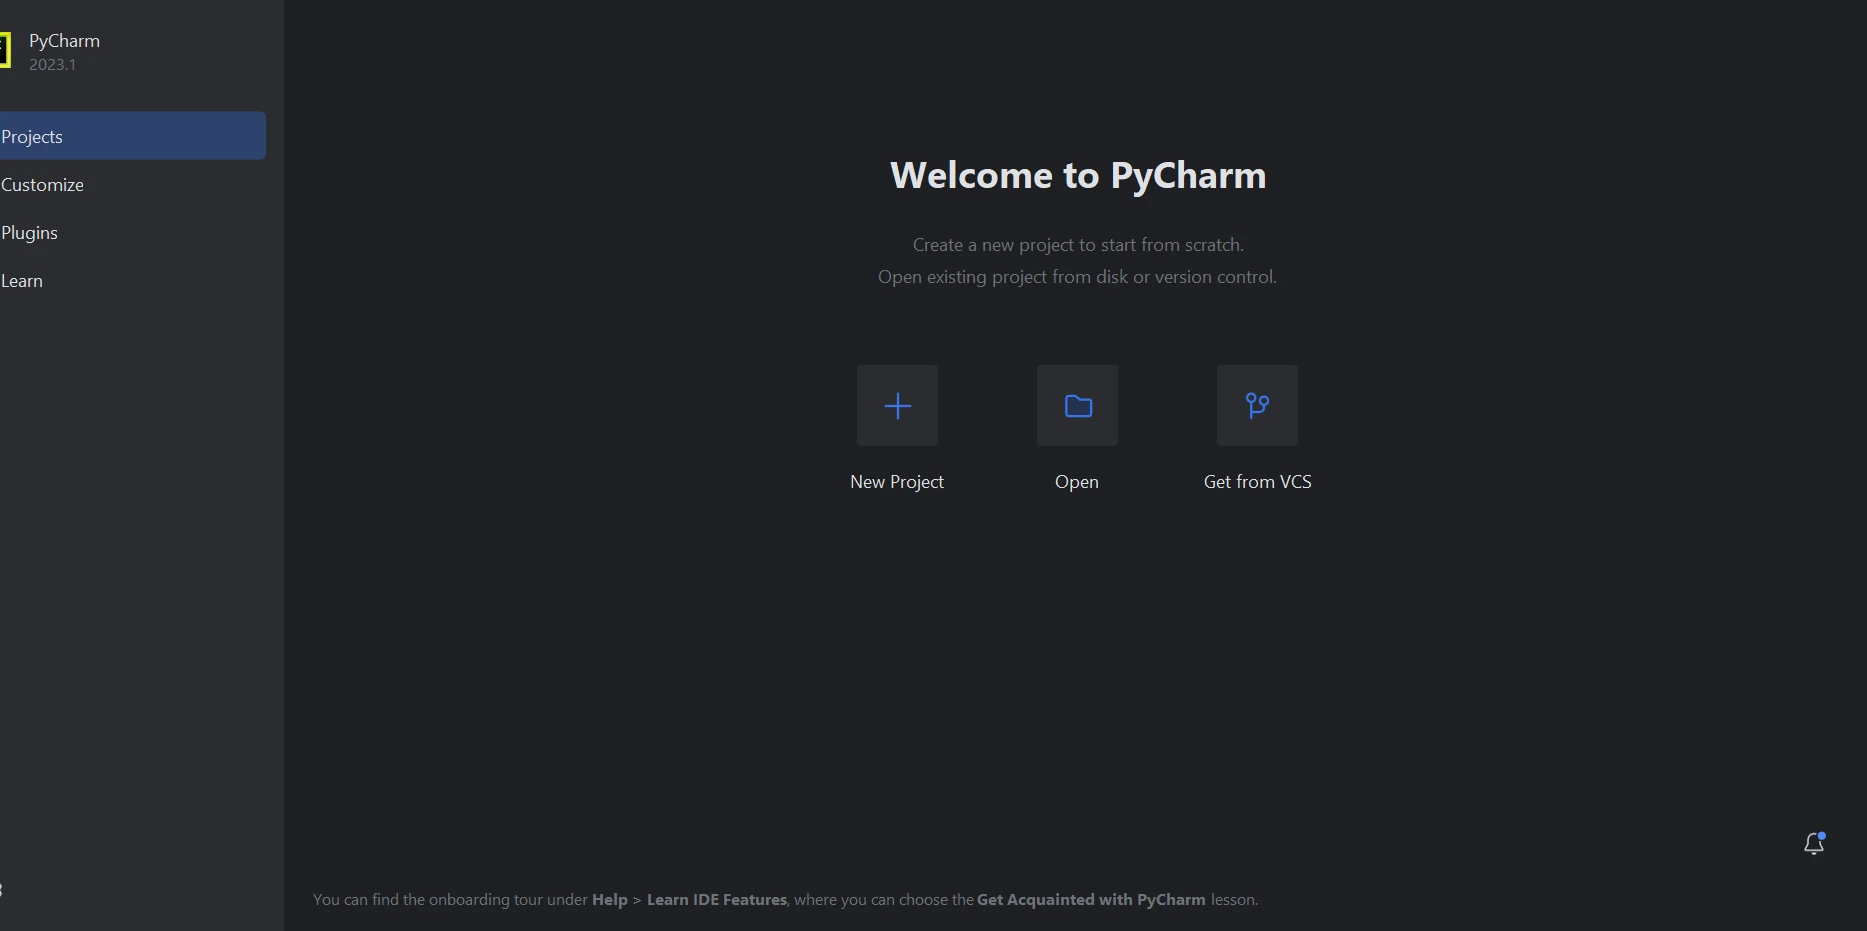
Après avoir lancé l'IDE PyCharm, sélectionnez "Nouveau projet" dans le menu, comme indiqué dans la figure ci-dessous.
**IDE PyCharm**
Comme vu dans l'image ci-dessous, quand vous choisissez "Nouveau projet", une nouvelle fenêtre apparaîtra et vous permettra de définir l'emplacement du projet et l'environnement Python.
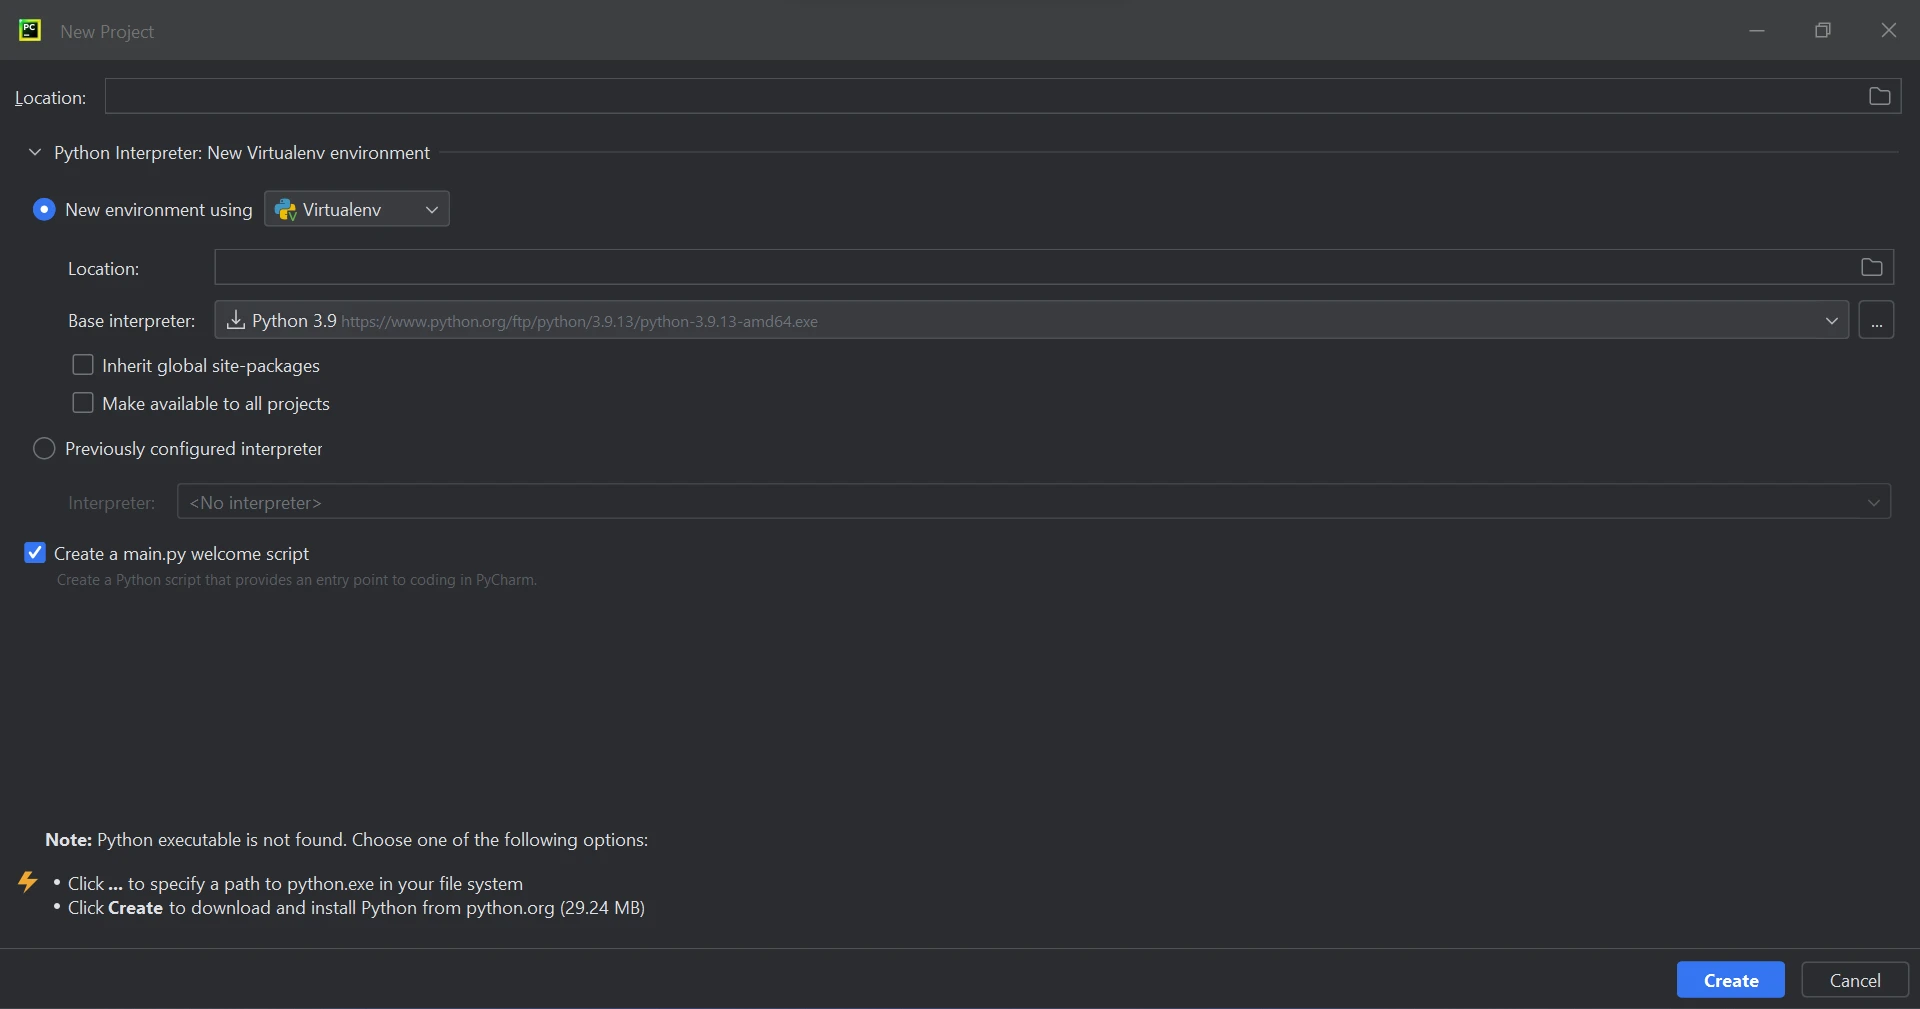
**Créer un nouveau projet dans PyCharm**
Après avoir sélectionné l'emplacement et l'environnement pour le projet, cliquez sur le bouton **Créer** pour l'initier. Les fichiers Python peuvent être ouverts dans la nouvelle fenêtre lancée pour que vous y entriez votre code. Ce guide utilise Python 3.9.
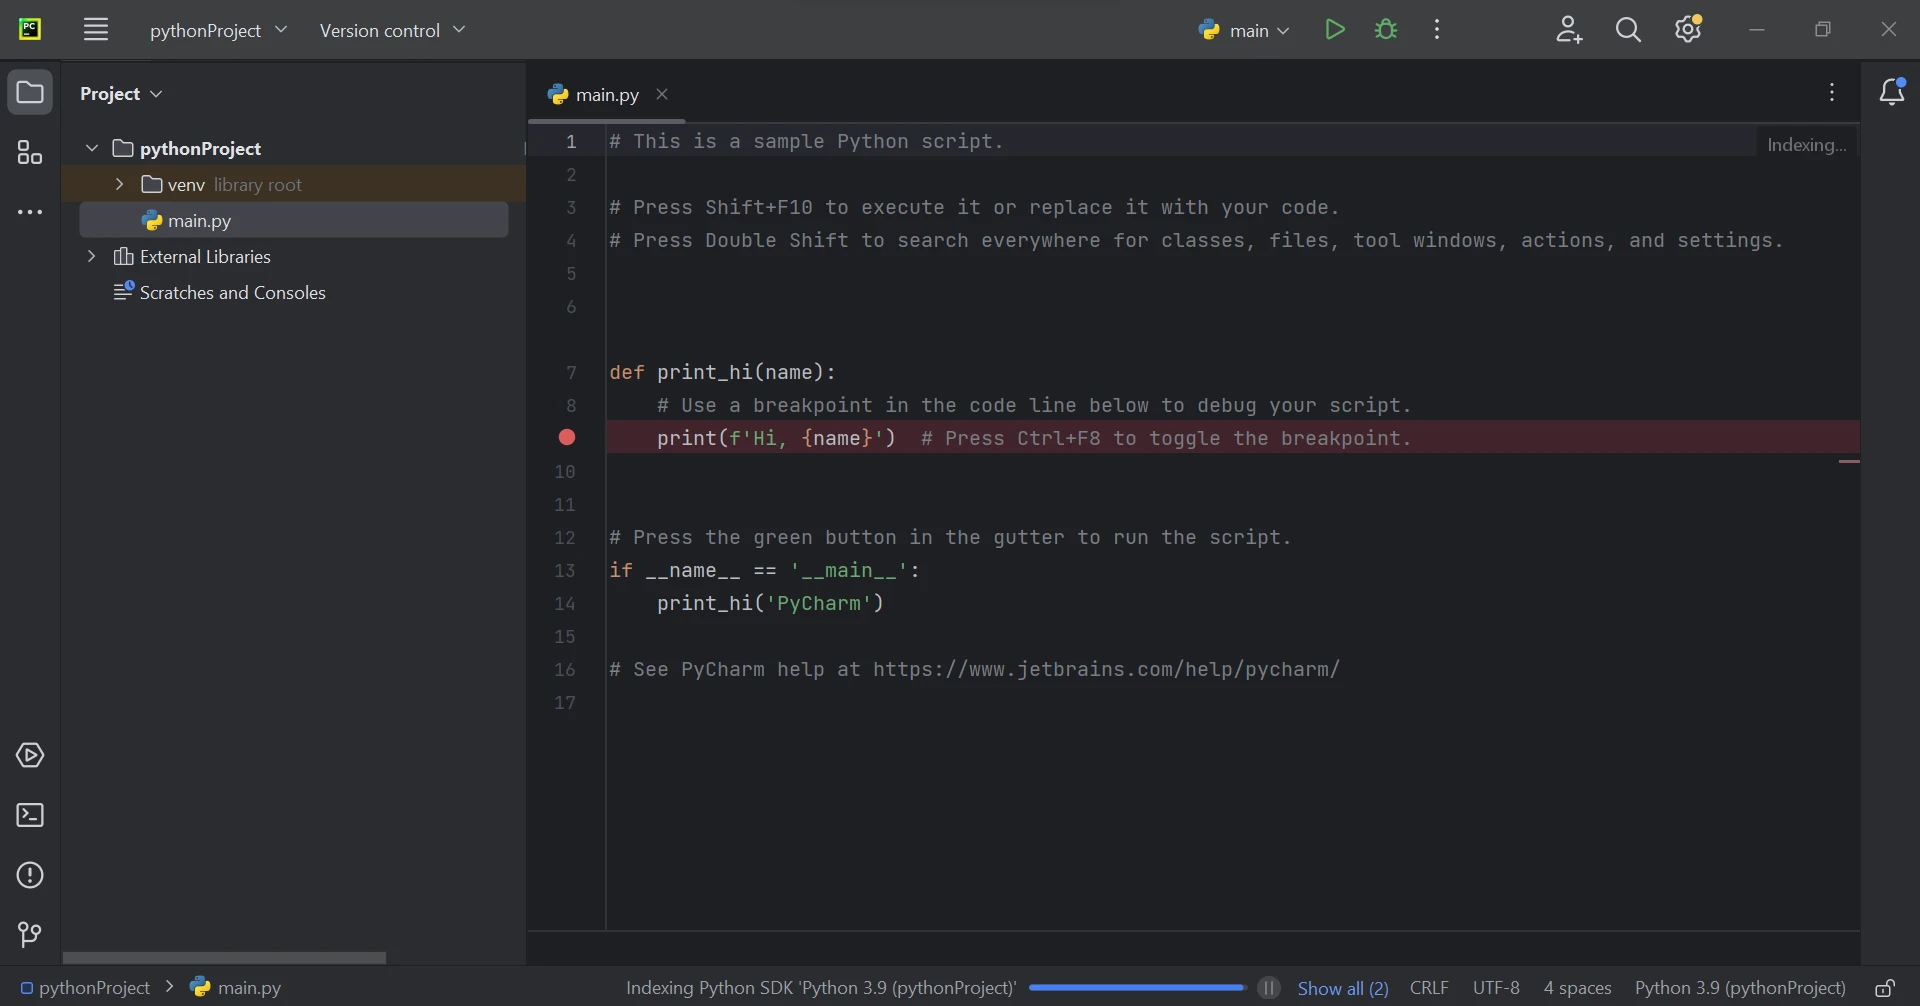
**le fichier Python principal**
### Exigence de la bibliothèque IronPDF
IronPDF for Python s'appuie sur .NET 6.0 comme technologie de base. Par conséquent, pour utiliser IronPDF for Python, votre ordinateur doit avoir le runtime .NET 6.0 installé. Les utilisateurs de Linux et Mac peuvent avoir besoin d'installer .NET avant de pouvoir utiliser ce module Python. [Téléchargez l'environnement d'exécution nécessaire depuis Microsoft](https://dotnet.microsoft.com/en-us/download/dotnet/6.0).
### Configuration de la bibliothèque IronPDF
Le package `ironpdf` doit être installé afin de créer, éditer et ouvrir des fichiers avec l'extension ".pdf". Pour installer le package dans PyCharm, ouvrez une fenêtre de terminal et tapez la commande suivante :
```shell
:ProductInstall
```
La capture d'écran ci-dessous illustre le processus d'installation du package `ironpdf`.
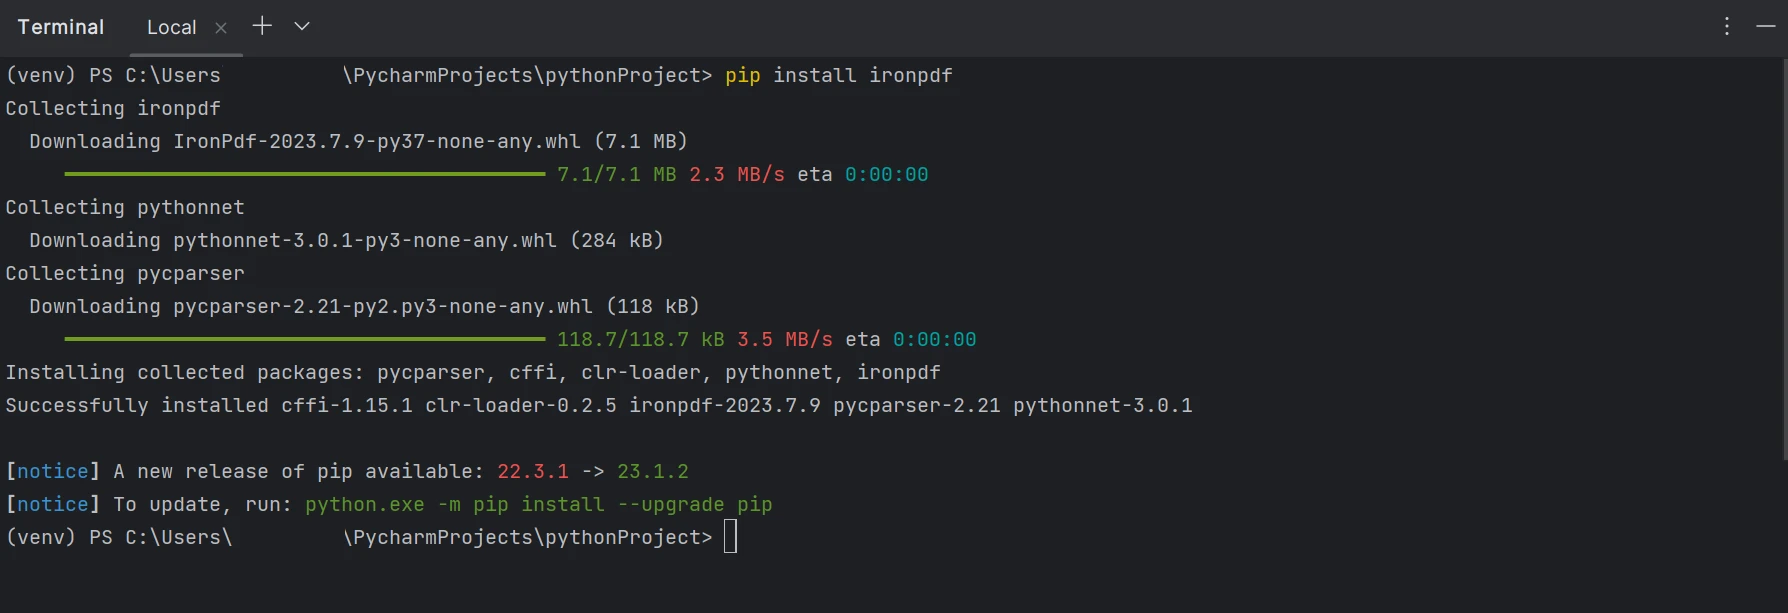
**Installer le package IronPDF**
## Extraction de données de tableau à partir d'un fichier PDF
Nous pouvons extraire facilement des données des fichiers PDF en utilisant la bibliothèque IronPDF for Python. IronPDF facilite l'analyse des données textuelles et l'extraction de tableaux à partir de fichiers PDF. Ci-dessous un exemple de code qui montre comment extraire des données de tableaux PDF, en utilisant l'image fournie comme référence.
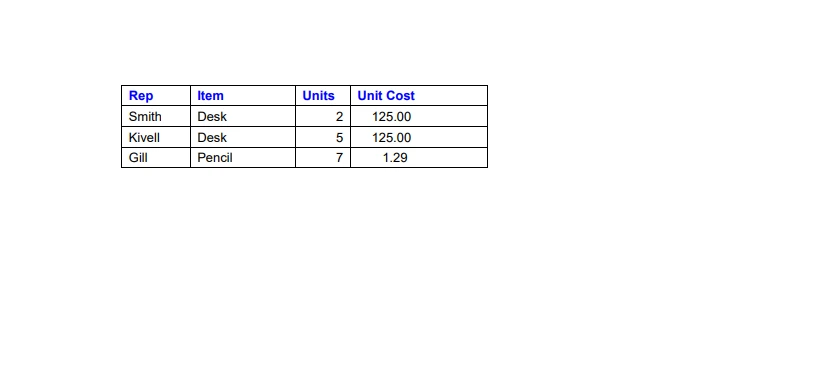
**Les données échantillons d'un fichier PDF**
```python
from ironpdf import PdfDocument

# Load the PDF document
pdf = PdfDocument.FromFile("sampleData.pdf")

# Extract all text from the PDF document
all_text = pdf.ExtractAllText()

# Split the extracted text into rows and print each row
for row in all_text.split("\n"):
    print(row)
```
Le code fourni montre comment IronPDF peut être utilisé pour extraire des tableaux à partir de fichiers PDF à l'aide de quelques lignes de code Python. Initialement, nous importons la bibliothèque IronPDF pour accéder à ses fonctionnalités et pour accéder à toutes les fonctionnalités d'IronPDF. Ensuite, avec l'aide de la classe `PdfDocument`, les fichiers PDF existants peuvent être traités pour effectuer diverses opérations dessus.
Lors de l'utilisation de la fonction `FromFile`, l'argument pour charger le fichier PDF d'entrée est disponible. Ensuite, la fonction `ExtractAllText` extrait toutes les données des tableaux de toutes les pages à l'intérieur des fichiers PDF. Puis, la fonction `split` est utilisée pour diviser les données du tableau extrait en plusieurs lignes et les afficher sur l'écran de la console.
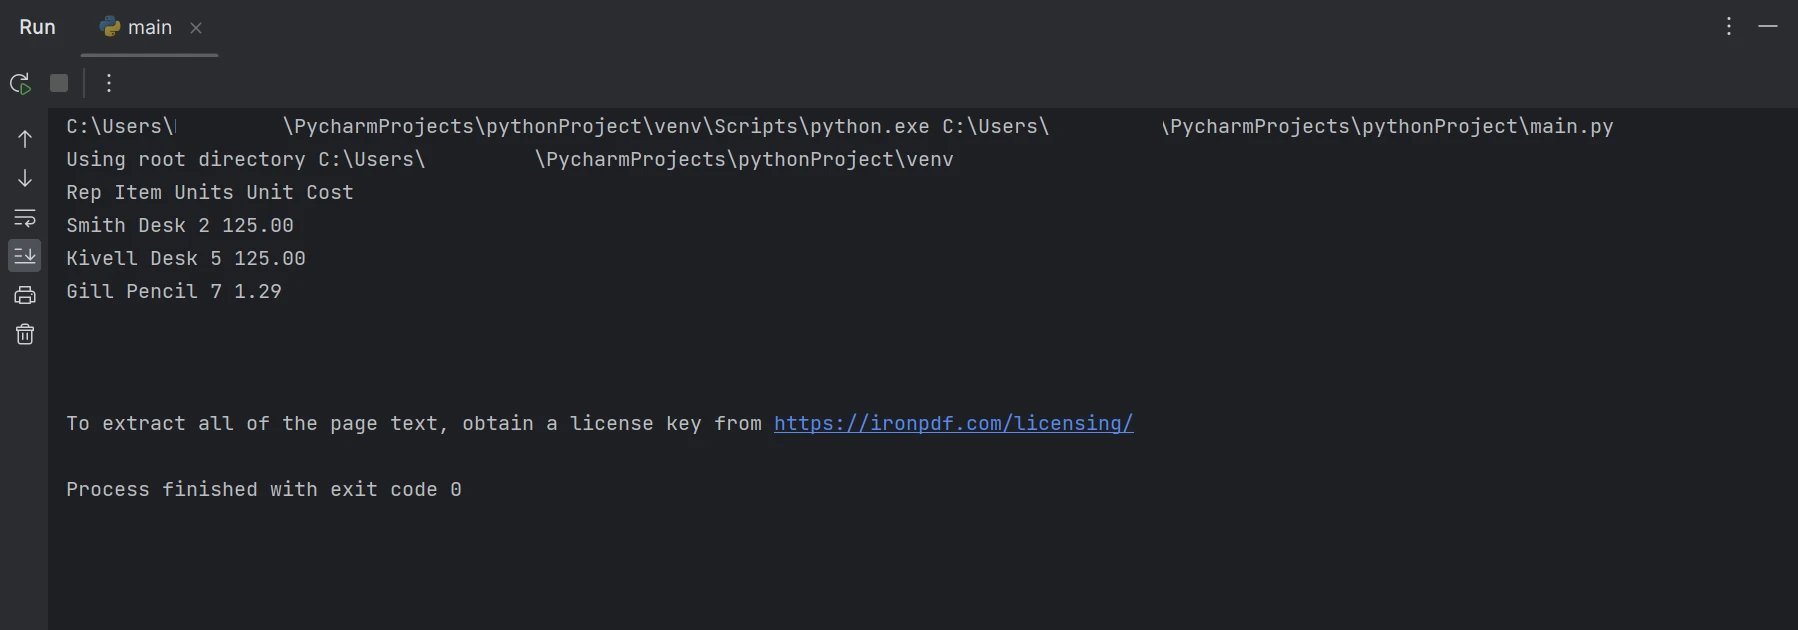
**Les données extraites**
Dans le résultat ci-dessus, les données sont affichées ligne par ligne, montrant comment les données de tableau peuvent être extraites. [En savoir plus sur IronPDF](/python/tutorials/html-to-pdf/) en consultant la [documentation du produit](/python/docs/).
## Conclusion
La bibliothèque IronPDF fournit des mesures de sécurité robustes pour minimiser les risques potentiels et garantir la sécurité des données. Elle est compatible avec tous les navigateurs populaires et n'est pas limitée à un en particulier. Avec IronPDF, les programmeurs peuvent créer et lire efficacement des fichiers PDF à l'aide de quelques lignes de code. Pour répondre aux divers besoins des développeurs, la bibliothèque IronPDF propose différentes options de licence, y compris une licence développeur gratuite et des licences de développement supplémentaires disponibles à l'achat.
Le pack Lite, au prix de `$liteLicense`, comprend une licence perpétuelle, une garantie de remboursement de 30 jours, un an de maintenance logicielle et des possibilités de mise à niveau. Il n'y a pas de frais supplémentaires après l'achat initial, et ces licences peuvent être utilisées dans les environnements de production, de staging, et de développement. IronPDF propose également des licences gratuites avec certaines limitations de temps et de redistribution. Les utilisateurs peuvent tester le produit dans un environnement réel avec une [période d'essai gratuite](trial-license) qui ne comprend pas de filigrane. Pour des informations détaillées concernant le coût et l'octroi de licences de la version d'essai d'IronPDF, cliquez sur la [page des licences](licensing).
Cet article va démontrer comment utiliser IronPDF, une bibliothèque de traitement PDF puissante, pour extraire facilement des données de tables complexes dans n'importe quel fichier PDF.
IronPDF
Python offre beaucoup plus de flexibilité pour les programmeurs comparé à d'autres langages et permet aux développeurs de concevoir facilement et efficacement des interfaces utilisateur graphiques. Par conséquent, l'incorporation de la bibliothèque IronPDF dans Python est un processus simple. Pour créer rapidement et en toute sécurité une interface graphique entièrement fonctionnelle, une gamme d'outils préinstallés, y compris PyQt, wxWidgets, Kivy, et divers autres packages et bibliothèques, peut être utilisée.
IronPDF simplifie la conception et le développement web avec Python. Ceci est principalement dû à l'abondance de frameworks de développement web Python disponibles, tels que Django, Flask, et Pyramid. Quelques sites web et services en ligne remarquables qui ont employé ces frameworks incluent Reddit, Mozilla, et Spotify.
Avec IronPDF, il est possible de générer un document à partir d'une URL. Il prend également en charge les agents utilisateurs se connectant via des formulaires de connexion HTML, des proxys, des cookies, des en-têtes HTTP, des identifiants de connexion réseau spéciaux, des variables de formulaire, et des agents utilisateurs.
Le programme IronPDF permet l'inspection et l'annotation des fichiers PDF.
IronPDF permet d'extraire des images de documents.
IronPDF fournit aux utilisateurs la possibilité d'ajouter des en-têtes, pieds de page, texte, photos, marque-pages, filigranes, et plus aux documents.
En utilisant IronPDF, vous pouvez diviser et fusionner des pages dans un document nouveau ou existant.
La conversion de documents en objets PDF est possible sans avoir besoin d'une visionneuse Acrobat.
IronPDF permet la création d'un document PDF à partir d'un fichier CSS.
Les documents peuvent être créés en utilisant des fichiers CSS contenant des définitions de type de média avec IronPDF.
Configurer l'environnement Python
Configurer Python
Assurez-vous que Python est installé sur votre ordinateur. Pour télécharger et configurer la version la plus récente de Python pour votre système d'exploitation, rendez-vous sur le site officiel de Python. Une fois Python installé, séparez les besoins de votre projet en créant un environnement virtuel. Avec l'aide du module venv, vous pouvez créer et gérer des environnements virtuels pour offrir à votre projet de conversion un espace de travail propre et organisé.
Nouveau projet dans PyCharm
Pour ce tutoriel, il est recommandé d'utiliser PyCharm, un IDE pour le développement en Python.
Après avoir lancé l'IDE PyCharm, sélectionnez "Nouveau projet" dans le menu, comme indiqué dans la figure ci-dessous.
IDE PyCharm
Comme vu dans l'image ci-dessous, quand vous choisissez "Nouveau projet", une nouvelle fenêtre apparaîtra et vous permettra de définir l'emplacement du projet et l'environnement Python.
Créer un nouveau projet dans PyCharm
Après avoir sélectionné l'emplacement et l'environnement pour le projet, cliquez sur le bouton Créer pour l'initier. Les fichiers Python peuvent être ouverts dans la nouvelle fenêtre lancée pour que vous y entriez votre code. Ce guide utilise Python 3.9.
le fichier Python principal
Exigence de la bibliothèque IronPDF
IronPDF for Python s'appuie sur .NET 6.0 comme technologie de base. Par conséquent, pour utiliser IronPDF for Python, votre ordinateur doit avoir le runtime .NET 6.0 installé. Les utilisateurs de Linux et Mac peuvent avoir besoin d'installer .NET avant de pouvoir utiliser ce module Python. Téléchargez l'environnement d'exécution nécessaire depuis Microsoft.
Configuration de la bibliothèque IronPDF
Le package ironpdf doit être installé afin de créer, éditer et ouvrir des fichiers avec l'extension ".pdf". Pour installer le package dans PyCharm, ouvrez une fenêtre de terminal et tapez la commande suivante :
> pip install ironpdf
pip install ironpdf
La capture d'écran ci-dessous illustre le processus d'installation du package ironpdf.
Installer le package IronPDF
Extraction de données de tableau à partir d'un fichier PDF
Nous pouvons extraire facilement des données des fichiers PDF en utilisant la bibliothèque IronPDF for Python. IronPDF facilite l'analyse des données textuelles et l'extraction de tableaux à partir de fichiers PDF. Ci-dessous un exemple de code qui montre comment extraire des données de tableaux PDF, en utilisant l'image fournie comme référence.
Les données échantillons d'un fichier PDF
from ironpdf importPdfDocument# Load the PDF documentpdf = PdfDocument.FromFile("sampleData.pdf")# Extract all text from the PDF documentall_text = pdf.ExtractAllText()# Split the extracted text into rows and print each rowfor row in all_text.split("\n"): print(row)
from ironpdf import PdfDocument

# Load the PDF document
pdf = PdfDocument.FromFile("sampleData.pdf")

# Extract all text from the PDF document
all_text = pdf.ExtractAllText()

# Split the extracted text into rows and print each row
for row in all_text.split("\n"):
    print(row)
Python
Le code fourni montre comment IronPDF peut être utilisé pour extraire des tableaux à partir de fichiers PDF à l'aide de quelques lignes de code Python. Initialement, nous importons la bibliothèque IronPDF pour accéder à ses fonctionnalités et pour accéder à toutes les fonctionnalités d'IronPDF. Ensuite, avec l'aide de la classe PdfDocument, les fichiers PDF existants peuvent être traités pour effectuer diverses opérations dessus.
Lors de l'utilisation de la fonction FromFile, l'argument pour charger le fichier PDF d'entrée est disponible. Ensuite, la fonction ExtractAllText extrait toutes les données des tableaux de toutes les pages à l'intérieur des fichiers PDF. Puis, la fonction split est utilisée pour diviser les données du tableau extrait en plusieurs lignes et les afficher sur l'écran de la console.
Les données extraites
Dans le résultat ci-dessus, les données sont affichées ligne par ligne, montrant comment les données de tableau peuvent être extraites. En savoir plus sur IronPDF en consultant la documentation du produit.
Conclusion
La bibliothèque IronPDF fournit des mesures de sécurité robustes pour minimiser les risques potentiels et garantir la sécurité des données. Elle est compatible avec tous les navigateurs populaires et n'est pas limitée à un en particulier. Avec IronPDF, les programmeurs peuvent créer et lire efficacement des fichiers PDF à l'aide de quelques lignes de code. Pour répondre aux divers besoins des développeurs, la bibliothèque IronPDF propose différentes options de licence, y compris une licence développeur gratuite et des licences de développement supplémentaires disponibles à l'achat.
Le pack Lite, au prix de $999, comprend une licence perpétuelle, une garantie de remboursement de 30 jours, un an de maintenance logicielle et des possibilités de mise à niveau. Il n'y a pas de frais supplémentaires après l'achat initial, et ces licences peuvent être utilisées dans les environnements de production, de staging, et de développement. IronPDF propose également des licences gratuites avec certaines limitations de temps et de redistribution. Les utilisateurs peuvent tester le produit dans un environnement réel avec une période d'essai gratuite qui ne comprend pas de filigrane. Pour des informations détaillées concernant le coût et l'octroi de licences de la version d'essai d'IronPDF, cliquez sur la page des licences.
Curtis Chau détient un baccalauréat en informatique (Université de Carleton) et se spécialise dans le développement front-end avec expertise en Node.js, TypeScript, JavaScript et React. Passionné par la création d'interfaces utilisateur intuitives et esthétiquement plaisantes, Curtis aime travailler avec des frameworks modernes et créer des manuels bien structurés et visuellement attrayants.


 IDE PyCharm
 Créer un nouveau projet dans PyCharm
 le fichier Python principal
 Installer le package IronPDF
 Les données échantillons d'un fichier PDF
 Les données extraites