from ironpdf import *

# Instantiate Renderer
renderer = ChromePdfRenderer()

# Create a PDF from a HTML string using Python
pdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>")

# Export to a file or Stream
pdf.SaveAs("output.pdf")

# Advanced Example with HTML Assets
# Load external html assets: Images, CSS and JavaScript.
# An optional BasePath 'C:\site\assets\' is set as the file location to load assets from
myAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", r"C:\site\assets")
myAdvancedPdf.SaveAs("html-with-assets.pdf")
from ironpdf import *# Instantiate Rendererrenderer = ChromePdfRenderer()# Create a PDF from a HTML string using Pythonpdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>")# Export to a file or Streampdf.SaveAs("output.pdf")# Advanced Example with HTML Assets# Load external html assets: Images, CSS and JavaScript.# An optional BasePath 'C:\site\assets\' is set as the file location to load assets frommyAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", r"C:\site\assets")myAdvancedPdf.SaveAs("html-with-assets.pdf")
Cet article explorera comment visualiser des fichiers PDF en Python en utilisant la bibliothèque IronPDF.
## IronPDF - Bibliothèque Python
[IronPDF](/python/) est une bibliothèque Python puissante qui permet aux développeurs de travailler avec des fichiers PDF de manière programmatique. Avec IronPDF, vous pouvez facilement générer, manipuler et extraire des données de documents PDF, ce qui en fait un outil polyvalent pour diverses tâches liées aux PDF. Que vous ayez besoin de créer des PDFs à partir de zéro, de modifier des PDFs existants ou d'extraire du contenu de PDFs, IronPDF offre un ensemble complet de fonctionnalités pour simplifier votre flux de travail.
Certaines fonctionnalités de la bibliothèque IronPDF for Python incluent :
- [Créer un nouveau fichier PDF](/python/tutorials/html-to-pdf/) à partir de zéro, en utilisant HTML ou une URL
- Modifier des fichiers PDF existants
- Faire pivoter les pages PDF
- [Extraire du texte](/python/blog/using-ironpdf-for-python/extract-data-from-pdf-python-tutorial/), les métadonnées et les images des fichiers PDF
- Convertir des fichiers PDF en d'autres formats
- [Sécuriser les fichiers PDF](/python/examples/security-and-metadata/) avec des mots de passe et des restrictions
- [Diviser](/python/blog/using-ironpdf-for-python/split-pdf-python-tutorial/) et [fusionner](/python/how-to/python-merge-pdf/) des PDFs
**Note :** IronPDF produit un fichier de données PDF avec filigrane. Pour supprimer le filigrane, vous devez licencier IronPDF. Si vous souhaitez utiliser une version licenciée d'IronPDF, visitez le [site web d'IronPDF](/python/) pour [obtenir une clé de licence](trial-license).
## Prérequis
Avant de travailler avec IronPDF en Python, il y a quelques prérequis :
1. **Installation de Python :** assurez-vous d'avoir Python installé sur votre système. IronPDF est compatible avec les versions Python 3.x, assurez-vous donc d'avoir une installation de Python compatible.
2. **Bibliothèque IronPDF :** Installez la bibliothèque IronPDF pour accéder à ses fonctionnalités. Vous pouvez l'installer en utilisant le Package Manager Python (**pip**) en exécutant la commande suivante dans votre interface de ligne de commande :
```bash
:ProductInstall
```
3. **Bibliothèque Tkinter :** Tkinter est la boîte à outils GUI standard for Python. Il est utilisé pour créer l'interface graphique utilisateur pour le visualiseur PDF dans le morceau de code fourni. Tkinter est généralement préinstallé avec Python, mais si vous rencontrez des problèmes, vous pouvez l'installer en utilisant le Package Manager :
```bash
pip install tkinter
```
4. **Bibliothèque Pillow :** La bibliothèque Pillow est une version dérivée de la bibliothèque d'imagerie Python (PIL) et fournit des capacités de traitement d'images supplémentaires. Elle est utilisée dans le morceau de code pour charger et afficher les images extraites du PDF. Installez Pillow en utilisant le Package Manager :
```bash
pip install pillow
```
5. **Environnement de développement intégré (IDE) :** L'utilisation d'un IDE pour gérer des projets Python peut grandement améliorer votre expérience de développement. Il offre des fonctionnalités comme l'autocomplétion de code, le débogage et un flux de travail plus rationalisé. Un IDE populaire pour le développement Python est PyCharm. Vous pouvez télécharger et installer PyCharm depuis le site web de JetBrains ([**https://www.jetbrains.com/pycharm/**](https://www.jetbrains.com/pycharm/)).
6. **Éditeur de texte :** Sinon, si vous préférez travailler avec un éditeur de texte léger, vous pouvez utiliser n'importe quel éditeur de texte de votre choix, tel que Visual Studio Code, Sublime Text ou Atom. Ces éditeurs offrent la coloration syntaxique et d'autres fonctionnalités utiles pour le développement Python. Vous pouvez également utiliser l'Application IDE propre à Python pour créer des scripts Python.
## Créer un projet de visualiseur PDF en utilisant PyCharm
Après avoir installé l'IDE PyCharm, créez un projet Python PyCharm en suivant les étapes ci-dessous :
1. **Lancer PyCharm :** Ouvrez PyCharm depuis le lanceur d'application de votre système ou depuis le raccourci du bureau.
2. **Créer un Nouveau Projet :** Cliquez sur "Create New Project" ou ouvrez un projet Python existant.
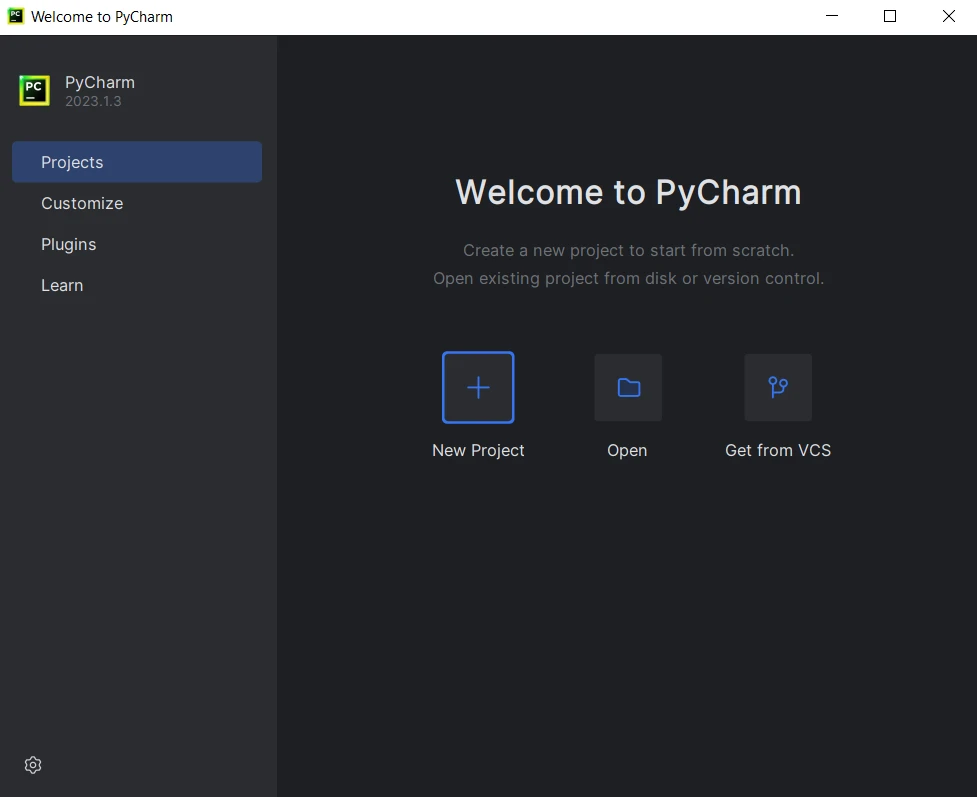
**PyCharm IDE**
3. **Configurer les Paramètres de Projet :** Fournissez un nom à votre projet et choisissez l'emplacement pour créer le répertoire du projet. Sélectionnez l'interpréteur Python pour votre projet. Puis cliquez sur "Create".
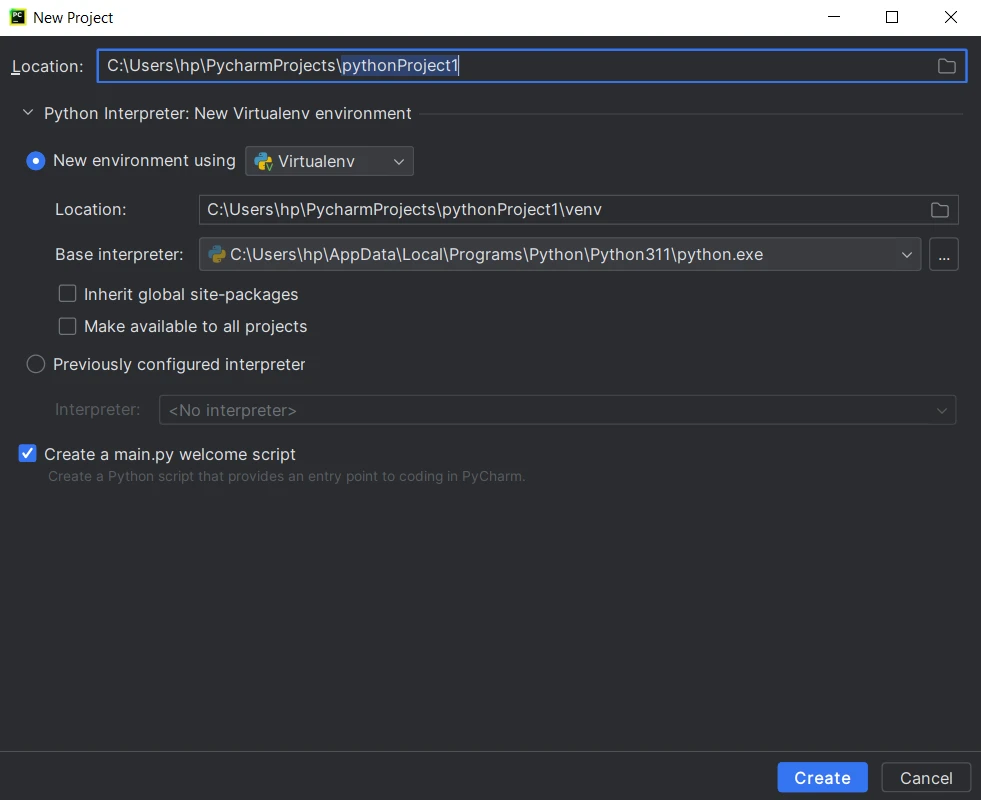
**Créer un nouveau projet Python**
4. **Créer des Fichiers Source :** PyCharm créera la structure du projet, y compris un fichier Python principal et un répertoire pour les fichiers sources additionnels. Commencez à écrire du code et cliquez sur le bouton d'exécution ou appuyez sur Shift+F10 pour exécuter le script.
## Étapes pour visualiser des fichiers PDF en Python avec IronPDF
### Importer les bibliothèques requises
Pour commencer, importez les bibliothèques nécessaires. Dans ce cas, les bibliothèques `os`, `shutil`, `ironpdf`, `tkinter`, et `PIL` seront nécessaires. Les bibliothèques `os` et `shutil` sont utilisées pour les opérations sur les fichiers et dossiers, `ironpdf` est la bibliothèque pour travailler avec les fichiers PDF, `tkinter` est utilisée pour créer l'interface graphique (GUI), et PIL est utilisé pour la manipulation d'images.
```python
import os
import shutil
import ironpdf
from tkinter import *
from PIL import Image, ImageTk
```
### Convertir le document PDF en images
Ensuite, définissez une fonction appelée `convert_pdf_to_images`. Cette fonction prend le chemin du fichier PDF en entrée. À l'intérieur de la fonction, la bibliothèque IronPDF est utilisée pour charger le document PDF à partir du fichier. Ensuite, spécifiez un chemin de dossier pour stocker les fichiers d'images extraits. La méthode `pdf.RasterizeToImageFiles` d'IronPDF est utilisée pour convertir chaque page du PDF en fichier image et la sauvegarder dans le dossier spécifié. Une liste est utilisée pour stocker les chemins des images. L'exemple de code complet est le suivant :
```python
def convert_pdf_to_images(pdf_file):
"""Convert each page of a PDF file to an image."""
pdf = ironpdf.PdfDocument.FromFile(pdf_file)
# Extract all pages to a folder as image files
folder_path = "images"
pdf.RasterizeToImageFiles(os.path.join(folder_path, "*.png"))
# List to store the image paths
image_paths = []
# Get the list of image files in the folder
for filename in os.listdir(folder_path):
if filename.lower().endswith((".png", ".jpg", ".jpeg", ".gif")):
image_paths.append(os.path.join(folder_path, filename))
return image_paths
```
Pour extraire le texte des documents PDF, visitez cette [page d'exemples de code](/python/examples/extract-pdf-text/).
### Gérer la fermeture de la fenêtre
Pour nettoyer les fichiers image extraits lorsque la fenêtre de l'application est fermée, définissez une fonction `on_closing`. À l'intérieur de cette fonction, utilisez la méthode `shutil.rmtree()` pour supprimer le dossier `images` en entier. Ensuite, définissez cette fonction comme le protocole à exécuter lorsque la fenêtre est fermée. Le code suivant aide à réaliser la tâche :
```python
def on_closing():
"""Handle the window closing event by cleaning up the images."""
# Delete the images in the 'images' folder
shutil.rmtree("images")
window.destroy()
window.protocol("WM_DELETE_WINDOW", on_closing)
```
### Créer la fenêtre GUI
Maintenant, créons la fenêtre principale de l'interface graphique à l'aide du constructeur `Tk()`, définissez le titre de la fenêtre sur " Visualiseur d'images ", et définissez la fonction `on_closing()` comme protocole pour gérer la fermeture de la fenêtre.
```python
window = Tk()
window.title("Image Viewer")
window.protocol("WM_DELETE_WINDOW", on_closing)
```
### Créer un canevas défilable
Pour afficher les images et activer le défilement, créez un widget `Canvas`. Le widget `Canvas` est configuré pour remplir l'espace disponible et s'étendre dans les deux directions en utilisant `pack(side=LEFT, fill=BOTH, expand=True)`. De plus, créez un widget `Scrollbar` et configurez-le pour contrôler le défilement vertical de toutes les pages et du canvas.
```python
canvas = Canvas(window)
canvas.pack(side=LEFT, fill=BOTH, expand=True)
scrollbar = Scrollbar(window, command=canvas.yview)
scrollbar.pack(side=RIGHT, fill=Y)
canvas.configure(yscrollcommand=scrollbar.set)
# Update the scrollregion to encompass the entire canvas
canvas.bind("<Configure>", lambda e: canvas.configure(
scrollregion=canvas.bbox("all")))
# Configure the vertical scrolling using mouse wheel
canvas.bind_all("<MouseWheel>", lambda e: canvas.yview_scroll(
int(-1*(e.delta/120)), "units"))
```
### Créer un cadre pour les images
Ensuite, créez un widget `Frame` à l'intérieur du canvas pour contenir les images en utilisant `create_window()` pour placer le cadre dans le canvas. Les coordonnées `(0, 0)` et le paramètre `anchor='nw'` garantissent que le cadre commence dans le coin supérieur gauche du canvas.
```python
frame = Frame(canvas)
canvas.create_window((0, 0), window=frame, anchor="nw")
```
### Convertir le fichier PDF en images et les afficher
L'étape suivante consiste à appeler la fonction `convert_pdf_to_images()` avec le nom du fichier chemin de l'entrée du fichier PDF. Cette fonction extrait les pages PDF en tant qu'images et retourne une liste de chemins d'images. En itérant à travers les chemins d'images et en chargeant chaque image en utilisant la méthode `Image.open()` de la bibliothèque PIL, un objet `PhotoImage` est créé en utilisant `ImageTk.PhotoImage()`. Ensuite, créez un widget `Label` pour afficher l'image.
```python
images = convert_pdf_to_images("input.pdf")
# Load and display the images in the Frame
for image_path in images:
image = Image.open(image_path)
photo = ImageTk.PhotoImage(image)
label = Label(frame, image=photo)
label.image = photo # Store a reference to prevent garbage collection
label.pack(pady=10)
```
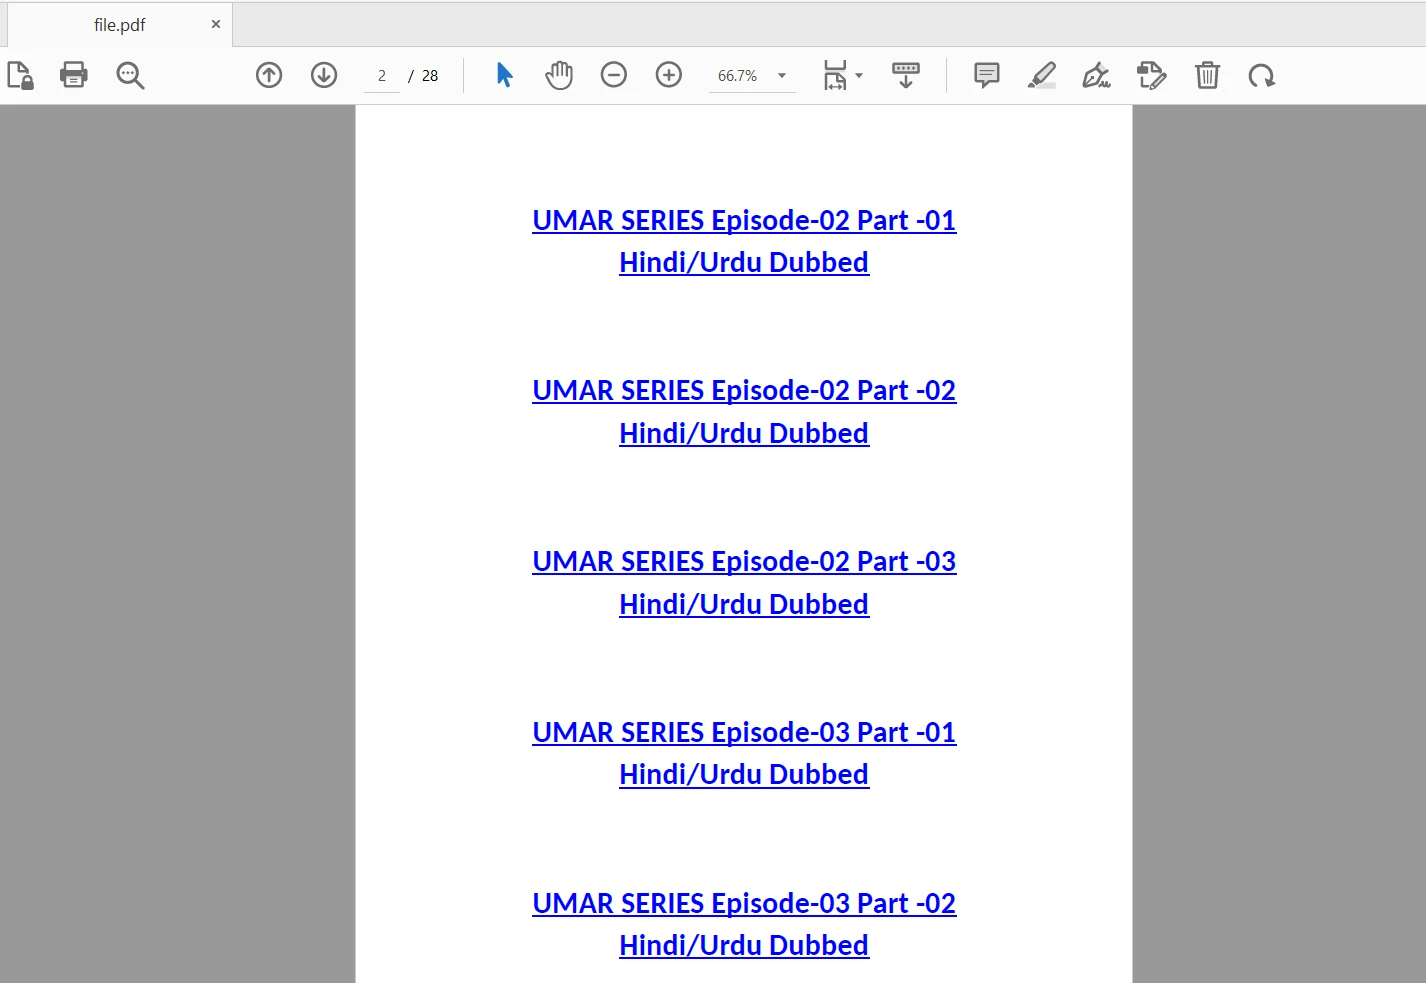
**Le fichier d'entrée**
### Exécuter la boucle principale de la GUI
Enfin, exécutons la boucle d'événements principale en utilisant `window.mainloop()`. Cela garantit que la fenêtre de la GUI reste ouverte et réactive jusqu'à ce qu'elle soit fermée par l'utilisateur.
```python
window.mainloop()
```
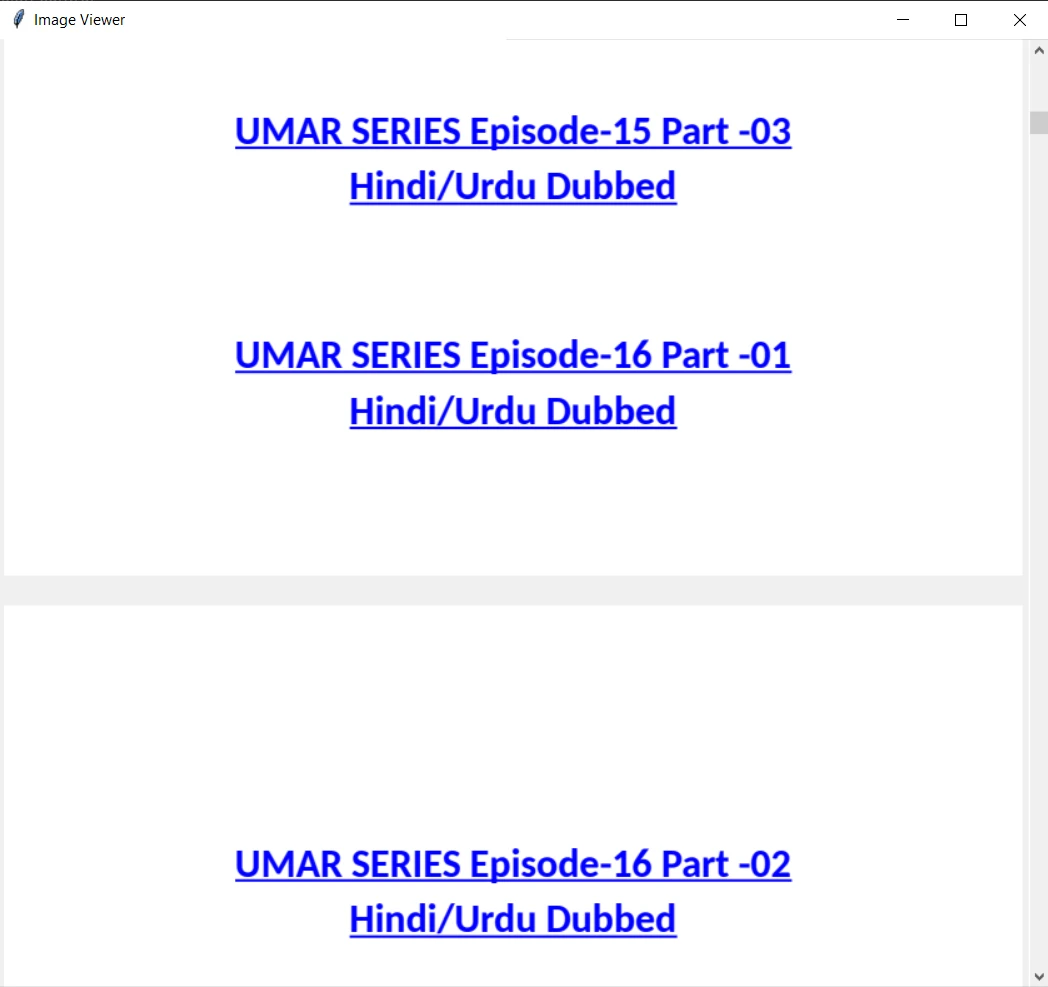
**La sortie de l'UI**
## Conclusion
Ce tutoriel a exploré comment visualiser des documents PDF en Python en utilisant la bibliothèque [IronPDF](/python/). Il a couvert les étapes nécessaires pour ouvrir un fichier PDF et le convertir en une série de fichiers image, puis les afficher dans un canevas défilable, et gérer le nettoyage des images extraites lorsque l'application est fermée.
Pour plus de détails sur la bibliothèque IronPDF for Python, veuillez vous référer à la [documentation](/python/docs/).
Téléchargez et installez la bibliothèque [IronPDF for Python](/python/) et obtenez également un [essai gratuit](trial-license) pour tester sa fonctionnalité complète dans un développement commercial.
Cet article explorera comment visualiser des fichiers PDF en Python en utilisant la bibliothèque IronPDF.
IronPDF - Bibliothèque Python
IronPDF est une bibliothèque Python puissante qui permet aux développeurs de travailler avec des fichiers PDF de manière programmatique. Avec IronPDF, vous pouvez facilement générer, manipuler et extraire des données de documents PDF, ce qui en fait un outil polyvalent pour diverses tâches liées aux PDF. Que vous ayez besoin de créer des PDFs à partir de zéro, de modifier des PDFs existants ou d'extraire du contenu de PDFs, IronPDF offre un ensemble complet de fonctionnalités pour simplifier votre flux de travail.
Certaines fonctionnalités de la bibliothèque IronPDF for Python incluent :
Note : IronPDF produit un fichier de données PDF avec filigrane. Pour supprimer le filigrane, vous devez licencier IronPDF. Si vous souhaitez utiliser une version licenciée d'IronPDF, visitez le site web d'IronPDF pour obtenir une clé de licence.
Prérequis
Avant de travailler avec IronPDF en Python, il y a quelques prérequis :
Installation de Python : assurez-vous d'avoir Python installé sur votre système. IronPDF est compatible avec les versions Python 3.x, assurez-vous donc d'avoir une installation de Python compatible.
Bibliothèque IronPDF : Installez la bibliothèque IronPDF pour accéder à ses fonctionnalités. Vous pouvez l'installer en utilisant le Package Manager Python (pip) en exécutant la commande suivante dans votre interface de ligne de commande :
> pip install ironpdf
pip install ironpdf
Bibliothèque Tkinter : Tkinter est la boîte à outils GUI standard for Python. Il est utilisé pour créer l'interface graphique utilisateur pour le visualiseur PDF dans le morceau de code fourni. Tkinter est généralement préinstallé avec Python, mais si vous rencontrez des problèmes, vous pouvez l'installer en utilisant le Package Manager :
pip install tkinter
pip install tkinter
SHELL
Bibliothèque Pillow : La bibliothèque Pillow est une version dérivée de la bibliothèque d'imagerie Python (PIL) et fournit des capacités de traitement d'images supplémentaires. Elle est utilisée dans le morceau de code pour charger et afficher les images extraites du PDF. Installez Pillow en utilisant le Package Manager :
pip install pillow
pip install pillow
SHELL
Environnement de développement intégré (IDE) : L'utilisation d'un IDE pour gérer des projets Python peut grandement améliorer votre expérience de développement. Il offre des fonctionnalités comme l'autocomplétion de code, le débogage et un flux de travail plus rationalisé. Un IDE populaire pour le développement Python est PyCharm. Vous pouvez télécharger et installer PyCharm depuis le site web de JetBrains (https://www.jetbrains.com/pycharm/).
Éditeur de texte : Sinon, si vous préférez travailler avec un éditeur de texte léger, vous pouvez utiliser n'importe quel éditeur de texte de votre choix, tel que Visual Studio Code, Sublime Text ou Atom. Ces éditeurs offrent la coloration syntaxique et d'autres fonctionnalités utiles pour le développement Python. Vous pouvez également utiliser l'Application IDE propre à Python pour créer des scripts Python.
Créer un projet de visualiseur PDF en utilisant PyCharm
Après avoir installé l'IDE PyCharm, créez un projet Python PyCharm en suivant les étapes ci-dessous :
Lancer PyCharm : Ouvrez PyCharm depuis le lanceur d'application de votre système ou depuis le raccourci du bureau.
Créer un Nouveau Projet : Cliquez sur "Create New Project" ou ouvrez un projet Python existant.
PyCharm IDE
Configurer les Paramètres de Projet : Fournissez un nom à votre projet et choisissez l'emplacement pour créer le répertoire du projet. Sélectionnez l'interpréteur Python pour votre projet. Puis cliquez sur "Create".
Créer un nouveau projet Python
Créer des Fichiers Source : PyCharm créera la structure du projet, y compris un fichier Python principal et un répertoire pour les fichiers sources additionnels. Commencez à écrire du code et cliquez sur le bouton d'exécution ou appuyez sur Shift+F10 pour exécuter le script.
Étapes pour visualiser des fichiers PDF en Python avec IronPDF
Importer les bibliothèques requises
Pour commencer, importez les bibliothèques nécessaires. Dans ce cas, les bibliothèques os, shutil, ironpdf, tkinter, et PIL seront nécessaires. Les bibliothèques os et shutil sont utilisées pour les opérations sur les fichiers et dossiers, ironpdf est la bibliothèque pour travailler avec les fichiers PDF, tkinter est utilisée pour créer l'interface graphique (GUI), et PIL est utilisé pour la manipulation d'images.
import os
import shutil
import ironpdf
from tkinter import *
from PIL import Image, ImageTk
Python
Convertir le document PDF en images
Ensuite, définissez une fonction appelée convert_pdf_to_images. Cette fonction prend le chemin du fichier PDF en entrée. À l'intérieur de la fonction, la bibliothèque IronPDF est utilisée pour charger le document PDF à partir du fichier. Ensuite, spécifiez un chemin de dossier pour stocker les fichiers d'images extraits. La méthode pdf.RasterizeToImageFiles d'IronPDF est utilisée pour convertir chaque page du PDF en fichier image et la sauvegarder dans le dossier spécifié. Une liste est utilisée pour stocker les chemins des images. L'exemple de code complet est le suivant :
def convert_pdf_to_images(pdf_file):
    """Convert each page of a PDF file to an image."""
    pdf = ironpdf.PdfDocument.FromFile(pdf_file)
    # Extract all pages to a folder as image files
    folder_path = "images"
    pdf.RasterizeToImageFiles(os.path.join(folder_path, "*.png"))
    # List to store the image paths
    image_paths = []
    # Get the list of image files in the folder
    for filename in os.listdir(folder_path):
        if filename.lower().endswith((".png", ".jpg", ".jpeg", ".gif")):
            image_paths.append(os.path.join(folder_path, filename))
    return image_paths
def convert_pdf_to_images(pdf_file):
    """Convert each page of a PDF file to an image."""
    pdf = ironpdf.PdfDocument.FromFile(pdf_file)
    # Extract all pages to a folder as image files
    folder_path = "images"
    pdf.RasterizeToImageFiles(os.path.join(folder_path, "*.png"))
    # List to store the image paths
    image_paths = []
    # Get the list of image files in the folder
    for filename in os.listdir(folder_path):
        if filename.lower().endswith((".png", ".jpg", ".jpeg", ".gif")):
            image_paths.append(os.path.join(folder_path, filename))
    return image_paths
Pour nettoyer les fichiers image extraits lorsque la fenêtre de l'application est fermée, définissez une fonction on_closing. À l'intérieur de cette fonction, utilisez la méthode shutil.rmtree() pour supprimer le dossier images en entier. Ensuite, définissez cette fonction comme le protocole à exécuter lorsque la fenêtre est fermée. Le code suivant aide à réaliser la tâche :
def on_closing(): """Handle the window closing event by cleaning up the images.""" # Delete the images in the 'images' folder shutil.rmtree("images") window.destroy()window.protocol("WM_DELETE_WINDOW", on_closing)
def on_closing():
    """Handle the window closing event by cleaning up the images."""
    # Delete the images in the 'images' folder
    shutil.rmtree("images")
    window.destroy()

window.protocol("WM_DELETE_WINDOW", on_closing)
Python
Créer la fenêtre GUI
Maintenant, créons la fenêtre principale de l'interface graphique à l'aide du constructeur Tk(), définissez le titre de la fenêtre sur " Visualiseur d'images ", et définissez la fonction on_closing() comme protocole pour gérer la fermeture de la fenêtre.
Pour afficher les images et activer le défilement, créez un widget Canvas. Le widget Canvas est configuré pour remplir l'espace disponible et s'étendre dans les deux directions en utilisant pack(side=LEFT, fill=BOTH, expand=True). De plus, créez un widget Scrollbar et configurez-le pour contrôler le défilement vertical de toutes les pages et du canvas.
canvas = Canvas(window)canvas.pack(side=LEFT, fill=BOTH, expand=True)scrollbar = Scrollbar(window, command=canvas.yview)scrollbar.pack(side=RIGHT, fill=Y)canvas.configure(yscrollcommand=scrollbar.set)# Update the scrollregion to encompass the entire canvascanvas.bind("<Configure>", lambda e: canvas.configure( scrollregion=canvas.bbox("all")))# Configure the vertical scrolling using mouse wheelcanvas.bind_all("<MouseWheel>", lambda e: canvas.yview_scroll( int(-1*(e.delta/120)), "units"))
canvas = Canvas(window)
canvas.pack(side=LEFT, fill=BOTH, expand=True)

scrollbar = Scrollbar(window, command=canvas.yview)
scrollbar.pack(side=RIGHT, fill=Y)
canvas.configure(yscrollcommand=scrollbar.set)

# Update the scrollregion to encompass the entire canvas
canvas.bind("<Configure>", lambda e: canvas.configure(
    scrollregion=canvas.bbox("all")))

# Configure the vertical scrolling using mouse wheel
canvas.bind_all("<MouseWheel>", lambda e: canvas.yview_scroll(
    int(-1*(e.delta/120)), "units"))
Python
Créer un cadre pour les images
Ensuite, créez un widget Frame à l'intérieur du canvas pour contenir les images en utilisant create_window() pour placer le cadre dans le canvas. Les coordonnées (0, 0) et le paramètre anchor='nw' garantissent que le cadre commence dans le coin supérieur gauche du canvas.
Convertir le fichier PDF en images et les afficher
L'étape suivante consiste à appeler la fonction convert_pdf_to_images() avec le nom du fichier chemin de l'entrée du fichier PDF. Cette fonction extrait les pages PDF en tant qu'images et retourne une liste de chemins d'images. En itérant à travers les chemins d'images et en chargeant chaque image en utilisant la méthode Image.open() de la bibliothèque PIL, un objet PhotoImage est créé en utilisant ImageTk.PhotoImage(). Ensuite, créez un widget Label pour afficher l'image.
images = convert_pdf_to_images("input.pdf")# Load and display the images in the Framefor image_path in images: image = Image.open(image_path) photo = ImageTk.PhotoImage(image) label = Label(frame, image=photo) label.image = photo # Store a reference to prevent garbage collection label.pack(pady=10)
images = convert_pdf_to_images("input.pdf")
# Load and display the images in the Frame
for image_path in images:
    image = Image.open(image_path)
    photo = ImageTk.PhotoImage(image)
    label = Label(frame, image=photo)
    label.image = photo  # Store a reference to prevent garbage collection
    label.pack(pady=10)
Python
Le fichier d'entrée
Exécuter la boucle principale de la GUI
Enfin, exécutons la boucle d'événements principale en utilisant window.mainloop(). Cela garantit que la fenêtre de la GUI reste ouverte et réactive jusqu'à ce qu'elle soit fermée par l'utilisateur.
window.mainloop()
window.mainloop()
Python
La sortie de l'UI
Conclusion
Ce tutoriel a exploré comment visualiser des documents PDF en Python en utilisant la bibliothèque IronPDF. Il a couvert les étapes nécessaires pour ouvrir un fichier PDF et le convertir en une série de fichiers image, puis les afficher dans un canevas défilable, et gérer le nettoyage des images extraites lorsque l'application est fermée.
Pour plus de détails sur la bibliothèque IronPDF for Python, veuillez vous référer à la documentation.
Téléchargez et installez la bibliothèque IronPDF for Python et obtenez également un essai gratuit pour tester sa fonctionnalité complète dans un développement commercial.
Curtis Chau détient un baccalauréat en informatique (Université de Carleton) et se spécialise dans le développement front-end avec expertise en Node.js, TypeScript, JavaScript et React. Passionné par la création d'interfaces utilisateur intuitives et esthétiquement plaisantes, Curtis aime travailler avec des frameworks modernes et créer des manuels bien structurés et visuellement attrayants.


 PyCharm IDE
 Créer un nouveau projet Python
 Le fichier d'entrée
 La sortie de l'UI







