



已更新 2026年4月21日
Python 中的 Scrapy (開發人員的工作原理)
在這裡出現 Scrapy,一個 Python 網路抓取框架,和 IronPDF,兩個強大的庫一起工作以優化線上資料提取和動態 PDF 的建立。
閱讀更多

本文將使用IronPDF for Python和Python程式碼從PDF文件中提取圖像。
IronPDF for Python是最先進且功能強大的程式庫,為Python中的PDF文件處理帶來新的維度。 作為PDF任務的綜合解決方案,IronPDF可將高級PDF功能無縫整合到應用程式中。
IronPDF提供了一系列廣泛的工具和API,可以從零建立PDF,將HTML轉換為高品質PDF,並通過合併、拆分和編輯等操作來管理PDF頁面。 這些工具既使用者友好又高效。 憑藉其使用者友好的介面和豐富的文件,IronPDF為開發者開啟了可能性。
無論是建立專業報告和發票、自動化工作流程,還是管理文件,IronPDF都是文件管理和自動化領域的寶貴資產,是任何希望在Python應用程式中利用PDF功能的開發者不可或缺的工具。
PdfDocument.FromFile方法從本地磁盤載入PDF文件。ExtractAllImages方法從PDF文件中提取圖像。在深入了解使用Python從PDF獲取圖像的過程前,我們先安裝必要的先決條件:
Python安裝: 確保您在系統上安裝了Python解釋器。 獲取PDF中圖像的過程需要Python 3.0或更新版本。 確保您安裝的Python與其相容。
IronPDF程式庫: 為了利用IronPDF的強大功能,您需要使用pip,Python包管理器來安裝它。 只需打開命令行介面並執行以下命令:
整合開發環境 (IDE): 雖然不是必需的,但使用IDE可以大大提升您的開發體驗。 IDE提供了程式碼完成、除錯以及更流暢的工作流程等功能。 一個非常受歡迎的Python開發IDE是PyCharm。 您可以從JetBrains網站下載並安裝PyCharm。
一旦這些先決條件就位,您就可以探索逐步指南,通過使用Python和IronPDF從PDF中檢索圖像的精彩世界。
以下是在PyCharm中建立新Python專案的步驟。
要在PyCharm中啟動新的Python專案,請打開PyCharm應用程式並導航到頂部選單。
點擊文件,然後從下拉選單中選擇新專案。
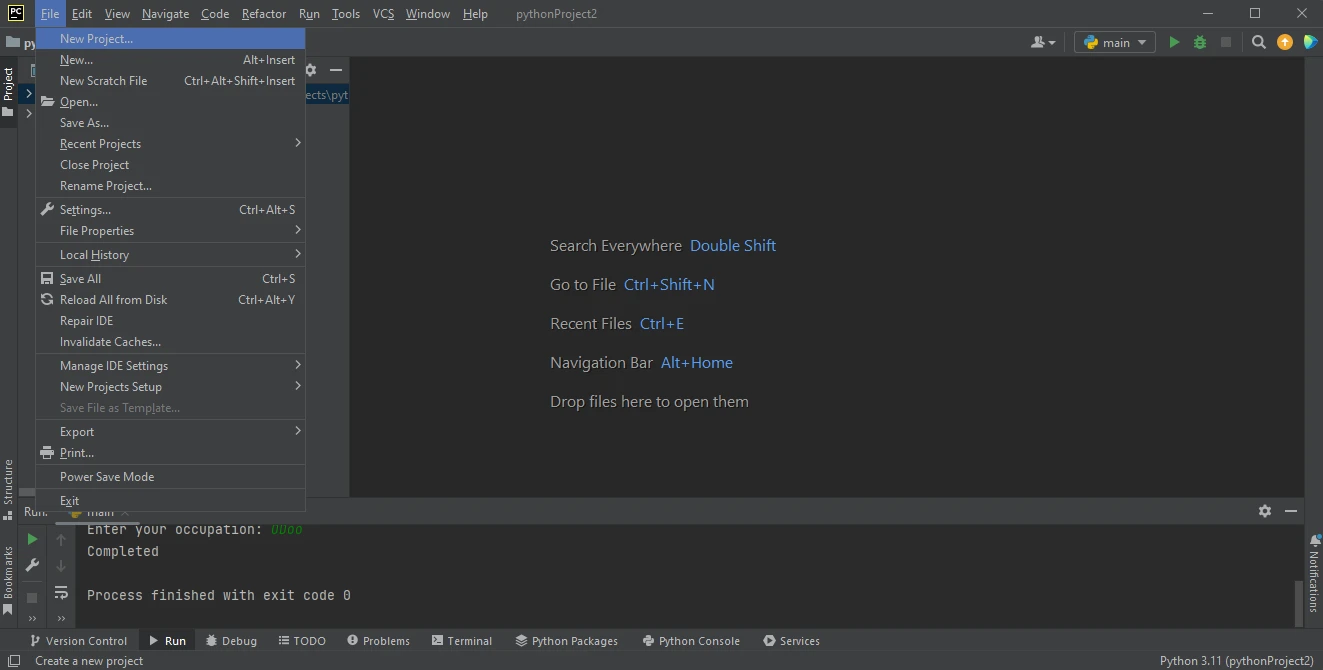 PyCharm IDE
點擊新專案後,將會彈出一個標題為建立專案的新窗口。
在此窗口的頂部位置字段中輸入您的專案名稱。選擇環境; 如果您使用虛擬環境,請從提供的選項中選擇它。
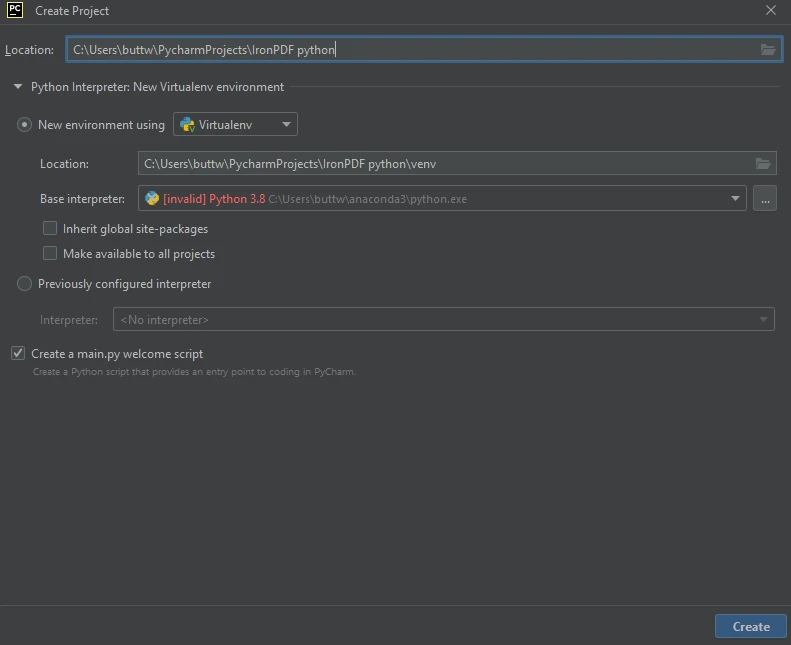 在PyCharm中建立新的Python專案
選擇環境後,點擊建立按鈕建立您的Python專案。
您的Python專案現在已建立並準備用於各種任務,例如提取圖像。
要安裝IronPDF,打開終端或一個單獨的命令提示符,輸入命令pip install ironpdf,然後按下Enter鍵。 終端將顯示以下輸出。
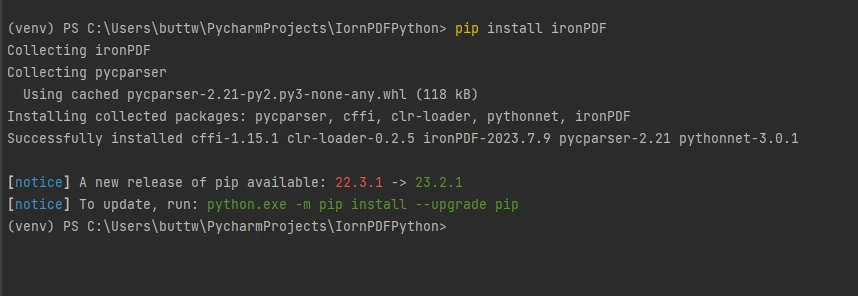 安裝IronPDF套件
IronPDF為開發者提供了工具和API,可以無縫地瀏覽PDF並識別和提取嵌入的圖像。 無論是分析還是整合,IronPDF都能使用Python的靈活性簡化提取過程。 這使得它在處理PDF和基於圖像的應用程式時變得必不可少。只需要幾行程式碼就可以從PDF文件中提取所有圖像,這非常簡單。
查看以下程式碼,用Python程式語言從PDF中提取圖像。
from ironpdf import PdfDocument

# Open PDF file
pdf = PdfDocument.FromFile("FYP Thesis.pdf")

# Get all images found in the PDF Document
all_images = pdf.ExtractAllImages()

# Save each image to the local disk with a dynamic name
for i, image in enumerate(all_images):
image.SaveAs(f"output_image_{i}.png")此程式碼首先匯入IronPDF程式庫,然後使用文件路徑和PdfDocument.FromFile方法從本地空間載入PDF文件。 它存取PDF的每一頁以提取圖像字節作為圖像物件。 這些從PDF頁面提取的圖像物件隨後使用SaveAs方法保存。 程式碼根據圖像索引和所需的圖像文件擴展名分配動態圖像名稱,本例中為PNG格式。
此方法比使用其它Python程式庫(如PyMuPDF和Pillow)更簡單,因為它們需要更多程式碼才能完成同樣的提取和保存圖像文件的任務。
圖像從PDF文件的所有頁面中提取並以PNG格式保存。 您還可以靈活調整文件擴展名以匹配所需的圖像文件格式來修改輸出格式。
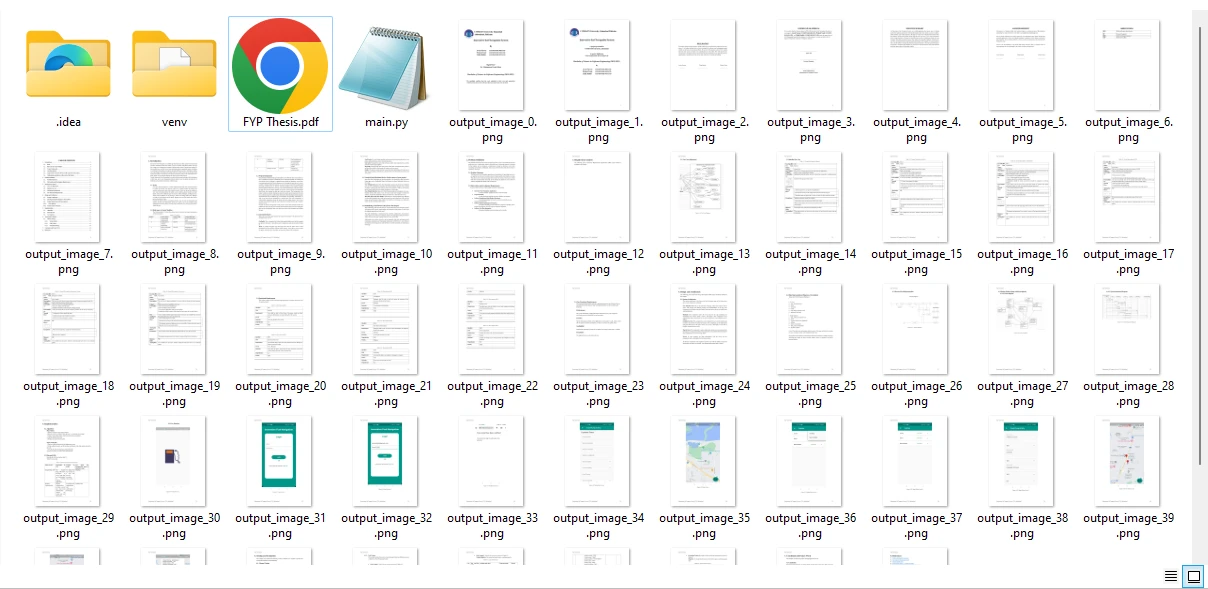 從範例PDF文件中提取的圖像
Python與強大的IronPDF一起,為從PDF文件檢索圖像的任務提供了靈活和高效的解決方案。 利用Python的靈活性和IronPDF的功能,開發者可以無縫地瀏覽PDF文件,定位其中的圖像字節,並使用所需的圖像擴展名保存這些圖像。 該過程涉及從PDF獲取圖像,並且生成的圖像列表可以根據需要進一步處理和操縱。 通過掌握使用Python從PDF中獲取圖像的技藝,開發者可以增強其工作流程,自動化文件管理,並探索大量基於圖像的應用程式,使其在數位時代成為一項有價值的技能。
有關從PDF文件中提取圖像的更多功能,請參閱以下範例。 您可以探索其他操作,如將PDF文件內容轉換為圖像; 完整的教程可在此Python技術文章中找到。

Curtis Chau擁有Carleton大學的電腦科學學士學位,專精於前端開發,擁有Node.js、TypeScript、JavaScript和React的專業知識。Curtis熱衷於建立直觀且美觀的使用者介面,喜愛使用現代框架並建立結構良好、視覺吸引力的手冊。


IronPDF 是 IRONSUITE 的一部分
10 款適用於辦公室文件的 .NET API 產品

當您需要您的PDF看起來像HTML一樣快速。



