



更新日 2026年4月21日
Scrapy in Python(開発者向けのしくみ)
ここにScrapy、PythonにおけるWebスクレイピングフレームワークとIronPDFが登場し、オンラインデータの抽出と動的PDFの作成を最適化するための2つの強力なライブラリが協力しています。
詳しく読む

この記事では、IronPDFライブラリを使用してPythonで請求書のPDFファイルからテキストデータを抽出する方法について説明します。
PdfDocument.FromFile メソッドを利用してPDFファイルを開きます。ExtractAllText メソッドを使って、請求書からすべてのデータを抽出します。print メソッドを使用して、請求書から抽出したすべてのデータを印刷します。IronPDF for Pythonは、PythonアプリケーションとPDFドキュメントの間のブリッジとして機能するPythonを使用した強力なライブラリです。 この多用途なツールは、開発者がPythonプロジェクト内でPDFファイルを容易に作成、操作、やり取りできる手段を提供します。 以下は、IronPDFを貴重な資産にしている際立った機能のいくつかです:
PythonでのIronPDF環境のセットアップは、ライブラリを効果的に使用するためのいくつかのステップを含みます。 ステップバイステップガイドは以下の通りです:
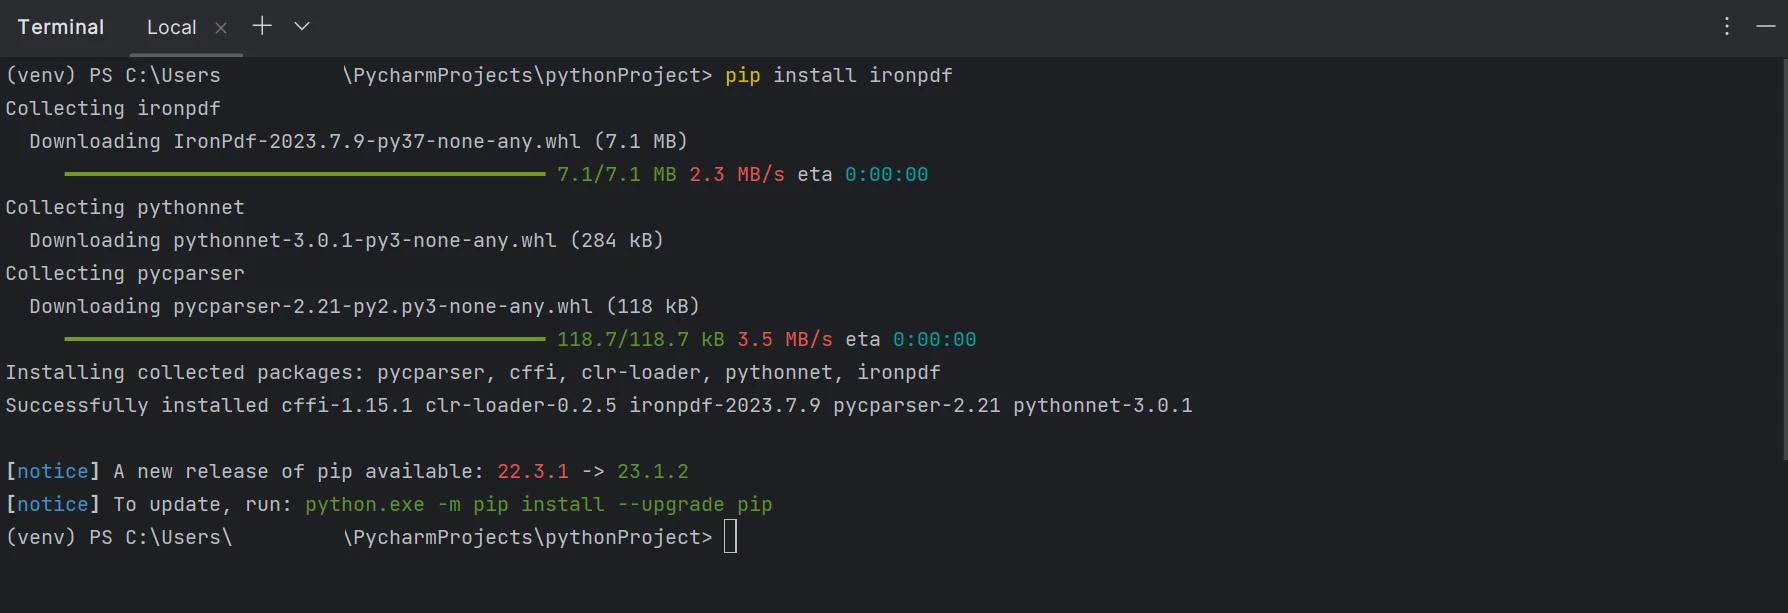 コマンドラインからのIronPDFのインストール
このセクションでは、PythonライブラリのIronPDFを使用して請求書形式と出力形式からデータを抽出する方法を確認します。 以下のコードは、請求書からすべてのデータを抽出し、コンソールに出力します。
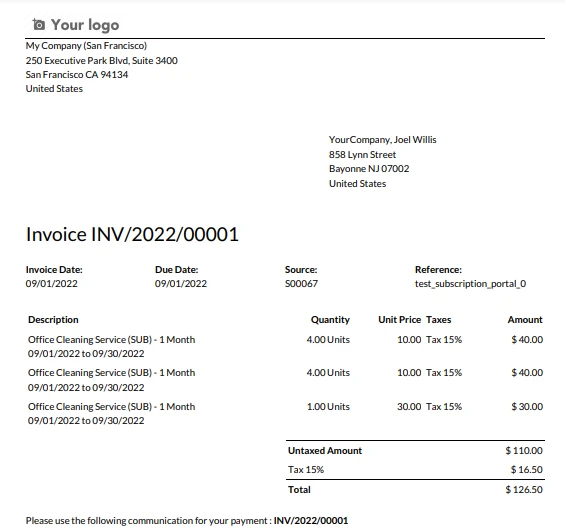 サンプル請求書
from ironpdf import PdfDocument

# Load the PDF using the PdfDocument.FromFile method
pdf = PdfDocument.FromFile("INV_2022_00001.pdf")

# Extract all text from the PDF
all_text = pdf.ExtractAllText()

# Print the extracted text
print(all_text)上記のコードは、PdfDocument.FromFile メソッドを使用して"INV_2022_00001.pdf"という特定のPDFファイルを読み込みます。 その後、読み込んだPDFドキュメントからすべてのテキストコンテンツを抽出し、変数all_text に格納します。 最後に、抽出したテキストをprint 関数を使用してコンソールに出力します。 本質的に、このコードはPDFファイルから構造化および非構造化テキストデータを抽出するプロセスを自動化し、Python環境でのさらなる処理または分析が可能になります。
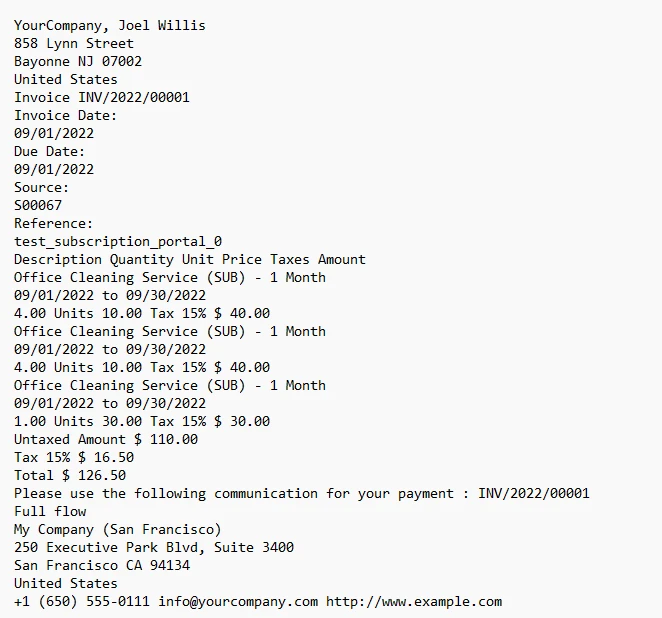 コンソールに出力された請求書のテキスト
IronPDFを使用して請求書データを抽出するのは非常に簡単なプロセスです。 請求書番号や金額などのデータをPDF請求書データから抽出するのは難しいプロセスですが、IronPDFとPythonオープンソースライブラリre を組み合わせて使用することで実現可能です。 以下のコードは、PDF請求書から特定のデータを抽出し、コンソールに出力します。
from ironpdf import PdfDocument
import re

# Define regex patterns to find invoice number and amount
invoice_number_pattern = r"Invoice\s+(INV/\d{4}/\d{5})"
amount_pattern = r"Total\s+\$\s*([\d,.]+(?:\.\d{2})?)"

# Load the PDF using the PdfDocument.FromFile method
pdf = PdfDocument.FromFile("INV_2022_00001.pdf")

# Extract all text from the PDF
all_text = pdf.ExtractAllText()

# Search for the invoice number and amount in text
invoice_number_match = re.search(invoice_number_pattern, all_text)
amount_match = re.search(amount_pattern, all_text)

# Extract the matching groups if matches are found
invoice_number = invoice_number_match.group(1) if invoice_number_match else "Not found"
amount = amount_match.group(1) if amount_match else "Not found"

# Print the extracted data
print('Invoice Number: ' + invoice_number + '\nAmount: $' + amount)このコードスニペットは、PythonとIronPDFライブラリを使用して、PDFドキュメントからデータを抽出します。 最初に必要なライブラリをインポートし、PDFのテキストコンテンツ内で請求書番号と総金額を識別するための正規表現パターンを定義します。 その後、ターゲットPDFをロードし、そのすべてのテキストを抽出して、定義されたパターンの一致を検索し始めます。
一致が見つかれば、請求書番号と金額の対応する値が格納されます; 見つからなければ"Not found"が割り当てられます。 最後に、スクリプトは抽出された請求書番号と金額をコンソールに出力し、様々なデータ処理や会計アプリケーションで一般的に見られるPDFドキュメントから特定のデータを自動的に抽出するための簡潔な方法を提供します。
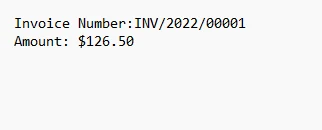 出力テキスト
今日のビジネスの急速なペースの中で、PythonはPDF請求書からの重要データ抽出を自動化することで財務業務を効率化しようとする組織の強力な味方として立っています。 Pythonの機能とIronPDFライブラリを活用することで、企業は手作業でのデータ入力を大幅に削減し、エラーを軽減し、時間を節約し、請求書管理の会計プロセス全体の生産性を向上させることができます。 PDF生成、HTMLからPDFへの変換、PDFの編集、結合、分割、フォーム処理、デジタル署名、正確なデータ抽出など、多才な機能を備えたIronPDFは、これらの作業の強力なツールとして台頭しています。
シンプルなセットアップ手順を従うことで、Python開発者はすばやくIronPDFをプロジェクトに統合でき、請求書の処理のワークフローを革命的に進化させ、請求書からのデータ抽出をシームレスかつ効率的なプロセスにします。 IronPDFを使用したデータ抽出のコード例は、詳細なコードサンプルから見つけることができます。 IronPDF for Pythonを使用したデータ抽出に関する完全なチュートリアルは、以下のPythonチュートリアルで利用可能であり、C#を使用した請求書抽出に関してはIronOCRチュートリアルを参照してください。

Curtis Chauは、カールトン大学でコンピュータサイエンスの学士号を取得し、Node.js、TypeScript、JavaScript、およびReactに精通したフロントエンド開発を専門としています。直感的で美しいユーザーインターフェースを作成することに情熱を持ち、Curtisは現代のフレームワークを用いた開発や、構造の良い視覚的に魅力的なマニュアルの作成を楽しんでいます。



IronPDF はIRONSUITEの一部です
オフィス文書向けの.NET API製品10個

PDFがHTMLのように見える必要があるとき、迅速に。



