from ironpdf import *

# Instantiate Renderer
renderer = ChromePdfRenderer()

# Create a PDF from a HTML string using Python
pdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>")

# Export to a file or Stream
pdf.SaveAs("output.pdf")

# Advanced Example with HTML Assets
# Load external html assets: Images, CSS and JavaScript.
# An optional BasePath 'C:\site\assets\' is set as the file location to load assets from
myAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", r"C:\site\assets")
myAdvancedPdf.SaveAs("html-with-assets.pdf")
from ironpdf import *# Instantiate Rendererrenderer = ChromePdfRenderer()# Create a PDF from a HTML string using Pythonpdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>")# Export to a file or Streampdf.SaveAs("output.pdf")# Advanced Example with HTML Assets# Load external html assets: Images, CSS and JavaScript.# An optional BasePath 'C:\site\assets\' is set as the file location to load assets frommyAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", r"C:\site\assets")myAdvancedPdf.SaveAs("html-with-assets.pdf")
VERWENDUNG VON IRONPDF FOR PYTHON
Wie man Rechnungsdaten aus einer PDF in Python extrahiert
In diesem Artikel wird erläutert, wie Sie mit der **IronPDF**-Bibliothek für Python Textdaten aus PDF-Rechnungen extrahieren können.
## So extrahieren Sie Rechnungsdaten aus PDF in Python
1. Installieren Sie die Python-Bibliothek zur Extraktion von Daten aus PDF-Rechnungen.
2. Verwenden Sie die `PdfDocument.FromFile`-Methode, um eine PDF-Datei zu öffnen.
3. Extrahieren Sie alle Daten aus der Rechnung mit der `ExtractAllText`-Methode.
4. Verwenden Sie die `print`-Methode, um alle extrahierten Daten aus der Rechnung auszudrucken.
5. Extrahieren Sie spezifische Daten aus den Rechnungsdaten.
## 1. IronPDF
IronPDF for Python ist eine robuste Bibliothek, die als Brücke zwischen Python-Anwendungen und PDF-Dokumenten dient. Dieses vielseitige Werkzeug bietet Entwicklern die Möglichkeit, PDF-Dateien mühelos in ihren Python-Projekten zu erstellen, zu manipulieren und mit ihnen zu interagieren. Hier sind einige der herausragenden Funktionen, die IronPDF zu einer wertvollen Ressource machen:
1. [**PDF-Erzeugung:**](/python/how-to/python-create-pdf/) IronPDF ermöglicht die dynamische Erstellung von PDF-Dateien von Grund auf, sodass Entwickler PDF-Dokumente mit benutzerdefiniertem Inhalt, Styling und Layout programmgesteuert erstellen können.
2. [**HTML-zu-PDF-Konvertierung:**](/python/blog/using-ironpdf-for-python/python-generate-pdf-from-template-tutorial) Es kann HTML-Inhalte, einschließlich Webseiten, in hochwertige PDFs umwandeln und dabei das Layout und das Design des ursprünglichen HTML beibehalten, was besonders nützlich für die Erstellung von Berichten und Dokumentationen ist.
3. [**PDF-Bearbeitung:**](/python/blog/using-ironpdf-for-python/python-pdf-editor-tutorial) Entwickler können bestehende PDFs einfach bearbeiten, indem sie Text, Bilder und interaktive Elemente hinzufügen, ändern oder entfernen, was es zu einem leistungsstarken Werkzeug für die Dokumentmanipulation macht.
4. **PDF-Zusammenführung und -Aufteilung:** IronPDF ermöglicht Ihnen die [Zusammenführung mehrerer PDF-Dokumente](/python/how-to/python-merge-pdf/) zu einer einzigen Datei oder das [Aufteilen einer PDF in mehrere Dateien](/python/blog/using-ironpdf-for-python/split-pdf-python-tutorial), was Flexibilität bei der Verwaltung großer PDF-Sätze bietet.
5. [**PDF-Formulare:**](/python/examples/form-data/) Es unterstützt die Erstellung und das Ausfüllen von interaktiven PDF-Formularen, was es ideal für Anwendungen macht, die Benutzereingaben und Datenerfassung erfordern.
6. [**Digitale Signaturen:**](/python/blog/using-ironpdf-for-python/digital-signature-python-tutorial) Sie können digitale Signaturen zu PDF-Dokumenten hinzufügen, um die Integrität und Authentizität Ihrer Dateien zu gewährleisten, was für rechtliche und sicherheitsrelevante Zwecke entscheidend ist.
7. [**PDF-Datenextraktion:**](/python/blog/using-ironpdf-for-python/extract-data-from-pdf-python-tutorial) IronPDF bietet Extraktionsmöglichkeiten, um Informationen innerhalb von PDFs zu schützen.
## 2. Einrichten der Umgebung
Das Einrichten der Umgebung für IronPDF in Python umfasst einige Schritte, um sicherzustellen, dass Sie die Bibliothek effektiv nutzen können. Hier ist eine Schritt-für-Schritt-Anleitung:
1. Erstellen Sie ein neues Python-Projekt in PyCharm und erstellen Sie eine virtuelle Umgebung oder verwenden Sie einen bestehenden Interpreter.
2. Installieren Sie IronPDF über das Befehlszeilenterminal, indem Sie den folgenden Befehl im Terminal ausführen:
```shell
:ProductInstall
```
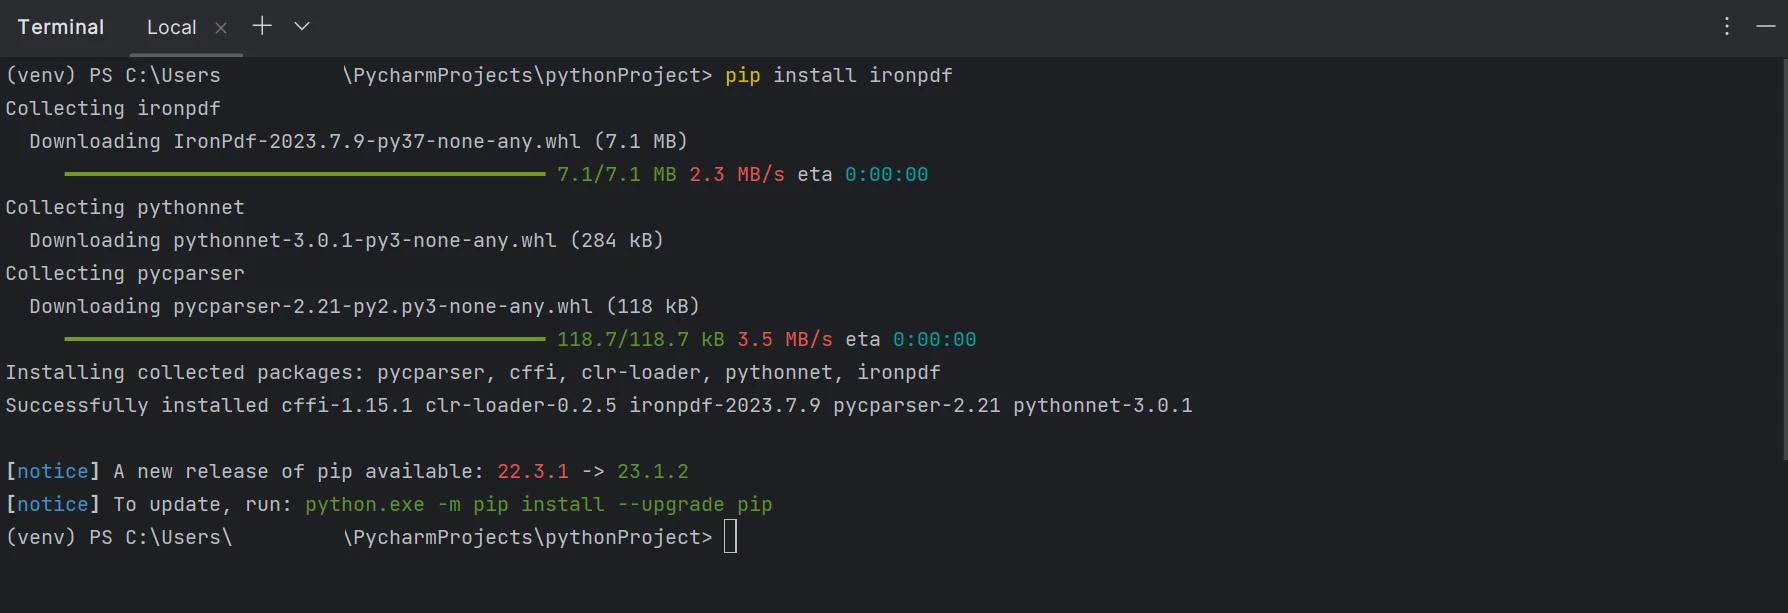
**IronPDF wird vom Kommandozeilen-Terminal installiert**
## 3. Daten aus Rechnungen mit IronPDF extrahieren
In diesem Abschnitt sehen wir, wie Daten aus dem Rechnungsformat und dem Ausgabeformat unter Verwendung der Python-Bibliothek IronPDF extrahiert werden. Der untenstehende Code extrahiert alle Daten aus der Rechnung und gibt sie in der Konsole aus.
### Beispielrechnung
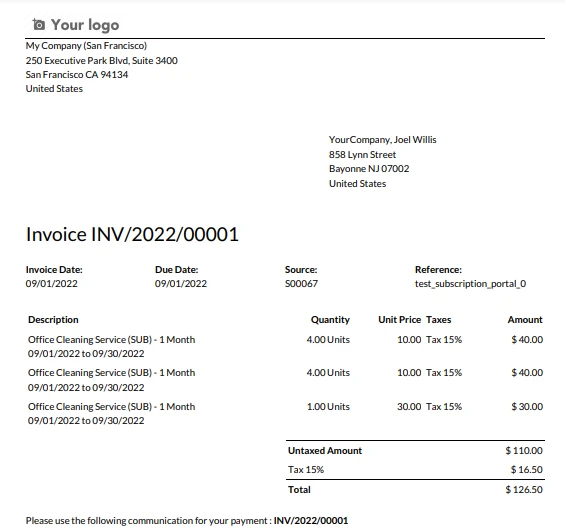
**Die Musterrechnung**
```python
from ironpdf import PdfDocument

# Load the PDF using the PdfDocument.FromFile method
pdf = PdfDocument.FromFile("INV_2022_00001.pdf")

# Extract all text from the PDF
all_text = pdf.ExtractAllText()

# Print the extracted text
print(all_text)
```
Der obige Code lädt eine bestimmte PDF-Datei mit dem Namen "INV_2022_00001.pdf" mithilfe der `PdfDocument.FromFile`-Methode. Anschließend wird der gesamte Textinhalt aus dem geladenen PDF-Dokument extrahiert und in der Variablen `all_text` gespeichert. Schließlich wird der extrahierte Text mit der `print`-Funktion auf der Konsole ausgegeben. Im Wesentlichen automatisiert dieser Code den Prozess der Extraktion von strukturierten und unstrukturierten Textdaten aus einer PDF-Datei, was sie für die weitere Verarbeitung oder Analyse in einer Python-Umgebung zugänglich macht.
### 3.1. Ausgabe
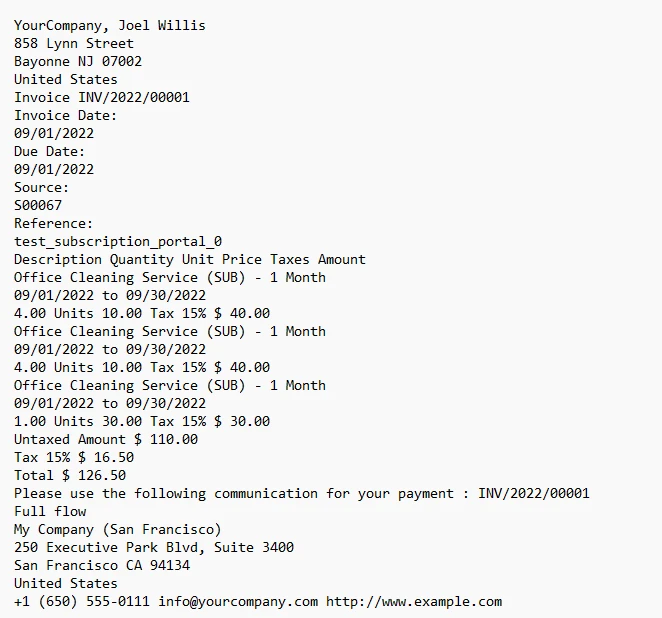
**Der Text aus der Rechnungsausgabe in der Konsole**
## 4. Spezifische Daten aus Rechnungen extrahieren
Die Verwendung von IronPDF zur Extraktion von Rechnungsdaten ist ein recht einfacher Prozess. Daten wie Rechnungsnummer und Betrag aus den PDF-Rechnungsdaten zu extrahieren kann ein kniffliger Prozess sein, aber mit dem Einsatz von IronPDF in Verbindung mit der Open-Source-Python-Bibliothek `re` lässt sich das erreichen. Der untenstehende Code extrahiert spezifische Daten aus PDF-Rechnungen und gibt sie in der Konsole aus.
```python
from ironpdf import PdfDocument
import re
# Define regex patterns to find invoice number and amount
invoice_number_pattern = r"Invoice\s+(INV/\d{4}/\d{5})"
amount_pattern = r"Total\s+\$\s*([\d,.]+(?:\.\d{2})?)"
# Load the PDF using the PdfDocument.FromFile method
pdf = PdfDocument.FromFile("INV_2022_00001.pdf")
# Extract all text from the PDF
all_text = pdf.ExtractAllText()
# Search for the invoice number and amount in text
invoice_number_match = re.search(invoice_number_pattern, all_text)
amount_match = re.search(amount_pattern, all_text)
# Extract the matching groups if matches are found
invoice_number = invoice_number_match.group(1) if invoice_number_match else "Not found"
amount = amount_match.group(1) if amount_match else "Not found"
# Print the extracted data
print('Invoice Number: ' + invoice_number + '\nAmount: $' + amount)
```
Dieses Codebeispiel verwendet Python und die IronPDF-Bibliothek, um Daten aus einem PDF-Dokument zu extrahieren. Es beginnt mit dem Importieren der erforderlichen Bibliotheken und dem Definieren von regulären Ausdrucksmustern zur Identifizierung einer Rechnungsnummer und eines Gesamtbetrags innerhalb des Textinhalts des PDFs. Der Code lädt dann das Ziel-PDF, extrahiert den gesamten Text und sucht nach Übereinstimmungen der definierten Muster.
Wenn erfolgreiche Übereinstimmungen gefunden werden, speichert er die entsprechenden Werte für die Rechnungsnummer und den Betrag; Andernfalls wird "Nicht gefunden" zugewiesen. Schließlich druckt das Skript die extrahierte Rechnungsnummer und den Betrag in der Konsole aus und bietet einen einfachen Weg zur Automatisierung des Extraktionsprozesses spezifischer Daten aus PDF-Dokumenten, eine Aufgabe, die in verschiedenen Datenverarbeitungs- und Buchhaltungsanwendungen häufig vorkommt.
### 4.1. Ausgabe
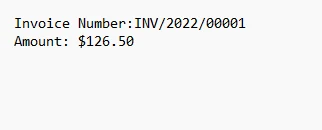
**Der Ausgabetext**
## 5. Fazit
In der heutigen schnelllebigen Geschäftswelt ist Python ein mächtiger Verbündeter für Unternehmen, die ihre Finanzprozesse durch die Automatisierung der Extraktion wichtiger Daten aus PDF-Rechnungen rationalisieren möchten. Durch die Nutzung der Möglichkeiten von Python und der IronPDF-Bibliothek können Unternehmen die manuelle Dateneingabe erheblich reduzieren, Fehler minimieren, Zeit sparen und die Produktivität im Buchhaltungsprozess beim Verwalten von Rechnungen steigern. IronPDF, mit seinen vielseitigen Funktionen wie PDF-Erstellung, HTML-zu-PDF-Konvertierung, PDF-Bearbeitung, Zusammenführung, Aufteilung, Formularverwaltung, digitale Signaturen und genaue Datenextraktion, erweist sich als leistungsstarkes Werkzeug für diese Aufgaben.
Indem sie einfache Einrichtungsverfahren befolgen, können Python-Entwickler IronPDF schnell in ihre Projekte integrieren, ihre Rechnungsverarbeitungs-Workflows revolutionieren und die Datenauswertung aus Rechnungen zu einem reibungslosen und effizienten Prozess machen. Das Codebeispiel zur Datenextraktion mit IronPDF finden Sie in den [detaillierten Codebeispielen](/python/examples/extract-pdf-text/). Das vollständige Tutorial zur Datenextraktion mit IronPDF for Python ist im folgenden [Python-Tutorial](/python/blog/using-ironpdf-for-python/extract-specific-text-from-pdf-python-tutorial) verfügbar, und für die Rechnungsextraktion mit C# besuchen Sie das [IronOCR-Tutorial](/csharp/ocr/blog/using-ironocr/invoice-ocr-csharp-tutorial).
In diesem Artikel wird erläutert, wie Sie mit der IronPDF-Bibliothek für Python Textdaten aus PDF-Rechnungen extrahieren können.
So extrahieren Sie Rechnungsdaten aus PDF in Python
Installieren Sie die Python-Bibliothek zur Extraktion von Daten aus PDF-Rechnungen.
Verwenden Sie die PdfDocument.FromFile-Methode, um eine PDF-Datei zu öffnen.
Extrahieren Sie alle Daten aus der Rechnung mit der ExtractAllText-Methode.
Verwenden Sie die print-Methode, um alle extrahierten Daten aus der Rechnung auszudrucken.
Extrahieren Sie spezifische Daten aus den Rechnungsdaten.
1. IronPDF
IronPDF for Python ist eine robuste Bibliothek, die als Brücke zwischen Python-Anwendungen und PDF-Dokumenten dient. Dieses vielseitige Werkzeug bietet Entwicklern die Möglichkeit, PDF-Dateien mühelos in ihren Python-Projekten zu erstellen, zu manipulieren und mit ihnen zu interagieren. Hier sind einige der herausragenden Funktionen, die IronPDF zu einer wertvollen Ressource machen:
PDF-Erzeugung: IronPDF ermöglicht die dynamische Erstellung von PDF-Dateien von Grund auf, sodass Entwickler PDF-Dokumente mit benutzerdefiniertem Inhalt, Styling und Layout programmgesteuert erstellen können.
HTML-zu-PDF-Konvertierung: Es kann HTML-Inhalte, einschließlich Webseiten, in hochwertige PDFs umwandeln und dabei das Layout und das Design des ursprünglichen HTML beibehalten, was besonders nützlich für die Erstellung von Berichten und Dokumentationen ist.
PDF-Bearbeitung: Entwickler können bestehende PDFs einfach bearbeiten, indem sie Text, Bilder und interaktive Elemente hinzufügen, ändern oder entfernen, was es zu einem leistungsstarken Werkzeug für die Dokumentmanipulation macht.
PDF-Formulare: Es unterstützt die Erstellung und das Ausfüllen von interaktiven PDF-Formularen, was es ideal für Anwendungen macht, die Benutzereingaben und Datenerfassung erfordern.
Digitale Signaturen: Sie können digitale Signaturen zu PDF-Dokumenten hinzufügen, um die Integrität und Authentizität Ihrer Dateien zu gewährleisten, was für rechtliche und sicherheitsrelevante Zwecke entscheidend ist.
PDF-Datenextraktion: IronPDF bietet Extraktionsmöglichkeiten, um Informationen innerhalb von PDFs zu schützen.
2. Einrichten der Umgebung
Das Einrichten der Umgebung für IronPDF in Python umfasst einige Schritte, um sicherzustellen, dass Sie die Bibliothek effektiv nutzen können. Hier ist eine Schritt-für-Schritt-Anleitung:
Erstellen Sie ein neues Python-Projekt in PyCharm und erstellen Sie eine virtuelle Umgebung oder verwenden Sie einen bestehenden Interpreter.
Installieren Sie IronPDF über das Befehlszeilenterminal, indem Sie den folgenden Befehl im Terminal ausführen:
> pip install ironpdf
pip install ironpdf
IronPDF wird vom Kommandozeilen-Terminal installiert
3. Daten aus Rechnungen mit IronPDF extrahieren
In diesem Abschnitt sehen wir, wie Daten aus dem Rechnungsformat und dem Ausgabeformat unter Verwendung der Python-Bibliothek IronPDF extrahiert werden. Der untenstehende Code extrahiert alle Daten aus der Rechnung und gibt sie in der Konsole aus.
Beispielrechnung
Die Musterrechnung
from ironpdf importPdfDocument# Load the PDF using the PdfDocument.FromFile methodpdf = PdfDocument.FromFile("INV_2022_00001.pdf")# Extract all text from the PDFall_text = pdf.ExtractAllText()# Print the extracted textprint(all_text)
from ironpdf import PdfDocument

# Load the PDF using the PdfDocument.FromFile method
pdf = PdfDocument.FromFile("INV_2022_00001.pdf")

# Extract all text from the PDF
all_text = pdf.ExtractAllText()

# Print the extracted text
print(all_text)
Python
Der obige Code lädt eine bestimmte PDF-Datei mit dem Namen "INV_2022_00001.pdf" mithilfe der PdfDocument.FromFile-Methode. Anschließend wird der gesamte Textinhalt aus dem geladenen PDF-Dokument extrahiert und in der Variablen all_text gespeichert. Schließlich wird der extrahierte Text mit der print-Funktion auf der Konsole ausgegeben. Im Wesentlichen automatisiert dieser Code den Prozess der Extraktion von strukturierten und unstrukturierten Textdaten aus einer PDF-Datei, was sie für die weitere Verarbeitung oder Analyse in einer Python-Umgebung zugänglich macht.
3.1. Ausgabe
Der Text aus der Rechnungsausgabe in der Konsole
4. Spezifische Daten aus Rechnungen extrahieren
Die Verwendung von IronPDF zur Extraktion von Rechnungsdaten ist ein recht einfacher Prozess. Daten wie Rechnungsnummer und Betrag aus den PDF-Rechnungsdaten zu extrahieren kann ein kniffliger Prozess sein, aber mit dem Einsatz von IronPDF in Verbindung mit der Open-Source-Python-Bibliothek re lässt sich das erreichen. Der untenstehende Code extrahiert spezifische Daten aus PDF-Rechnungen und gibt sie in der Konsole aus.
from ironpdf importPdfDocumentimport re# Define regex patterns to find invoice number and amountinvoice_number_pattern = r"Invoice\s+(INV/\d{4}/\d{5})"amount_pattern = r"Total\s+\$\s*([\d,.]+(?:\.\d{2})?)"# Load the PDF using the PdfDocument.FromFile methodpdf = PdfDocument.FromFile("INV_2022_00001.pdf")# Extract all text from the PDFall_text = pdf.ExtractAllText()# Search for the invoice number and amount in textinvoice_number_match = re.search(invoice_number_pattern, all_text)amount_match = re.search(amount_pattern, all_text)# Extract the matching groups if matches are foundinvoice_number = invoice_number_match.group(1) if invoice_number_match else "Not found"amount = amount_match.group(1) if amount_match else "Not found"# Print the extracted dataprint('Invoice Number: ' + invoice_number + '\nAmount: $' + amount)
from ironpdf import PdfDocument
import re

# Define regex patterns to find invoice number and amount
invoice_number_pattern = r"Invoice\s+(INV/\d{4}/\d{5})"
amount_pattern = r"Total\s+\$\s*([\d,.]+(?:\.\d{2})?)"

# Load the PDF using the PdfDocument.FromFile method
pdf = PdfDocument.FromFile("INV_2022_00001.pdf")

# Extract all text from the PDF
all_text = pdf.ExtractAllText()

# Search for the invoice number and amount in text
invoice_number_match = re.search(invoice_number_pattern, all_text)
amount_match = re.search(amount_pattern, all_text)

# Extract the matching groups if matches are found
invoice_number = invoice_number_match.group(1) if invoice_number_match else "Not found"
amount = amount_match.group(1) if amount_match else "Not found"

# Print the extracted data
print('Invoice Number: ' + invoice_number + '\nAmount: $' + amount)
Python
Dieses Codebeispiel verwendet Python und die IronPDF-Bibliothek, um Daten aus einem PDF-Dokument zu extrahieren. Es beginnt mit dem Importieren der erforderlichen Bibliotheken und dem Definieren von regulären Ausdrucksmustern zur Identifizierung einer Rechnungsnummer und eines Gesamtbetrags innerhalb des Textinhalts des PDFs. Der Code lädt dann das Ziel-PDF, extrahiert den gesamten Text und sucht nach Übereinstimmungen der definierten Muster.
Wenn erfolgreiche Übereinstimmungen gefunden werden, speichert er die entsprechenden Werte für die Rechnungsnummer und den Betrag; Andernfalls wird "Nicht gefunden" zugewiesen. Schließlich druckt das Skript die extrahierte Rechnungsnummer und den Betrag in der Konsole aus und bietet einen einfachen Weg zur Automatisierung des Extraktionsprozesses spezifischer Daten aus PDF-Dokumenten, eine Aufgabe, die in verschiedenen Datenverarbeitungs- und Buchhaltungsanwendungen häufig vorkommt.
4.1. Ausgabe
Der Ausgabetext
5. Fazit
In der heutigen schnelllebigen Geschäftswelt ist Python ein mächtiger Verbündeter für Unternehmen, die ihre Finanzprozesse durch die Automatisierung der Extraktion wichtiger Daten aus PDF-Rechnungen rationalisieren möchten. Durch die Nutzung der Möglichkeiten von Python und der IronPDF-Bibliothek können Unternehmen die manuelle Dateneingabe erheblich reduzieren, Fehler minimieren, Zeit sparen und die Produktivität im Buchhaltungsprozess beim Verwalten von Rechnungen steigern. IronPDF, mit seinen vielseitigen Funktionen wie PDF-Erstellung, HTML-zu-PDF-Konvertierung, PDF-Bearbeitung, Zusammenführung, Aufteilung, Formularverwaltung, digitale Signaturen und genaue Datenextraktion, erweist sich als leistungsstarkes Werkzeug für diese Aufgaben.
Indem sie einfache Einrichtungsverfahren befolgen, können Python-Entwickler IronPDF schnell in ihre Projekte integrieren, ihre Rechnungsverarbeitungs-Workflows revolutionieren und die Datenauswertung aus Rechnungen zu einem reibungslosen und effizienten Prozess machen. Das Codebeispiel zur Datenextraktion mit IronPDF finden Sie in den detaillierten Codebeispielen. Das vollständige Tutorial zur Datenextraktion mit IronPDF for Python ist im folgenden Python-Tutorial verfügbar, und für die Rechnungsextraktion mit C# besuchen Sie das IronOCR-Tutorial.
Curtis Chau hat einen Bachelor-Abschluss in Informatik von der Carleton University und ist spezialisiert auf Frontend-Entwicklung mit Expertise in Node.js, TypeScript, JavaScript und React. Leidenschaftlich widmet er sich der Erstellung intuitiver und ästhetisch ansprechender Benutzerschnittstellen und arbeitet gerne mit modernen Frameworks sowie der Erstellung gut strukturierter, optisch ansprechender Handbücher.


 IronPDF wird vom Kommandozeilen-Terminal installiert
 Die Musterrechnung
 Der Text aus der Rechnungsausgabe in der Konsole
 Der Ausgabetext







