using IronPdf;

// Disable local disk access or cross-origin requests
Installation.EnableWebSecurity = true;

// Instantiate Renderer
var renderer = new ChromePdfRenderer();

// Create a PDF from a HTML string using C#
var pdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>");

// Export to a file or Stream
pdf.SaveAs("output.pdf");

// Advanced Example with HTML Assets
// Load external html assets: Images, CSS and JavaScript.
// An optional BasePath 'C:\site\assets\' is set as the file location to load assets from
var myAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", @"C:\site\assets\");
myAdvancedPdf.SaveAs("html-with-assets.pdf");
using IronPdf;// Disable local disk access or cross-origin requestsInstallation.EnableWebSecurity = true;// Instantiate Renderervar renderer = new ChromePdfRenderer();// Create a PDF from a HTML string using C#var pdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>");// Export to a file or Streampdf.SaveAs("output.pdf");// Advanced Example with HTML Assets// Load external html assets: Images, CSS and JavaScript.// An optional BasePath 'C:\site\assets\' is set as the file location to load assets fromvar myAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", @"C:\site\assets\");myAdvancedPdf.SaveAs("html-with-assets.pdf");
A manipulação de texto é uma habilidade essencial para qualquer desenvolvedor .NET . Seja para limpar sequências de caracteres para entrada do usuário, formatar dados para análise ou processar texto extraído de documentos, ter as ferramentas certas para o trabalho faz toda a diferença. Ao trabalhar com PDFs, gerenciar e processar texto de forma eficiente pode ser um desafio devido à sua natureza não estruturada. É aí que o IronPDF , uma poderosa biblioteca para trabalhar com PDFs em C#, se destaca.
Neste artigo, exploraremos como aproveitar o método Trim() do C# em combinação com o IronPDF para limpar e processar texto de documentos PDF de forma eficaz.
Compreendendo C# Trim()
O que é o corte de texto?
O método Trim() remove espaços em branco ou caracteres específicos do início e do fim de strings. Por exemplo:
Dim str As String = "!!Hello World!!"
Dim trimmedStart As String = str.TrimStart("!"c) ' "Hello World!!"
Dim trimmedEnd As String = str.TrimEnd("!"c) ' "!!Hello World"
Armadilhas comuns e soluções
1. Exceções de Referência Nula
Chamar Trim() em uma string null gera um erro. Para evitar isso, use o operador de coalescência nula ou verificações condicionais:
string text = null;
string safeTrim = text?.Trim() ?? string.Empty;
string text = null;
string safeTrim = text?.Trim() ?? string.Empty;
string text = null;
string safeTrim = text?.Trim() ?? string.Empty;
Dim text As String = NothingDim safeTrim As String = If(text?.Trim(), String.Empty)
Dim text AsString = NothingDim safeTrim AsString = If(text?.Trim(), String.Empty)
Dim text As String = Nothing
Dim safeTrim As String = If(text?.Trim(), String.Empty)
2. Sobrecarga de Imutabilidade
Como as strings em C# são imutáveis, operações repetidas de Trim() em loops podem degradar o desempenho. Para grandes conjuntos de dados, considere usar Span<t> ou reutilizar variáveis.
3. Corte excessivo de caracteres válidos
Remover caracteres necessários por engano é um erro comum. Sempre especifique os caracteres exatos a serem removidos ao trabalhar com conteúdo que não seja espaço em branco.
4. Espaço em branco Unicode
O método padrão Trim() não lida com certos caracteres de espaço em branco Unicode (por exemplo, \u2003). Para resolver isso, inclua-os explicitamente nos parâmetros de ajuste.
Técnicas avançadas para poda eficiente
Integração de expressões regulares
Para padrões complexos, combine Trim() com expressões regulares. Por exemplo, para substituir vários espaços:
Dim cleanedText As String = Regex.Replace(text, "^\s+|\s+$", "")
Dim cleanedText AsString = Regex.Replace(text, "^\s+|\s+$", "")
Dim cleanedText As String = Regex.Replace(text, "^\s+|\s+$", "")
Otimização de desempenho
Ao processar textos extensos, evite operações repetidas de corte e aparamento. Use StringBuilder para pré-processamento:
var sb = new StringBuilder(text); // Custom extension method to trim once// Assuming a Trim extension method exists for StringBuildersb.Trim();
var sb = new StringBuilder(text); // Custom extension method to trim once// Assuming a Trim extension method exists for StringBuildersb.Trim();
var sb = new StringBuilder(text);
// Custom extension method to trim once
// Assuming a Trim extension method exists for StringBuilder
sb.Trim();
Dim sb = New StringBuilder(text)' Custom extension method to trim once' Assuming a Trim extension method exists for StringBuildersb.Trim()
Dim sb = New StringBuilder(text)' Custom extension method to trim once' Assuming a Trim extension method exists for StringBuildersb.Trim()
Dim sb = New StringBuilder(text)
' Custom extension method to trim once
' Assuming a Trim extension method exists for StringBuilder
sb.Trim()
Lidando com cenários específicos de cada cultura
Enquanto Trim() não é sensível à cultura, você pode usar CultureInfo para aparar sensível ao local em casos raros.
Por que usar o recurso de recorte no processamento de PDFs?
Ao extrair texto de PDFs, você frequentemente encontra caracteres iniciais e finais, como símbolos especiais, espaços desnecessários ou artefatos de formatação. Por exemplo:
Inconsistências de formatação: a estrutura do PDF pode levar a quebras de linha desnecessárias ou caracteres especiais.
Os espaços em branco no final das linhas podem causar desordem na saída de texto, especialmente ao alinhar dados para relatórios.
Ocorrências iniciais e finais de símbolos (por exemplo, *, -) frequentemente aparecem em conteúdo gerado por OCR.
Usando Trim() permite que você limpe o objeto de string atual e o prepare para operações futuras.
Por que escolher o IronPDF para processamento de PDFs?
IronPDF é uma poderosa biblioteca de manipulação de PDF for .NET, projetada para facilitar o trabalho com arquivos PDF. Ele oferece recursos que permitem gerar, editar e extrair conteúdo de PDFs com configuração e esforço de programação mínimos. Aqui estão alguns dos principais recursos que o IronPDF oferece:
Conversão de HTML para PDF: O IronPDF pode converter conteúdo HTML (incluindo CSS, imagens e JavaScript) em PDFs totalmente formatados. Isso é especialmente útil para renderizar páginas da web ou relatórios dinâmicos como PDFs.
Edição de PDF: Com o IronPDF, você pode manipular documentos PDF existentes adicionando texto, imagens e gráficos, além de editar o conteúdo das páginas existentes.
Extração de Texto e Imagem: A biblioteca permite extrair texto e imagens de PDFs, facilitando a análise e a interpretação do conteúdo do PDF.
Preenchimento de formulários: O IronPDF permite o preenchimento de campos de formulário em PDFs, o que é útil para gerar documentos personalizados.
Marca d'água: Também é possível adicionar marcas d'água a documentos PDF para fins de identidade visual ou proteção de direitos autorais.
Benefícios de usar o IronPDF para tarefas de recorte
O IronPDF se destaca no processamento de dados PDF não estruturados, facilitando a extração, limpeza e processamento eficiente de texto. Os casos de uso incluem:
Limpeza dos dados extraídos: Remova espaços em branco ou caracteres desnecessários antes de armazená-los em um banco de dados.
Preparando os dados para análise: Aparar e formatar os dados para melhor legibilidade.
Implementing Text Trimming with IronPDF in C#
Configurando seu projeto IronPDF
Comece instalando o IronPDF via NuGet:
Abra seu projeto no Visual Studio.
Execute o seguinte comando no Console do Gerenciador de Pacotes NuGet :
PM > Install-Package IronPdf
Install-Package IronPdf
Baixe a versão de avaliação gratuita do IronPDF para desbloquear todo o seu potencial, caso ainda não possua uma licença.
Exemplo passo a passo: como remover texto de um PDF
Aqui está um exemplo completo de como extrair texto de um PDF e limpá-lo usando Trim() para remover um caractere especificado:
using IronPdf;public class Program{ public static void Main(string[] args) { // Load a PDF file PdfDocument pdf = PdfDocument.FromFile("trimSample.pdf"); // Extract text from the PDF string extractedText = pdf.ExtractAllText(); // Trim whitespace and unwanted characters string trimmedText = extractedText.Trim('*'); // Display the cleaned text Console.WriteLine($"Cleaned Text: {trimmedText}"); }}
using IronPdf;public class Program{ public static voidMain(string[] args) { // Load a PDF file PdfDocument pdf = PdfDocument.FromFile("trimSample.pdf"); // Extract text from the PDF string extractedText = pdf.ExtractAllText(); // Trim whitespace and unwanted characters string trimmedText = extractedText.Trim('*'); // Display the cleaned textConsole.WriteLine($"Cleaned Text: {trimmedText}"); }}
using IronPdf;

public class Program
{
    public static void Main(string[] args)
    {
        // Load a PDF file
        PdfDocument pdf = PdfDocument.FromFile("trimSample.pdf");

        // Extract text from the PDF
        string extractedText = pdf.ExtractAllText();

        // Trim whitespace and unwanted characters
        string trimmedText = extractedText.Trim('*');

        // Display the cleaned text
        Console.WriteLine($"Cleaned Text: {trimmedText}");
    }
}
Imports IronPdfPublic Class Program Public Shared Sub Main(ByVal args As String()) ' Load a PDF file Dim pdf As PdfDocument = PdfDocument.FromFile("trimSample.pdf") ' Extract text from the PDF Dim extractedText As String = pdf.ExtractAllText() ' Trim whitespace and unwanted characters Dim trimmedText As String = extractedText.Trim("*"c) ' Display the cleaned text Console.WriteLine($"Cleaned Text: {trimmedText}") End SubEnd Class
ImportsIronPdfPublic Class Program PublicShared Sub Main(ByVal args AsString()) ' Load a PDF file Dim pdf AsPdfDocument = PdfDocument.FromFile("trimSample.pdf") ' Extract text from the PDF Dim extractedText AsString = pdf.ExtractAllText() ' Trim whitespace and unwanted characters Dim trimmedText AsString = extractedText.Trim("*"c) ' Display the cleaned textConsole.WriteLine($"Cleaned Text: {trimmedText}") End SubEnd Class
Imports IronPdf

Public Class Program
    Public Shared Sub Main(ByVal args As String())
        ' Load a PDF file
        Dim pdf As PdfDocument = PdfDocument.FromFile("trimSample.pdf")

        ' Extract text from the PDF
        Dim extractedText As String = pdf.ExtractAllText()

        ' Trim whitespace and unwanted characters
        Dim trimmedText As String = extractedText.Trim("*"c)

        ' Display the cleaned text
        Console.WriteLine($"Cleaned Text: {trimmedText}")
    End Sub
End Class
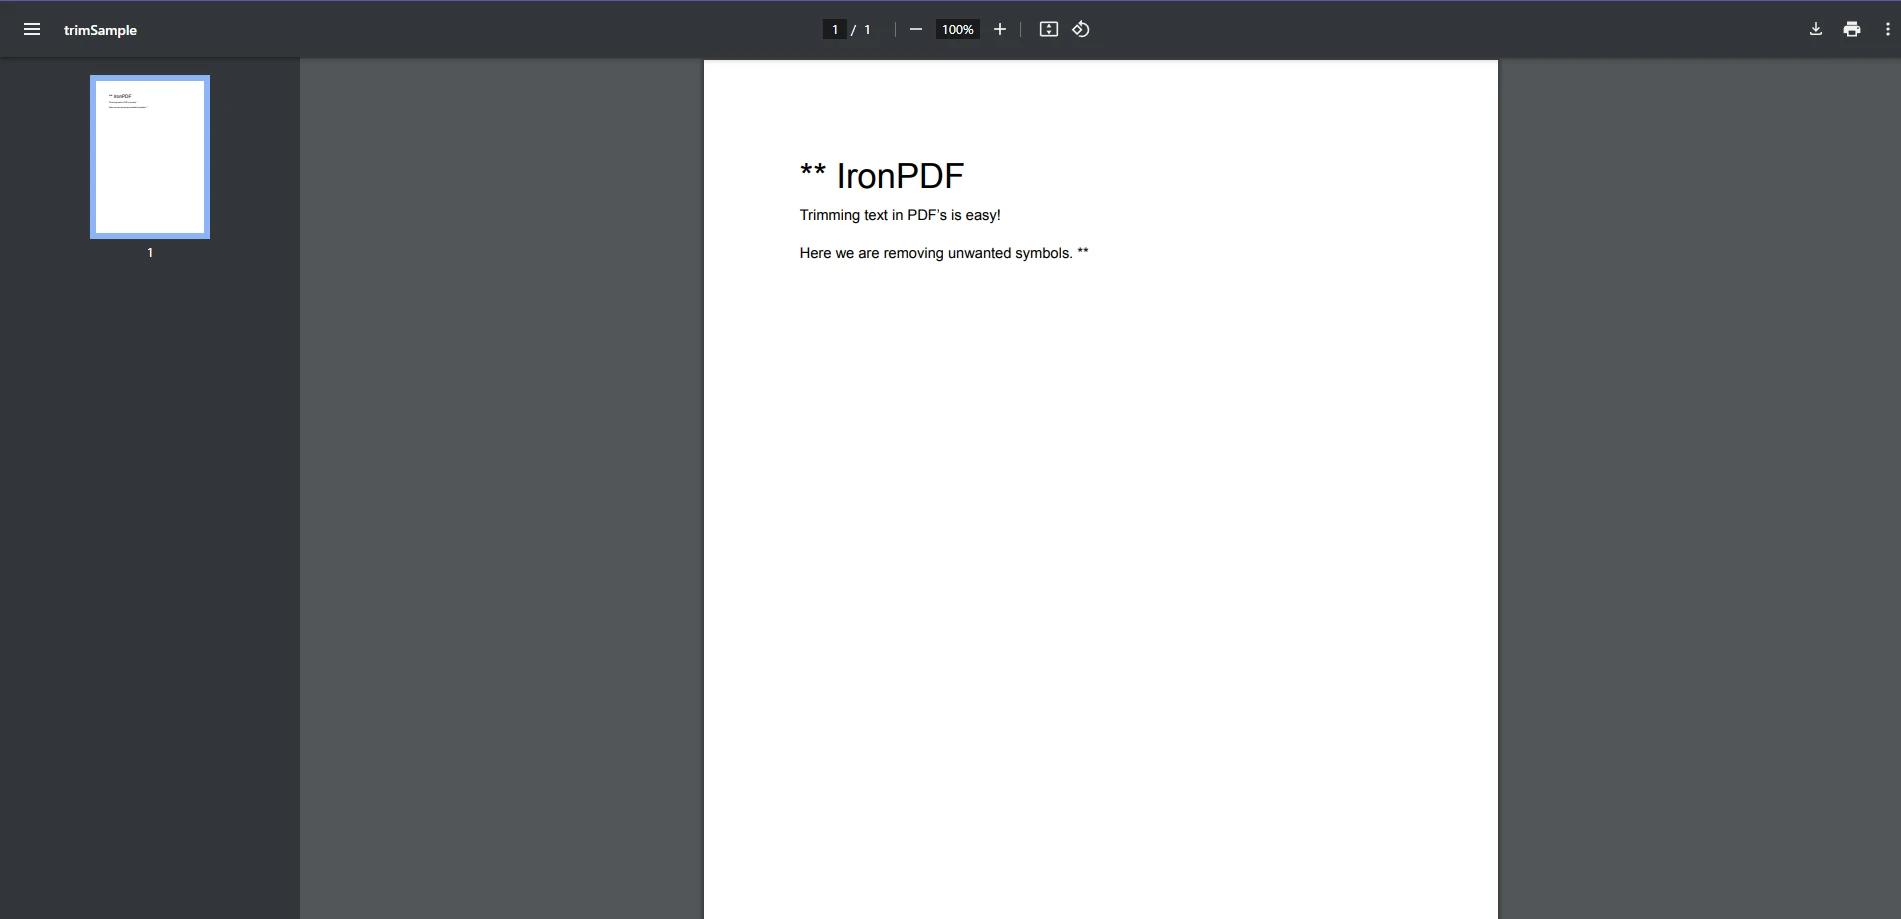
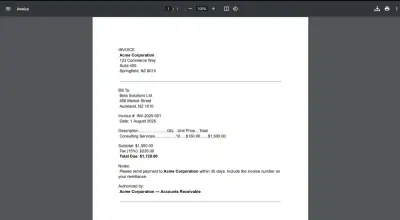
Entrada PDF:
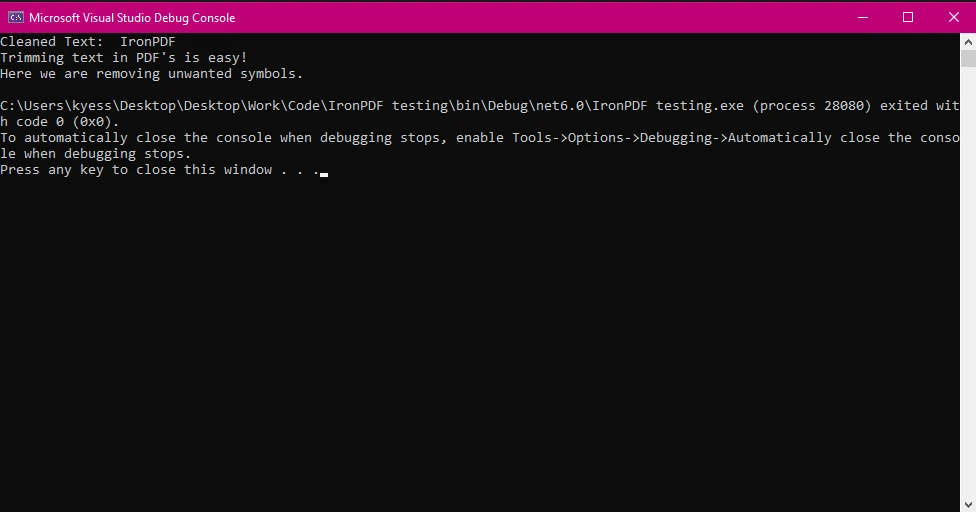
Saída do console:
Explorando aplicações no mundo real
Automatizando o processamento de faturas
Extraia texto de faturas em PDF, remova conteúdo desnecessário e analise detalhes essenciais, como totais ou IDs de faturas. Exemplo:
Utilize o IronPDF para ler os dados da fatura.
Remova os espaços em branco para garantir uma formatação consistente.
Limpeza da saída OCR
O reconhecimento óptico de caracteres (OCR) frequentemente resulta em texto ruidoso. Ao utilizar os recursos de extração de texto e de recorte em C# do IronPDF, você pode limpar a saída para processamento ou análise posterior.
Conclusão
O processamento eficiente de texto é uma habilidade essencial para desenvolvedores .NET , especialmente ao trabalhar com dados não estruturados provenientes de PDFs. O método Trim(), particularmente público string Trim(), combinado com as capacidades do IronPDF, oferece uma maneira confiável de limpar e processar texto removendo espaços em branco iniciais e finais, caracteres especificados e até mesmo caracteres Unicode.
Aplicando métodos como TrimEnd() para remover caracteres finais, ou realizando uma operação de aparo final, você pode transformar texto ruidoso em conteúdo utilizável para relatórios, automação e análise. O método acima permite que os desenvolvedores limpem a string existente com precisão, aprimorando os fluxos de trabalho que envolvem PDFs.
Ao combinar os poderosos recursos de manipulação de PDF do IronPDF com o versátil método Trim() do C#, você pode economizar tempo e esforço no desenvolvimento de soluções que exigem formatação precisa de texto. Tarefas que antes levavam horas - como remover espaços em branco indesejados, limpar textos gerados por OCR ou padronizar dados extraídos - agora podem ser concluídas em minutos.
Leve suas capacidades de processamento de PDF para o próximo nível hoje mesmo - baixe a versão de avaliação gratuita do IronPDF e veja em primeira mão como ele pode transformar sua experiência de desenvolvimento .NET . Seja você um iniciante ou um desenvolvedor experiente, o IronPDF é seu parceiro na criação de soluções mais inteligentes, rápidas e eficientes.
Curtis Chau é bacharel em Ciência da Computação (Universidade Carleton) e se especializa em desenvolvimento front-end, com experiência em Node.js, TypeScript, JavaScript e React. Apaixonado por criar interfaces de usuário intuitivas e esteticamente agradáveis, Curtis gosta de trabalhar com frameworks modernos e criar manuais bem estruturados e visualmente atraentes.