在今天的教程中,我们将探索如何使用两个强大的PDF库,IronPDF 和 PDFSharp从PDF文档中提取文本。 我们将学习如何使用这些工具进行文本提取,而无需拥有Adobe库许可,并比较它们之间的区别。
有几十个专注于PDF的库可供选择,通过花时间比较它们并了解其功能如何运作,您将能够为您的项目需求挑选合适的库。 文本提取只是您可能需要在PDF上执行的众多任务之一,文本提取在需要高效读取或解析PDF文件数据的情况下尤为有用。
PDFSharp
PDFSharp是一个开源的.NET库,专为程序化创建和修改PDF文档而设计。 虽然它的主要优势在于PDF生成和操作,但在与合适的外部库配合使用时,它也提供了读取现有PDF文件和提取内容的基本工具。
PDFSharp不仅可以创建新的PDF文档,还可以用于修改现有PDF文件、合并和拆分文档、添加注释等。
IronPDF
IronPDF是一个专业级别的.NET库,设计用于简化在C#中处理PDF文档的过程。 它是一个功能丰富的工具,专为开发涉及PDF生成、操作、PDF加密、转换PDF文件、合并PDF页面、HTML到PDF转换、内容提取等应用程序的开发人员设计。
凭借其强大的功能,IronPDF作为在小型项目和企业级别应用中创建和管理PDF的多功能解决方案而脱颖而出。
IronPDF旨在兼容现代的.NET框架,包括.NET Core、.NET 5、.NET 6 和 .NET 7,以及像.NET Framework这样的旧版本。 它在Windows、macOS和Linux操作系统上无缝工作,并且与Docker、Azure和AWS环境完全兼容。 这确保了开发人员可以在任何平台或云服务上部署其PDF工作流。
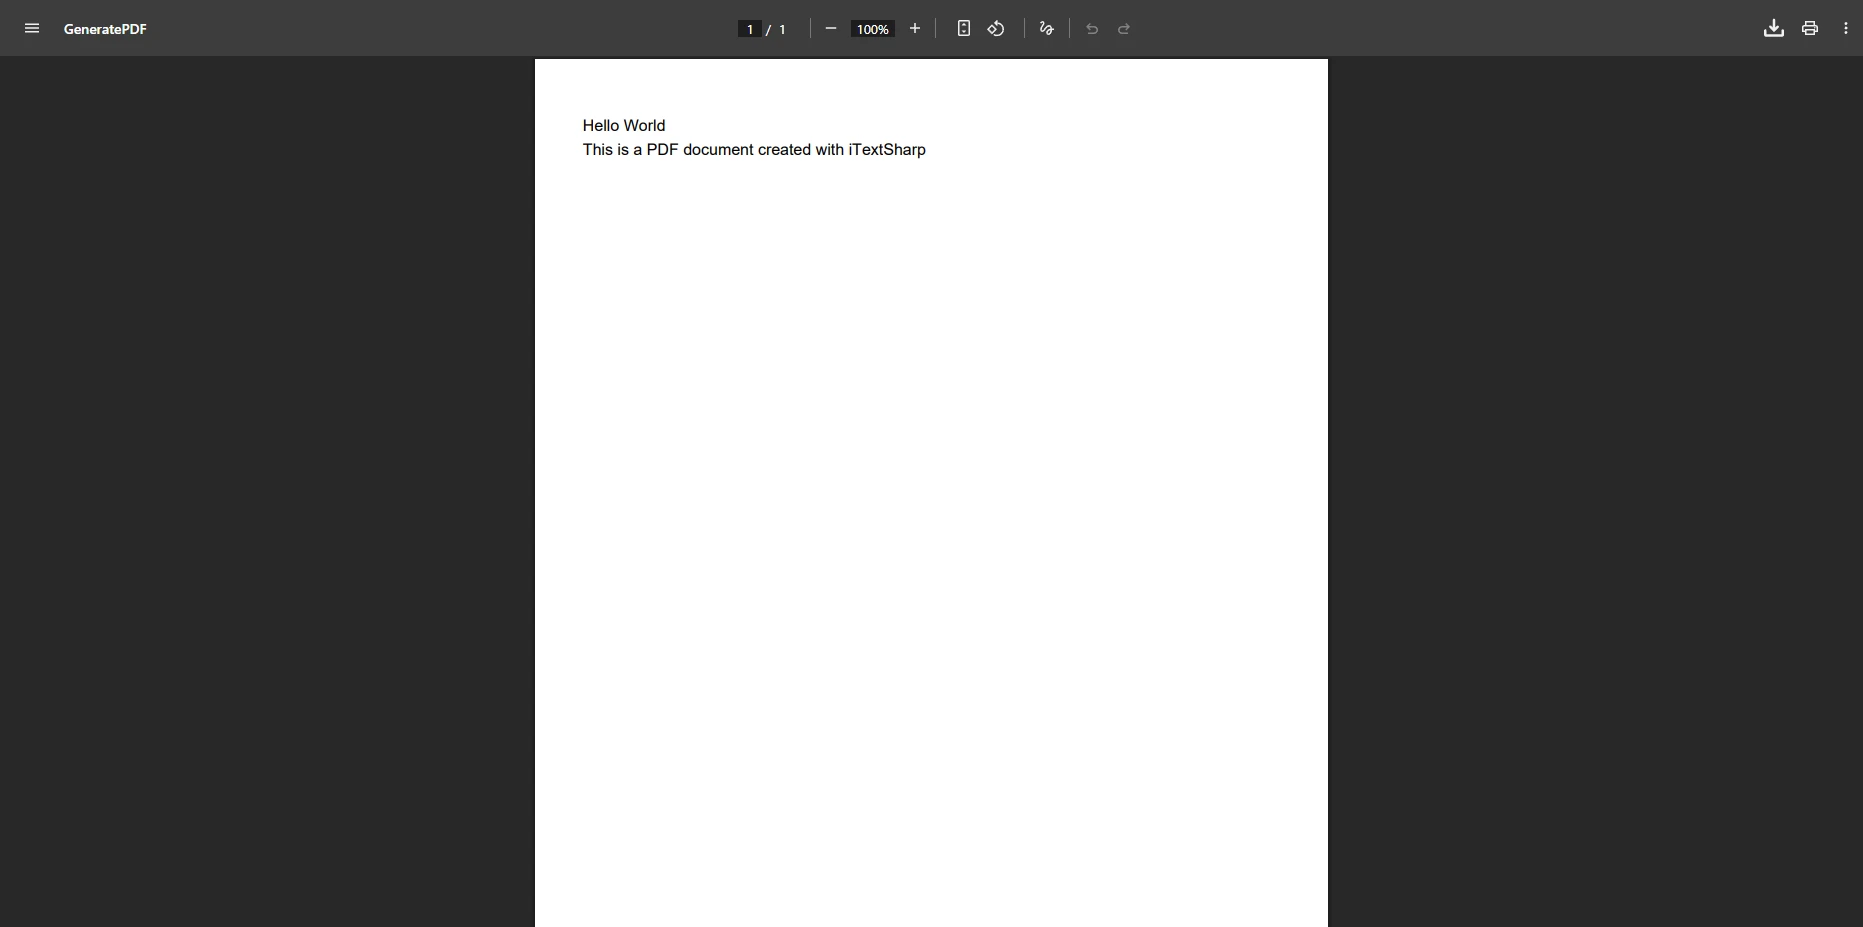
对于今天的示例,我们将在Visual Studio中尝试从此PDF文档中提取文本:
使用PDFSharp从PDF文件中提取文本
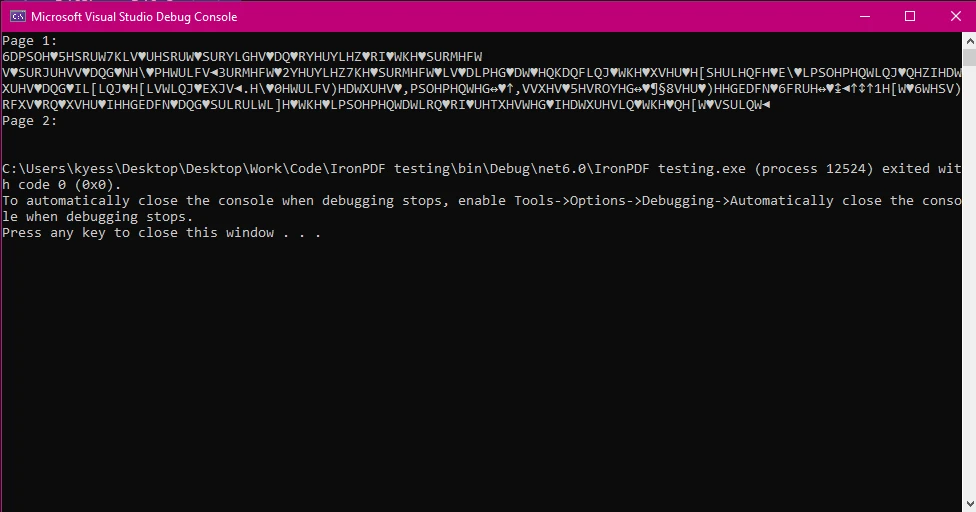
PDFSharp在其当前版本中不具备从PDF文档中提取文本的本机支持。 它主要设计用于创建和操作PDF,例如绘制图形、添加内容和合并文档,但缺乏一个内置的机制,无法单独提取文本,无法处理特殊字符、复杂编码等。 它可能会产生碎片或不完整的文本输出,或者输出为空白字符串而非实际的PDF内容。 例如:
如果您需要支持不同字体、编码和布局的高级文本提取,您可能需要使用更加专业化的库,例如:
-
iText:(或称iText):这是一个流行的PDF库,具有强大的文本提取和解析功能。
-
**Pdfium:**另一个擅长提取文本的选项,尤其擅长从具有复杂格式的 PDF 中提取文本。
使用IronPDF从PDF文件中提取文本
现在,让我们看看如何使用IronPDF来处理文本提取。 IronPDF的文本提取功能为开发人员提供了一种简洁且强大的方法,可以高效地从PDF文档中提取文本,而无需额外的代码来正确格式化数据字符串以转换为可读文本。
using IronPdf;

public class Program
{
    public static void Main(string[] args)
    {
        // Provide the file path to the PDF document
        string pdfPath = @"invoice.pdf";

        // Load the PDF document using IronPDF
        var pdf = PdfDocument.FromFile(pdfPath);

        // Extract all text from the PDF
        var extractedText = pdf.ExtractAllText();

        // Output the extracted text to the console
        Console.WriteLine(extractedText);
    }
}
using IronPdf;

public class Program
{
    public static void Main(string[] args)
    {
        // Provide the file path to the PDF document
        string pdfPath = @"invoice.pdf";

        // Load the PDF document using IronPDF
        var pdf = PdfDocument.FromFile(pdfPath);

        // Extract all text from the PDF
        var extractedText = pdf.ExtractAllText();

        // Output the extracted text to the console
        Console.WriteLine(extractedText);
    }
}
Imports IronPdf
Public Class Program
Public Shared Sub Main(args As String())
' Provide the file path to the PDF document
Dim pdfPath As String = "invoice.pdf"
' Load the PDF document using IronPDF
Dim pdf = PdfDocument.FromFile(pdfPath)
' Extract all text from the PDF
Dim extractedText = pdf.ExtractAllText()
' Output the extracted text to the console
Console.WriteLine(extractedText)
End Sub
End Class
Imports IronPdf

Public Class Program
    Public Shared Sub Main(args As String())
        ' Provide the file path to the PDF document
        Dim pdfPath As String = "invoice.pdf"

        ' Load the PDF document using IronPDF
        Dim pdf = PdfDocument.FromFile(pdfPath)

        ' Extract all text from the PDF
        Dim extractedText = pdf.ExtractAllText()

        ' Output the extracted text to the console
        Console.WriteLine(extractedText)
    End Sub
End Class
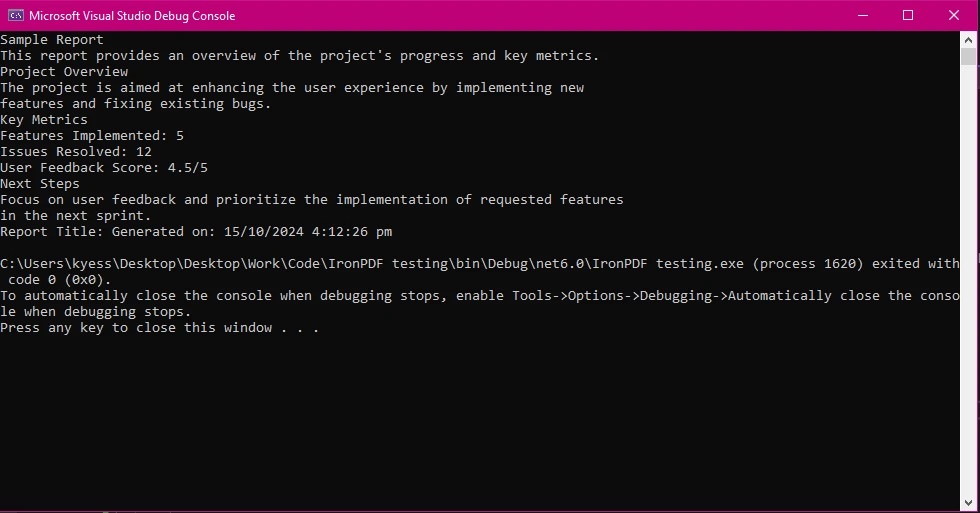
IronPDF提供了简单高效的API,用于从给定的PDF路径中提取文本。 它确保提取的文本结构良好且准确,为需要在其应用程序中处理PDF内容的开发人员提供了可靠的选择。
比较
PDFSharp是一个理想的用于基本PDF创建和操作的免费开源库,但它的功能有限,处理复杂PDF时存在困难。 理论上,它可以用于从PDF文件中提取文本,但这需要高级文本解析,并可能导致输出碎片化。
IronPDF提供了更健壮的解决方案,具有高级功能,如准确的文本提取、HTML到PDF转换,以及对现代PDF标准的支持。 它针对性能和易用性进行优化,且具有直观的API。 虽然它对开发是免费的,但它也为其付费许可层提供 商业许可。
结论
PDFSharp和IronPDF都是在C#中从PDF中提取文本的有价值工具,但它们适合不同的使用场景:
- PDFSharp是需要免费开源库进行基本PDF创建和文本提取的开发人员的绝佳选择。 然而,其文本提取能力有限,可能无法满足更复杂应用程序的需求。
- IronPDF则在文本提取、HTML到PDF转换和高级PDF编辑任务方面表现出色。 凭借其易用性、跨平台兼容性和广泛的功能,成为开发人员处理专业级PDF工作流的首选。
要深入了解IronPDF如何优于其他库,请访问官方的IronPDF文档。
PDFSharp 是其各自所有者的注册商标。 本网站与PDFSharp无任何关联,亦未获得其认可或赞助。所有产品名称、标识和品牌均为其各自所有者的财产。 比较仅供参考,反映撰写时公开可用的信息。