Dans le tutoriel d'aujourd'hui, nous explorerons comment extraire du texte de documents PDF à l'aide de deux puissantes bibliothèques PDF, IronPDF et PDFSharp. Nous apprendrons comment fonctionne l'extraction de texte avec ces outils sans avoir besoin de posséder une licence de bibliothèque Adobe et comment ils se comparent les uns aux autres.
Il existe des dizaines de bibliothèques axées sur le PDF parmi lesquelles choisir, et en prenant le temps de les comparer et d'apprendre comment leurs fonctionnalités fonctionnent, vous pourrez choisir la bonne bibliothèque pour les besoins de votre projet. L'extraction de texte n'est qu'un des nombreux exemples de tâches que vous pourriez avoir besoin d'effectuer sur vos PDF, l'extraction de texte étant utile dans des situations où vous pourriez avoir besoin de lire ou d'analyser efficacement des données à partir de fichiers PDF.
PDFSharp
PDFSharp est une bibliothèque .NET open-source conçue pour la création et la modification de documents PDF de manière programmatique. Bien que sa force principale réside dans la génération et la manipulation de PDF, elle fournit également des outils de base pour lire des fichiers PDF existants et extraire du contenu, lorsqu'elle est associée aux bonnes bibliothèques externes.
PDFSharp peut faire plus qu'au-delà de la création de nouveaux documents PDF à la volée, il peut être utilisé pour modifier des fichiers PDF existants, fusionner et diviser des documents, ajouter des annotations, et plus.
IronPDF
IronPDF est une bibliothèque .NET de niveau professionnel conçue pour simplifier le processus de travail avec des documents PDF en C#. C'est un outil riche en fonctionnalités destiné aux développeurs construisant des applications impliquant la génération de PDF, la modification, le chiffrement PDF, la conversion de fichiers PDF, la fusion de pages PDF, la conversion HTML en PDF, l'extraction de contenu et plus encore.
Avec ses capacités robustes, IronPDF se distingue comme une solution polyvalente pour créer et gérer des PDF dans des projets de petite taille comme dans des applications de niveau entreprise.
IronPDF est conçu pour être compatible avec les frameworks .NET modernes, y compris .NET Core, .NET 5, .NET 6 et .NET 7, ainsi que les versions anciennes comme .NET Framework. Il fonctionne parfaitement sur des systèmes d'exploitation comme Windows, macOS et Linux, et est entièrement compatible avec les environnements Docker, Azure et AWS. Cela garantit que les développeurs peuvent déployer leurs flux de travail PDF sur n'importe quelle plateforme ou service cloud.
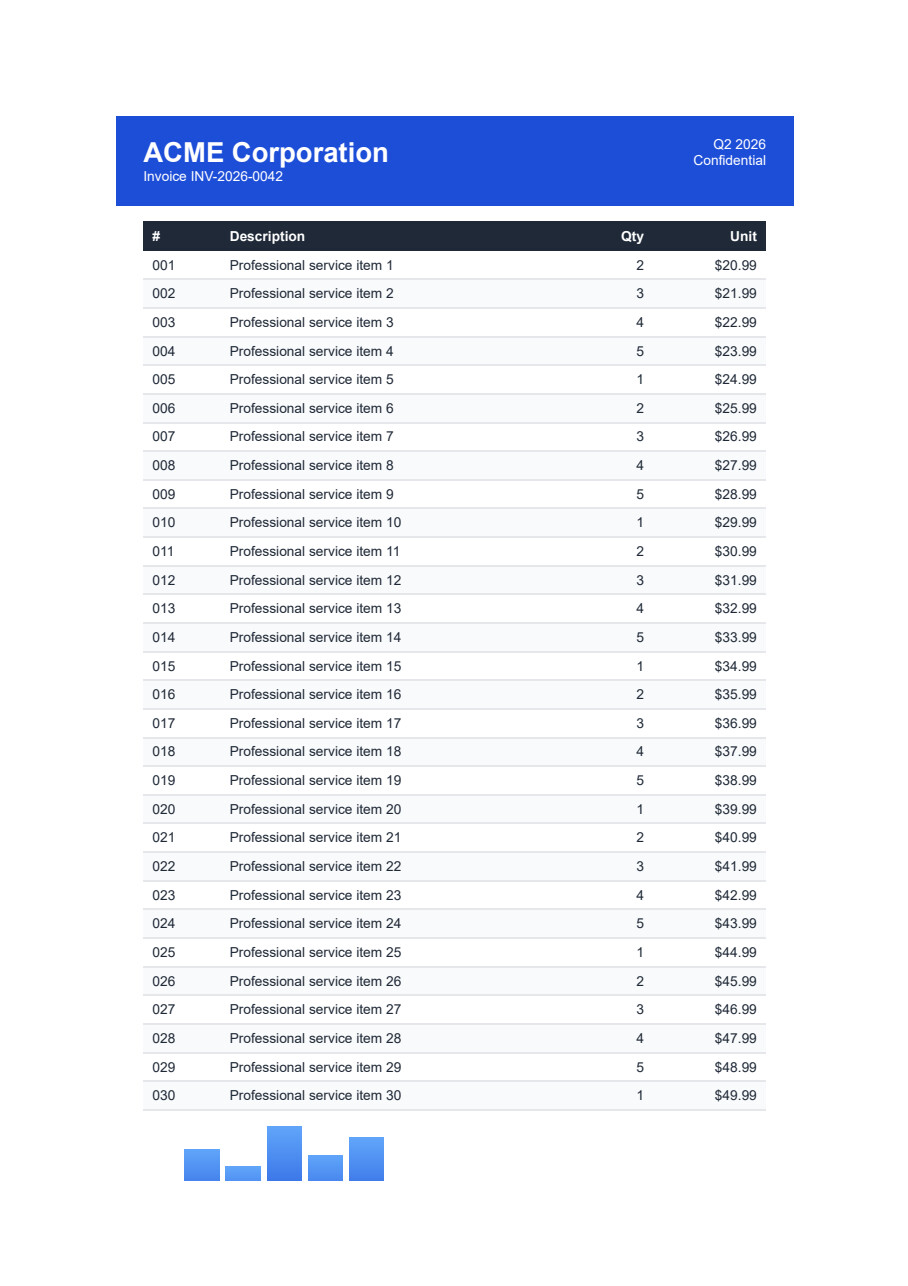
Pour l'exemple d'aujourd'hui, nous allons essayer d'extraire du texte de ce document PDF dans Visual Studio :
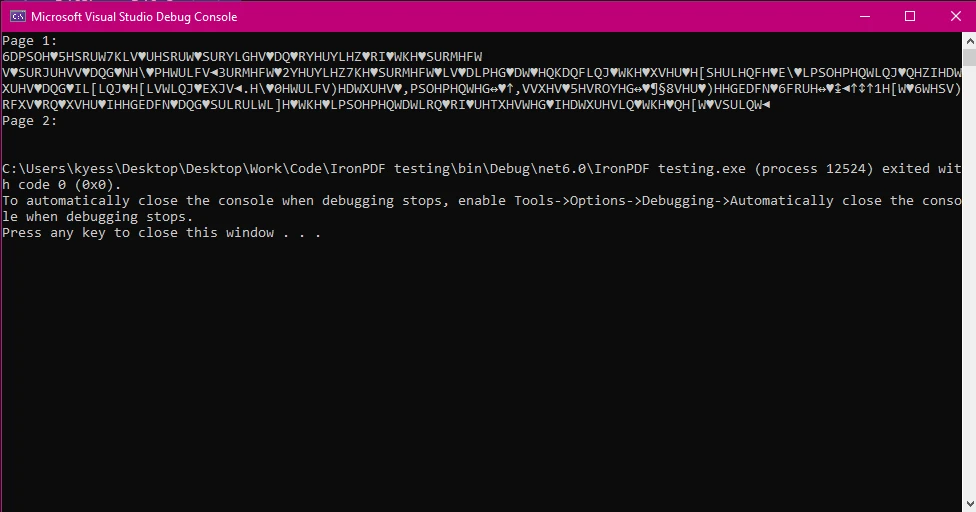
PDFSharp, dans sa version actuelle, ne prend pas en charge nativement l'extraction de texte à partir de documents PDF. Elle est principalement conçue pour créer et manipuler des PDF, comme dessiner des graphiques, ajouter du contenu, et fusionner des documents, mais elle manque d'un mécanisme intégré pour extraire du texte par elle-même, incapable de gérer les caractères spéciaux, l'encodage avancé, etc. Elle peut produire une sortie de texte fragmentée ou incomplète, ou des chaînes vides au lieu du contenu PDF réel. Par exemple :
Si vous avez besoin d'une extraction de texte avancée avec un meilleur support pour différentes polices, encodages et mises en page, vous devrez probablement utiliser une bibliothèque plus spécialisée, telle que :
-
iText (ou iText) : C'est une bibliothèque PDF populaire avec un support solide pour l'extraction et l'analyse de texte.
-
Pdfium : Une autre option qui excelle dans l'extraction de texte, notamment à partir de PDF avec une mise en forme complexe.
Voyons maintenant comment l'extraction de texte est gérée avec IronPDF. La fonction d'extraction de texte d'IronPDF offre aux développeurs une méthode efficace et puissante pour extraire du texte des PDF sans code supplémentaire pour le formatage.
using IronPdf;

public class Program
{
    public static void Main(string[] args)
    {
        // Provide the file path to the PDF document
        string pdfPath = @"invoice.pdf";

        // Load the PDF document using IronPDF
        var pdf = PdfDocument.FromFile(pdfPath);

        // Extract all text from the PDF
        var extractedText = pdf.ExtractAllText();

        // Output the extracted text to the console
        Console.WriteLine(extractedText);
    }
}
using IronPdf;

public class Program
{
    public static void Main(string[] args)
    {
        // Provide the file path to the PDF document
        string pdfPath = @"invoice.pdf";

        // Load the PDF document using IronPDF
        var pdf = PdfDocument.FromFile(pdfPath);

        // Extract all text from the PDF
        var extractedText = pdf.ExtractAllText();

        // Output the extracted text to the console
        Console.WriteLine(extractedText);
    }
}
Imports IronPdf
Public Class Program
Public Shared Sub Main(args As String())
' Provide the file path to the PDF document
Dim pdfPath As String = "invoice.pdf"
' Load the PDF document using IronPDF
Dim pdf = PdfDocument.FromFile(pdfPath)
' Extract all text from the PDF
Dim extractedText = pdf.ExtractAllText()
' Output the extracted text to the console
Console.WriteLine(extractedText)
End Sub
End Class
Imports IronPdf

Public Class Program
    Public Shared Sub Main(args As String())
        ' Provide the file path to the PDF document
        Dim pdfPath As String = "invoice.pdf"

        ' Load the PDF document using IronPDF
        Dim pdf = PdfDocument.FromFile(pdfPath)

        ' Extract all text from the PDF
        Dim extractedText = pdf.ExtractAllText()

        ' Output the extracted text to the console
        Console.WriteLine(extractedText)
    End Sub
End Class
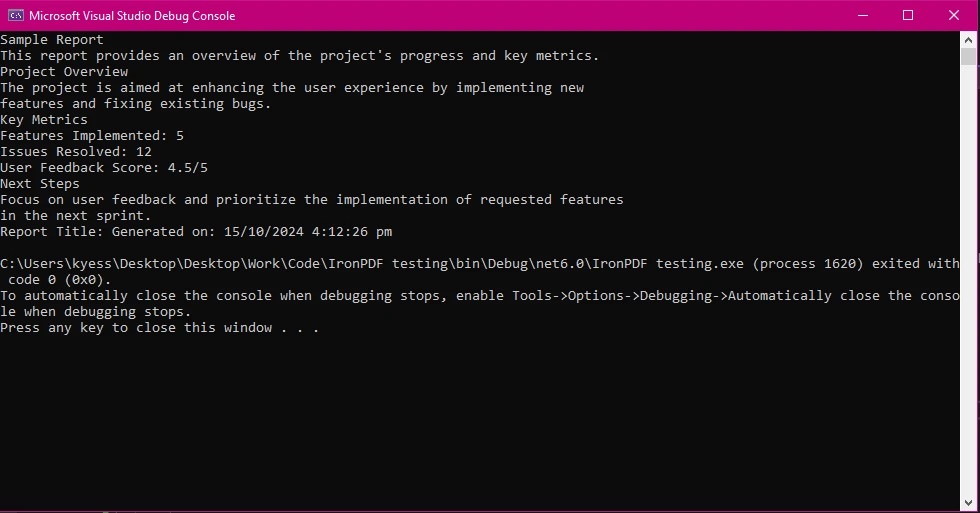
IronPDF fournit une API simple et efficace pour extraire du texte à partir du chemin PDF donné. Il garantit que le texte extrait est bien structuré et précis, ce qui en fait une option fiable pour les développeurs qui ont besoin de traiter le contenu PDF dans leurs applications.
Comparaison
PDFSharp est une bibliothèque open-source gratuite idéale pour la création et la manipulation de PDF de base, mais elle a des fonctionnalités limitées et a du mal avec les PDF complexes. Bien qu'en théorie, elle puisse être utilisée pour extraire du texte des fichiers PDF, cela nécessiterait une analyse de texte avancée et pourrait produire une sortie fragmentée.
IronPDF offre une solution plus robuste avec des fonctionnalités avancées telles que l'extraction de texte précise, la conversion HTML en PDF, et le support des normes PDF modernes. Il est optimisé pour la performance et la facilité d'utilisation avec une API intuitive. Bien qu'il soit gratuit pour le développement, il offre également des licences commerciales pour ses paliers de licence payante.
Conclusion
PDFSharp et IronPDF sont tous deux des outils précieux pour travailler avec l'extraction de texte à partir de PDF en C#, mais ils répondent à différents cas d'utilisation :
- PDFSharp est un excellent choix pour les développeurs qui ont besoin d'une bibliothèque open-source gratuite pour la création de base de PDF et l'extraction de texte. Cependant, ses capacités d'extraction de texte sont limitées et peuvent ne pas répondre aux besoins d'applications plus complexes.
- IronPDF, en revanche, excelle dans l'extraction de texte, la conversion HTML en PDF et les tâches d'édition avancée de PDF. Sa facilité d'utilisation, sa compatibilité multiplateforme et sa large gamme de fonctionnalités en font un choix privilégié pour les développeurs gérant des flux de travail PDF de qualité professionnelle.
Pour une exploration plus approfondie de la façon dont IronPDF surpasse d'autres bibliothèques, visitez la Documentation d'IronPDF officielle.
PDFSharp est une marque déposée de son propriétaire respectif. Ce site n'est ni affilié à, ni approuvé par, ni sponsorisé par PDFSharp. Tous les noms de produits, logos et marques appartiennent à leurs propriétaires respectifs. Les comparaisons sont à titre informatif uniquement et reflètent les informations publiquement disponibles au moment de l'écriture.