In diesem Tutorial werden wir untersuchen, wie man Text aus PDF-Dokumenten (Portable Document Format) in C# mit zwei verschiedenen PDF-Bibliotheken extrahiert.
In der heutigen modernen Web-Ära gibt es eine Reihe von Bibliotheken, die in der Lage sind, Text und Bilder aus PDF-Dateien zu extrahieren, um sie zu parsen und zu lesen. Heute werden wir zwei leistungsstarke PDF-Bibliotheken, IronPDF und QuestPDF, verwenden, um Text aus einer PDF-Datei zu extrahieren. Indem wir vergleichen, wie diese beiden Bibliotheken eine einfache Textextraktionsaufgabe bewältigen, können wir feststellen, welche sich besser für die Bearbeitung solcher fortgeschrittener PDF-Aufgaben eignet. Bevor wir in den Vergleichsabschnitt eintauchen, wollen wir uns zunächst einen kurzen Überblick über jede Bibliothek verschaffen.
QuestPDF
QuestPDF ist eine hochmoderne, Open-Source-PDF-Generierungsbibliothek, die speziell für .NET-Entwickler entwickelt wurde. Sie verwendet eine moderne deklarative API, die es Benutzern ermöglicht, komplexe PDF-Layouts mit großer Flexibilität und Präzision zu definieren und zu erstellen. Während QuestPDF sich in erster Linie auf die Dokumentenerstellung und nicht auf die Textextraktion konzentriert, bietet es einen sauberen, intuitiven Ansatz zum Aufbau von Dokumenten von Grund auf und zur Manipulation verschiedener Elemente innerhalb des Dokuments. Dies macht es besonders gut geeignet für Anwendungen, die angepasste, dynamische PDF-Inhalte erfordern.
IronPDF
IronPDF ist eine vielseitige PDF-Verarbeitungsbibliothek, die entwickelt wurde, um das Arbeiten mit PDFs in C# einfacher und effizienter zu gestalten. Im Gegensatz zu QuestPDF ist IronPDF speziell für die PDF-Erstellung und -Bearbeitung konzipiert. Die Funktionen, die es bietet, umfassen PDF Verschlüsselung, umfassende Unterstützung für das Bearbeiten und Annotieren vorhandener PDFs, das Konvertieren verschiedener Dokumente ins PDF-Format, das Hinzufügen von Kopf- und Fußzeilen (die verwendet werden können, um Seitenzahlen anzuzeigen), das Bearbeiten von Dokumentmetadaten, Multithreading- und asynchrone Unterstützung sowie erweiterte PDF-Konvertierungstools.
Zusätzlich zu seinem umfangreichen Funktionsumfang bietet IronPDF vollständige plattformübergreifende Unterstützung und Support for .NET 5/6/7, .NET Core und .NET Framework. Es ist auch vollständig kompatibel mit Windows, macOS, Linux und Cloud-Plattformen wie Azure und AWS, was es zu einer ausgezeichneten Wahl für plattformübergreifende .NET-Anwendungen macht.
Für das heutige Beispiel werden wir Text aus unserem Beispiel-Rechnung-PDF-Dokument mit beiden Bibliotheken extrahieren.
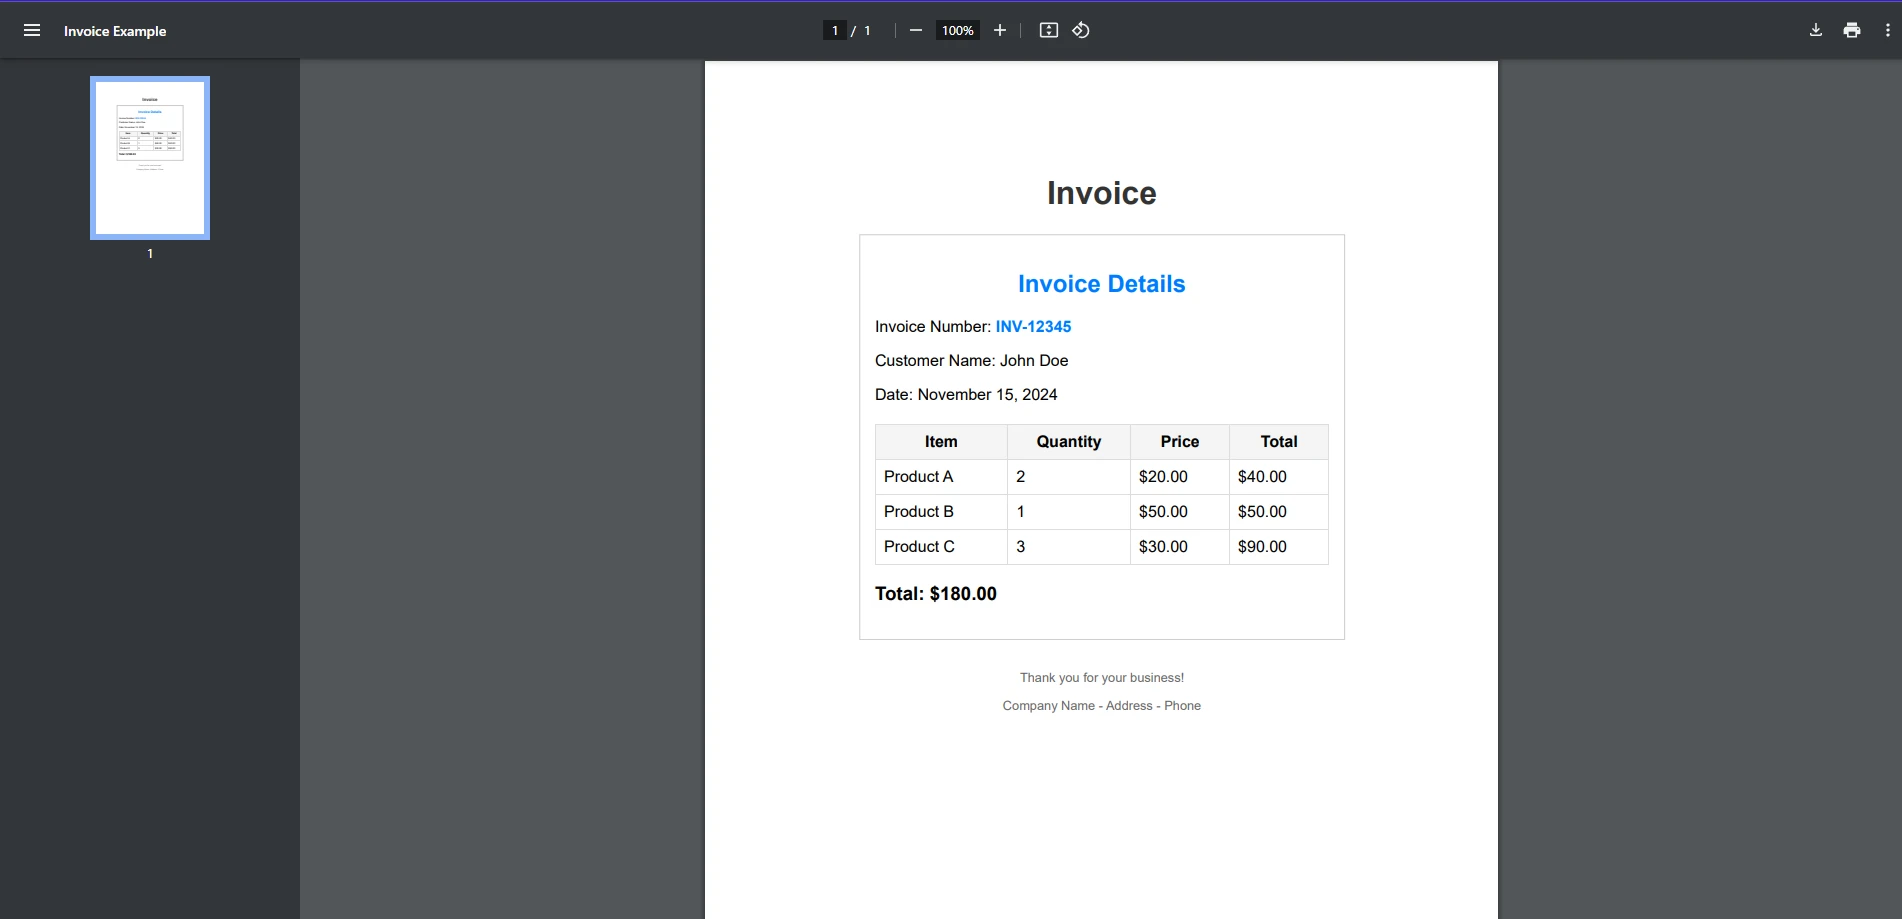
Zuerst schauen wir, ob QuestPDF diese Aufgabe bewältigen kann.
Leider, während QuestPDF hervorragend im Handling der PDF-Erstellung und der Leistung bestimmter PDF-Aufgaben ist, gehört die Textextraktion nicht zu den Funktionen, die es derzeit anbietet. Obwohl QuestPDF nicht von Natur aus für die Textextraktion aus bestehenden PDF-Dateien entwickelt wurde, bietet es grundlegende Werkzeuge für die Arbeit mit PDFs, die durch zusätzliches Logik oder Drittanbieter-Integrationen zur Textextraktion erweitert werden können. So könnte QuestPDF beispielsweise zur Generierung von PDF-Dokumenten mit strukturierten Inhalten verwendet werden, und Sie könnten eine benutzerdefinierte Lösung implementieren, um Inhalte basierend auf der Dokumentstruktur mit einer Drittanbieter-Bibliothek zu extrahieren.
Textextraktion ist nur eine der Aufgaben, bei denen IronPDF bei der Arbeit mit PDFs glänzt. In nur wenigen Codezeilen können wir den Text aus einem gesamten PDF-Dokument extrahieren. Dies kann im folgenden Codeausschnitt sehen:
using IronPdf;

public class Program
{
    public static void Main(string[] args)
    {
        // Load the PDF document
        PdfDocument pdf = PdfDocument.FromFile("exampleInvoice.pdf");

        // Extract all the text from the loaded PDF document
        string text = pdf.ExtractAllText();

        // Print the extracted text to the console
        Console.WriteLine(text);
    }
}
using IronPdf;

public class Program
{
    public static void Main(string[] args)
    {
        // Load the PDF document
        PdfDocument pdf = PdfDocument.FromFile("exampleInvoice.pdf");

        // Extract all the text from the loaded PDF document
        string text = pdf.ExtractAllText();

        // Print the extracted text to the console
        Console.WriteLine(text);
    }
}
Imports IronPdf
Public Class Program
Public Shared Sub Main(args As String())
' Load the PDF document
Dim pdf As PdfDocument = PdfDocument.FromFile("exampleInvoice.pdf")
' Extract all the text from the loaded PDF document
Dim text As String = pdf.ExtractAllText()
' Print the extracted text to the console
Console.WriteLine(text)
End Sub
End Class
Imports IronPdf

Public Class Program
    Public Shared Sub Main(args As String())
        ' Load the PDF document
        Dim pdf As PdfDocument = PdfDocument.FromFile("exampleInvoice.pdf")

        ' Extract all the text from the loaded PDF document
        Dim text As String = pdf.ExtractAllText()

        ' Print the extracted text to the console
        Console.WriteLine(text)
    End Sub
End Class
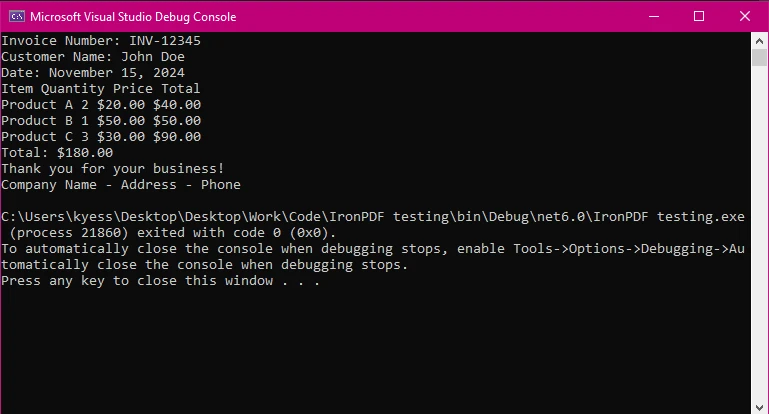
Ausgabedatei
Vergleich
IronPDF bietet eine einfache API zur Textextraktion, die ideal für Entwickler ist, die sich auf Effizienz konzentrieren. In nur drei Zeilen konnten wir den Textinhalt in unserem PDF-Dokument extrahieren und ihn zur Ansicht darstellen. Von hier aus könnten Sie den extrahierten Text leicht für weitere Verwendung oder Bearbeitung speichern.
QuestPDF hingegen konnte eine Aufgabe wie die Textextraktion aufgrund einer begrenzteren Anzahl von Funktionen im Vergleich zu Bibliotheken wie IronPDF nicht bewältigen. Während es andere Aufgaben wie die PDF-Erstellung und grundlegende Manipulation beherrscht, müssten Sie externe Bibliotheken implementieren, um Text zu extrahieren.
Abschluss
Wenn es darum geht, Text zu extrahieren, ist QuestPDF durch die Nutzung seiner Community-Lizenz für private Projekte kostenlos, bietet aber auch die Option von kommerziellen Lizenzen.
Beide Bibliotheken sind genau und zuverlässig, aber die Wahl hängt letztendlich von den Anforderungen Ihres Projekts ab.
Für einen tieferen Vergleich dieser Bibliotheken lesen Sie den vollständigen Blog auf IronPDF vs QuestPDF.
QuestPDF ist ein eingetragenes Warenzeichen seines jeweiligen Eigentümers. Diese Website ist nicht mit QuestPDF verbunden, wird nicht von QuestPDF unterstützt oder gesponsert. Alle Produktnamen, Logos und Marken sind Eigentum ihrer jeweiligen Eigentümer. Vergleiche dienen nur zu Informationszwecken und spiegeln öffentlich zugängliche Informationen zum Zeitpunkt des Schreibens wider.