Pour ce tutoriel, nous allons voir comment extraire du texte à partir de documents PDF (Portable Document Format) en C# en utilisant deux bibliothèques PDF différentes.
À l'ère moderne du web d'aujourd'hui, il existe un certain nombre de bibliothèques capables d'extraire du texte et des images à partir de fichiers PDF pour leur analyse et leur lecture. Aujourd'hui, nous utiliserons deux puissantes bibliothèques PDF, IronPDF et QuestPDF, pour extraire du texte d'un fichier PDF. En comparant comment ces deux bibliothèques gèrent une tâche simple d'extraction de texte, nous pouvons déterminer laquelle pourrait être mieux adaptée pour gérer de telles tâches PDF avancées. Avant de passer à la section de comparaison, prenons d'abord un moment pour regarder une brève introduction de chaque bibliothèque.
QuestPDF
QuestPDF est une bibliothèque de génération de PDF de pointe et open source conçue spécifiquement pour les développeurs .NET. Elle utilise une API déclarative moderne qui permet aux utilisateurs de définir et de générer des mises en page PDF complexes avec une grande flexibilité et précision. Bien que l'objectif principal de QuestPDF soit la génération de documents plutôt que l'extraction de texte, elle offre une approche simple et intuitive pour construire des documents à partir de zéro et manipuler différents éléments au sein du document. Cela la rend particulièrement bien adaptée pour les applications nécessitant un contenu PDF personnalisé et dynamique.
IronPDF
IronPDF est une bibliothèque de traitement PDF polyvalente conçue pour faciliter et rendre plus efficace le travail avec les PDF en C#. Contrairement à QuestPDF, IronPDF est spécifiquement conçu pour la génération et la manipulation des PDF. Les fonctionnalités qu'elle offre incluent l'encryption des PDF, un support étendu pour l'édition et l'annotation des PDF existants, la conversion de divers documents en format PDF, l'ajout de en-têtes et pieds de page (qui peuvent être utilisés pour afficher des numéros de page), l'édition des métadonnées du document, le support du multithreading et asynchrone, et des outils avancés de conversion PDF.
En plus de son ensemble riche en fonctionnalités, IronPDF offre un support complet multiplateforme, prenant en charge .NET 5/6/7, .NET Core et .NET Framework. Elle est également entièrement compatible avec Windows, macOS, Linux et les plateformes cloud comme Azure et AWS, en faisant un excellent choix pour les applications .NET multiplateformes.
Pour l'exemple d'aujourd'hui, nous allons extraire du texte de notre document PDF de facture exemple en utilisant les deux bibliothèques.
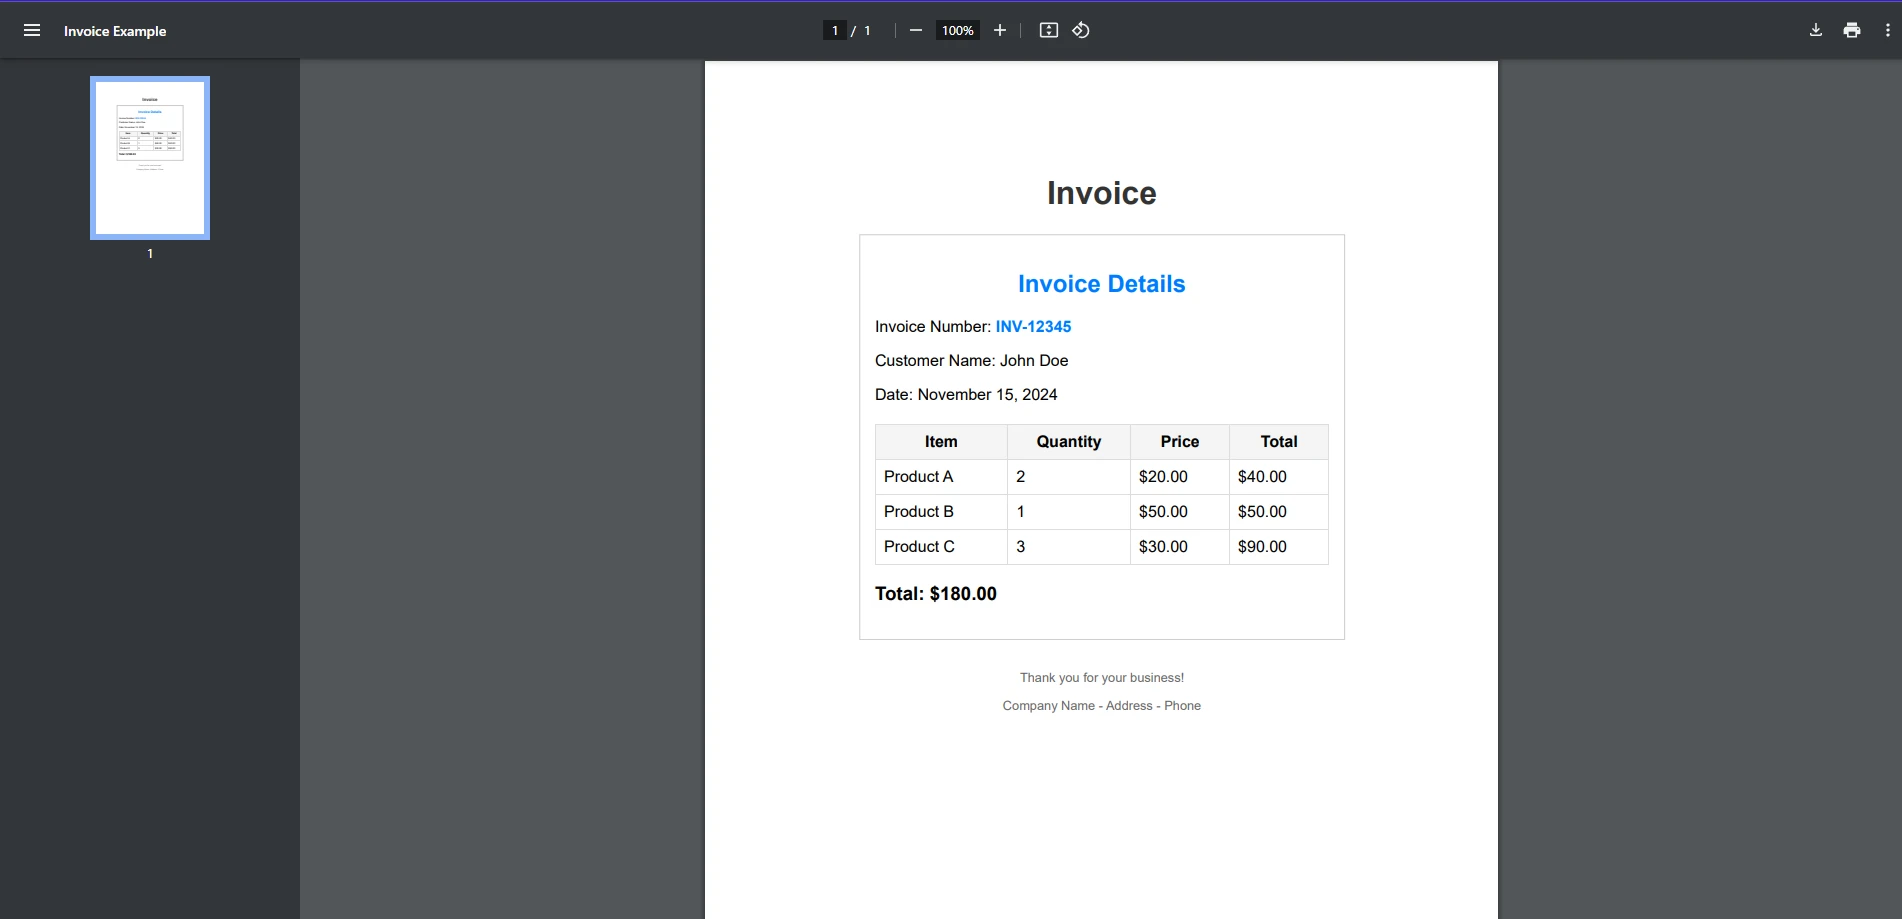
D'abord, nous allons voir si QuestPDF peut gérer cette tâche.
Malheureusement, bien que QuestPDF excelle à créer des PDF et à effectuer certaines tâches PDF, l'extraction de texte ne fait pas partie des fonctionnalités qu'elle propose actuellement. Bien que QuestPDF ne soit pas intrinsèquement conçu pour extraire du texte des fichiers PDF existants, elle fournit des outils de base pour travailler avec les PDF, qui peuvent être étendus pour l'extraction de texte avec de la logique supplémentaire ou des intégrations tierces. Par exemple, QuestPDF pourrait être utilisé pour générer des documents PDF avec un contenu structuré, et vous pourriez mettre en œuvre une solution personnalisée pour extraire le contenu en fonction de la structure du document en utilisant une bibliothèque tierce.
L'extraction de texte n'est qu'une des tâches pour lesquelles IronPDF excelle lorsqu'il s'agit de travailler avec des PDF. En seulement quelques lignes de code, nous sommes capables d'extraire du texte d'un document PDF entier. Ceci peut être vu dans l'extrait de code suivant :
using IronPdf;

public class Program
{
    public static void Main(string[] args)
    {
        // Load the PDF document
        PdfDocument pdf = PdfDocument.FromFile("exampleInvoice.pdf");

        // Extract all the text from the loaded PDF document
        string text = pdf.ExtractAllText();

        // Print the extracted text to the console
        Console.WriteLine(text);
    }
}
using IronPdf;

public class Program
{
    public static void Main(string[] args)
    {
        // Load the PDF document
        PdfDocument pdf = PdfDocument.FromFile("exampleInvoice.pdf");

        // Extract all the text from the loaded PDF document
        string text = pdf.ExtractAllText();

        // Print the extracted text to the console
        Console.WriteLine(text);
    }
}
Imports IronPdf
Public Class Program
Public Shared Sub Main(args As String())
' Load the PDF document
Dim pdf As PdfDocument = PdfDocument.FromFile("exampleInvoice.pdf")
' Extract all the text from the loaded PDF document
Dim text As String = pdf.ExtractAllText()
' Print the extracted text to the console
Console.WriteLine(text)
End Sub
End Class
Imports IronPdf

Public Class Program
    Public Shared Sub Main(args As String())
        ' Load the PDF document
        Dim pdf As PdfDocument = PdfDocument.FromFile("exampleInvoice.pdf")

        ' Extract all the text from the loaded PDF document
        Dim text As String = pdf.ExtractAllText()

        ' Print the extracted text to the console
        Console.WriteLine(text)
    End Sub
End Class
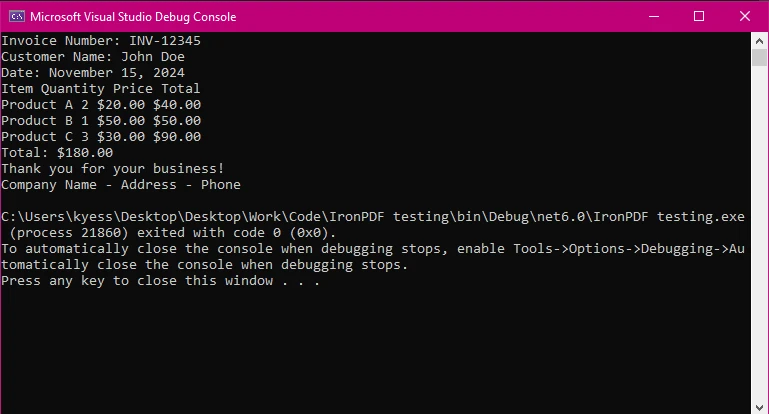
Fichier de sortie
Comparaison
IronPDF fournit une API simple pour extraire du texte, la rendant idéale pour les développeurs soucieux d'efficacité. En seulement trois lignes, nous avons pu extraire le contenu textuel de notre document PDF et l'afficher pour être lu. D'ici, vous pourriez facilement enregistrer le texte extrait pour une utilisation ou une manipulation ultérieure.
QuestPDF, quant à elle, ne pouvait pas gérer une tâche telle que l'extraction de texte, en raison d'un nombre plus limité de fonctionnalités par rapport à des bibliothèques comme IronPDF. Bien qu'elle puisse gérer d'autres tâches comme la génération de PDF et la manipulation de base, vous auriez besoin de mettre en œuvre des bibliothèques externes pour extraire le texte.
Conclusion
Lorsqu'il s'agit de l'extraction de texte, QuestPDF est gratuit grâce à l'utilisation de sa licence communautaire pour les projets privés, mais propose également des options de licences commerciales.
Les deux bibliothèques sont précises et fiables, mais le choix dépend finalement de vos besoins de projet.
Pour une comparaison plus approfondie de ces bibliothèques, consultez l'article complet sur IronPDF vs QuestPDF.
QuestPDF est une marque déposée de son propriétaire respectif. Ce site n'est pas affilié, approuvé par ou sponsorisé par QuestPDF. Tous les noms de produits, logos et marques sont la propriété de leurs propriétaires respectifs. Les comparaisons sont à titre informatif uniquement et reflètent les informations publiquement disponibles au moment de l'écriture.