using IronPdf;

// Disable local disk access or cross-origin requests
Installation.EnableWebSecurity = true;

// Instantiate Renderer
var renderer = new ChromePdfRenderer();

// Create a PDF from a HTML string using C#
var pdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>");

// Export to a file or Stream
pdf.SaveAs("output.pdf");

// Advanced Example with HTML Assets
// Load external html assets: Images, CSS and JavaScript.
// An optional BasePath 'C:\site\assets\' is set as the file location to load assets from
var myAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", @"C:\site\assets\");
myAdvancedPdf.SaveAs("html-with-assets.pdf");
using IronPdf;// Disable local disk access or cross-origin requestsInstallation.EnableWebSecurity = true;// Instantiate Renderervar renderer = new ChromePdfRenderer();// Create a PDF from a HTML string using C#var pdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>");// Export to a file or Streampdf.SaveAs("output.pdf");// Advanced Example with HTML Assets// Load external html assets: Images, CSS and JavaScript.// An optional BasePath 'C:\site\assets\' is set as the file location to load assets fromvar myAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", @"C:\site\assets\");myAdvancedPdf.SaveAs("html-with-assets.pdf");
## Einführung in das Suchen von Text in PDFs mit C#
Das Auffinden von Text innerhalb eines PDFs kann eine herausfordernde Aufgabe sein, insbesondere wenn man mit statischen Dateien arbeitet, die nicht einfach bearbeitet oder [durchsucht](https://learn.microsoft.com/en-us/dotnet/csharp/how-to/search-strings) werden können. Egal, ob Sie Dokumenten-Workflows automatisieren, Suchfunktionen erstellen, Text hervorheben müssen, der Ihren Suchkriterien entspricht, oder Daten extrahieren müssen: Textextraktion ist eine entscheidende Funktion für Entwickler.
[IronPDF](https://ironpdf.com), eine leistungsstarke .NET-Bibliothek, vereinfacht diesen Prozess und ermöglicht es Entwicklern, effizient in PDFs nach Text zu suchen und [Text extrahieren](/how-to/extract-text-and-images/). In diesem Artikel werden wir untersuchen, wie man IronPDF verwendet, um Text in einem PDF mit C# zu finden, inklusive Codebeispielen und praktischen Anwendungen.
## Was ist "Text suchen" in C#?
"Text finden" bezieht sich auf den Prozess, spezifischen Text oder Muster innerhalb eines Dokuments, einer Datei oder anderer Datenstrukturen zu suchen. Im Kontext von PDF-Dateien geht es darum, Instanzen von spezifischen Wörtern, Ausdrücken oder Mustern innerhalb des Textinhalts eines PDF-Dokuments zu identifizieren und zu lokalisieren. Diese Funktionalität ist für zahlreiche Anwendungen in verschiedenen Branchen unerlässlich, insbesondere wenn mit unstrukturierten oder halbstrukturierten Daten gearbeitet wird, die im PDF-Format gespeichert sind.
### Text in PDF-Dateien verstehen
PDF-Dateien sind so konzipiert, dass sie Inhalte in einem konsistenten, geräteunabhängigen Format präsentieren. Jedoch kann die Art und Weise, wie Text in PDFs gespeichert wird, stark variieren. Text kann gespeichert sein als:
* **Durchsuchbarer Text:** Text, der direkt extrahiert werden kann, weil er als Text eingebettet ist (z.B. aus einem Word-Dokument, das in PDF konvertiert wurde).
* **Gescanntes Text:** Text, der als Bild erscheint und OCR (Optische Zeichenerkennung) erfordert, um in durchsuchbaren Text umgewandelt zu werden.
* **Komplexe Layouts:** Text, der in Fragmenten oder mit ungewöhnlicher Kodierung gespeichert ist, was es schwieriger macht, ihn genau zu extrahieren und zu durchsuchen.
Diese Variabilität bedeutet, dass eine effektive Textsuche in PDFs oft spezialisierte Bibliotheken erfordert, wie IronPDF, die nahtlos mit verschiedenen Inhaltsarten umgehen können.
### Warum ist das Finden von Text wichtig?
Die Fähigkeit, Text in PDFs zu finden, hat ein breites Anwendungsspektrum, einschließlich:
1. **Automatisierung von Workflows:** Automatisierung von Aufgaben wie der Verarbeitung von Rechnungen, Verträgen oder Berichten, indem Schlüsselbegriffe oder Werte in PDF-Dokumenten identifiziert werden.
2. **Datenextraktion:** Extrahieren von Informationen zur Verwendung in anderen Systemen oder zur Analyse.
3. **Inhaltsverifikation:** Sicherstellung, dass erforderliche Begriffe oder Ausdrücke in Dokumenten vorhanden sind, wie z.B. Konformitätserklärungen oder rechtliche Klauseln.
4. **Verbesserung des Benutzererlebnisses:** Ermöglichen von Suchfunktionen in Dokumentenmanagementsystemen, die Benutzern helfen, schnell relevante Informationen zu finden.
### Herausforderungen bei der Textsuche
Das Finden von Text in PDFs ist nicht immer einfach aufgrund folgender Herausforderungen:
* **Kodierungsvariationen:** Einige PDFs verwenden eine benutzerdefinierte Kodierung für Text, was die Extraktion erschwert.
* **Fragmentierter Text:** Text kann in mehrere Stücke geteilt sein, was die Suche komplexer macht.
* **Grafiken und Bilder:** In Bildern eingebetteter Text erfordert OCR zur Extraktion.
* **Mehrsprachige Unterstützung:** Die Suche in Dokumenten mit unterschiedlichen Sprachen, Schriftsystemen oder von rechts nach links geschriebenem Text erfordert eine robuste Handhabung.
## Warum IronPDF für die Textextraktion wählen?
[IronPDF](https://ironpdf.com) ist darauf ausgelegt, die Manipulation von PDFs für Entwickler im .NET-Ökosystem so nahtlos wie möglich zu gestalten. Es bietet eine Reihe von Funktionen, die darauf zugeschnitten sind, die Prozesse der Textextraktion und -manipulation zu optimieren.
### Hauptvorteile
1. **Benutzerfreundlichkeit:**
IronPDF bietet eine [intuitive API](/object-reference/api/), die es Entwicklern ermöglicht, schnell loszulegen, ohne eine steile Lernkurve. Ob Sie grundlegende Textextraktion oder [HTML zu PDF-Konvertierung](/examples/using-html-to-create-a-pdf/) oder fortgeschrittene Operationen durchführen, die Methoden sind einfach zu verwenden.
2. **Hohe Genauigkeit:**
Im Gegensatz zu einigen PDF-Bibliotheken, die mit PDFs mit komplexen Layouts oder eingebetteten Schriftarten zu kämpfen haben, extrahiert IronPDF zuverlässig Text mit Präzision.
3. **Plattformübergreifende Unterstützung:**
IronPDF ist mit sowohl .NET Framework als auch .NET Core kompatibel, sodass Entwickler es in modernen Web-Apps, Desktop-Anwendungen und sogar in Altsystemen verwenden können.
4. **Unterstützung für erweiterte Abfragen:**
Die Bibliothek unterstützt erweiterte Suchtechniken wie reguläre Ausdrücke und gezielte Extraktion, was sie für komplexe Anwendungsfälle wie Data Mining oder Dokumentenindizierung geeignet macht.
## Einrichten von IronPDF in Ihrem Projekt
IronPDF ist über NuGet verfügbar, was es einfach macht, es zu Ihren .NET-Projekten hinzuzufügen. So beginnen Sie.
### Installation
Um [IronPDF zu installieren](https://www.nuget.org/packages/IronPdf/), verwenden Sie den NuGet-Paket-Manager in Visual Studio oder führen Sie den folgenden Befehl in der Paket-Manager-Konsole aus:
```sh
:ProductInstall
```
Dies wird die Bibliothek zusammen mit ihren Abhängigkeiten herunterladen und installieren.
### Grundlegender Aufbau
Sobald die Bibliothek installiert ist, müssen Sie sie in Ihrem Projekt einbinden, indem Sie den IronPDF-Namespace referenzieren. Fügen Sie die folgende Zeile am Anfang Ihrer Code-Datei hinzu:
```csharp
using IronPdf;
```
## Code-Beispiel: Suchen von Text in einer PDF-Datei
IronPDF vereinfacht den Prozess des Findens von Text innerhalb eines PDF-Dokuments. Unten folgt eine Schritt-für-Schritt-Demonstration, wie dies erreicht wird.
### Laden einer PDF-Datei
Der erste Schritt besteht darin, die PDF-Datei zu laden, mit der Sie arbeiten möchten. Dies geschieht mit der `PdfDocument` Klasse, wie im folgenden Code zu sehen:
```csharp
using IronPdf;
PdfDocument pdf = PdfDocument.FromFile("example.pdf");
```
Die `PdfDocument` Klasse repräsentiert die PDF-Datei im Speicher und ermöglicht Ihnen, verschiedene Operationen wie das Extrahieren von Text oder das Ändern von Inhalten durchzuführen. Sobald das PDF geladen ist, können wir Text aus dem gesamten PDF-Dokument oder einer bestimmten PDF-Seite innerhalb der Datei suchen.
### Suchen Sie nach bestimmten Texten
Nach dem Laden der PDF-Datei verwenden Sie die `ExtractAllText()` Methode, um den Textinhalt des gesamten Dokuments zu extrahieren. Sie können dann nach spezifischen Begriffen mit Standard-String-Manipulationstechniken suchen:
```csharp
using IronPdf;
public class Program
{
public static void Main(string[] args)
{
string path = "example.pdf";
// Load a PDF file
PdfDocument pdf = PdfDocument.FromFile(path);
// Extract all text from the PDF
string text = pdf.ExtractAllText();
// Search for a specific term
string searchTerm = "Invoice";
bool isFound = text.Contains(searchTerm, StringComparison.OrdinalIgnoreCase);
Console.WriteLine(isFound
? $"The term '{searchTerm}' was found in the PDF!"
: $"The term '{searchTerm}' was not found.");
}
}
```
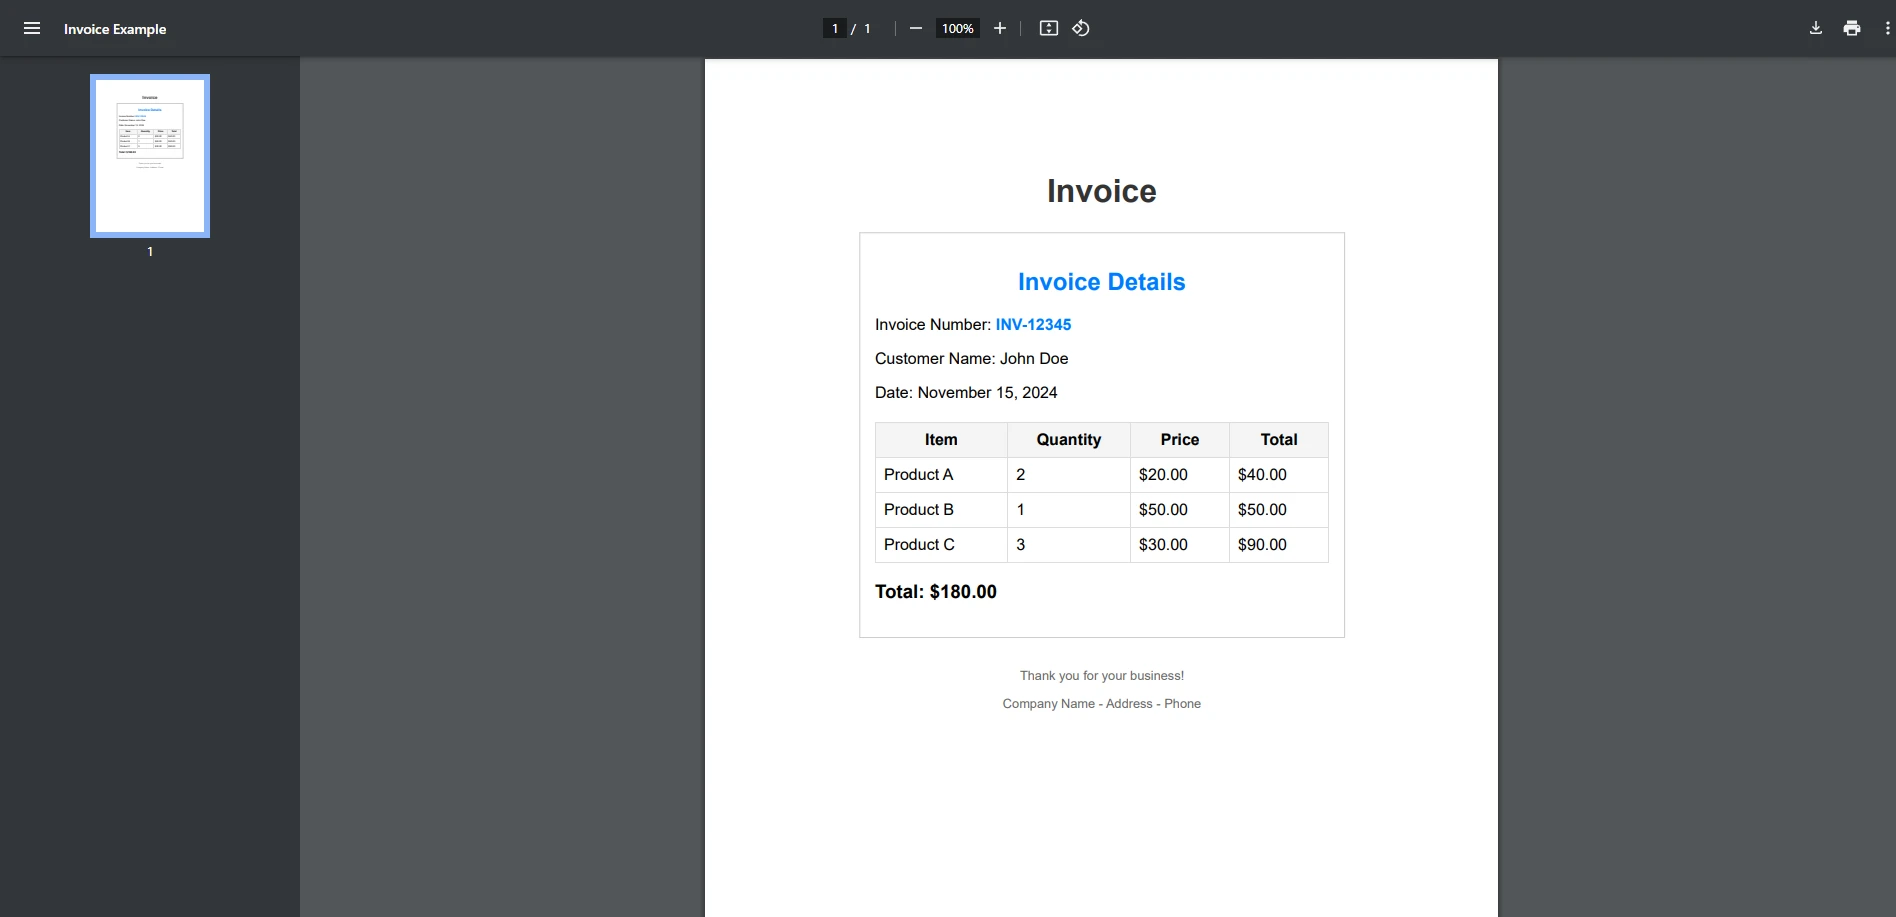
**Eingabe-PDF**
**Konsolenausgabe**
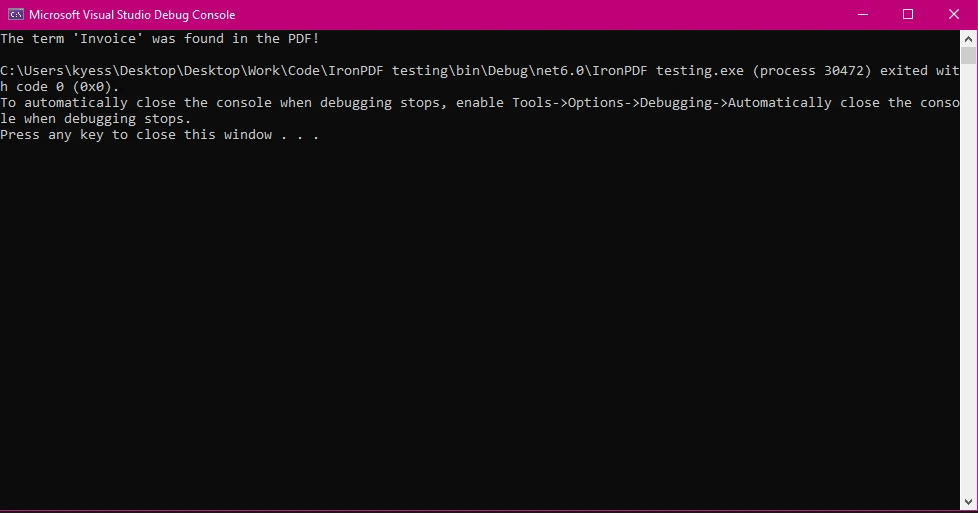
Dieses Beispiel zeigt einen einfachen Fall, in dem Sie überprüfen, ob ein Begriff im PDF vorhanden ist. Das **`StringComparison.OrdinalIgnoreCase`** stellt sicher, dass der gesuchte Text nicht zwischen Groß- und Kleinschreibung unterscheidet.
### Erweiterte Funktionen für die Textsuche
IronPDF bietet mehrere erweiterte Funktionen, die seine Textsuchfunktionen erweitern.
#### Verwendung regulärer Ausdrücke
Reguläre Ausdrücke sind ein leistungsstarkes Werkzeug zum Auffinden von Mustern innerhalb von Text. Zum Beispiel möchten Sie vielleicht alle E-Mail-Adressen in einem PDF finden:
```csharp
using System.Text.RegularExpressions; // Required namespace for using regex
// Extract all text
string pdfText = pdf.ExtractAllText();
// Use a regex to find patterns (e.g., email addresses)
Regex regex = new Regex(@"[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}");
MatchCollection matches = regex.Matches(pdfText);
foreach (Match match in matches)
{
Console.WriteLine($"Found match: {match.Value}");
}
```
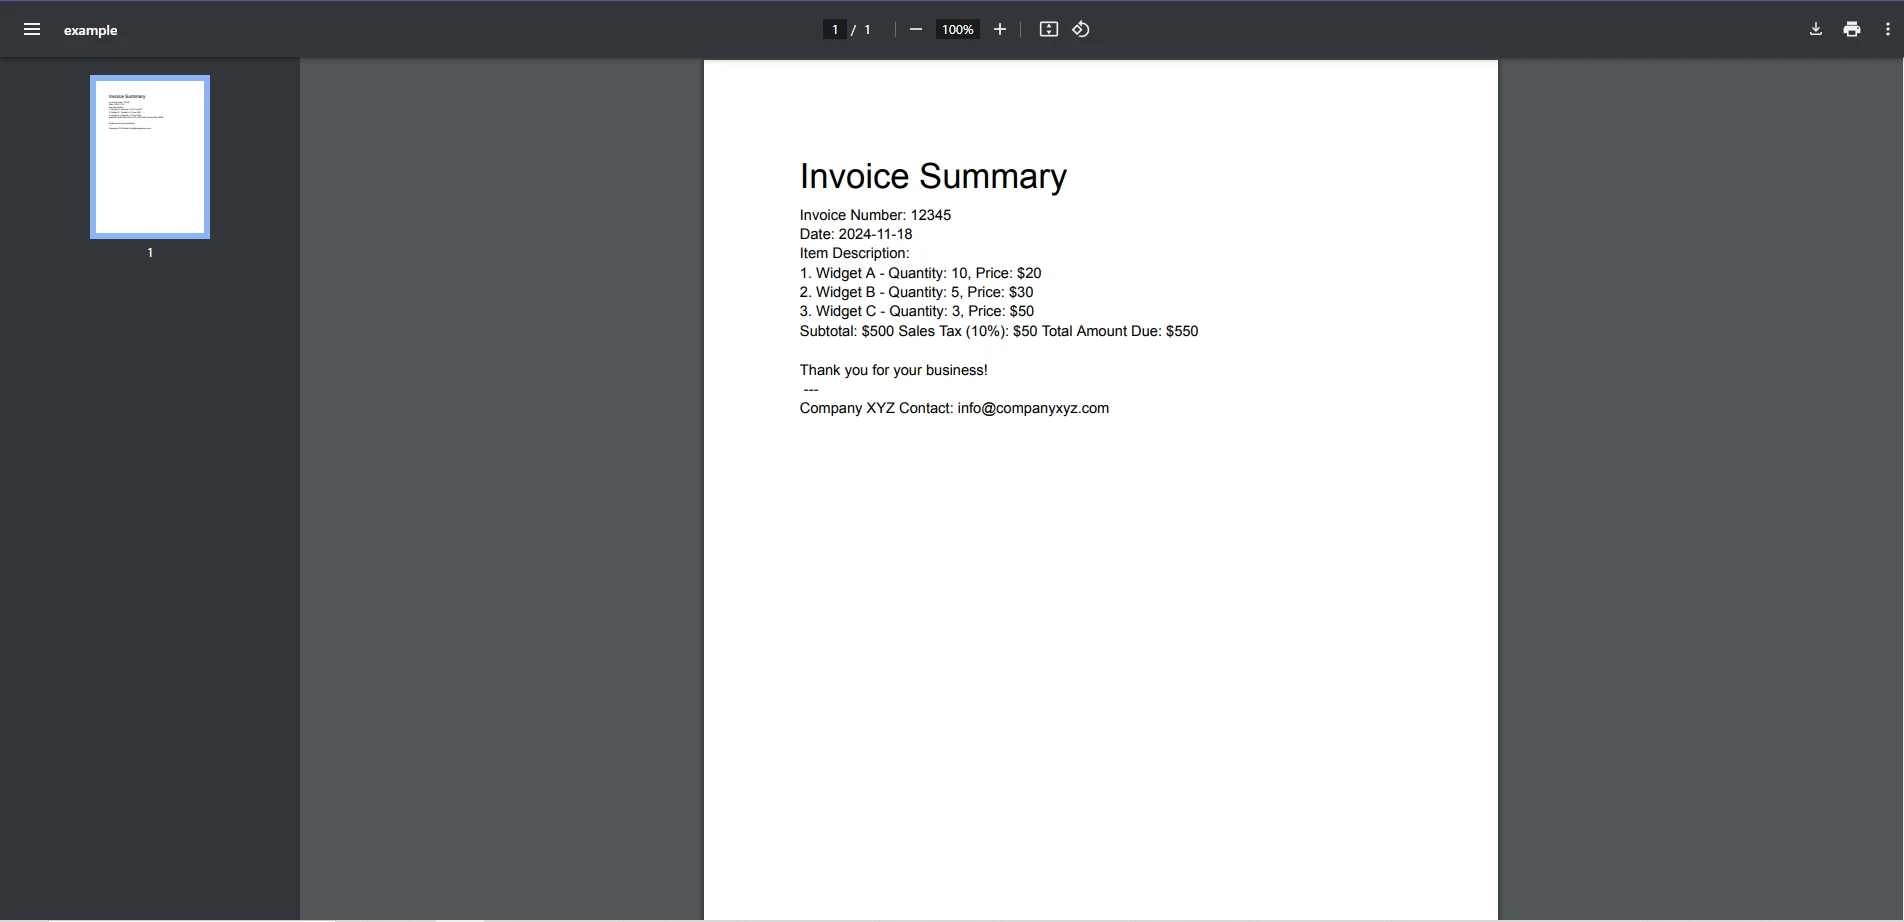
**Eingabe-PDF**
**Konsolenausgabe**
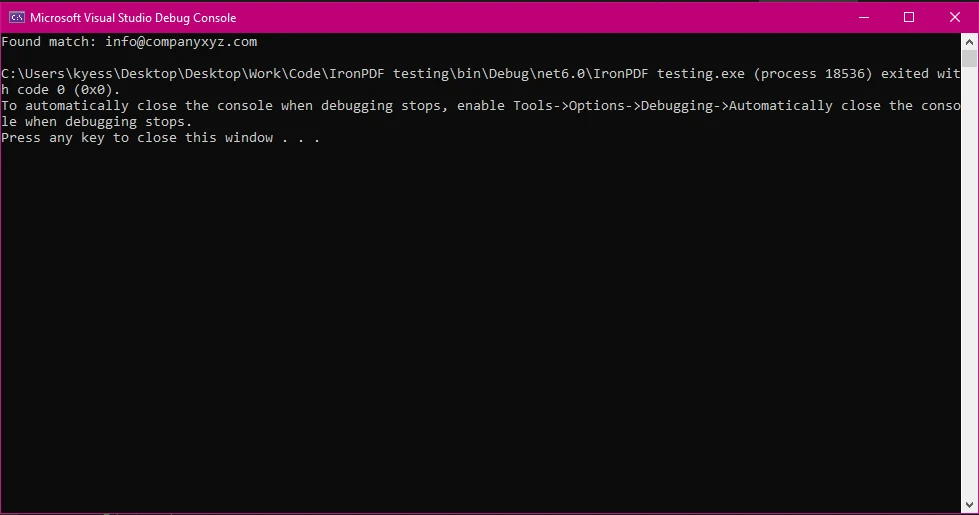
Dieses Beispiel verwendet ein Regex-Muster, um alle im Dokument gefundenen E-Mail-Adressen zu identifizieren und auszugeben.
#### Textextrahieren von Text aus bestimmten Seiten
Manchmal müssen Sie möglicherweise nur in einer bestimmten Seite eines PDFs suchen. IronPDF ermöglicht es Ihnen, einzelne Seiten über die **`PdfDocument.Pages`** Eigenschaft anzuvisieren:
```csharp
using IronPdf;
public class Program
{
public static void Main(string[] args)
{
// Load a PDF file
PdfDocument pdf = PdfDocument.FromFile("urlPdf.pdf");
// Extract text from the first page
var pageText = pdf.Pages[0].Text.ToString();
if (pageText.Contains("IronPDF"))
{
Console.WriteLine("Found the term 'IronPDF' on the first page!");
}
}
}
```
**Eingabe-PDF**
**Konsolenausgabe**
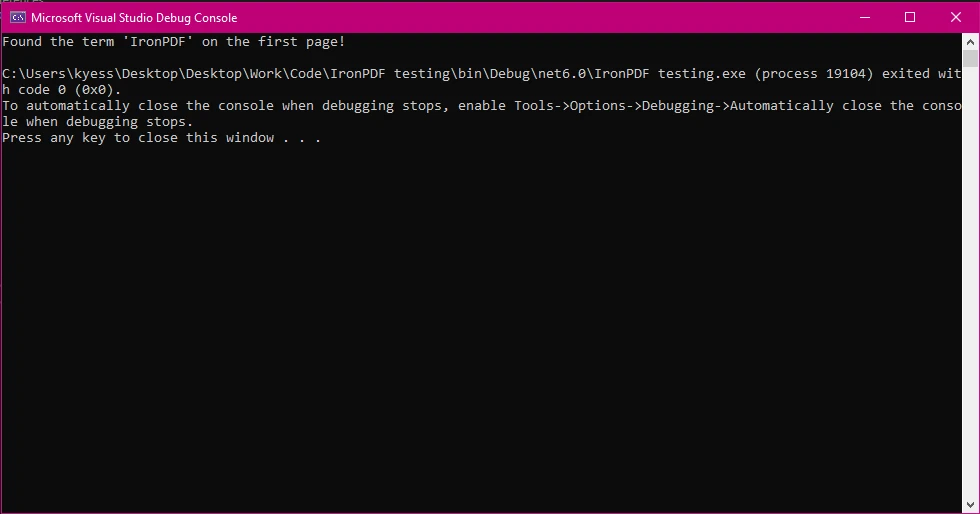
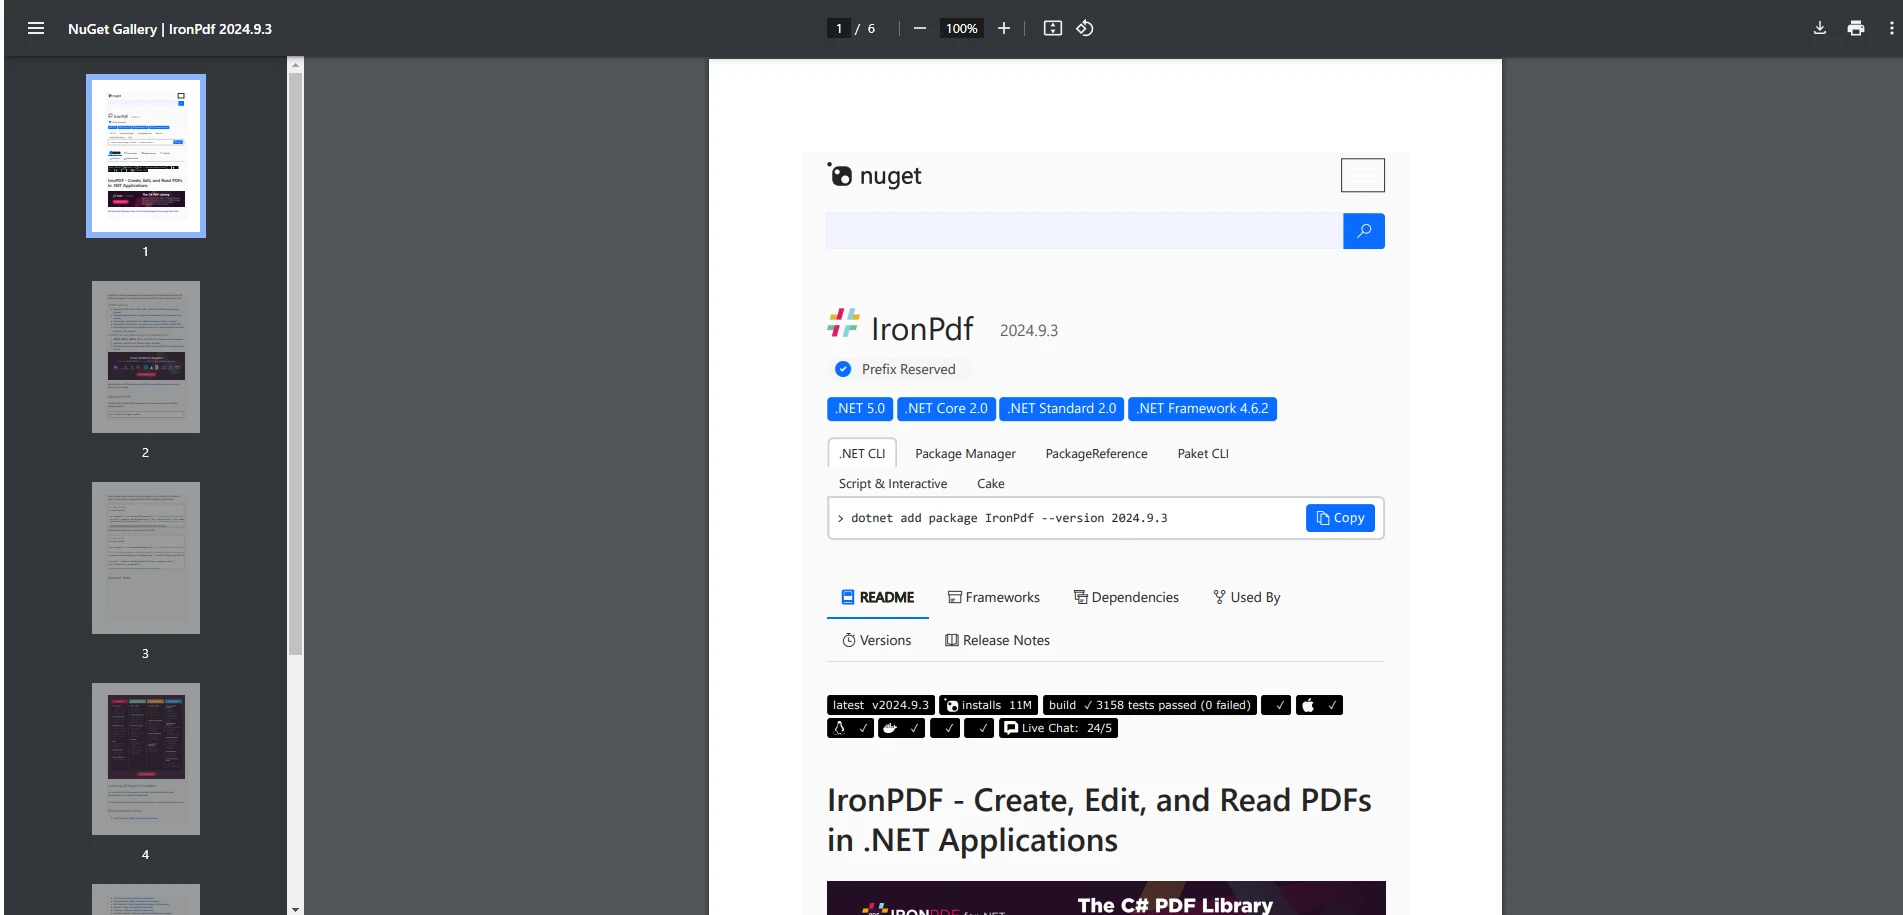
Dieser Ansatz ist nützlich zur Optimierung der Leistung bei der Arbeit mit großen PDFs.
## Echte Anwendungsfälle
### Vertragsanalyse
Juristische Fachleute können IronPDF verwenden, um die Suche nach wichtigen Begriffen oder Klauseln in langen Verträgen zu automatisieren. Zum Beispiel "Beendigungsklausel" oder "Vertraulichkeit" in Dokumenten schnell finden.
### Rechnungsbearbeitung
In Finanz- oder Buchhaltungsabläufen kann IronPDF helfen, Rechnungsnummern, Daten oder Gesamtbeträge in großen PDF-Dateien zu finden, Abläufe zu optimieren und den manuellen Aufwand zu reduzieren.
### Datenschürfung
IronPDF kann in Datenpipelines integriert werden, um Informationen aus Berichten oder Protokollen zu extrahieren und zu analysieren, die im PDF-Format gespeichert sind. Dies ist besonders nützlich für Branchen, die mit großen Mengen unstrukturierter Daten arbeiten.
## Abschluss
[IronPDF](https://ironpdf.com) ist mehr als nur eine Bibliothek zur Arbeit mit PDFs; es ist ein komplettes Toolkit, das .NET-Entwicklern ermöglicht, komplexe PDF-Operationen mit Leichtigkeit zu bewältigen. Von der Extraktion von Text und dem Auffinden spezifischer Begriffe bis hin zur Durchführung erweiterter Mustererkennung mit regulären Ausdrücken erleichtert IronPDF Aufgaben, die sonst erheblichen manuellen Aufwand oder mehrere Bibliotheken erfordern würden.
Die Fähigkeit, Text in PDFs zu extrahieren und zu durchsuchen, eröffnet leistungsstarke Anwendungsfälle über Branchen hinweg. Juristische Fachleute können die Suche nach kritischen Klauseln in Verträgen automatisieren, Buchhalter können die Rechnungsverarbeitung rationalisieren, und Entwickler in jedem Bereich können effiziente Dokumenten-Workflows erstellen. Durch das Angebot präziser Textextraktion, Kompatibilität mit .NET Core und Framework und fortschrittlichen Funktionen sorgt IronPDF dafür, dass Ihre PDF-Bedürfnisse problemlos erfüllt werden.
#### Beginnen Sie noch heute!
Lassen Sie nicht zu, dass die PDF-Verarbeitung Ihre Entwicklung verlangsamt. Beginnen Sie noch heute mit IronPDF, um Textextraktion zu vereinfachen und die Produktivität zu steigern. So können Sie beginnen:
* **Laden Sie die kostenlose Testversion herunter:** Besuchen Sie [IronPDF](trial-license).
* **Schauen Sie sich die Dokumentation an:** Entdecken Sie detaillierte Anleitungen und Beispiele in der IronPDF-[Dokumentation](/docs/).
* **Beginnen Sie mit der Entwicklung:** Implementieren Sie leistungsstarke PDF-Funktionen in Ihren .NET-Anwendungen mit minimalem Aufwand.
Machen Sie den ersten Schritt zur Optimierung Ihrer Dokumenten-Workflows mit IronPDF. Nutzen Sie dessen volles Potenzial, verbessern Sie Ihren Entwicklungsprozess und liefern Sie robuste, PDF-gestützte Lösungen schneller als je zuvor.
Das Auffinden von Text innerhalb eines PDFs kann eine herausfordernde Aufgabe sein, insbesondere wenn man mit statischen Dateien arbeitet, die nicht einfach bearbeitet oder durchsucht werden können. Egal, ob Sie Dokumenten-Workflows automatisieren, Suchfunktionen erstellen, Text hervorheben müssen, der Ihren Suchkriterien entspricht, oder Daten extrahieren müssen: Textextraktion ist eine entscheidende Funktion für Entwickler.
IronPDF, eine leistungsstarke .NET-Bibliothek, vereinfacht diesen Prozess und ermöglicht es Entwicklern, effizient in PDFs nach Text zu suchen und Text extrahieren. In diesem Artikel werden wir untersuchen, wie man IronPDF verwendet, um Text in einem PDF mit C# zu finden, inklusive Codebeispielen und praktischen Anwendungen.
Was ist "Text suchen" in C#?
"Text finden" bezieht sich auf den Prozess, spezifischen Text oder Muster innerhalb eines Dokuments, einer Datei oder anderer Datenstrukturen zu suchen. Im Kontext von PDF-Dateien geht es darum, Instanzen von spezifischen Wörtern, Ausdrücken oder Mustern innerhalb des Textinhalts eines PDF-Dokuments zu identifizieren und zu lokalisieren. Diese Funktionalität ist für zahlreiche Anwendungen in verschiedenen Branchen unerlässlich, insbesondere wenn mit unstrukturierten oder halbstrukturierten Daten gearbeitet wird, die im PDF-Format gespeichert sind.
Text in PDF-Dateien verstehen
PDF-Dateien sind so konzipiert, dass sie Inhalte in einem konsistenten, geräteunabhängigen Format präsentieren. Jedoch kann die Art und Weise, wie Text in PDFs gespeichert wird, stark variieren. Text kann gespeichert sein als:
Durchsuchbarer Text: Text, der direkt extrahiert werden kann, weil er als Text eingebettet ist (z.B. aus einem Word-Dokument, das in PDF konvertiert wurde).
Gescanntes Text: Text, der als Bild erscheint und OCR (Optische Zeichenerkennung) erfordert, um in durchsuchbaren Text umgewandelt zu werden.
Komplexe Layouts: Text, der in Fragmenten oder mit ungewöhnlicher Kodierung gespeichert ist, was es schwieriger macht, ihn genau zu extrahieren und zu durchsuchen.
Diese Variabilität bedeutet, dass eine effektive Textsuche in PDFs oft spezialisierte Bibliotheken erfordert, wie IronPDF, die nahtlos mit verschiedenen Inhaltsarten umgehen können.
Warum ist das Finden von Text wichtig?
Die Fähigkeit, Text in PDFs zu finden, hat ein breites Anwendungsspektrum, einschließlich:
Automatisierung von Workflows: Automatisierung von Aufgaben wie der Verarbeitung von Rechnungen, Verträgen oder Berichten, indem Schlüsselbegriffe oder Werte in PDF-Dokumenten identifiziert werden.
Datenextraktion: Extrahieren von Informationen zur Verwendung in anderen Systemen oder zur Analyse.
Inhaltsverifikation: Sicherstellung, dass erforderliche Begriffe oder Ausdrücke in Dokumenten vorhanden sind, wie z.B. Konformitätserklärungen oder rechtliche Klauseln.
Verbesserung des Benutzererlebnisses: Ermöglichen von Suchfunktionen in Dokumentenmanagementsystemen, die Benutzern helfen, schnell relevante Informationen zu finden.
Herausforderungen bei der Textsuche
Das Finden von Text in PDFs ist nicht immer einfach aufgrund folgender Herausforderungen:
Kodierungsvariationen: Einige PDFs verwenden eine benutzerdefinierte Kodierung für Text, was die Extraktion erschwert.
Fragmentierter Text: Text kann in mehrere Stücke geteilt sein, was die Suche komplexer macht.
Grafiken und Bilder: In Bildern eingebetteter Text erfordert OCR zur Extraktion.
Mehrsprachige Unterstützung: Die Suche in Dokumenten mit unterschiedlichen Sprachen, Schriftsystemen oder von rechts nach links geschriebenem Text erfordert eine robuste Handhabung.
Warum IronPDF für die Textextraktion wählen?
IronPDF ist darauf ausgelegt, die Manipulation von PDFs für Entwickler im .NET-Ökosystem so nahtlos wie möglich zu gestalten. Es bietet eine Reihe von Funktionen, die darauf zugeschnitten sind, die Prozesse der Textextraktion und -manipulation zu optimieren.
Hauptvorteile
Benutzerfreundlichkeit:
IronPDF bietet eine intuitive API, die es Entwicklern ermöglicht, schnell loszulegen, ohne eine steile Lernkurve. Ob Sie grundlegende Textextraktion oder HTML zu PDF-Konvertierung oder fortgeschrittene Operationen durchführen, die Methoden sind einfach zu verwenden.
Hohe Genauigkeit:
Im Gegensatz zu einigen PDF-Bibliotheken, die mit PDFs mit komplexen Layouts oder eingebetteten Schriftarten zu kämpfen haben, extrahiert IronPDF zuverlässig Text mit Präzision.
Plattformübergreifende Unterstützung:
IronPDF ist mit sowohl .NET Framework als auch .NET Core kompatibel, sodass Entwickler es in modernen Web-Apps, Desktop-Anwendungen und sogar in Altsystemen verwenden können.
Unterstützung für erweiterte Abfragen:
Die Bibliothek unterstützt erweiterte Suchtechniken wie reguläre Ausdrücke und gezielte Extraktion, was sie für komplexe Anwendungsfälle wie Data Mining oder Dokumentenindizierung geeignet macht.
Einrichten von IronPDF in Ihrem Projekt
IronPDF ist über NuGet verfügbar, was es einfach macht, es zu Ihren .NET-Projekten hinzuzufügen. So beginnen Sie.
Installation
Um IronPDF zu installieren, verwenden Sie den NuGet-Paket-Manager in Visual Studio oder führen Sie den folgenden Befehl in der Paket-Manager-Konsole aus:
PM > Install-Package IronPdf
Install-Package IronPdf
Dies wird die Bibliothek zusammen mit ihren Abhängigkeiten herunterladen und installieren.
Grundlegender Aufbau
Sobald die Bibliothek installiert ist, müssen Sie sie in Ihrem Projekt einbinden, indem Sie den IronPDF-Namespace referenzieren. Fügen Sie die folgende Zeile am Anfang Ihrer Code-Datei hinzu:
using IronPdf;
using IronPdf;
ImportsIronPdf
Imports IronPdf
Code-Beispiel: Suchen von Text in einer PDF-Datei
IronPDF vereinfacht den Prozess des Findens von Text innerhalb eines PDF-Dokuments. Unten folgt eine Schritt-für-Schritt-Demonstration, wie dies erreicht wird.
Laden einer PDF-Datei
Der erste Schritt besteht darin, die PDF-Datei zu laden, mit der Sie arbeiten möchten. Dies geschieht mit der PdfDocument Klasse, wie im folgenden Code zu sehen:
using IronPdf;PdfDocument pdf = PdfDocument.FromFile("example.pdf");
using IronPdf;
PdfDocument pdf = PdfDocument.FromFile("example.pdf");
ImportsIronPdfPrivate pdf AsPdfDocument = PdfDocument.FromFile("example.pdf")
Imports IronPdf
Private pdf As PdfDocument = PdfDocument.FromFile("example.pdf")
Die PdfDocument Klasse repräsentiert die PDF-Datei im Speicher und ermöglicht Ihnen, verschiedene Operationen wie das Extrahieren von Text oder das Ändern von Inhalten durchzuführen. Sobald das PDF geladen ist, können wir Text aus dem gesamten PDF-Dokument oder einer bestimmten PDF-Seite innerhalb der Datei suchen.
Suchen Sie nach bestimmten Texten
Nach dem Laden der PDF-Datei verwenden Sie die ExtractAllText() Methode, um den Textinhalt des gesamten Dokuments zu extrahieren. Sie können dann nach spezifischen Begriffen mit Standard-String-Manipulationstechniken suchen:
using IronPdf;public class Program{ public static voidMain(string[] args) { string path = "example.pdf"; // Load a PDF file PdfDocument pdf = PdfDocument.FromFile(path); // Extract all text from the PDF string text = pdf.ExtractAllText(); // Search for a specific term string searchTerm = "Invoice"; bool isFound = text.Contains(searchTerm, StringComparison.OrdinalIgnoreCase);Console.WriteLine(isFound ? $"The term '{searchTerm}' was found in the PDF!" : $"The term '{searchTerm}' was not found."); }}
using IronPdf;
public class Program
{
    public static void Main(string[] args)
    {
        string path = "example.pdf";
        // Load a PDF file
        PdfDocument pdf = PdfDocument.FromFile(path);
        // Extract all text from the PDF
        string text = pdf.ExtractAllText();
        // Search for a specific term
        string searchTerm = "Invoice";
        bool isFound = text.Contains(searchTerm, StringComparison.OrdinalIgnoreCase);
        Console.WriteLine(isFound
            ? $"The term '{searchTerm}' was found in the PDF!"
            : $"The term '{searchTerm}' was not found.");
    }
}
ImportsIronPdfPublic Class Program PublicShared Sub Main(ByVal args() AsString) Dim path AsString = "example.pdf" ' Load a PDF file Dim pdf AsPdfDocument = PdfDocument.FromFile(path) ' Extract all text from the PDF Dim text AsString = pdf.ExtractAllText() ' Search for a specific term Dim searchTerm AsString = "Invoice" Dim isFound AsBoolean = text.Contains(searchTerm, StringComparison.OrdinalIgnoreCase)Console.WriteLine(If(isFound, $"The term '{searchTerm}' was found in the PDF!", $"The term '{searchTerm}' was not found.")) End SubEnd Class
Imports IronPdf
Public Class Program
	Public Shared Sub Main(ByVal args() As String)
		Dim path As String = "example.pdf"
		' Load a PDF file
		Dim pdf As PdfDocument = PdfDocument.FromFile(path)
		' Extract all text from the PDF
		Dim text As String = pdf.ExtractAllText()
		' Search for a specific term
		Dim searchTerm As String = "Invoice"
		Dim isFound As Boolean = text.Contains(searchTerm, StringComparison.OrdinalIgnoreCase)
		Console.WriteLine(If(isFound, $"The term '{searchTerm}' was found in the PDF!", $"The term '{searchTerm}' was not found."))
	End Sub
End Class
Eingabe-PDF
Konsolenausgabe
Dieses Beispiel zeigt einen einfachen Fall, in dem Sie überprüfen, ob ein Begriff im PDF vorhanden ist. Das StringComparison.OrdinalIgnoreCase stellt sicher, dass der gesuchte Text nicht zwischen Groß- und Kleinschreibung unterscheidet.
Erweiterte Funktionen für die Textsuche
IronPDF bietet mehrere erweiterte Funktionen, die seine Textsuchfunktionen erweitern.
Verwendung regulärer Ausdrücke
Reguläre Ausdrücke sind ein leistungsstarkes Werkzeug zum Auffinden von Mustern innerhalb von Text. Zum Beispiel möchten Sie vielleicht alle E-Mail-Adressen in einem PDF finden:
using System.Text.RegularExpressions; // Required namespace for using regex// Extract all textstring pdfText = pdf.ExtractAllText();// Use a regex to find patterns (e.g., email addresses)Regex regex = new Regex(@"[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}");MatchCollection matches = regex.Matches(pdfText);foreach (Match match in matches){Console.WriteLine($"Found match: {match.Value}");}
using System.Text.RegularExpressions;  // Required namespace for using regex
// Extract all text
string pdfText = pdf.ExtractAllText();
// Use a regex to find patterns (e.g., email addresses)
Regex regex = new Regex(@"[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}");
MatchCollection matches = regex.Matches(pdfText);
foreach (Match match in matches)
{
    Console.WriteLine($"Found match: {match.Value}");
}
ImportsSystem.Text.RegularExpressions' Required namespace for using regex' Extract all textPrivate pdfText AsString = pdf.ExtractAllText()' Use a regex to find patterns (e.g., email addresses)Private regex As New Regex("[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}")Private matches AsMatchCollection = regex.Matches(pdfText)For Each match AsMatchIn matchesConsole.WriteLine($"Found match: {match.Value}")Next match
Imports System.Text.RegularExpressions ' Required namespace for using regex
' Extract all text
Private pdfText As String = pdf.ExtractAllText()
' Use a regex to find patterns (e.g., email addresses)
Private regex As New Regex("[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}")
Private matches As MatchCollection = regex.Matches(pdfText)
For Each match As Match In matches
	Console.WriteLine($"Found match: {match.Value}")
Next match
Eingabe-PDF
Konsolenausgabe
Dieses Beispiel verwendet ein Regex-Muster, um alle im Dokument gefundenen E-Mail-Adressen zu identifizieren und auszugeben.
Textextrahieren von Text aus bestimmten Seiten
Manchmal müssen Sie möglicherweise nur in einer bestimmten Seite eines PDFs suchen. IronPDF ermöglicht es Ihnen, einzelne Seiten über die PdfDocument.Pages Eigenschaft anzuvisieren:
using IronPdf;public class Program{ public static voidMain(string[] args) { // Load a PDF file PdfDocument pdf = PdfDocument.FromFile("urlPdf.pdf"); // Extract text from the first page var pageText = pdf.Pages[0].Text.ToString(); if (pageText.Contains("IronPDF")) {Console.WriteLine("Found the term 'IronPDF' on the first page!"); } }}
using IronPdf;
public class Program
{
    public static void Main(string[] args)
    {
        // Load a PDF file
        PdfDocument pdf = PdfDocument.FromFile("urlPdf.pdf");
        // Extract text from the first page
        var pageText = pdf.Pages[0].Text.ToString();
        if (pageText.Contains("IronPDF"))
        {
            Console.WriteLine("Found the term 'IronPDF' on the first page!");
        }
    }
}
ImportsIronPdfPublic Class Program PublicShared Sub Main(ByVal args() AsString) ' Load a PDF file Dim pdf AsPdfDocument = PdfDocument.FromFile("urlPdf.pdf") ' Extract text from the first page Dim pageText = pdf.Pages(0).Text.ToString() If pageText.Contains("IronPDF") ThenConsole.WriteLine("Found the term 'IronPDF' on the first page!") End If End SubEnd Class
Imports IronPdf
Public Class Program
	Public Shared Sub Main(ByVal args() As String)
		' Load a PDF file
		Dim pdf As PdfDocument = PdfDocument.FromFile("urlPdf.pdf")
		' Extract text from the first page
		Dim pageText = pdf.Pages(0).Text.ToString()
		If pageText.Contains("IronPDF") Then
			Console.WriteLine("Found the term 'IronPDF' on the first page!")
		End If
	End Sub
End Class
Eingabe-PDF
Konsolenausgabe
Dieser Ansatz ist nützlich zur Optimierung der Leistung bei der Arbeit mit großen PDFs.
Echte Anwendungsfälle
Vertragsanalyse
Juristische Fachleute können IronPDF verwenden, um die Suche nach wichtigen Begriffen oder Klauseln in langen Verträgen zu automatisieren. Zum Beispiel "Beendigungsklausel" oder "Vertraulichkeit" in Dokumenten schnell finden.
Rechnungsbearbeitung
In Finanz- oder Buchhaltungsabläufen kann IronPDF helfen, Rechnungsnummern, Daten oder Gesamtbeträge in großen PDF-Dateien zu finden, Abläufe zu optimieren und den manuellen Aufwand zu reduzieren.
Datenschürfung
IronPDF kann in Datenpipelines integriert werden, um Informationen aus Berichten oder Protokollen zu extrahieren und zu analysieren, die im PDF-Format gespeichert sind. Dies ist besonders nützlich für Branchen, die mit großen Mengen unstrukturierter Daten arbeiten.
Abschluss
IronPDF ist mehr als nur eine Bibliothek zur Arbeit mit PDFs; es ist ein komplettes Toolkit, das .NET-Entwicklern ermöglicht, komplexe PDF-Operationen mit Leichtigkeit zu bewältigen. Von der Extraktion von Text und dem Auffinden spezifischer Begriffe bis hin zur Durchführung erweiterter Mustererkennung mit regulären Ausdrücken erleichtert IronPDF Aufgaben, die sonst erheblichen manuellen Aufwand oder mehrere Bibliotheken erfordern würden.
Die Fähigkeit, Text in PDFs zu extrahieren und zu durchsuchen, eröffnet leistungsstarke Anwendungsfälle über Branchen hinweg. Juristische Fachleute können die Suche nach kritischen Klauseln in Verträgen automatisieren, Buchhalter können die Rechnungsverarbeitung rationalisieren, und Entwickler in jedem Bereich können effiziente Dokumenten-Workflows erstellen. Durch das Angebot präziser Textextraktion, Kompatibilität mit .NET Core und Framework und fortschrittlichen Funktionen sorgt IronPDF dafür, dass Ihre PDF-Bedürfnisse problemlos erfüllt werden.
Beginnen Sie noch heute!
Lassen Sie nicht zu, dass die PDF-Verarbeitung Ihre Entwicklung verlangsamt. Beginnen Sie noch heute mit IronPDF, um Textextraktion zu vereinfachen und die Produktivität zu steigern. So können Sie beginnen:
Laden Sie die kostenlose Testversion herunter: Besuchen Sie IronPDF.
Schauen Sie sich die Dokumentation an: Entdecken Sie detaillierte Anleitungen und Beispiele in der IronPDF-Dokumentation.
Beginnen Sie mit der Entwicklung: Implementieren Sie leistungsstarke PDF-Funktionen in Ihren .NET-Anwendungen mit minimalem Aufwand.
Machen Sie den ersten Schritt zur Optimierung Ihrer Dokumenten-Workflows mit IronPDF. Nutzen Sie dessen volles Potenzial, verbessern Sie Ihren Entwicklungsprozess und liefern Sie robuste, PDF-gestützte Lösungen schneller als je zuvor.
Curtis Chau hat einen Bachelor-Abschluss in Informatik von der Carleton University und ist spezialisiert auf Frontend-Entwicklung mit Expertise in Node.js, TypeScript, JavaScript und React. Leidenschaftlich widmet er sich der Erstellung intuitiver und ästhetisch ansprechender Benutzerschnittstellen und arbeitet gerne mit modernen Frameworks sowie der Erstellung gut strukturierter, optisch ansprechender Handbücher.
















