using IronPdf;

// Disable local disk access or cross-origin requests
Installation.EnableWebSecurity = true;

// Instantiate Renderer
var renderer = new ChromePdfRenderer();

// Create a PDF from a HTML string using C#
var pdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>");

// Export to a file or Stream
pdf.SaveAs("output.pdf");

// Advanced Example with HTML Assets
// Load external html assets: Images, CSS and JavaScript.
// An optional BasePath 'C:\site\assets\' is set as the file location to load assets from
var myAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", @"C:\site\assets\");
myAdvancedPdf.SaveAs("html-with-assets.pdf");
using IronPdf;// Disable local disk access or cross-origin requestsInstallation.EnableWebSecurity = true;// Instantiate Renderervar renderer = new ChromePdfRenderer();// Create a PDF from a HTML string using C#var pdf = renderer.RenderHtmlAsPdf("<h1>Hello World</h1>");// Export to a file or Streampdf.SaveAs("output.pdf");// Advanced Example with HTML Assets// Load external html assets: Images, CSS and JavaScript.// An optional BasePath 'C:\site\assets\' is set as the file location to load assets fromvar myAdvancedPdf = renderer.RenderHtmlAsPdf("<img src='icons/iron.png'>", @"C:\site\assets\");myAdvancedPdf.SaveAs("html-with-assets.pdf");
## Introducción a la búsqueda de texto en PDF con C#
Encontrar texto dentro de un PDF puede ser una tarea desafiante, especialmente cuando se trabaja con archivos estáticos que no son fácilmente editables o [buscables](https://learn.microsoft.com/en-us/dotnet/csharp/how-to/search-strings). Ya sea que estés automatizando flujos de trabajo de documentos, construyendo funcionalidad de búsqueda, necesitando resaltar texto que coincida con tus criterios de búsqueda o extrayendo datos, la extracción de texto es una función crítica para los desarrolladores.
[IronPDF](https://ironpdf.com), una potente biblioteca .NET, simplifica este proceso, permitiendo a los desarrolladores buscar y [extraer texto](/how-to/extract-text-and-images/) eficientemente de PDFs. En este artículo, exploraremos cómo usar IronPDF para encontrar texto en un PDF usando C#, completo con ejemplos de código y aplicaciones prácticas.
## ¿Qué es "Buscar texto" en C#?
"Encontrar texto" se refiere al proceso de buscar texto o patrones específicos dentro de un documento, archivo u otras estructuras de datos. En el contexto de archivos PDF, implica identificar y localizar instancias de palabras, frases o patrones específicos dentro del contenido de texto de un documento PDF. Esta funcionalidad es esencial para numerosas aplicaciones en diversas industrias, especialmente cuando se trata con datos no estructurados o semi-estructurados almacenados en formato PDF.
### Comprensión del texto en archivos PDF
Los archivos PDF están diseñados para presentar contenido en un formato consistente e independiente del dispositivo. Sin embargo, la forma de almacenar texto en PDFs varía. El texto puede estar almacenado como:
* **Texto buscable:** Texto que es directamente extraíble porque está incrustado como texto (por ejemplo, de un documento de Word convertido a PDF).
* **Texto escaneado:** Texto que aparece como una imagen, que requiere OCR (Reconocimiento Óptico de Caracteres) para convertir en texto buscable.
* **Diseños complejos:** Texto almacenado en fragmentos o con codificación inusual, lo que hace más difícil extraer y buscar con precisión.
Esta variabilidad significa que la búsqueda efectiva de texto en PDFs a menudo requiere bibliotecas especializadas, como IronPDF, que pueden manejar tipos de contenido diversos sin problemas.
### ¿Por qué es importante encontrar el texto?
La capacidad de encontrar texto en PDFs tiene un amplio rango de aplicaciones, incluyendo:
1. **Automatización de flujos de trabajo:** Automatizar tareas como el procesamiento de facturas, contratos o informes identificando términos o valores clave en documentos PDF.
2. **Extracción de datos:** Extraer información para su uso en otros sistemas o para análisis.
3. **Verificación de contenido:** Asegurar que los términos o frases requeridas estén presentes en documentos, como declaraciones de conformidad o cláusulas legales.
4. **Mejora de la experiencia del usuario:** Habilitar la funcionalidad de búsqueda en sistemas de gestión de documentos, ayudando a los usuarios a ubicar rápidamente información relevante.
### Desafíos en la búsqueda de texto
Encontrar texto en PDFs no siempre es sencillo debido a los siguientes desafíos:
* **Variaciones de codificación:** Algunos PDFs utilizan codificaciones personalizadas para el texto, lo que complica la extracción.
* **Texto fragmentado:** El texto podría estar dividido en múltiples piezas, haciendo que las búsquedas sean más complejas.
* **Gráficos e imágenes:** El texto incrustado en imágenes requiere OCR para extraerlo.
* **Soporte multilingüe:** Buscar en documentos con diferentes idiomas, escrituras o texto de derecha a izquierda requiere un manejo robusto.
## ¿Por qué elegir IronPDF para la extracción de texto?
[IronPDF](https://ironpdf.com) está diseñado para hacer que la manipulación de PDFs sea lo más fluida posible para los desarrolladores que trabajan en el ecosistema .NET. Ofrece un conjunto de funciones diseñadas para agilizar los procesos de extracción y manipulación de texto.
### Beneficios clave
1. **Facilidad de uso:**
IronPDF presenta una [API intuitiva](/object-reference/api/), lo que permite a los desarrolladores comenzar rápidamente sin una curva de aprendizaje empinada. Ya sea que estés realizando una extracción de texto básica o [conversión de HTML a PDF](/examples/using-html-to-create-a-pdf/), o operaciones avanzadas, sus métodos son fáciles de usar.
2. **Alta precisión:**
A diferencia de algunas bibliotecas PDF que luchan con PDFs que contienen diseños complejos o fuentes incrustadas, IronPDF extrae texto con precisión de manera confiable.
3. **Compatibilidad multiplataforma:**
IronPDF es compatible tanto con .NET Framework como con .NET Core, asegurando que los desarrolladores puedan usarlo en aplicaciones web modernas, aplicaciones de escritorio e incluso sistemas heredados.
4. **Soporte para consultas avanzadas:**
La biblioteca es compatible con técnicas de búsqueda avanzadas, como expresiones regulares y extracción específica, lo que la hace adecuada para casos de uso complejos, como minería de datos o indexación de documentos.
## Cómo configurar IronPDF en su proyecto
IronPDF está disponible a través de NuGet, lo que hace que sea fácil de agregar a tus proyectos .NET. Aquí te mostramos cómo empezar.
### Instalación
Para [instalar IronPDF](https://www.nuget.org/packages/IronPdf/), usa el Administrador de Paquetes NuGet en Visual Studio o ejecuta el siguiente comando en la Consola del Administrador de Paquetes:
```sh
:ProductInstall
```
Esto descargará e instalará la biblioteca junto con sus dependencias.
### Configuración básica
Una vez que la biblioteca esté instalada, necesitas incluirla en tu proyecto referenciando el espacio de nombres IronPDF. Agrega la siguiente línea en la parte superior de tu archivo de código:
```csharp
using IronPdf;
```
## Ejemplo de código: Encontrar texto en un PDF
IronPDF simplifica el proceso de encontrar texto dentro de un documento PDF. A continuación, se muestra una demostración paso a paso de cómo lograrlo.
### Cargar un archivo PDF
El primer paso es cargar el archivo PDF con el que deseas trabajar. Esto se hace utilizando la clase `PdfDocument`, como se ve en el siguiente código:
```csharp
using IronPdf;
PdfDocument pdf = PdfDocument.FromFile("example.pdf");
```
La clase `PdfDocument` representa el archivo PDF en la memoria, lo que le permite realizar varias operaciones como extraer texto o modificar contenido. Una vez que el PDF ha sido cargado, podemos buscar texto desde todo el documento PDF o una página PDF específica dentro del archivo.
### Búsqueda de texto específico
Después de cargar el PDF, utilice el método `ExtractAllText()` para extraer el contenido de texto de todo el documento. Luego puedes buscar términos específicos usando técnicas estándar de manipulación de cadenas:
```csharp
using IronPdf;
public class Program
{
public static void Main(string[] args)
{
string path = "example.pdf";
// Load a PDF file
PdfDocument pdf = PdfDocument.FromFile(path);
// Extract all text from the PDF
string text = pdf.ExtractAllText();
// Search for a specific term
string searchTerm = "Invoice";
bool isFound = text.Contains(searchTerm, StringComparison.OrdinalIgnoreCase);
Console.WriteLine(isFound
? $"The term '{searchTerm}' was found in the PDF!"
: $"The term '{searchTerm}' was not found.");
}
}
```
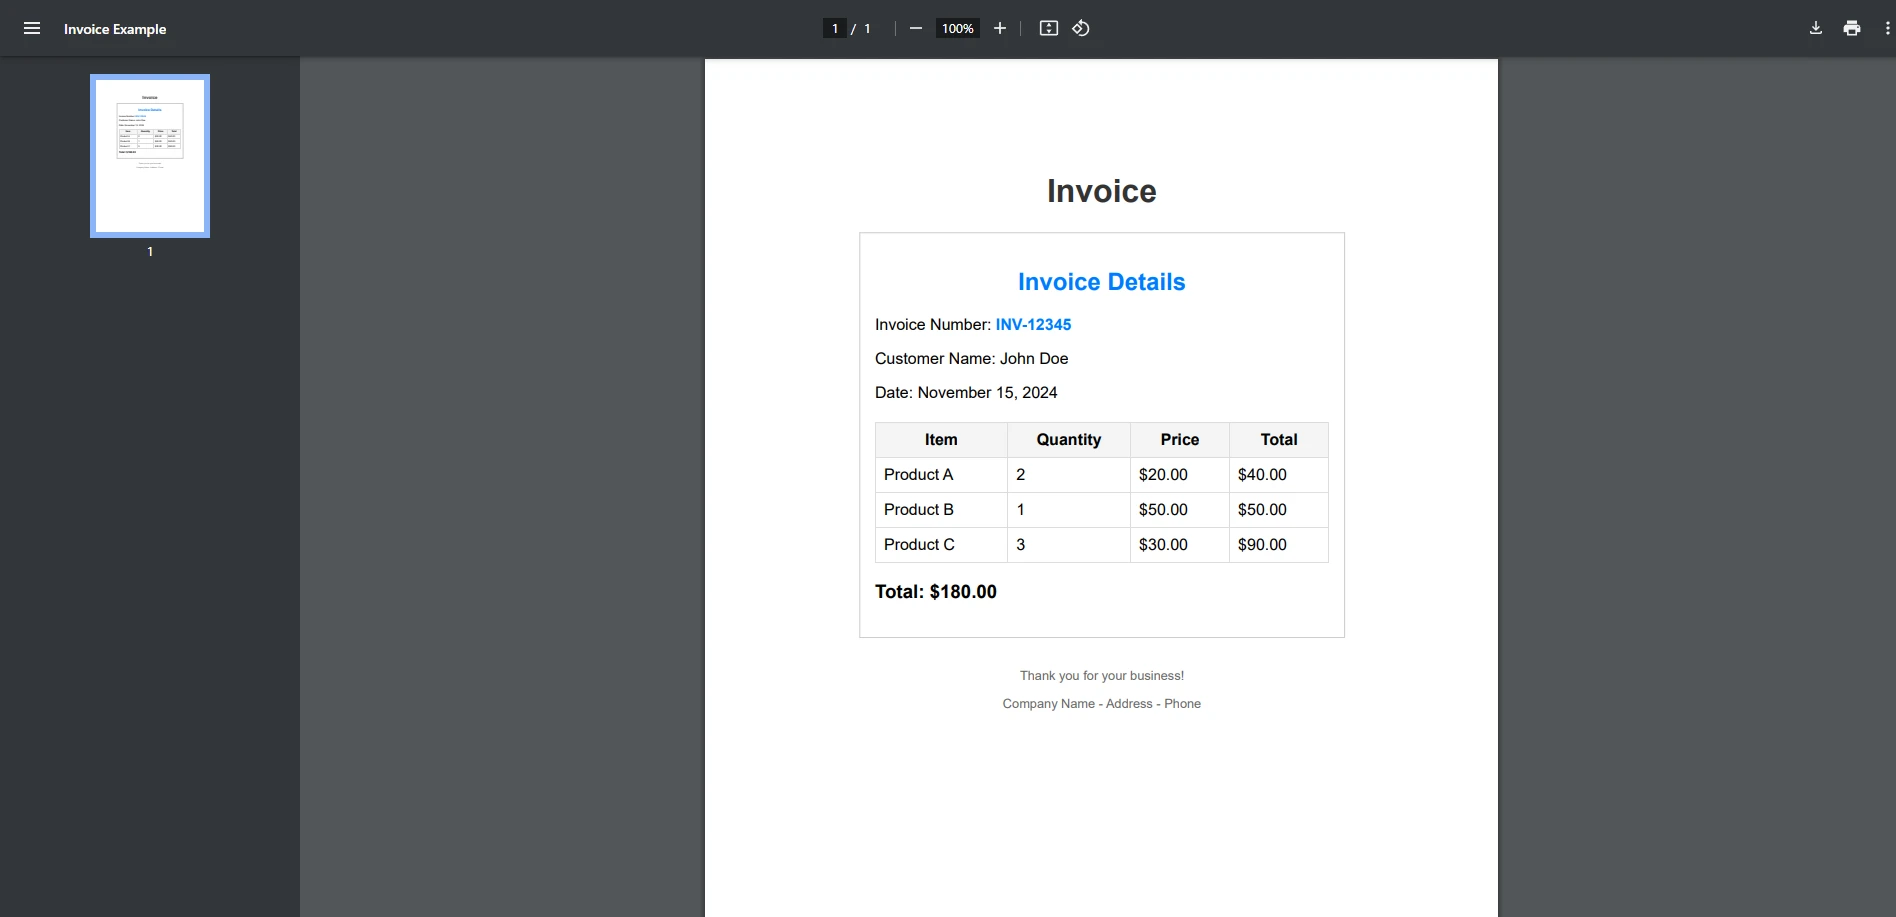
**PDF de entrada**
**Salida de la Consola**
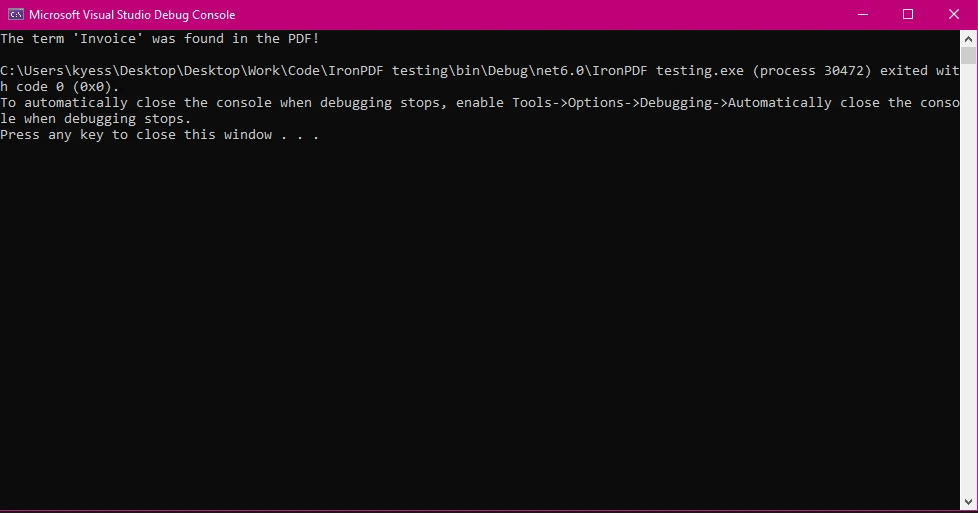
Este ejemplo demuestra un caso simple donde verificas si existe un término en el PDF. El **`StringComparison.OrdinalIgnoreCase`** garantiza que el texto buscado no distinga entre mayúsculas y minúsculas.
### Características avanzadas para la búsqueda de texto
IronPDF ofrece varias funciones avanzadas que extienden sus capacidades de búsqueda de texto.
#### Uso de expresiones regulares
Las expresiones regulares son una herramienta poderosa para encontrar patrones dentro del texto. Por ejemplo, podrías querer localizar todas las direcciones de correo electrónico en un PDF:
```csharp
using System.Text.RegularExpressions; // Required namespace for using regex
// Extract all text
string pdfText = pdf.ExtractAllText();
// Use a regex to find patterns (e.g., email addresses)
Regex regex = new Regex(@"[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}");
MatchCollection matches = regex.Matches(pdfText);
foreach (Match match in matches)
{
Console.WriteLine($"Found match: {match.Value}");
}
```
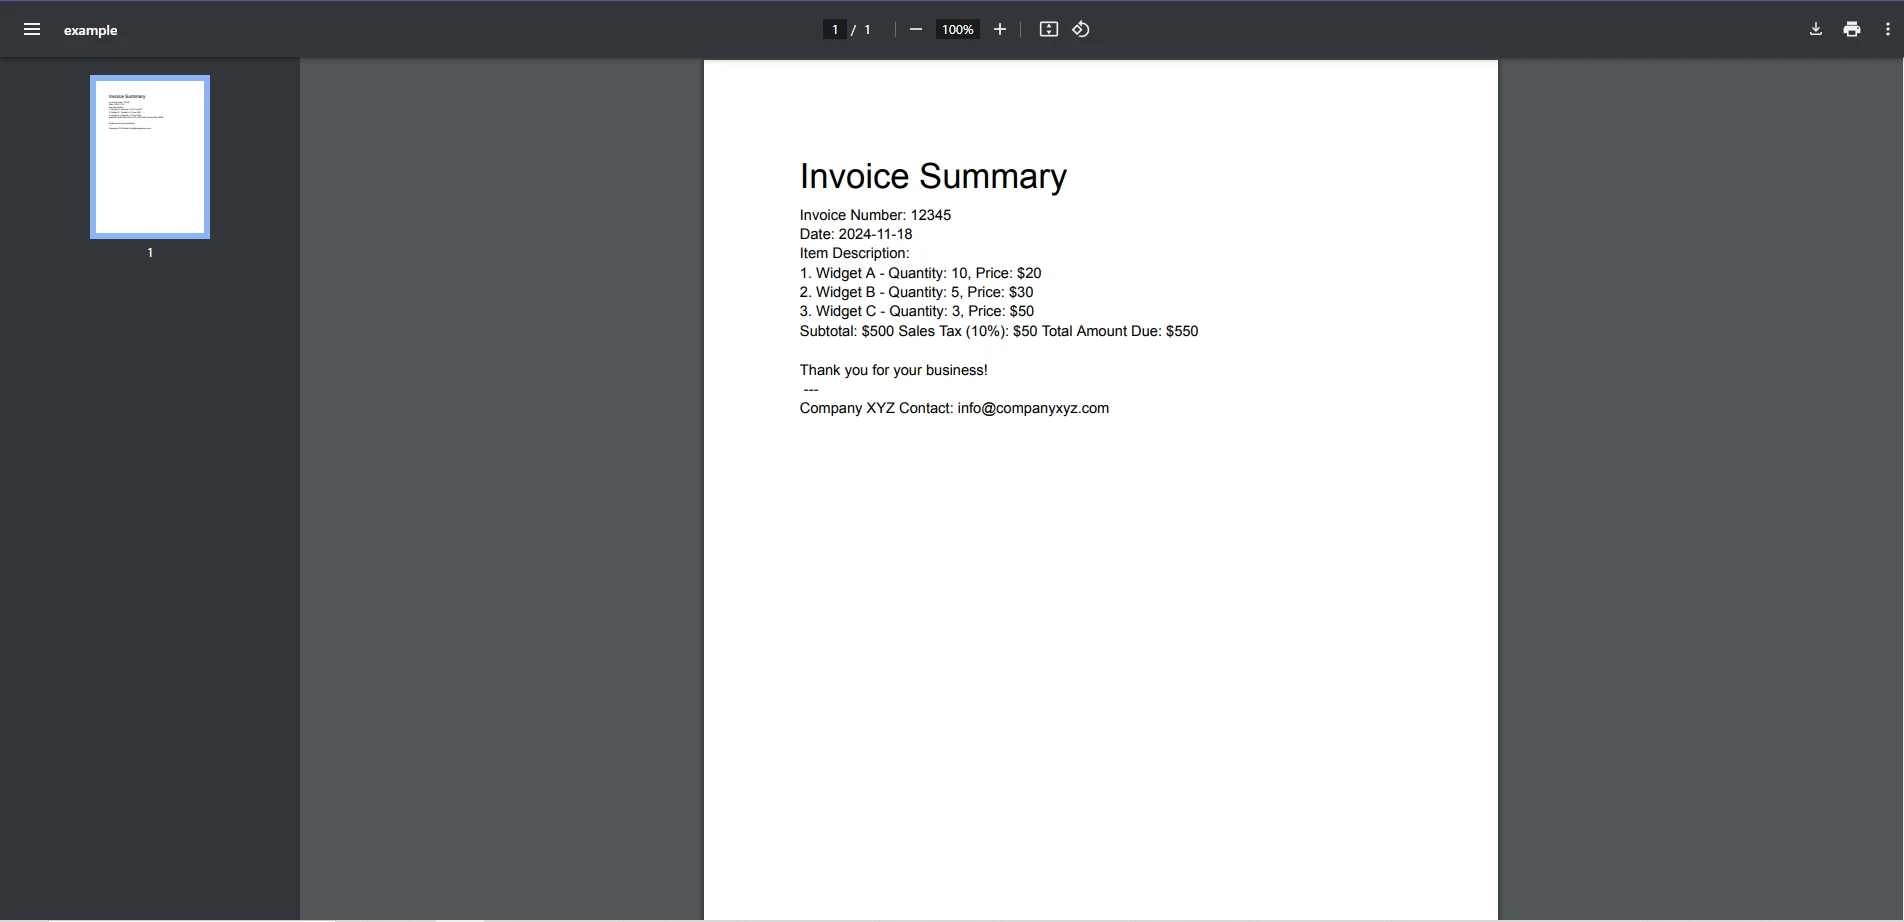
**PDF de entrada**
**Salida de la Consola**
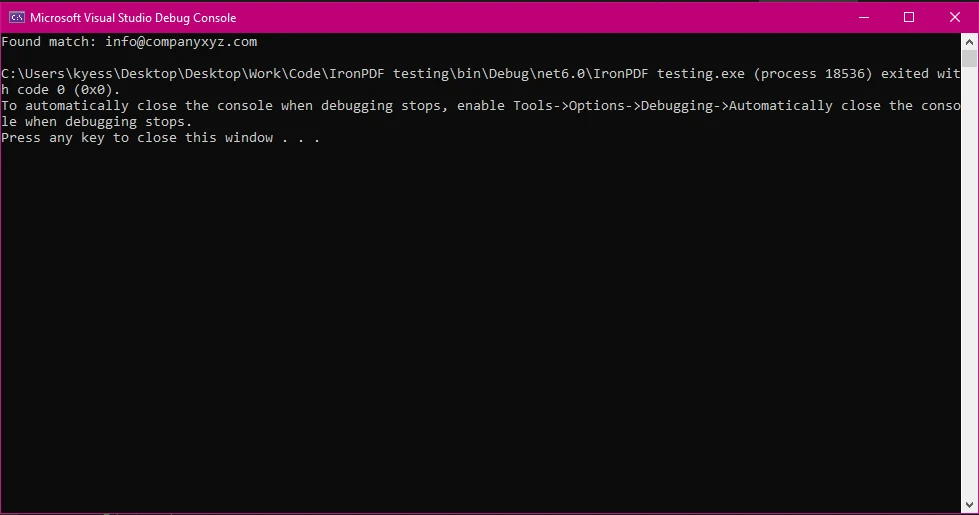
Este ejemplo usa un patrón de regex para identificar e imprimir todas las direcciones de correo electrónico encontradas en el documento.
#### Extracción de texto de páginas específicas
A veces, podrías necesitar buscar solo dentro de una página específica de un PDF. IronPDF le permite apuntar a páginas individuales utilizando la propiedad **`PdfDocument.Pages`** :
```csharp
using IronPdf;
public class Program
{
public static void Main(string[] args)
{
// Load a PDF file
PdfDocument pdf = PdfDocument.FromFile("urlPdf.pdf");
// Extract text from the first page
var pageText = pdf.Pages[0].Text.ToString();
if (pageText.Contains("IronPDF"))
{
Console.WriteLine("Found the term 'IronPDF' on the first page!");
}
}
}
```
**PDF de entrada**
**Salida de la Consola**
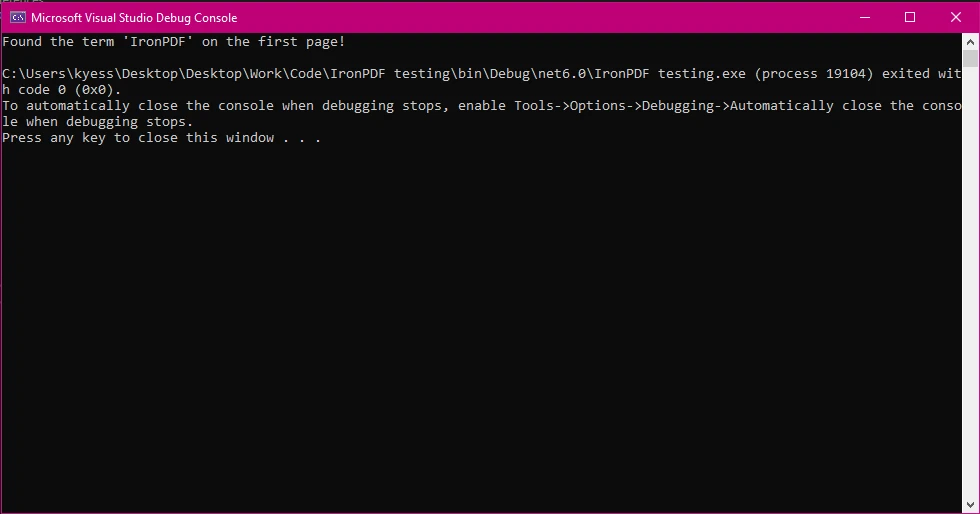
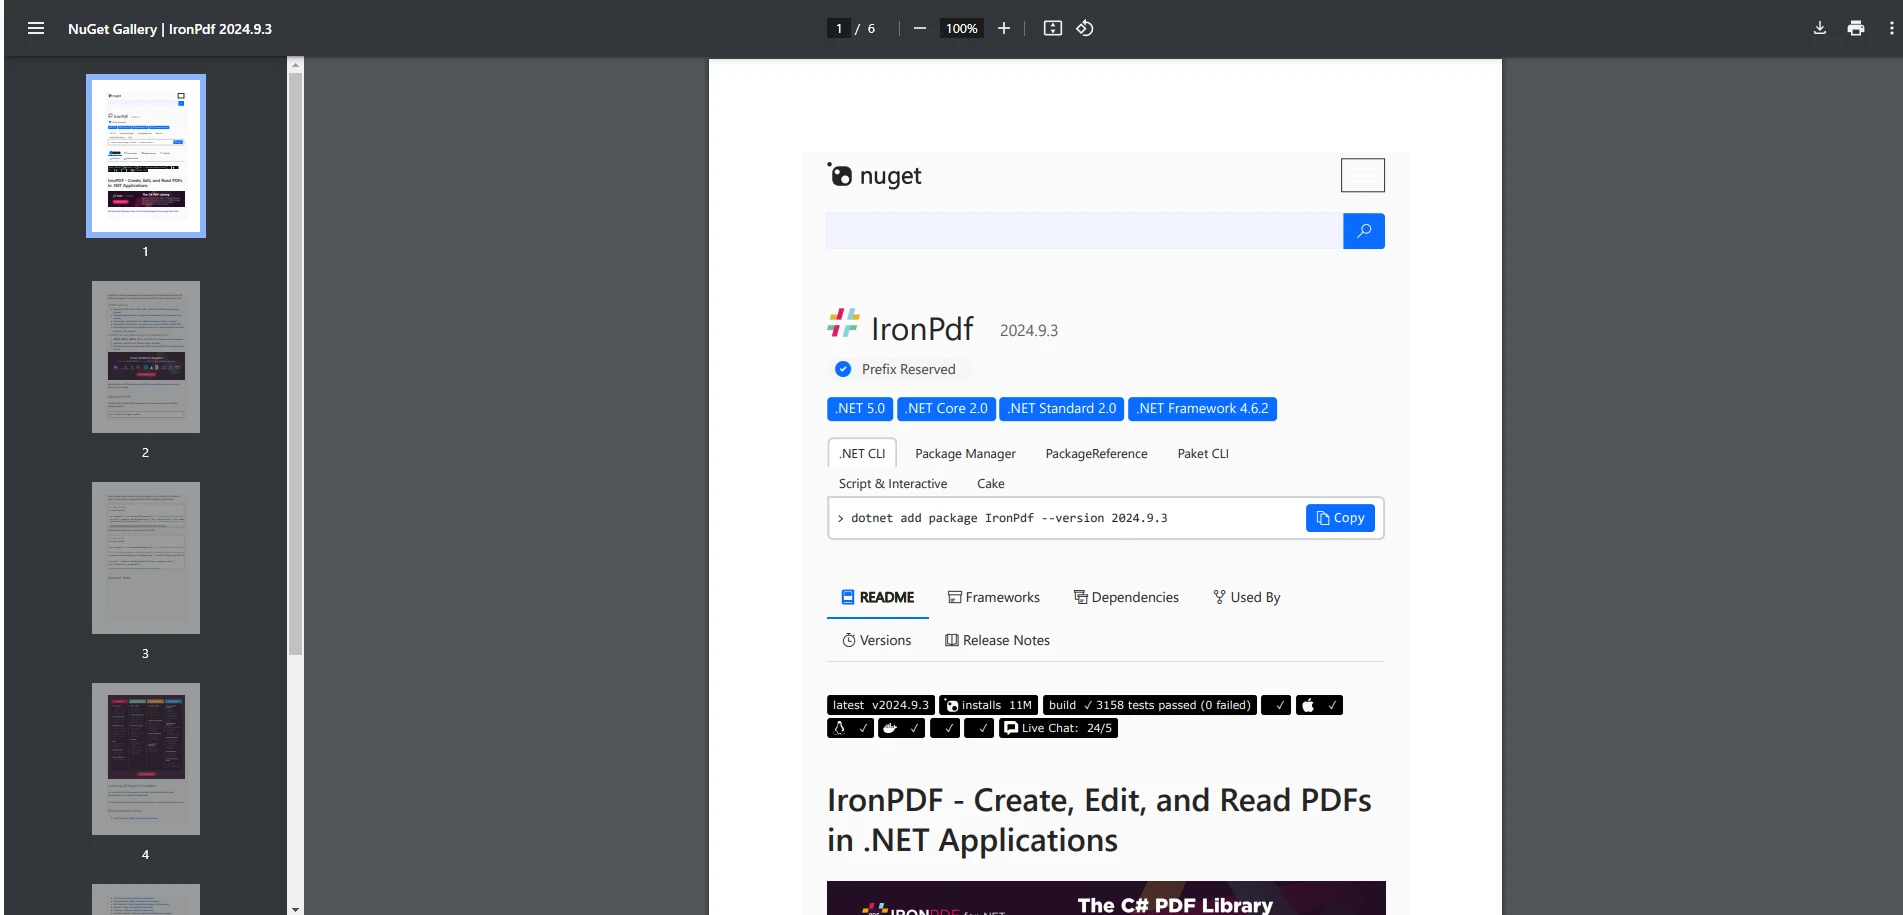
Este enfoque es útil para optimizar el rendimiento cuando se trabaja con PDFs grandes.
## Casos de uso del mundo real
### Análisis de contratos
Los profesionales legales pueden usar IronPDF para automatizar la búsqueda de términos o cláusulas clave dentro de contratos extensos. Por ejemplo, localizar rápidamente "Cláusula de Terminación" o "Confidencialidad" en documentos.
### Procesamiento de facturas
En flujos de trabajo financieros o contables, IronPDF puede ayudar a localizar números de factura, fechas o montos totales en archivos PDF a granel, agilizando las operaciones y reduciendo el esfuerzo manual.
### Minería de datos
IronPDF puede integrarse en los flujos de datos para extraer y analizar información de informes o registros almacenados en formato PDF. Esto es particularmente útil para las industrias que manejan grandes volúmenes de datos no estructurados.
## Conclusión
[IronPDF](https://ironpdf.com) es más que solo una biblioteca para trabajar con PDFs; es un kit de herramientas completo que capacita a los desarrolladores .NET para manejar operaciones complejas de PDFs con facilidad. Desde extraer texto y encontrar términos específicos hasta realizar coincidencias de patrones avanzadas con expresiones regulares, IronPDF agiliza tareas que de otro modo requerirían un esfuerzo manual significativo o múltiples bibliotecas.
La capacidad de extraer y buscar texto en PDFs desbloquea casos de uso poderosos en diversas industrias. Los profesionales legales pueden automatizar la búsqueda de cláusulas críticas en contratos, los contadores pueden agilizar el procesamiento de facturas, y los desarrolladores en cualquier campo pueden crear flujos de documentos eficientes. Al ofrecer una extracción de texto precisa, compatibilidad con .NET Core y Framework, y capacidades avanzadas, IronPDF asegura que tus necesidades de PDF se cumplan sin complicaciones.
#### ¡Comience hoy mismo!
No permitas que el procesamiento de PDFs frene tu desarrollo. Comienza a usar IronPDF hoy para simplificar la extracción de texto y aumentar la productividad. Aquí te mostramos cómo puedes comenzar:
* **Descargar la prueba gratuita:** Visita [IronPDF](trial-license).
* **Consulta la documentación:** Explora guías detalladas y ejemplos en la [documentación](/docs/) de IronPDF.
* **Comienza a construir:** Implementa una funcionalidad poderosa de PDF en tus aplicaciones .NET con un mínimo esfuerzo.
Da el primer paso hacia la optimización de tus flujos de documentos con IronPDF. Desbloquea su potencial completo, mejora tu proceso de desarrollo, y ofrece soluciones robustas potenciadas por PDF más rápido que nunca.
Encontrar texto dentro de un PDF puede ser una tarea desafiante, especialmente cuando se trabaja con archivos estáticos que no son fácilmente editables o buscables. Ya sea que estés automatizando flujos de trabajo de documentos, construyendo funcionalidad de búsqueda, necesitando resaltar texto que coincida con tus criterios de búsqueda o extrayendo datos, la extracción de texto es una función crítica para los desarrolladores.
IronPDF, una potente biblioteca .NET, simplifica este proceso, permitiendo a los desarrolladores buscar y extraer texto eficientemente de PDFs. En este artículo, exploraremos cómo usar IronPDF para encontrar texto en un PDF usando C#, completo con ejemplos de código y aplicaciones prácticas.
¿Qué es "Buscar texto" en C#?
"Encontrar texto" se refiere al proceso de buscar texto o patrones específicos dentro de un documento, archivo u otras estructuras de datos. En el contexto de archivos PDF, implica identificar y localizar instancias de palabras, frases o patrones específicos dentro del contenido de texto de un documento PDF. Esta funcionalidad es esencial para numerosas aplicaciones en diversas industrias, especialmente cuando se trata con datos no estructurados o semi-estructurados almacenados en formato PDF.
Comprensión del texto en archivos PDF
Los archivos PDF están diseñados para presentar contenido en un formato consistente e independiente del dispositivo. Sin embargo, la forma de almacenar texto en PDFs varía. El texto puede estar almacenado como:
Texto buscable: Texto que es directamente extraíble porque está incrustado como texto (por ejemplo, de un documento de Word convertido a PDF).
Texto escaneado: Texto que aparece como una imagen, que requiere OCR (Reconocimiento Óptico de Caracteres) para convertir en texto buscable.
Diseños complejos: Texto almacenado en fragmentos o con codificación inusual, lo que hace más difícil extraer y buscar con precisión.
Esta variabilidad significa que la búsqueda efectiva de texto en PDFs a menudo requiere bibliotecas especializadas, como IronPDF, que pueden manejar tipos de contenido diversos sin problemas.
¿Por qué es importante encontrar el texto?
La capacidad de encontrar texto en PDFs tiene un amplio rango de aplicaciones, incluyendo:
Automatización de flujos de trabajo: Automatizar tareas como el procesamiento de facturas, contratos o informes identificando términos o valores clave en documentos PDF.
Extracción de datos: Extraer información para su uso en otros sistemas o para análisis.
Verificación de contenido: Asegurar que los términos o frases requeridas estén presentes en documentos, como declaraciones de conformidad o cláusulas legales.
Mejora de la experiencia del usuario: Habilitar la funcionalidad de búsqueda en sistemas de gestión de documentos, ayudando a los usuarios a ubicar rápidamente información relevante.
Desafíos en la búsqueda de texto
Encontrar texto en PDFs no siempre es sencillo debido a los siguientes desafíos:
Variaciones de codificación: Algunos PDFs utilizan codificaciones personalizadas para el texto, lo que complica la extracción.
Texto fragmentado: El texto podría estar dividido en múltiples piezas, haciendo que las búsquedas sean más complejas.
Gráficos e imágenes: El texto incrustado en imágenes requiere OCR para extraerlo.
Soporte multilingüe: Buscar en documentos con diferentes idiomas, escrituras o texto de derecha a izquierda requiere un manejo robusto.
¿Por qué elegir IronPDF para la extracción de texto?
IronPDF está diseñado para hacer que la manipulación de PDFs sea lo más fluida posible para los desarrolladores que trabajan en el ecosistema .NET. Ofrece un conjunto de funciones diseñadas para agilizar los procesos de extracción y manipulación de texto.
Beneficios clave
Facilidad de uso:
IronPDF presenta una API intuitiva, lo que permite a los desarrolladores comenzar rápidamente sin una curva de aprendizaje empinada. Ya sea que estés realizando una extracción de texto básica o conversión de HTML a PDF, o operaciones avanzadas, sus métodos son fáciles de usar.
Alta precisión:
A diferencia de algunas bibliotecas PDF que luchan con PDFs que contienen diseños complejos o fuentes incrustadas, IronPDF extrae texto con precisión de manera confiable.
Compatibilidad multiplataforma:
IronPDF es compatible tanto con .NET Framework como con .NET Core, asegurando que los desarrolladores puedan usarlo en aplicaciones web modernas, aplicaciones de escritorio e incluso sistemas heredados.
Soporte para consultas avanzadas:
La biblioteca es compatible con técnicas de búsqueda avanzadas, como expresiones regulares y extracción específica, lo que la hace adecuada para casos de uso complejos, como minería de datos o indexación de documentos.
Cómo configurar IronPDF en su proyecto
IronPDF está disponible a través de NuGet, lo que hace que sea fácil de agregar a tus proyectos .NET. Aquí te mostramos cómo empezar.
Instalación
Para instalar IronPDF, usa el Administrador de Paquetes NuGet en Visual Studio o ejecuta el siguiente comando en la Consola del Administrador de Paquetes:
PM > Install-Package IronPdf
Install-Package IronPdf
Esto descargará e instalará la biblioteca junto con sus dependencias.
Configuración básica
Una vez que la biblioteca esté instalada, necesitas incluirla en tu proyecto referenciando el espacio de nombres IronPDF. Agrega la siguiente línea en la parte superior de tu archivo de código:
using IronPdf;
using IronPdf;
ImportsIronPdf
Imports IronPdf
Ejemplo de código: Encontrar texto en un PDF
IronPDF simplifica el proceso de encontrar texto dentro de un documento PDF. A continuación, se muestra una demostración paso a paso de cómo lograrlo.
Cargar un archivo PDF
El primer paso es cargar el archivo PDF con el que deseas trabajar. Esto se hace utilizando la clase PdfDocument, como se ve en el siguiente código:
using IronPdf;PdfDocument pdf = PdfDocument.FromFile("example.pdf");
using IronPdf;
PdfDocument pdf = PdfDocument.FromFile("example.pdf");
ImportsIronPdfPrivate pdf AsPdfDocument = PdfDocument.FromFile("example.pdf")
Imports IronPdf
Private pdf As PdfDocument = PdfDocument.FromFile("example.pdf")
La clase PdfDocument representa el archivo PDF en la memoria, lo que le permite realizar varias operaciones como extraer texto o modificar contenido. Una vez que el PDF ha sido cargado, podemos buscar texto desde todo el documento PDF o una página PDF específica dentro del archivo.
Búsqueda de texto específico
Después de cargar el PDF, utilice el método ExtractAllText() para extraer el contenido de texto de todo el documento. Luego puedes buscar términos específicos usando técnicas estándar de manipulación de cadenas:
using IronPdf;public class Program{ public static voidMain(string[] args) { string path = "example.pdf"; // Load a PDF file PdfDocument pdf = PdfDocument.FromFile(path); // Extract all text from the PDF string text = pdf.ExtractAllText(); // Search for a specific term string searchTerm = "Invoice"; bool isFound = text.Contains(searchTerm, StringComparison.OrdinalIgnoreCase);Console.WriteLine(isFound ? $"The term '{searchTerm}' was found in the PDF!" : $"The term '{searchTerm}' was not found."); }}
using IronPdf;
public class Program
{
    public static void Main(string[] args)
    {
        string path = "example.pdf";
        // Load a PDF file
        PdfDocument pdf = PdfDocument.FromFile(path);
        // Extract all text from the PDF
        string text = pdf.ExtractAllText();
        // Search for a specific term
        string searchTerm = "Invoice";
        bool isFound = text.Contains(searchTerm, StringComparison.OrdinalIgnoreCase);
        Console.WriteLine(isFound
            ? $"The term '{searchTerm}' was found in the PDF!"
            : $"The term '{searchTerm}' was not found.");
    }
}
ImportsIronPdfPublic Class Program PublicShared Sub Main(ByVal args() AsString) Dim path AsString = "example.pdf" ' Load a PDF file Dim pdf AsPdfDocument = PdfDocument.FromFile(path) ' Extract all text from the PDF Dim text AsString = pdf.ExtractAllText() ' Search for a specific term Dim searchTerm AsString = "Invoice" Dim isFound AsBoolean = text.Contains(searchTerm, StringComparison.OrdinalIgnoreCase)Console.WriteLine(If(isFound, $"The term '{searchTerm}' was found in the PDF!", $"The term '{searchTerm}' was not found.")) End SubEnd Class
Imports IronPdf
Public Class Program
	Public Shared Sub Main(ByVal args() As String)
		Dim path As String = "example.pdf"
		' Load a PDF file
		Dim pdf As PdfDocument = PdfDocument.FromFile(path)
		' Extract all text from the PDF
		Dim text As String = pdf.ExtractAllText()
		' Search for a specific term
		Dim searchTerm As String = "Invoice"
		Dim isFound As Boolean = text.Contains(searchTerm, StringComparison.OrdinalIgnoreCase)
		Console.WriteLine(If(isFound, $"The term '{searchTerm}' was found in the PDF!", $"The term '{searchTerm}' was not found."))
	End Sub
End Class
PDF de entrada
Salida de la Consola
Este ejemplo demuestra un caso simple donde verificas si existe un término en el PDF. El StringComparison.OrdinalIgnoreCase garantiza que el texto buscado no distinga entre mayúsculas y minúsculas.
Características avanzadas para la búsqueda de texto
IronPDF ofrece varias funciones avanzadas que extienden sus capacidades de búsqueda de texto.
Uso de expresiones regulares
Las expresiones regulares son una herramienta poderosa para encontrar patrones dentro del texto. Por ejemplo, podrías querer localizar todas las direcciones de correo electrónico en un PDF:
using System.Text.RegularExpressions; // Required namespace for using regex// Extract all textstring pdfText = pdf.ExtractAllText();// Use a regex to find patterns (e.g., email addresses)Regex regex = new Regex(@"[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}");MatchCollection matches = regex.Matches(pdfText);foreach (Match match in matches){Console.WriteLine($"Found match: {match.Value}");}
using System.Text.RegularExpressions;  // Required namespace for using regex
// Extract all text
string pdfText = pdf.ExtractAllText();
// Use a regex to find patterns (e.g., email addresses)
Regex regex = new Regex(@"[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}");
MatchCollection matches = regex.Matches(pdfText);
foreach (Match match in matches)
{
    Console.WriteLine($"Found match: {match.Value}");
}
ImportsSystem.Text.RegularExpressions' Required namespace for using regex' Extract all textPrivate pdfText AsString = pdf.ExtractAllText()' Use a regex to find patterns (e.g., email addresses)Private regex As New Regex("[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}")Private matches AsMatchCollection = regex.Matches(pdfText)For Each match AsMatchIn matchesConsole.WriteLine($"Found match: {match.Value}")Next match
Imports System.Text.RegularExpressions ' Required namespace for using regex
' Extract all text
Private pdfText As String = pdf.ExtractAllText()
' Use a regex to find patterns (e.g., email addresses)
Private regex As New Regex("[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}")
Private matches As MatchCollection = regex.Matches(pdfText)
For Each match As Match In matches
	Console.WriteLine($"Found match: {match.Value}")
Next match
PDF de entrada
Salida de la Consola
Este ejemplo usa un patrón de regex para identificar e imprimir todas las direcciones de correo electrónico encontradas en el documento.
Extracción de texto de páginas específicas
A veces, podrías necesitar buscar solo dentro de una página específica de un PDF. IronPDF le permite apuntar a páginas individuales utilizando la propiedad PdfDocument.Pages :
using IronPdf;public class Program{ public static voidMain(string[] args) { // Load a PDF file PdfDocument pdf = PdfDocument.FromFile("urlPdf.pdf"); // Extract text from the first page var pageText = pdf.Pages[0].Text.ToString(); if (pageText.Contains("IronPDF")) {Console.WriteLine("Found the term 'IronPDF' on the first page!"); } }}
using IronPdf;
public class Program
{
    public static void Main(string[] args)
    {
        // Load a PDF file
        PdfDocument pdf = PdfDocument.FromFile("urlPdf.pdf");
        // Extract text from the first page
        var pageText = pdf.Pages[0].Text.ToString();
        if (pageText.Contains("IronPDF"))
        {
            Console.WriteLine("Found the term 'IronPDF' on the first page!");
        }
    }
}
ImportsIronPdfPublic Class Program PublicShared Sub Main(ByVal args() AsString) ' Load a PDF file Dim pdf AsPdfDocument = PdfDocument.FromFile("urlPdf.pdf") ' Extract text from the first page Dim pageText = pdf.Pages(0).Text.ToString() If pageText.Contains("IronPDF") ThenConsole.WriteLine("Found the term 'IronPDF' on the first page!") End If End SubEnd Class
Imports IronPdf
Public Class Program
	Public Shared Sub Main(ByVal args() As String)
		' Load a PDF file
		Dim pdf As PdfDocument = PdfDocument.FromFile("urlPdf.pdf")
		' Extract text from the first page
		Dim pageText = pdf.Pages(0).Text.ToString()
		If pageText.Contains("IronPDF") Then
			Console.WriteLine("Found the term 'IronPDF' on the first page!")
		End If
	End Sub
End Class
PDF de entrada
Salida de la Consola
Este enfoque es útil para optimizar el rendimiento cuando se trabaja con PDFs grandes.
Casos de uso del mundo real
Análisis de contratos
Los profesionales legales pueden usar IronPDF para automatizar la búsqueda de términos o cláusulas clave dentro de contratos extensos. Por ejemplo, localizar rápidamente "Cláusula de Terminación" o "Confidencialidad" en documentos.
Procesamiento de facturas
En flujos de trabajo financieros o contables, IronPDF puede ayudar a localizar números de factura, fechas o montos totales en archivos PDF a granel, agilizando las operaciones y reduciendo el esfuerzo manual.
Minería de datos
IronPDF puede integrarse en los flujos de datos para extraer y analizar información de informes o registros almacenados en formato PDF. Esto es particularmente útil para las industrias que manejan grandes volúmenes de datos no estructurados.
Conclusión
IronPDF es más que solo una biblioteca para trabajar con PDFs; es un kit de herramientas completo que capacita a los desarrolladores .NET para manejar operaciones complejas de PDFs con facilidad. Desde extraer texto y encontrar términos específicos hasta realizar coincidencias de patrones avanzadas con expresiones regulares, IronPDF agiliza tareas que de otro modo requerirían un esfuerzo manual significativo o múltiples bibliotecas.
La capacidad de extraer y buscar texto en PDFs desbloquea casos de uso poderosos en diversas industrias. Los profesionales legales pueden automatizar la búsqueda de cláusulas críticas en contratos, los contadores pueden agilizar el procesamiento de facturas, y los desarrolladores en cualquier campo pueden crear flujos de documentos eficientes. Al ofrecer una extracción de texto precisa, compatibilidad con .NET Core y Framework, y capacidades avanzadas, IronPDF asegura que tus necesidades de PDF se cumplan sin complicaciones.
¡Comience hoy mismo!
No permitas que el procesamiento de PDFs frene tu desarrollo. Comienza a usar IronPDF hoy para simplificar la extracción de texto y aumentar la productividad. Aquí te mostramos cómo puedes comenzar:
Consulta la documentación: Explora guías detalladas y ejemplos en la documentación de IronPDF.
Comienza a construir: Implementa una funcionalidad poderosa de PDF en tus aplicaciones .NET con un mínimo esfuerzo.
Da el primer paso hacia la optimización de tus flujos de documentos con IronPDF. Desbloquea su potencial completo, mejora tu proceso de desarrollo, y ofrece soluciones robustas potenciadas por PDF más rápido que nunca.
Curtis Chau tiene una licenciatura en Ciencias de la Computación (Carleton University) y se especializa en el desarrollo front-end con experiencia en Node.js, TypeScript, JavaScript y React. Apasionado por crear interfaces de usuario intuitivas y estéticamente agradables, disfruta trabajando con frameworks modernos y creando manuales bien estructurados y visualmente atractivos.
















