Cet article démontrera comment utiliser IronPDF for Python, l'une des bibliothèques PDF les plus puissantes, pour extraire tout texte disponible dans un document PDF.
Comment convertir un PDF en texte en Python
- Installer une bibliothèque Python pour convertir des PDF en texte
- Chargez un document PDF existant ou générez-en un nouveau
- Utilisez la méthode
ExtractAllText pour lire le texte du fichier ouvert - Utilisez une autre surcharge de la méthode pour lire le texte d'une ou plusieurs pages spécifiques.
- Imprimez le texte extrait dans la console ou enregistrez-le dans un fichier texte
- Installer la dernière version de Python depuis la page de téléchargement de Python
- Ouvrir n'importe quel outil IDE for Python
- Installer le runtime .NET Core
- Installer la bibliothèque IronPDF for Python ou télécharger depuis la page de téléchargement PyPI
- Extraire le texte du PDF
2.1 Qu'est-ce qu'IronPDF for Python ?
Il est simple d'intégrer la bibliothèque IronPDF dans Python car c'est un langage beaucoup plus dynamique comparé à d'autres langages et permet aux développeurs de créer des interfaces graphiques utilisateur rapidement et facilement. Il dispose d'une pléthore d'outils préinstallés, notamment PyQT, wxWidgets, kivy, et de nombreux autres paquets et bibliothèques supplémentaires, qui peuvent tous être utilisés pour créer une interface utilisateur graphique complète de manière rapide et sécurisée.
IronPDF for Python est une bibliothèque extrêmement efficace, particulièrement utile pour le développement web. La disponibilité d'autant de paradigmes de développement web en Python, comme Django, Flask, et Pyramid, y est en partie responsable. Ces frameworks ont été utilisés par de nombreux sites web et services en ligne, y compris Reddit, Mozilla, et Spotify.
2.2 Fonctionnalités de IronPDF
- Un fichier PDF peut être créé à partir d'une variété de sources, y compris HTML, HTML5, ASP, et des sites web PHP. En plus des fichiers HTML, il est également possible de convertir des fichiers image en PDF.
- IronPDF permet de créer des documents PDF interactifs, de remplir et envoyer des formulaires interactifs, de diviser et combiner des fichiers PDF, extraire du texte et des images à partir de fichiers PDF, rechercher certains mots dans un fichier PDF, rasteriser les pages PDF en images, convertir le PDF en HTML, et imprimer des fichiers PDF.
- IronPDF peut ouvrir des fichiers PDF et imprimer à partir d'une URL. De plus, il permet aux agents utilisateurs de se connecter derrière des formulaires de connexion HTML, des proxies, des cookies, des en-têtes HTTP, des identifiants de connexion réseau personnalisés, des variables de formulaire, et des agents utilisateurs.
- Les images peuvent être extraites des documents avec IronPDF.
- Avec IronPDF, il est très facile d'ajouter des en-têtes et pieds de page, du texte et des images, des signets et des filigranes, et plus encore aux documents.
- Il est possible de combiner et séparer des pages en utilisant un document nouveau ou existant avec IronPDF.
- Sans utiliser de visualiseur Acrobat, les documents peuvent être convertis en objets PDF.
- Un fichier CSS peut être utilisé pour créer un document PDF.
- La création de documents est possible en utilisant des fichiers CSS de type média.
2.3 Importer la bibliothèque IronPDF
Inclure les déclarations d'importation suivantes au début des fichiers source où IronPDF sera utilisé afin d'importer IronPDF :
from ironpdf import *
from ironpdf import *
Python
2.4 Définir la clé de licence (si nécessaire)
Bien qu'IronPDF for Python soit gratuit à utiliser, il appose un filigrane sur les fichiers PDF avec un fond en mosaïque pour les utilisateurs gratuits. Vous devez fournir à la bibliothèque une clé de licence légitime pour utiliser IronPDF pour créer des PDF sans filigrane. Comment configurer la bibliothèque avec une clé de licence est montré dans l'extrait de code suivant :
# Set the license key for IronPDF
License.LicenseKey = "IRONPDF-LICENSE-KEY-ABCDEFGH"
# Set the license key for IronPDF
License.LicenseKey = "IRONPDF-LICENSE-KEY-ABCDEFGH"
Python
Avant de créer des fichiers PDF ou de modifier leur contenu, assurez-vous que la clé de licence est configurée. La méthode LicenseKey doit être appelée avant toute autre ligne de code. Pour obtenir une clé de licence d'essai gratuite, rendez-vous sur la page de licence.
2.5 Définir les fichiers journaux
Un fichier texte appelé "Default" peut stocker des messages de journal produits par Custom.log dans le répertoire du script Python. L'extrait de code ci-dessous peut être utilisé pour définir la propriété LogFilePath et personnaliser le nom et l'emplacement du fichier journal :
# Enable debugging and set the log file path and mode
Logger.EnableDebugging = True
Logger.LogFilePath = "Custom.log"
Logger.LoggingMode = Logger.LoggingModes.All
# Enable debugging and set the log file path and mode
Logger.EnableDebugging = True
Logger.LogFilePath = "Custom.log"
Logger.LoggingMode = Logger.LoggingModes.All
Python
La bibliothèque IronPDF for Python peut convertir des pages PDF en objets PDF et permet l'extraction de texte à partir de fichiers PDF, y compris les fichiers PDF scannés. Voici un exemple qui montre comment lire un PDF existant avec IronPDF.
La première méthode consiste à extraire tout le texte disponible dans un PDF ; un exemple de code est fourni ci-dessous.
from ironpdf import *

# Load existing PDF document
pdf = PdfDocument.FromFile("content.pdf")

# Extract all the text from the entire PDF document
all_text = pdf.ExtractAllText()

# Display the extracted text
print(all_text)
from ironpdf import *

# Load existing PDF document
pdf = PdfDocument.FromFile("content.pdf")

# Extract all the text from the entire PDF document
all_text = pdf.ExtractAllText()

# Display the extracted text
print(all_text)
Python
Comme illustré dans le code ci-dessus, la méthode FromFile est un objet lecteur de PDF qui charge le fichier PDF existant et le convertit en objets document PDF. Cet objet peut être utilisé pour lire le texte et les images disponibles sur les pages PDF. L'objet fournit une méthode appelée ExtractAllText qui extrait chaque morceau de texte de l'ensemble du fichier PDF, en tenant le texte dans une chaîne qui peut être traitée. Et ensuite, utilisez la fonction print pour afficher le texte.
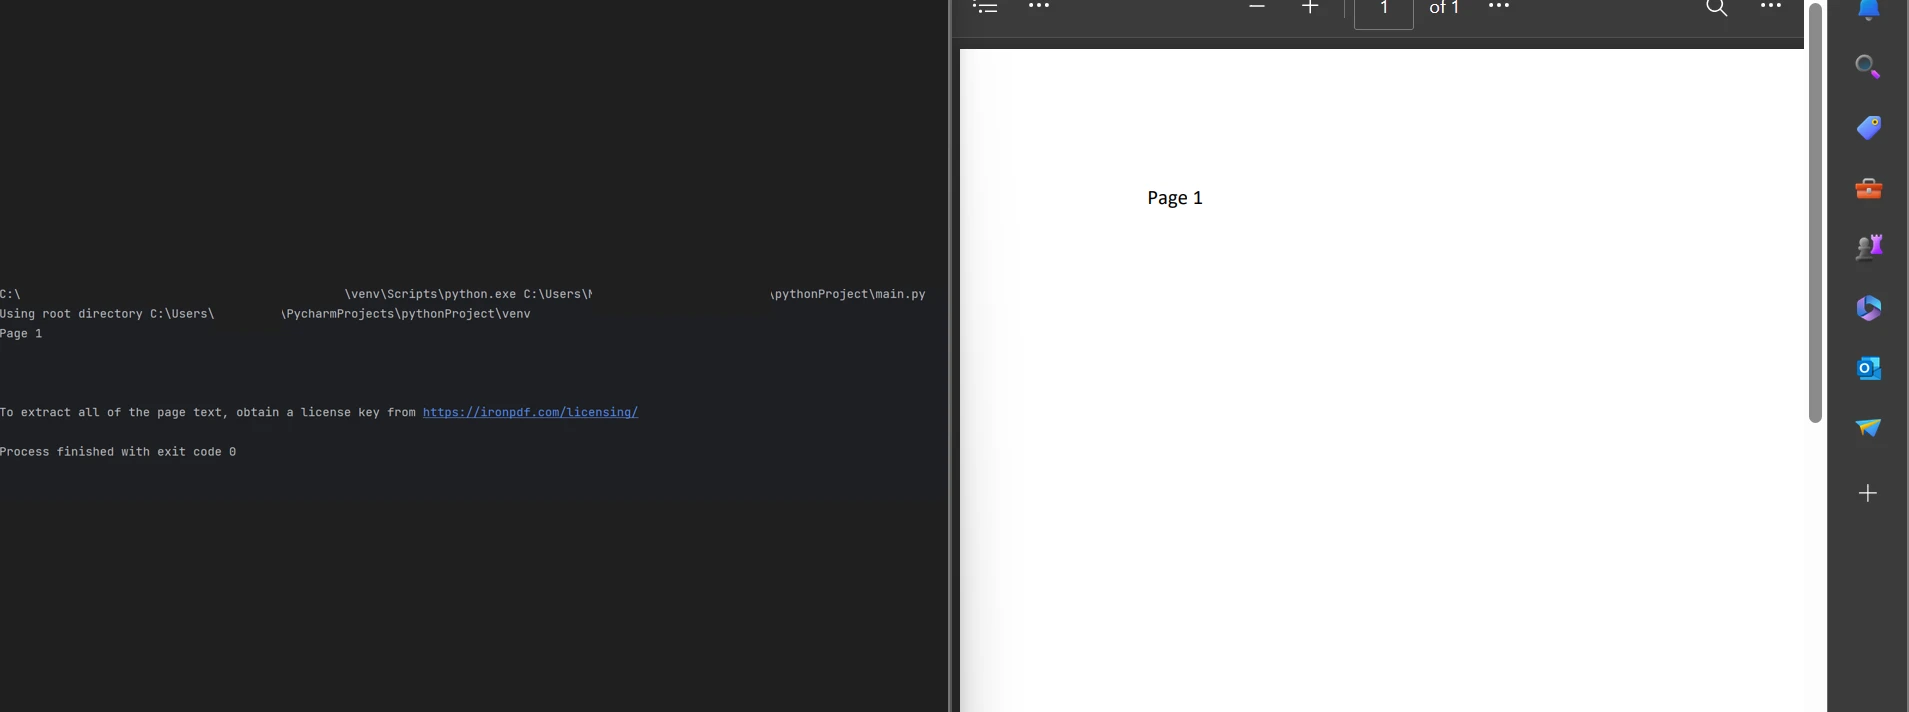 Affichage du texte
L'exemple de code pour la deuxième méthode qui peut être utilisé pour extraire du texte page par page d'un fichier PDF. Il est fourni ci-dessous.
from ironpdf import *

# Load existing PDF document
pdf = PdfDocument.FromFile("content.pdf")

# Extract text from a specific page in the document
page_text = pdf.ExtractTextFromPage(1)

# Display the extracted text from the specified page
print(page_text)
from ironpdf import *

# Load existing PDF document
pdf = PdfDocument.FromFile("content.pdf")

# Extract text from a specific page in the document
page_text = pdf.ExtractTextFromPage(1)

# Display the extracted text from the specified page
print(page_text)
Python
La méthode FromFile est utilisée pour charger le fichier PDF à partir d'un fichier existant et le convertir en un objet fichier PDF, comme montré dans le code ci-dessus. Une méthode sur l'objet de la page PDF appelée ExtractTextFromPage récupère tout le texte d'une page dans un fichier PDF. Le numéro de page doit être fourni comme paramètre pour extraire le texte de cette page particulière. Ensuite, après avoir extrait le texte, page_text peut être utilisé pour contenir l'information qui peut être traitée.
Consultez plus d'exemples pour extraire le texte d'un PDF.
4.0 Conclusion
La bibliothèque IronPDF, en revanche, offre des mesures de sécurité solides pour réduire les risques potentiels. Elle n'est pas adaptée à un seul navigateur et fonctionne avec tous les navigateurs couramment utilisés. IronPDF permet aux programmeurs de produire et lire facilement des fichiers PDF avec juste quelques lignes de code. La bibliothèque IronPDF propose une gamme d'options de licence, y compris une licence développeur gratuite et des licences de développement supplémentaires disponibles à l'achat, pour répondre aux besoins des différents développeurs.
IronPDF inclut une licence perpétuelle, une garantie de remboursement de 30 jours, une année de support logiciel, et des options de mise à jour. Il n'y a pas de dépenses supplémentaires après l'achat initial. Ces licences peuvent être utilisées dans des environnements de développement, de préproduction et de production. En savoir plus sur la licence du produit.
Télécharger le produit logiciel.








